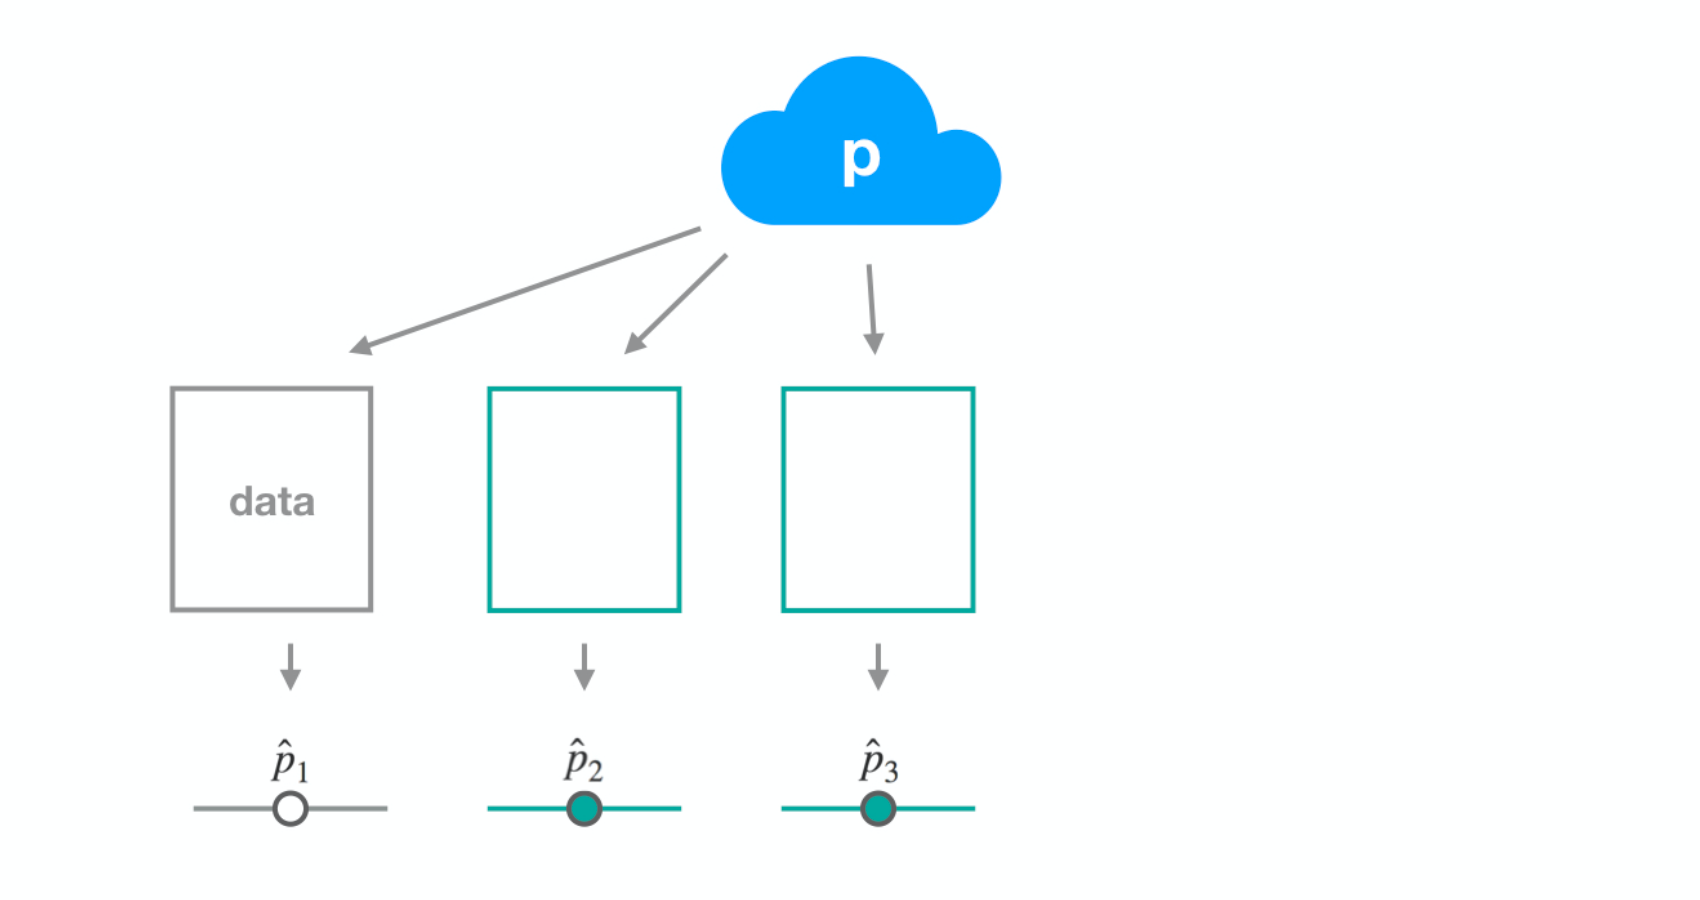
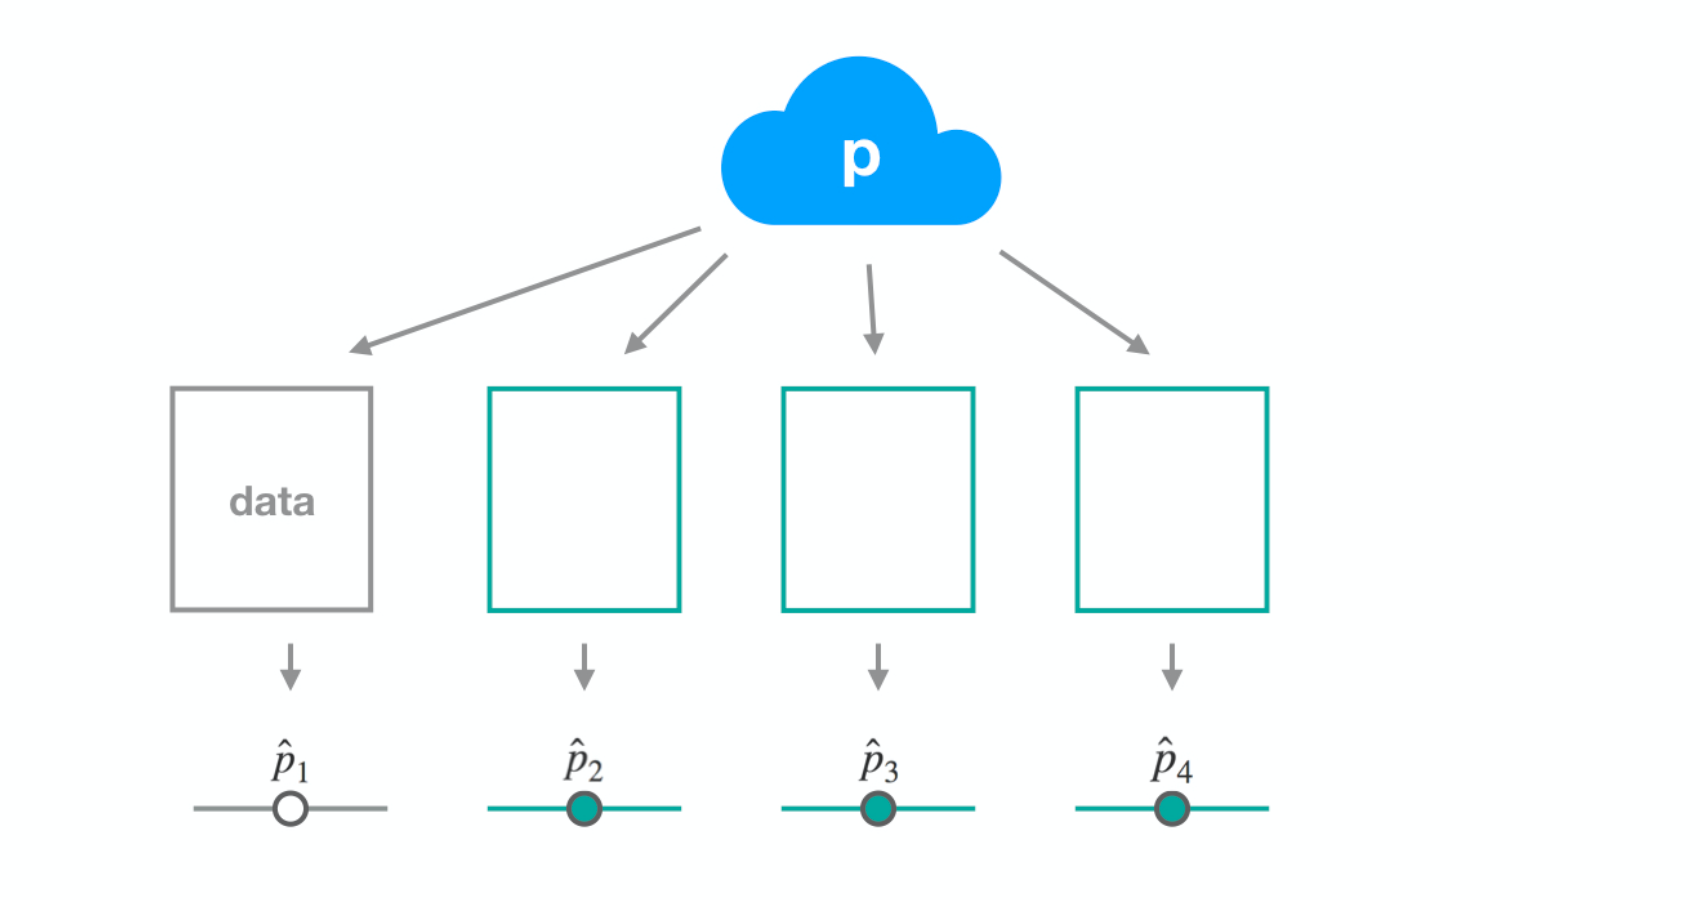
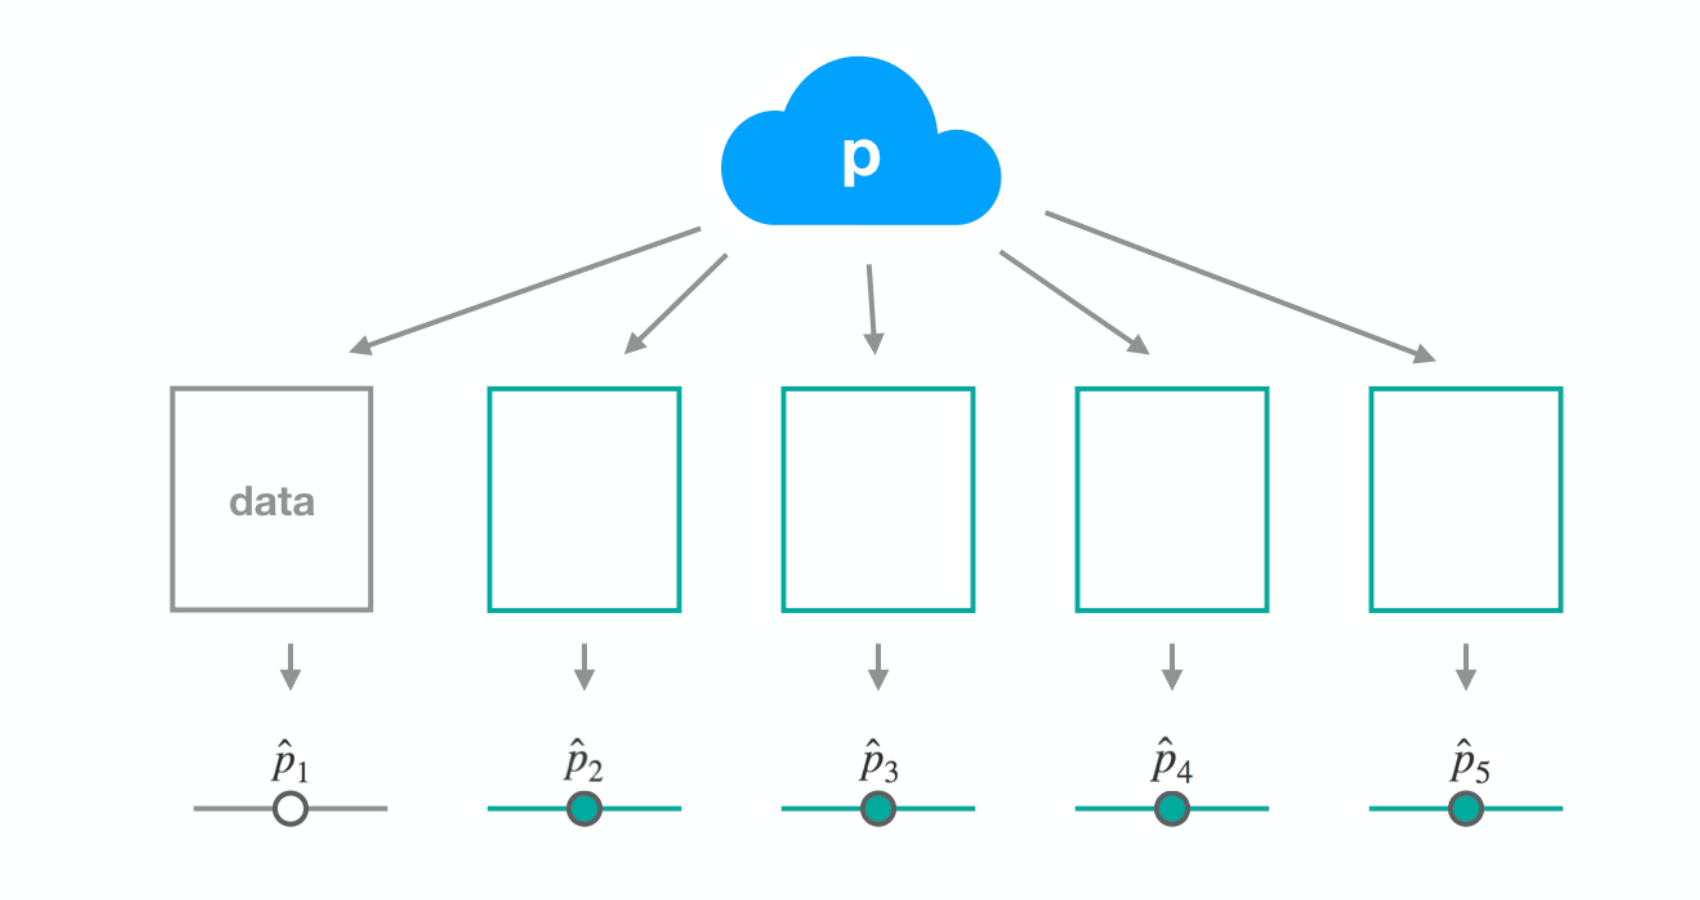
การตีความช่วงความเชื่อมั่น

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

Andrew Bray

Assistant Professor of Statistics at Reed College

ช่วงความเชื่อมั่น

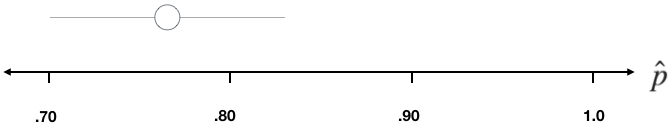
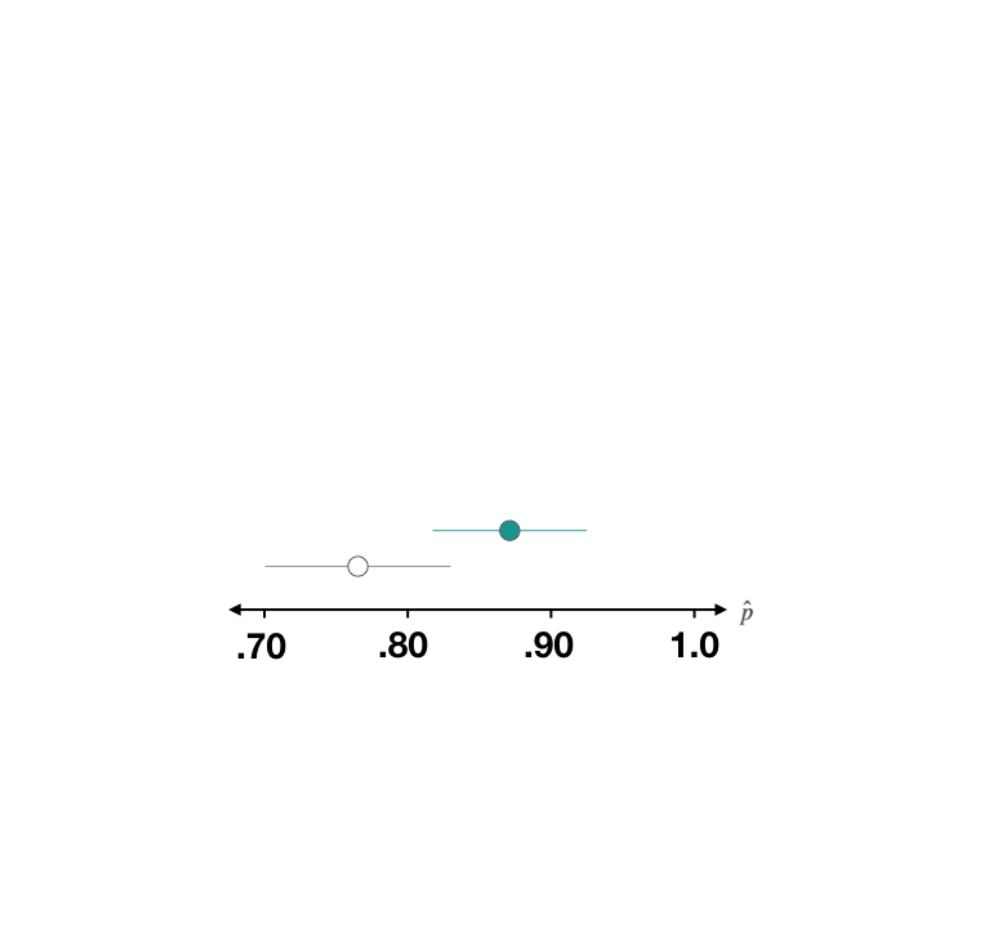
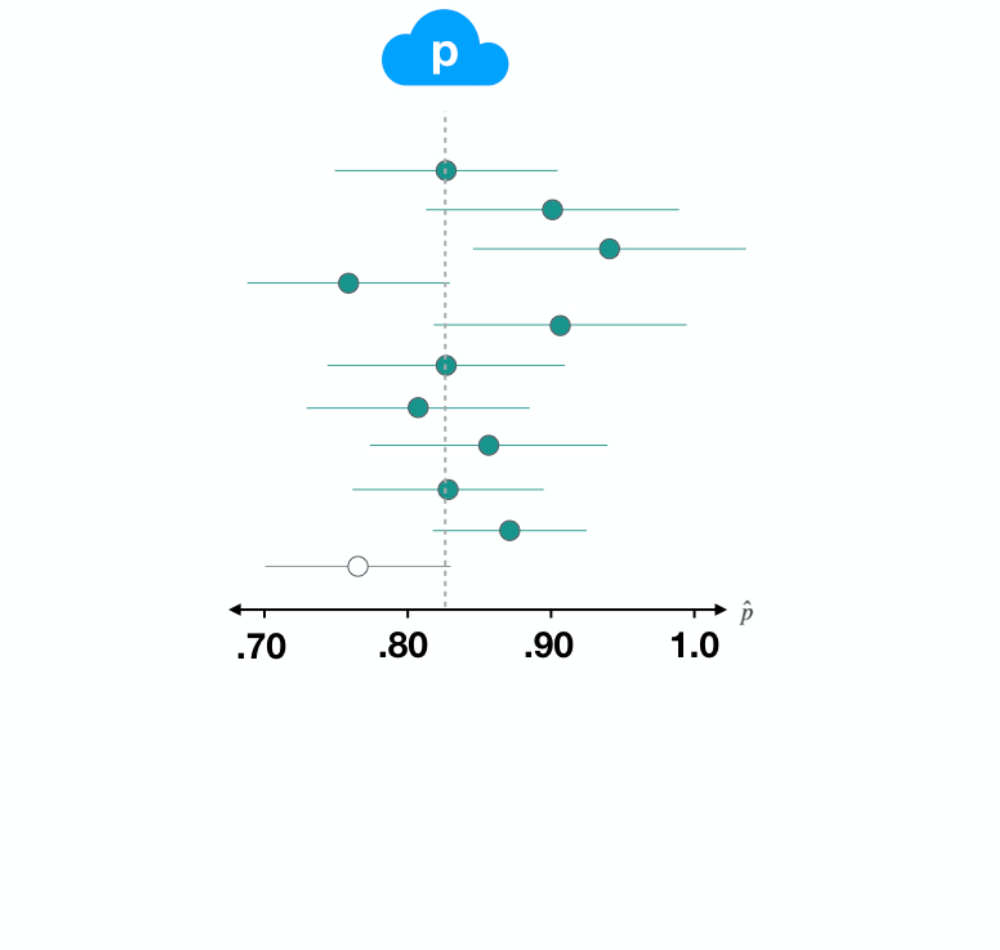
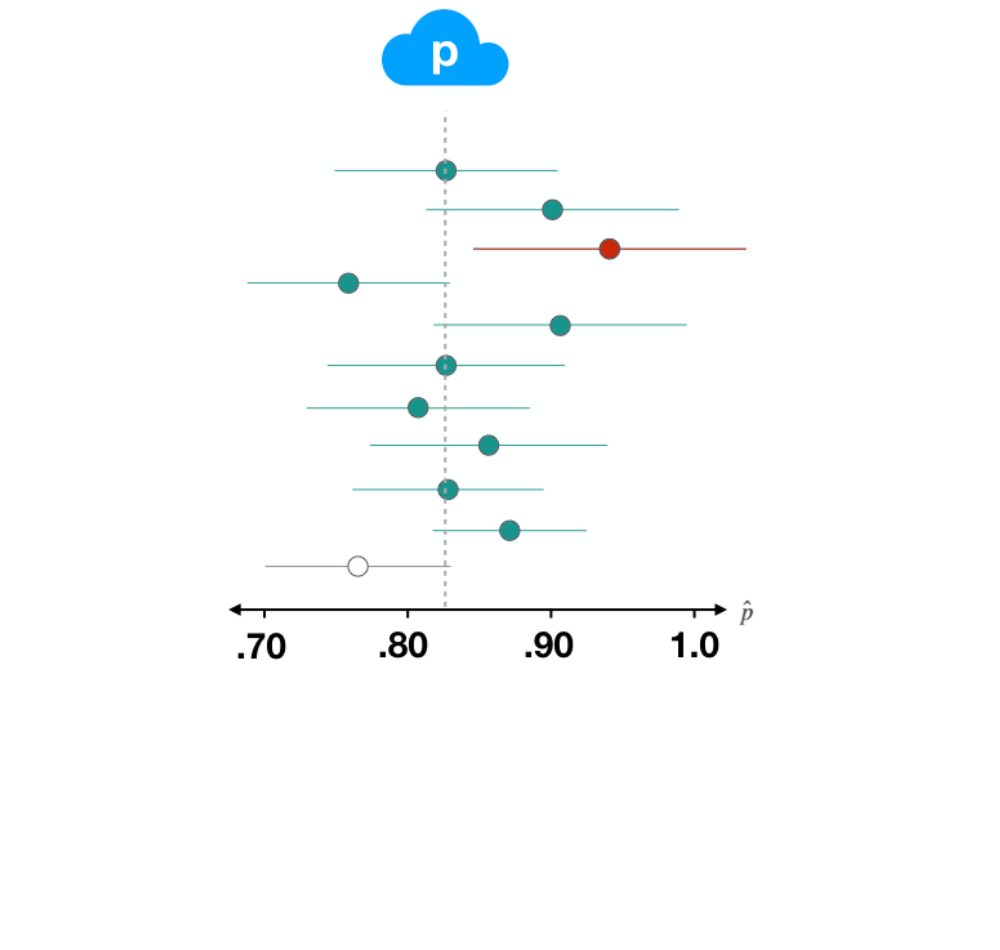
สรุป: สัดส่วนที่แท้จริงของชาวอเมริกันที่มีความสุขอยู่ระหว่าง 0.705 ถึง 0.841

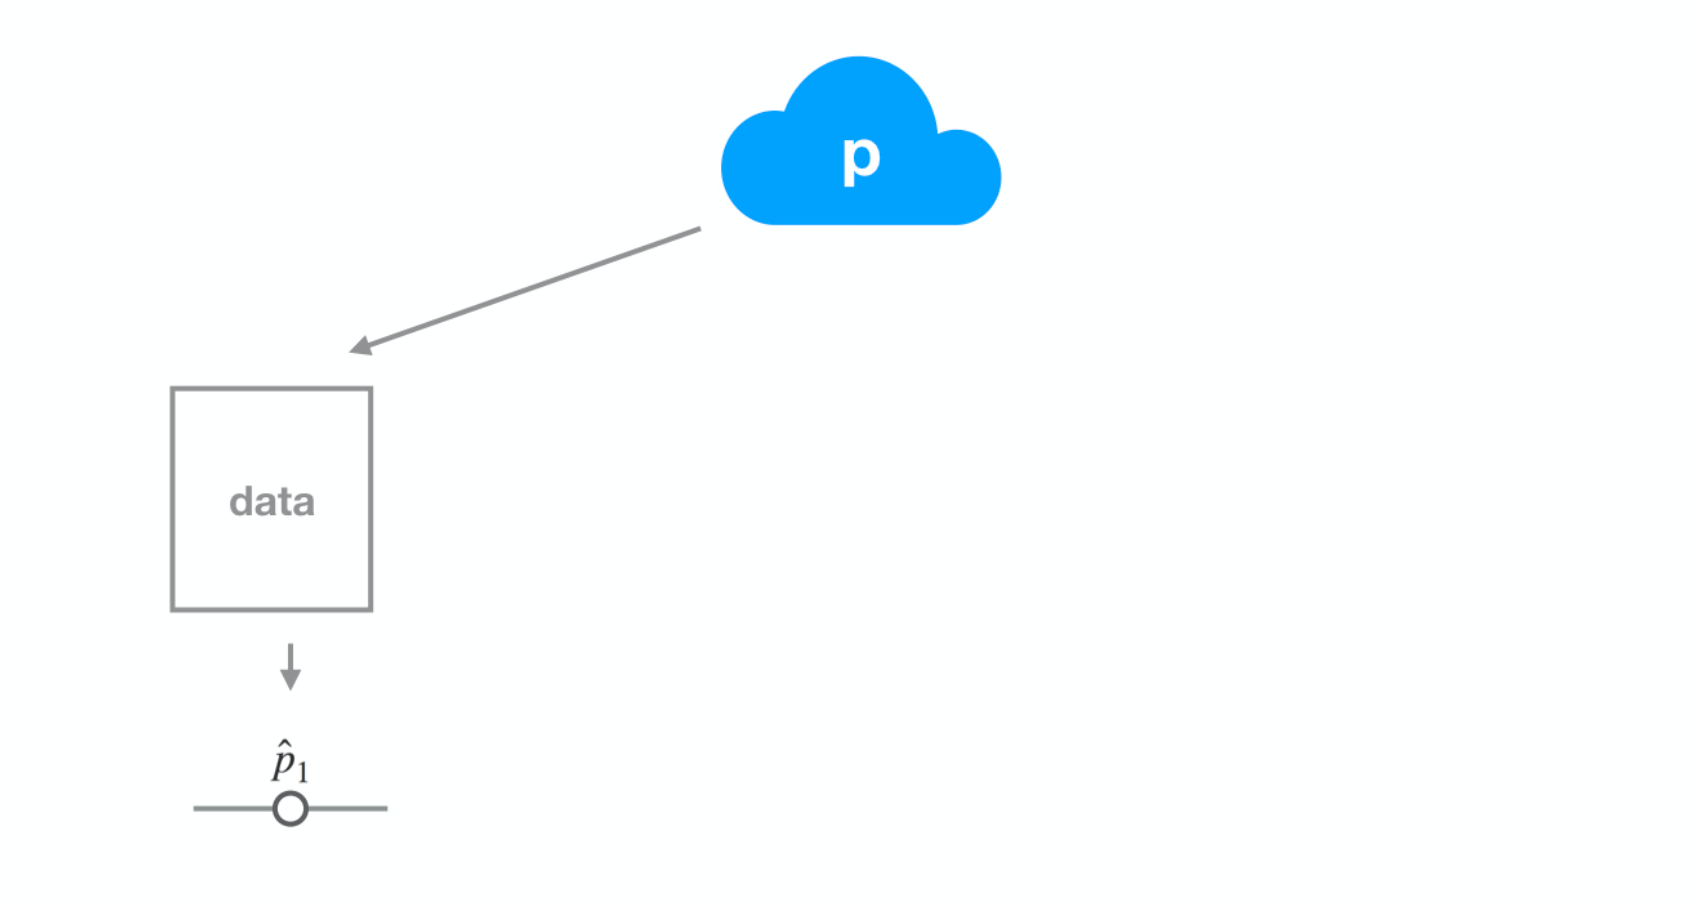
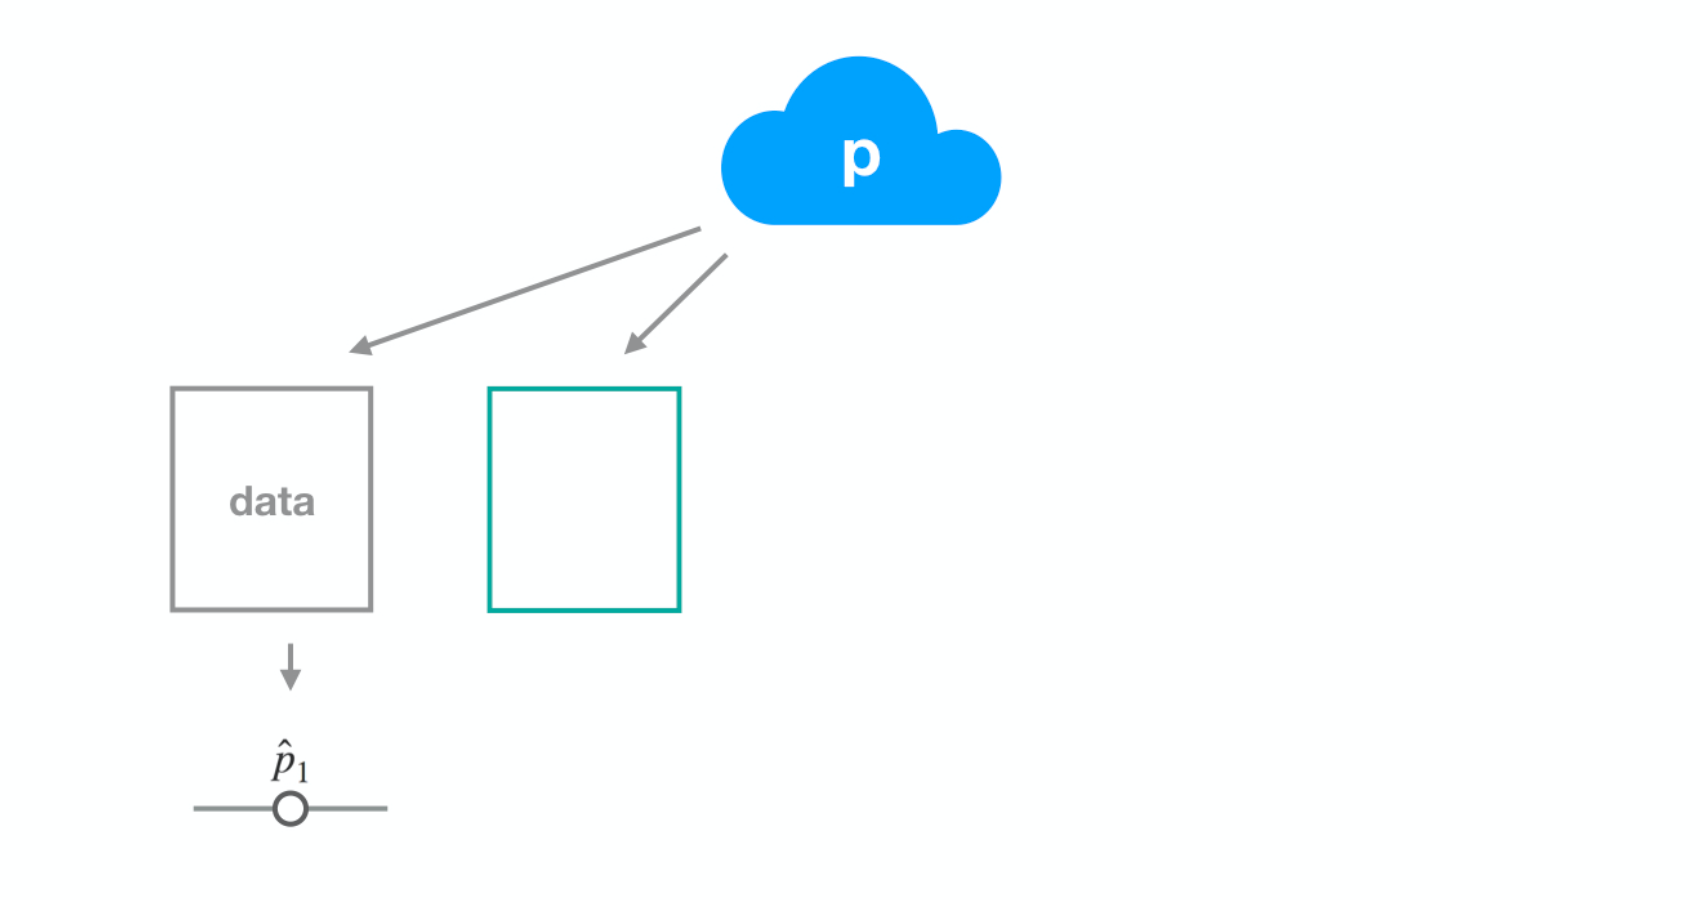
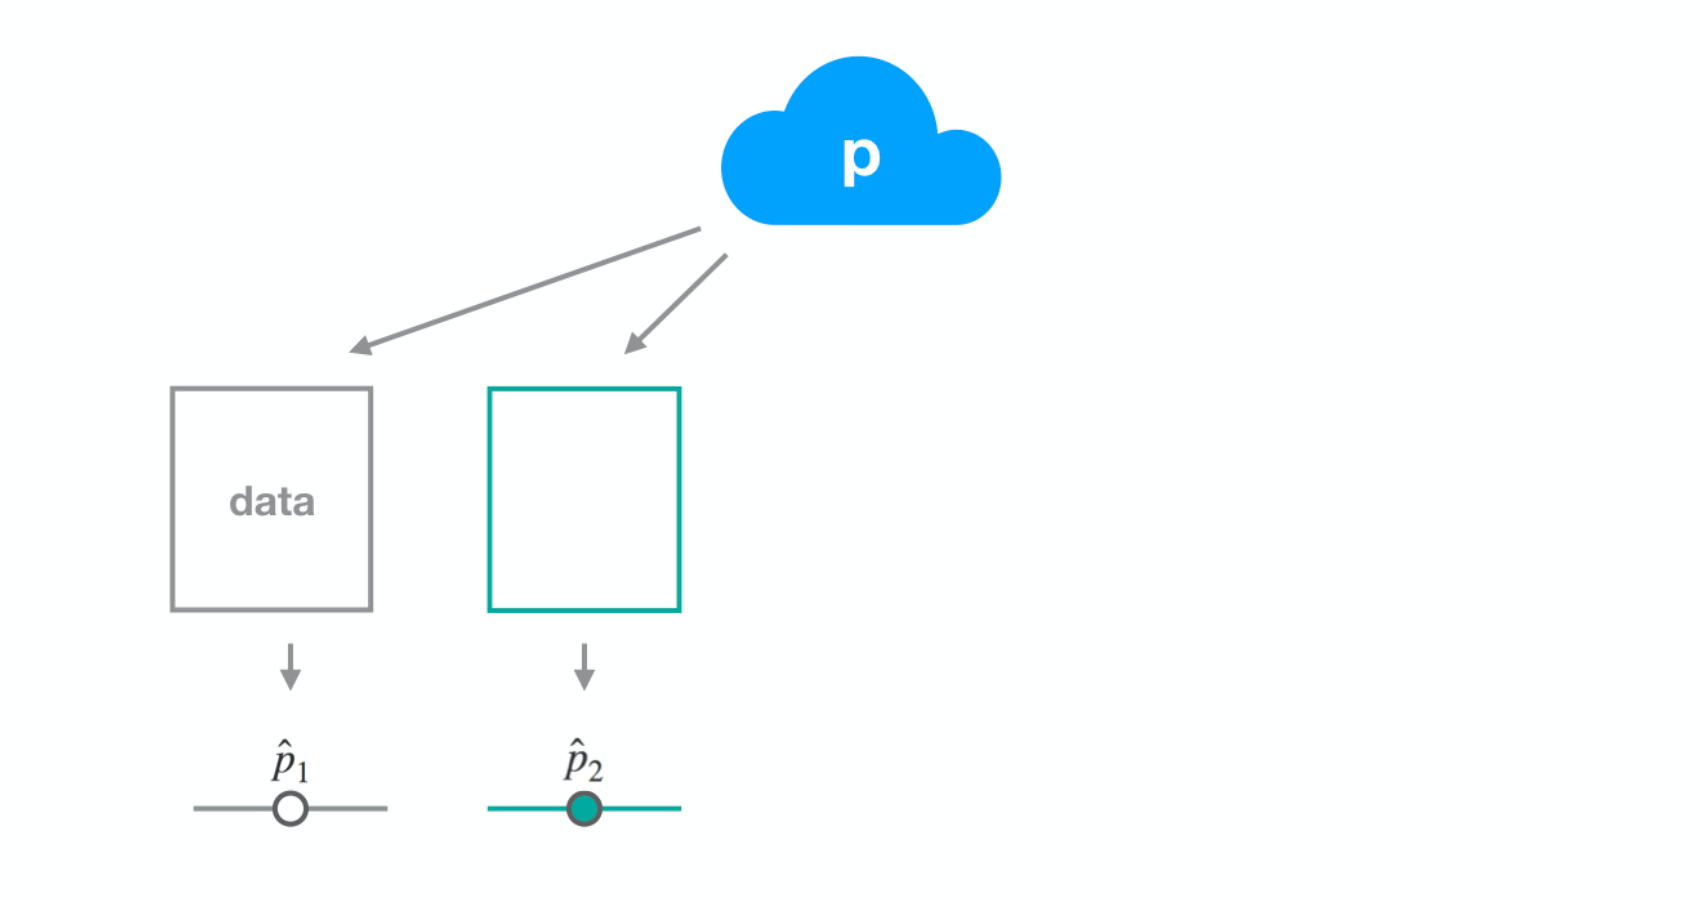
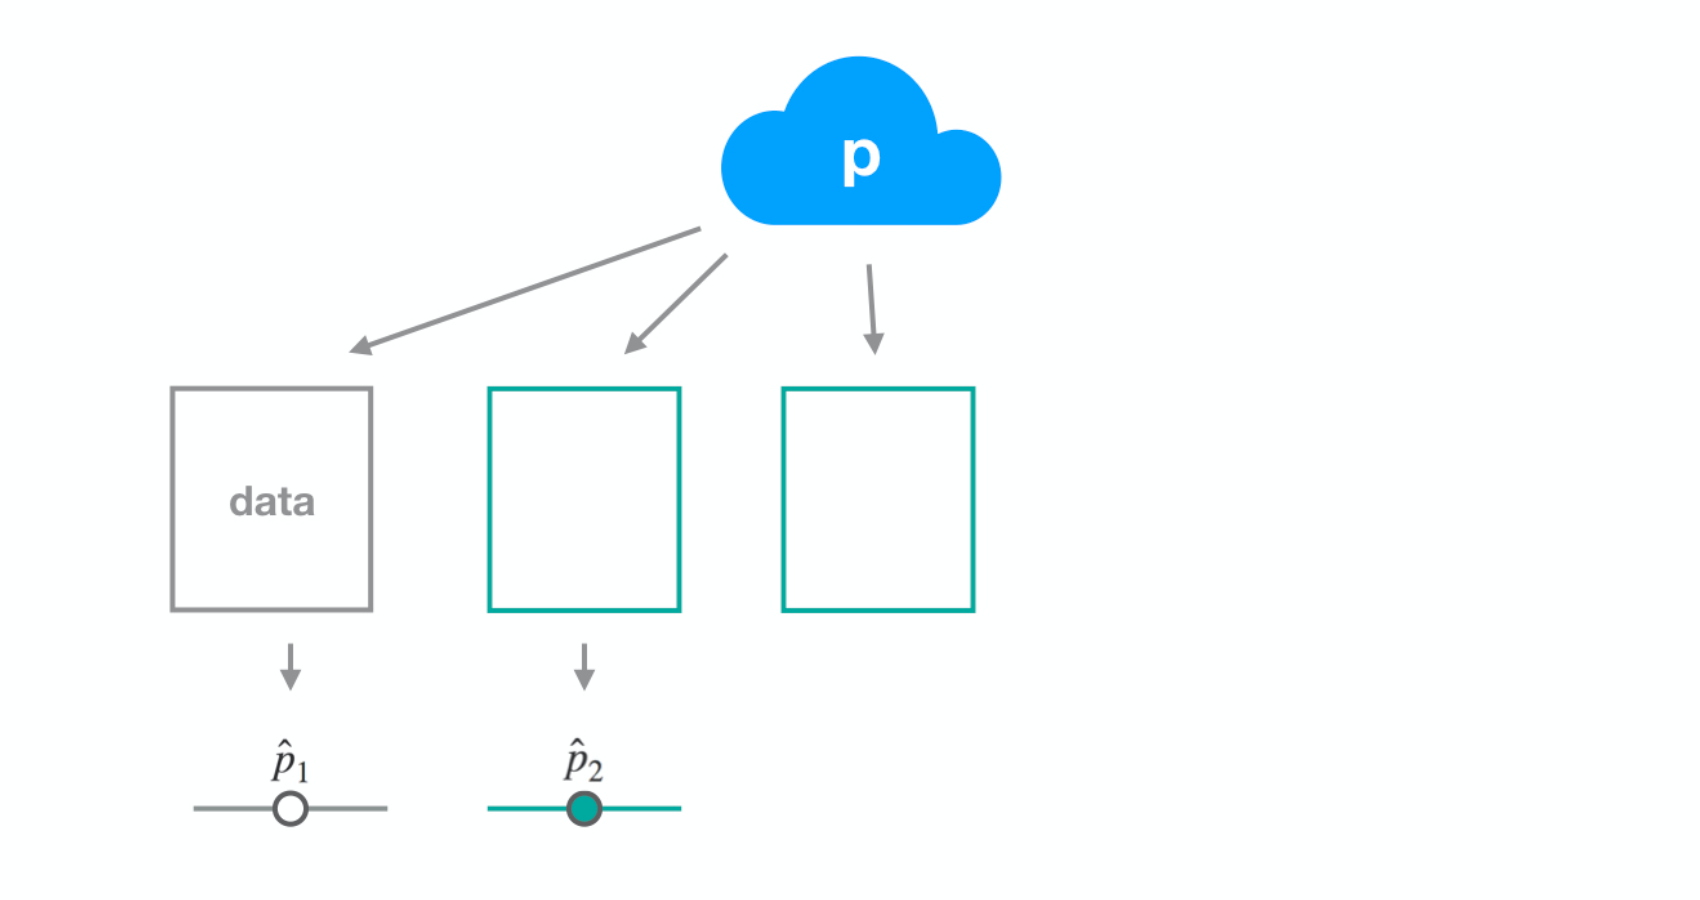
หมายความว่า มั่นใจ อย่างไร?

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 1

ds1 <- filter(gss, year == 2016)

p_hat <- ds1 %>% summarize(mean(happy == "HAPPY")) %>% pull()
SE <- ds1 %>% specify(response = happy, success = "HAPPY") %>% generate(reps = 500, type = "bootstrap") %>% calculate(stat = "prop") %>% summarize(sd(stat)) %>% pull()
c(p_hat - 2 * SE, p_hat + 2 * SE)
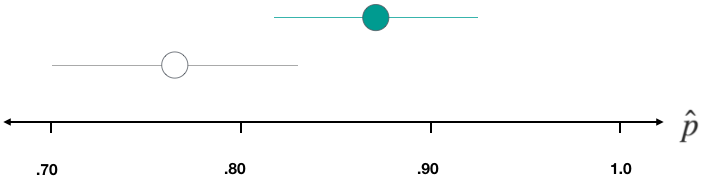
0.7073114 0.8393553

confidence-interval

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

one.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

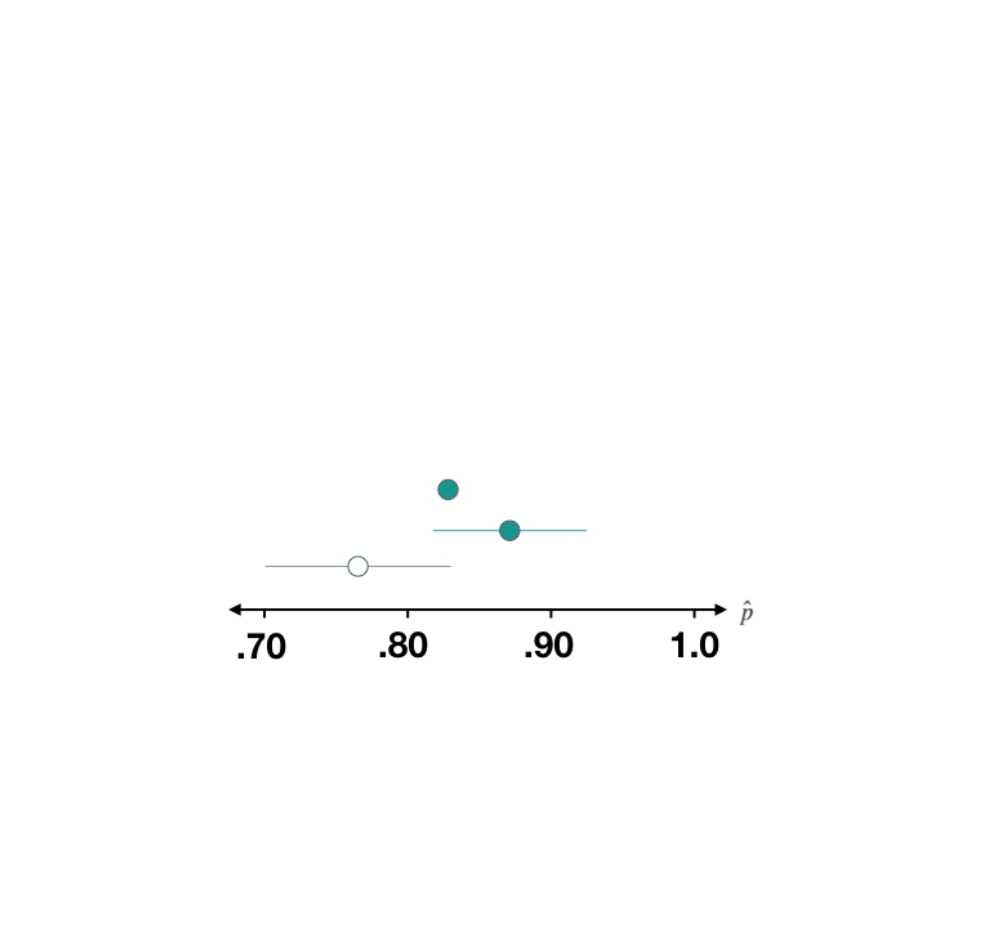
two.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

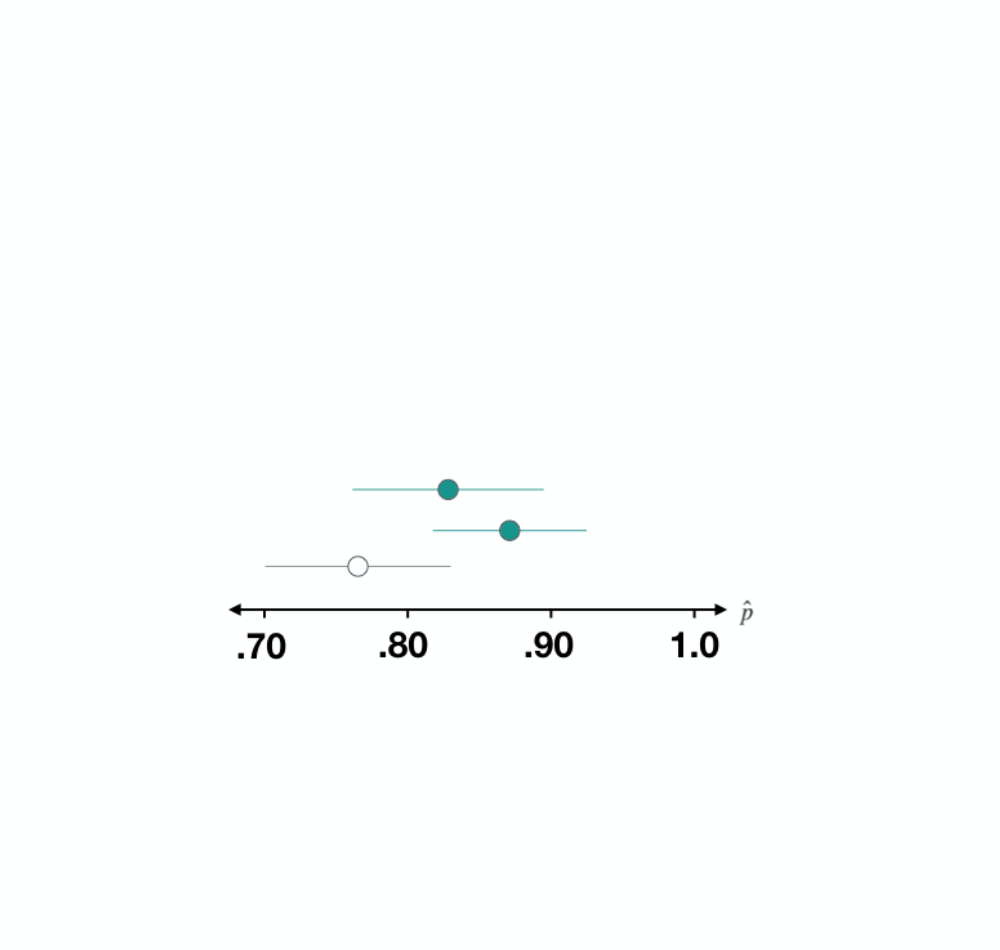
three.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

four.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

five.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

six.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

seven.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

eight.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

nine.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

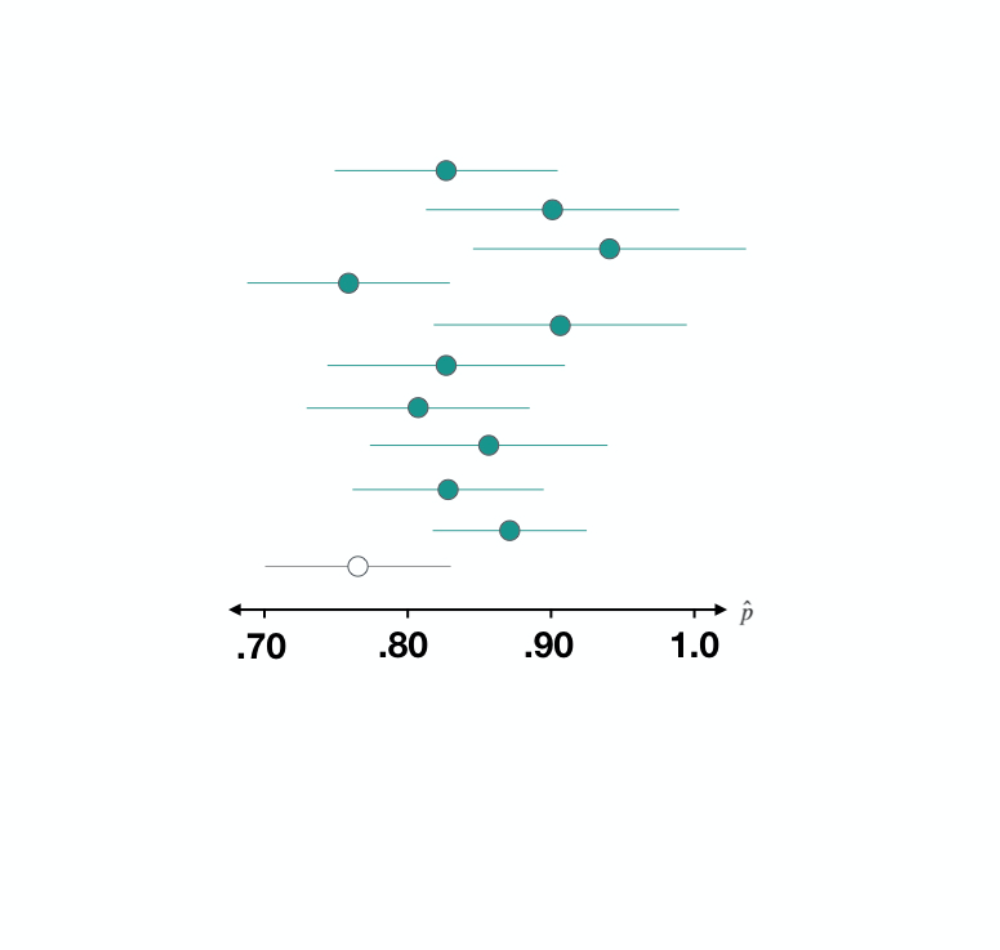
ten.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 2

ds2 <- filter(gss, year == 2014)

p_hat <- ds1 %>% summarize(mean(happy == "HAPPY")) %>% pull()
SE <- ds1 %>% specify(response = happy, success = "HAPPY") %>% generate(reps = 500, type = "bootstrap") %>% calculate(stat = "prop") %>% summarize(sd(stat)) %>% pull()
c(p_hat - 2 * SE, p_hat + 2 * SE)
0.8348831 0.9384503

Screenshot 2019-02-21 18.05.03.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 3

ds3 <- filter(gss, year == 2012)

p_hat <- ds1 %>% summarize(mean(happy == "HAPPY")) %>% pull()
SE <- ds1 %>% specify(response = happy, success = "HAPPY") %>% generate(reps = 500, type = "bootstrap") %>% calculate(stat = "prop") %>% summarize(sd(stat)) %>% pull()
c(p_hat - 2 * SE, p_hat + 2 * SE)
0.7626359 0.8906974

1-2-1.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 3

ds3 <- filter(gss, year == 2012)
p_hat <- ds3 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()
SE <- ds3 %>%
  specify(response = happy, 
          success = "HAPPY") %>%
  generate(reps = 500, 
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
0.7626359 0.8906974

1-2-2.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 3

ds3 <- filter(gss, year == 2012)
p_hat <- ds3 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()
SE <- ds3 %>%
  specify(response = happy, 
          success = "HAPPY") %>%
  generate(reps = 500, 
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
0.7626359 0.8906974

1-2-3.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 3

ds3 <- filter(gss, year == 2012)
p_hat <- ds3 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()
SE <- ds3 %>%
  specify(response = happy, 
          success = "HAPPY") %>%
  generate(reps = 500, 
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
0.7626359 0.8906974

1-2-4.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 3

ds3 <- filter(gss, year == 2012)
p_hat <- ds3 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()
SE <- ds3 %>%
  specify(response = happy, 
          success = "HAPPY") %>%
  generate(reps = 500, 
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
0.7626359 0.8906974

1-2-5.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ชุดข้อมูล 3

ds3 <- filter(gss, year == 2012)
p_hat <- ds3 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()
SE <- ds3 %>%
  specify(response = happy, 
          success = "HAPPY") %>%
  generate(reps = 500, 
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
0.7626359 0.8906974

1-2-6.png

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

ช่วงความเชื่อมั่น

การตีความ: "มั่นใจ 95% ว่าสัดส่วนที่แท้จริงของชาวอเมริกันที่มีความสุขอยู่ระหว่าง 0.705 ถึง 0.841"

ความกว้างของช่วงขึ้นอยู่กับ

  • n
  • ระดับความเชื่อมั่น
  • p
การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

มาฝึกกันเถอะ!

การอนุมานสำหรับข้อมูลเชิงหมวดหมู่ใน R

Preparing Video For Download...