Альтернативний метод: розподіл хі-квадрат

Статистичні висновки для категоріальних даних у R

Andrew Bray

Assistant Professor of Statistics at Reed College

Наближені розподіли: нормальний
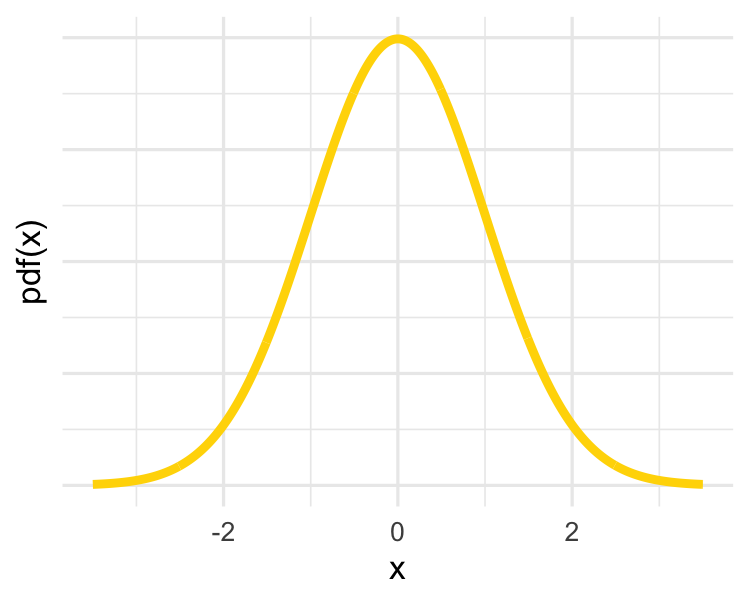
  • Статистики: $\hat{p}, \hat{p}_{1} - \hat{p}_{2}$

крива нормального розподілу

Статистичні висновки для категоріальних даних у R

Наближені розподіли: хі-квадрат

  • Статистика: $\hat{x}^{2}$
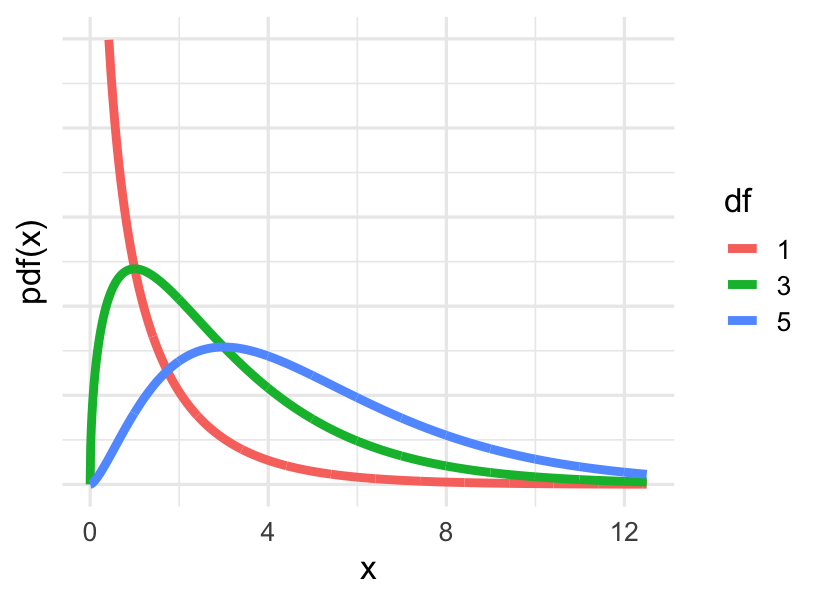
  • Форма визначається ступенями вільності
  • $df = (nrows - 1) \times (ncols - 1)$

крива розподілу хі-квадрат

Статистичні висновки для категоріальних даних у R

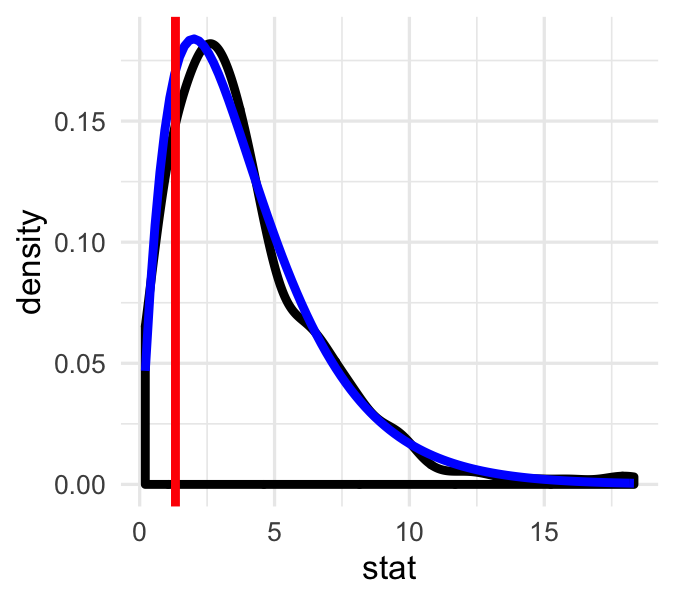
H-тест через наближення

null_spac <- gss_party %>%
  specify(natspac ~ party) %>%
  hypothesize(null = "independence") %>%
  generate(reps = 100, type = "permute") %>%
  calculate(stat = "Chisq")
ggplot(null_spac, aes(x = stat)) +
  geom_density() +
  stat_function(
    fun = dchisq, 
    args = list(df = 4), 
    color = "blue"
  ) +
  geom_vline(xintercept = chi_obs_spac, color = "red")

H-тест: наближення

Статистичні висновки для категоріальних даних у R

H-тест через наближення

gss_party %>%
  select(natarms, party) %>%
  table()
             party
natarms        D  I  R
  TOO LITTLE  17 20 24
  ABOUT RIGHT 14 28  8
  TOO MUCH    12 24  2
pchisq(chi_obs_spac, df = 4)
X-squared 
0.1430612
1 - pchisq(chi_obs_spac, df = 4)
X-squared 
0.8569388

H-тест: наближення

Статистичні висновки для категоріальних даних у R

Розподіл хі-квадрат

Стає гарним наближенням, коли:

  • $expected\_count >= 5$
  • $df >= 2$

крива розподілу хі-квадрат

Статистичні висновки для категоріальних даних у R

Давайте потренуємось!

Статистичні висновки для категоріальних даних у R

Preparing Video For Download...