Мультимодальний аналіз тональності

Багатомодальні моделі з Hugging Face

James Chapman

Curriculum Manager, DataCamp

Vision Language Models (VLMs)
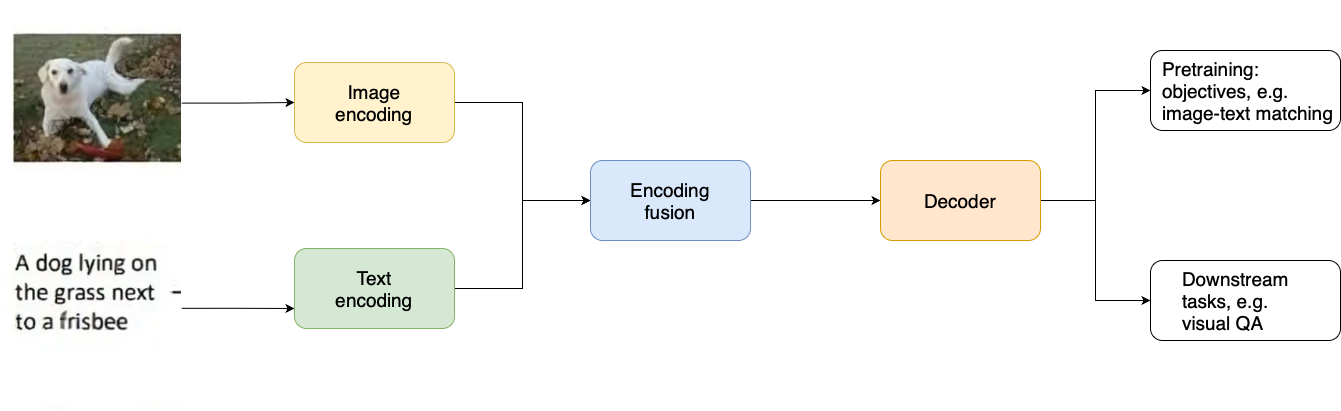
Схема архітектур моделей «зір+мова» загалом

  • Зображення й текст кодуються окремо
  • Злиття ознак
  • Створення спільних подань
    • Кілька завдань з однієї моделі
Багатомодальні моделі з Hugging Face

Завдання візуального міркування

  • VQA: Зображення + запитання → Прямі відповіді про вміст зображення
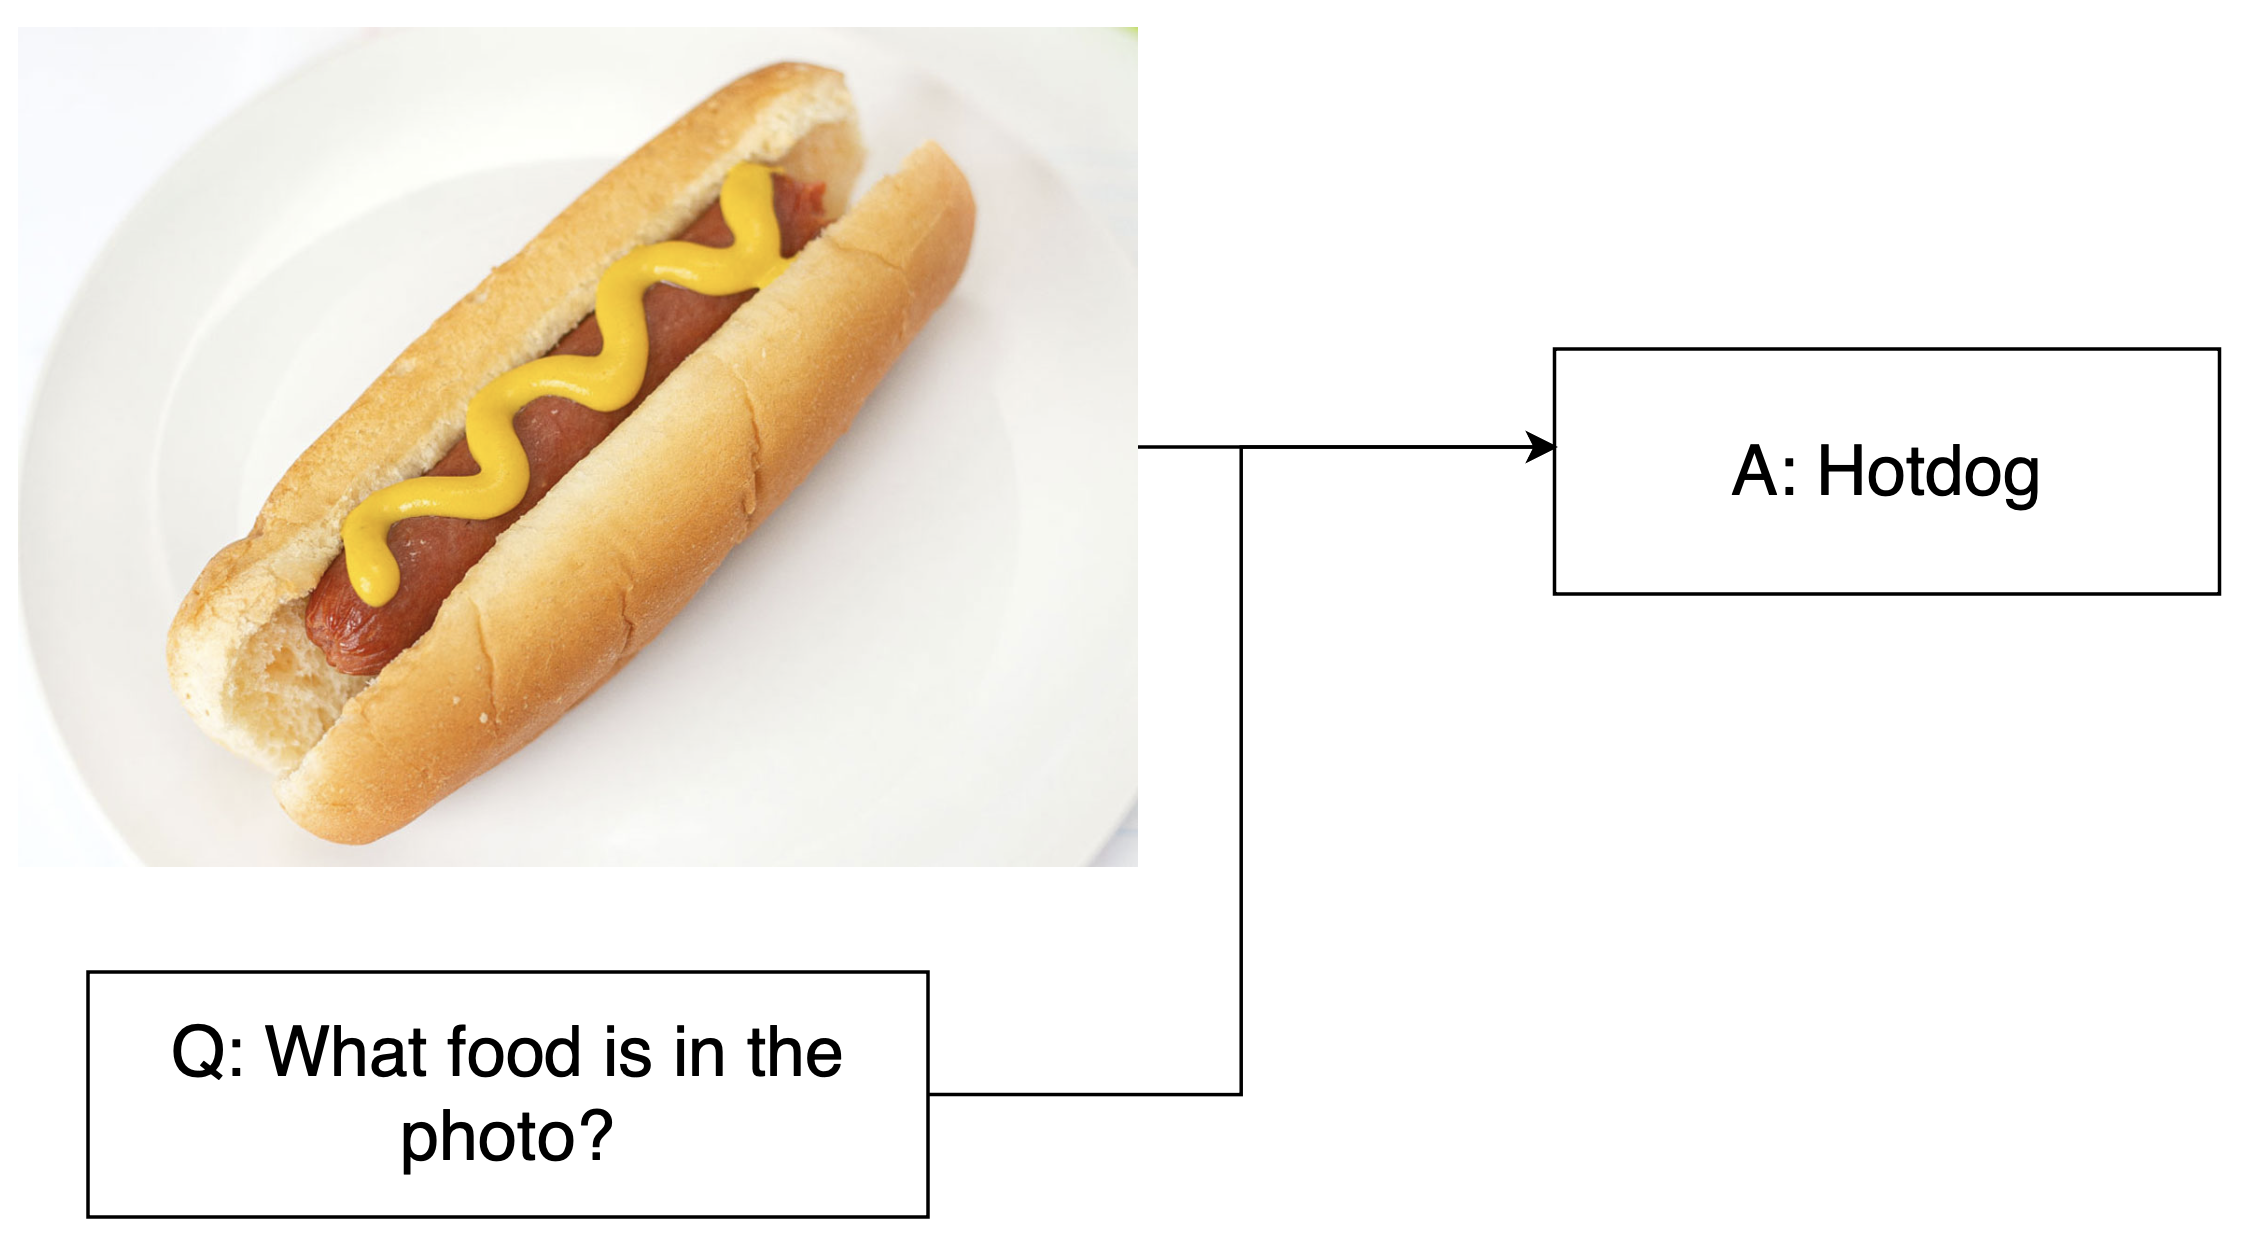
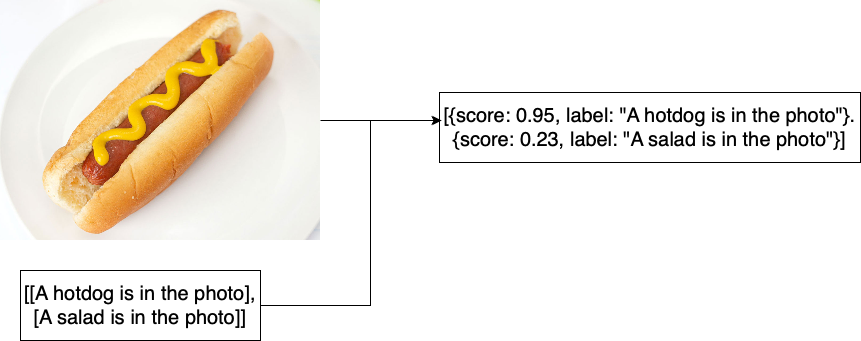
Відповіді на візуальні запитання про хот-дог

1 https://arxiv.org/pdf/1505.00468
Багатомодальні моделі з Hugging Face

Завдання візуального міркування

  • VQA: Зображення + запитання → Прямі відповіді про вміст зображення
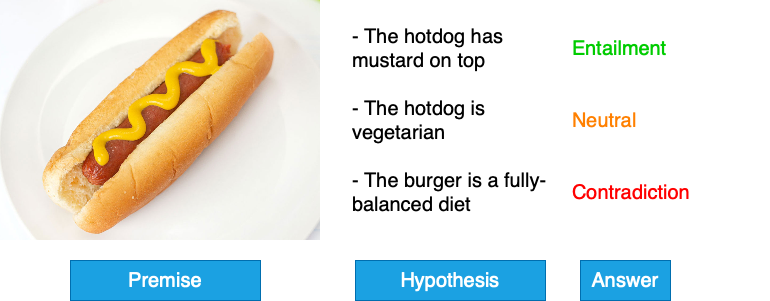
  • Відповідність: Зображення + твердження → Перевірка істинності

Приклад відповідностей із хот-догом і пов'язаними твердженнями

Багатомодальні моделі з Hugging Face

Завдання візуального міркування

  • VQA: Зображення + запитання → Прямі відповіді про вміст зображення
  • Відповідності: Зображення + твердження → Перевірка істинності
  • Ентейлмент: Зображення + контрастні тексти → Перевірка семантичного зв'язку

Приклад ентейлменту з хот-догом: підтвердження, нейтральні та суперечні гіпотези

Багатомодальні моделі з Hugging Face

Кейс: вплив на ціну акцій

from datasets import load_dataset
dset = "RealTimeData/bbc_news_alltime"
dataset = load_dataset(dset, '2017-01', 
                       split="train")


image = dataset[87]["top_image"] content = dataset[87]["content"] print(content)
'Ford\'s decision to cancel a $1.6bn 
investment in Mexico and 
invest an extra $700m in Michigan ...

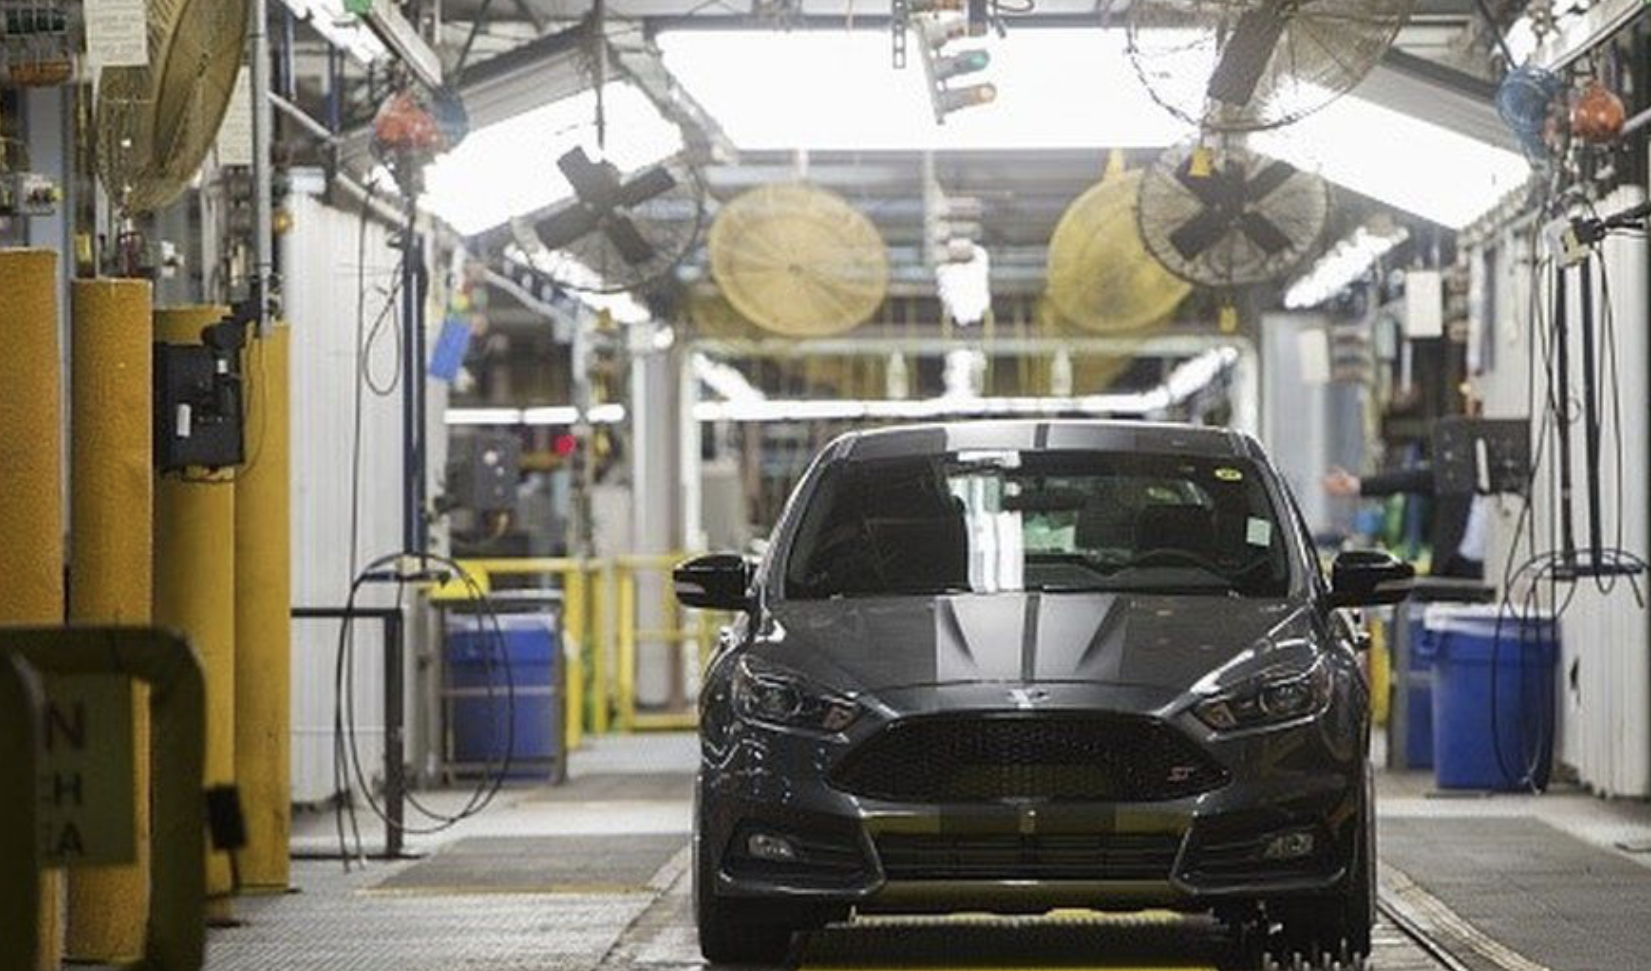
зображення зі статті новин про інвестиції у виробництво авто

Багатомодальні моделі з Hugging Face

Qwen 2 VLMs

from transformers import Qwen2VLForConditionalGeneration
from qwen_vl_utils import process_vision_info


vl_model = Qwen2VLForConditionalGeneration.from_pretrained( "Qwen/Qwen2-VL-2B-Instruct", device_map="auto", torch_dtype="auto" )
Багатомодальні моделі з Hugging Face

Препроцесор

from transformers import Qwen2VLProcessor

min_pixels = 224 * 224
max_pixels = 448 * 448
vl_model_processor = Qwen2VLProcessor.from_pretrained(
    "Qwen/Qwen2-VL-2B-Instruct", min_pixels=min_pixels, max_pixels=max_pixels
)
Багатомодальні моделі з Hugging Face

Мультимодальні підказки

text_query = f"Is the sentiment of the following content good or bad for the Ford share price:
{article_text}. Provide reasoning."


chat_template = [ { "role": "user", "content": [ {"type": "image", "image": article_image}, {"type": "text", "text": text_query} ] } ]
Багатомодальні моделі з Hugging Face

Класифікація VLM

text = vl_model_processor.apply_chat_template(chat_template, tokenize=False,
                                              add_generation_prompt=True)

image_inputs, _ = process_vision_info(chat_template)
inputs = vl_model_processor(text=[text], images=image_inputs, padding=True, return_tensors="pt")
generated_ids = vl_model.generate(**inputs, max_new_tokens=500)
generated_ids_trimmed = [out_ids[len(in_ids) :] for in_ids, out_ids\ in zip(inputs.input_ids, generated_ids)]
Багатомодальні моделі з Hugging Face

Класифікація VLM

output_text = vl_model_processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_text[0])
The sentiment of the provided text is negative. The author is expressing concern and
skepticism ...
Багатомодальні моделі з Hugging Face

Давайте потренуємось!

Багатомодальні моделі з Hugging Face

Preparing Video For Download...