Розпізнавання мовлення та генерування аудіо

Багатомодальні моделі з Hugging Face

James Chapman

Curriculum Manager, DataCamp

Мовлення
 

Які важливі складові мовних хвиль?

  • Висота тону: середня частота для чоловіків 85–180 Гц, для жінок 165–255 Гц
  • Наголос: залежить від мови, акценту та емоцій
  • Ритм: залежить від контексту, емоцій і мови


Публікація в соцмережах

Багатомодальні моделі з Hugging Face

Автоматичне розпізнавання мовлення

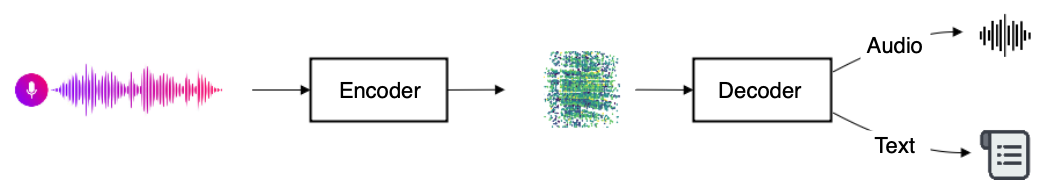
Аудіо кодується, потім декодується в аудіо або текст.

  • І текст, і аудіо є послідовними
  • Приклади: транскрипція, переклад, озвучення тексту
Багатомодальні моделі з Hugging Face

Автоматичне розпізнавання мовлення

  • Модель Tiny: 39 млн параметрів, розмір 150 МБ
  • Дані для навчання: 680 тис. годин (розмічені)
from transformers import WhisperProcessor, WhisperForConditionalGeneration
processor = WhisperProcessor.from_pretrained("openai/whisper-tiny")
model = WhisperForConditionalGeneration.from_pretrained("openai/whisper-tiny")
1 https://github.com/openai/whisper
Багатомодальні моделі з Hugging Face

Автоматичне розпізнавання мовлення

from datasets import load_dataset, Audio
dataset = load_dataset("CSTR-Edinburgh/vctk")["train"]
dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))

sample = dataset[0]["audio"]
input_preprocessed = processor(sample["array"], sampling_rate=sample["sampling_rate"], return_tensors="pt")
predicted_ids = model.generate(input_preprocessed.input_features)
transcription = processor.batch_decode(predicted_ids, skip_special_tokens=True) print(transcription)
['Please cool Stella.']
Багатомодальні моделі з Hugging Face

Генерування аудіо

Три компоненти для генерування аудіо:

  • Препроцесор: ресемплінг і вилучення ознак
  • Модель: перетворення ознак
  • Вокодер: окрема генеративна модель для хвильових форм аудіо
from transformers import SpeechT5Processor, SpeechT5ForSpeechToSpeech, SpeechT5HifiGan

processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_vc") model = SpeechT5ForSpeechToSpeech.from_pretrained("microsoft/speecht5_vc") vocoder = SpeechT5HifiGan.from_pretrained("microsoft/speecht5_hifigan")
Багатомодальні моделі з Hugging Face

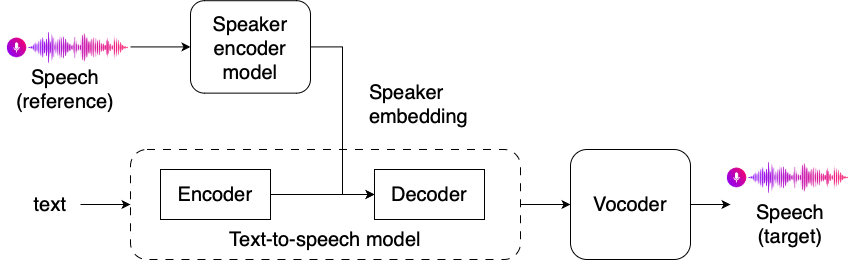
Вбудовування мовлення

Схема того, як вбудовування мовця використовується в конвеєрі генерування мовлення

Багатомодальні моделі з Hugging Face

Генерування вбудовувань мовця

  • Попередньо натренований енкодер: масив хвильової форми аудіо → закодований масив (зазвичай 512 вимірів)
from speechbrain.inference.speaker import EncoderClassifier
speaker_model = EncoderClassifier.from_hparams(source="speechbrain/spkrec-xvect-voxceleb")
speaker_embeddings = speaker_model.encode_batch(torch.tensor(dataset[0]["audio"]["array"]))

speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2).unsqueeze(0)
Багатомодальні моделі з Hugging Face

Генерування аудіо

inputs = processor(audio=dataset[0]["audio"], 
                   sampling_rate=dataset[0]["audio"]["sampling_rate"], 
                   return_tensors="pt")


speech = model.generate_speech(inputs["input_values"], speaker_embedding, vocoder=vocoder)
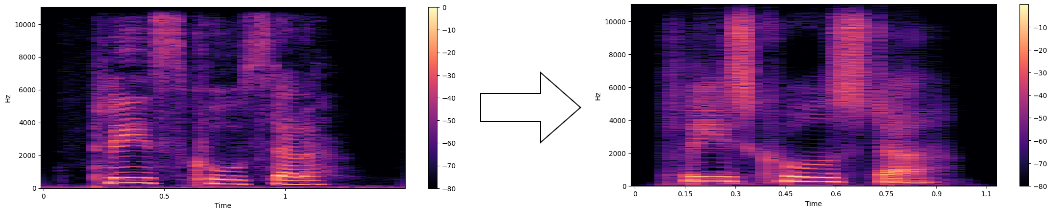
Спектрограма до і після

Багатомодальні моделі з Hugging Face

Давайте потренуємось!

Багатомодальні моделі з Hugging Face

Preparing Video For Download...