Попередня обробка різних модальностей

Багатомодальні моделі з Hugging Face

James Chapman

Curriculum Manager, DataCamp

Попередня обробка тексту
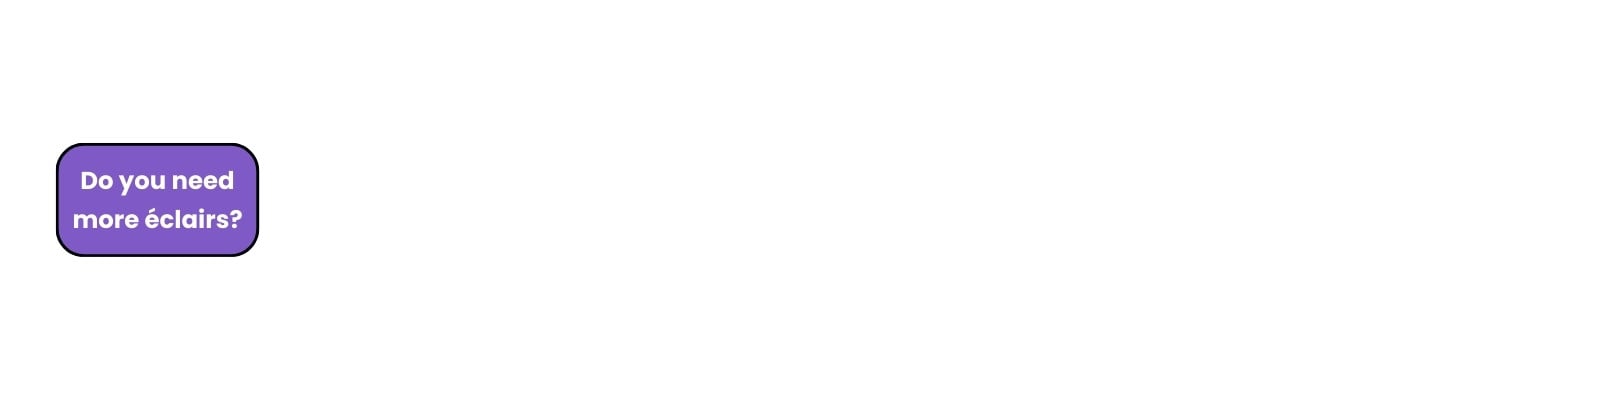
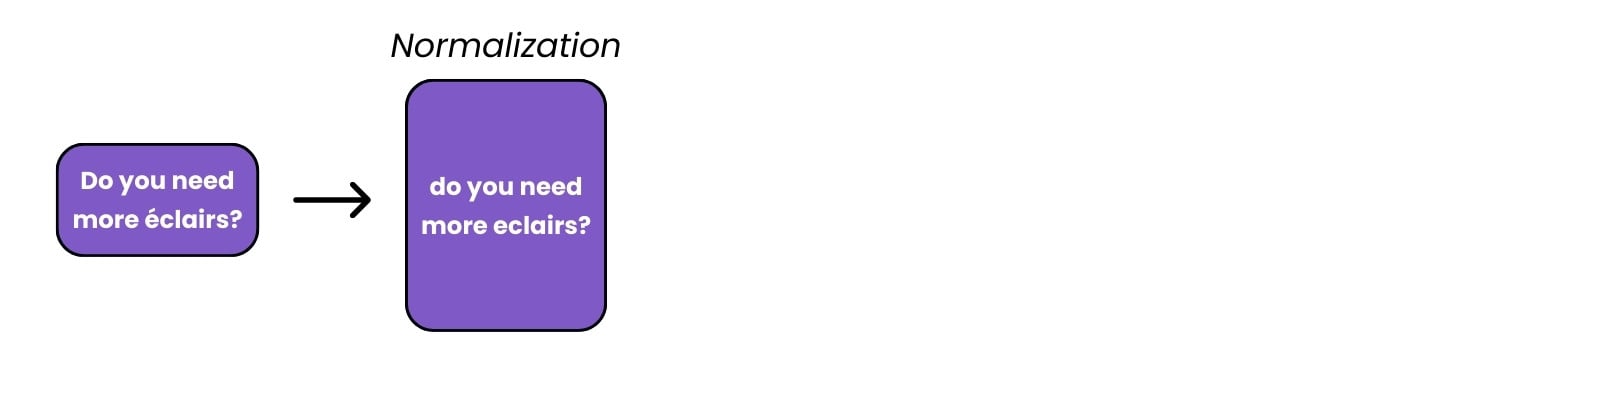
Приклад текстового рядка.

  • Tokenizer: перетворює текст → на вхід моделі
Багатомодальні моделі з Hugging Face

Попередня обробка тексту

Схема обробки тексту до нормалізації

  • Tokenizer: перетворює текст → на вхід моделі
    • Нормалізація: зниження регістру, вилучення спецсимволів, зайвих пробілів
Багатомодальні моделі з Hugging Face

Попередня обробка тексту

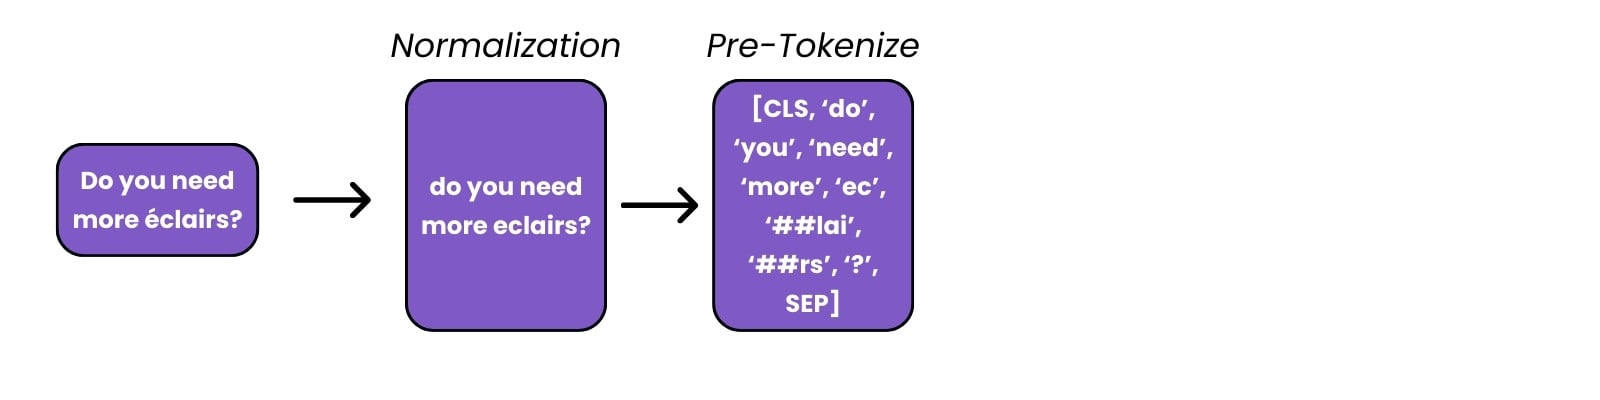
Продовження схеми до токенізації

  • Tokenizer: перетворює текст → на вхід моделі
    • Нормалізація: зниження регістру, вилучення спецсимволів, зайвих пробілів
    • (Пре)токенізація: поділ тексту на слова/підслова
Багатомодальні моделі з Hugging Face

Попередня обробка тексту

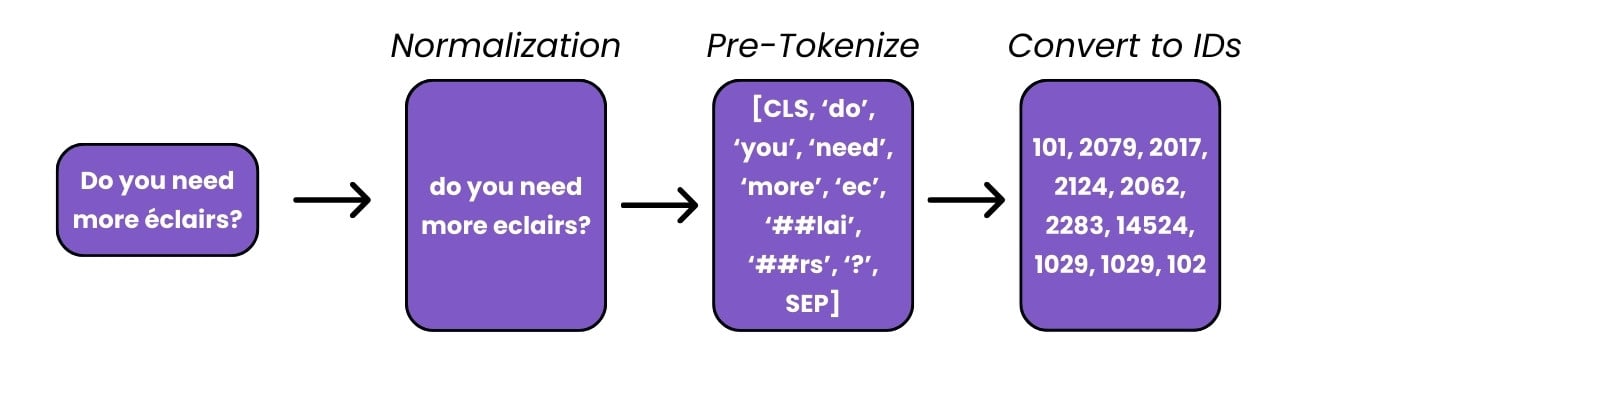
Продовження схеми до перетворення в ID та доповнення

  • Tokenizer: перетворює текст → на вхід моделі
    • Нормалізація: зниження регістру, вилучення спецсимволів, пробілів
    • (Пре)токенізація: поділ тексту на слова/підслова
    • Перетворення в ID: відображення токенів у цілі числа за словником
Багатомодальні моделі з Hugging Face

Попередня обробка тексту

preprocessing_text5.jpg

  • Tokenizer: перетворює текст → на вхід моделі
    • Нормалізація: зниження регістру, вилучення спецсимволів, пробілів
    • (Пре)токенізація: поділ тексту на слова/підслова
    • Перетворення в ID: відображення токенів у цілі числа за словником
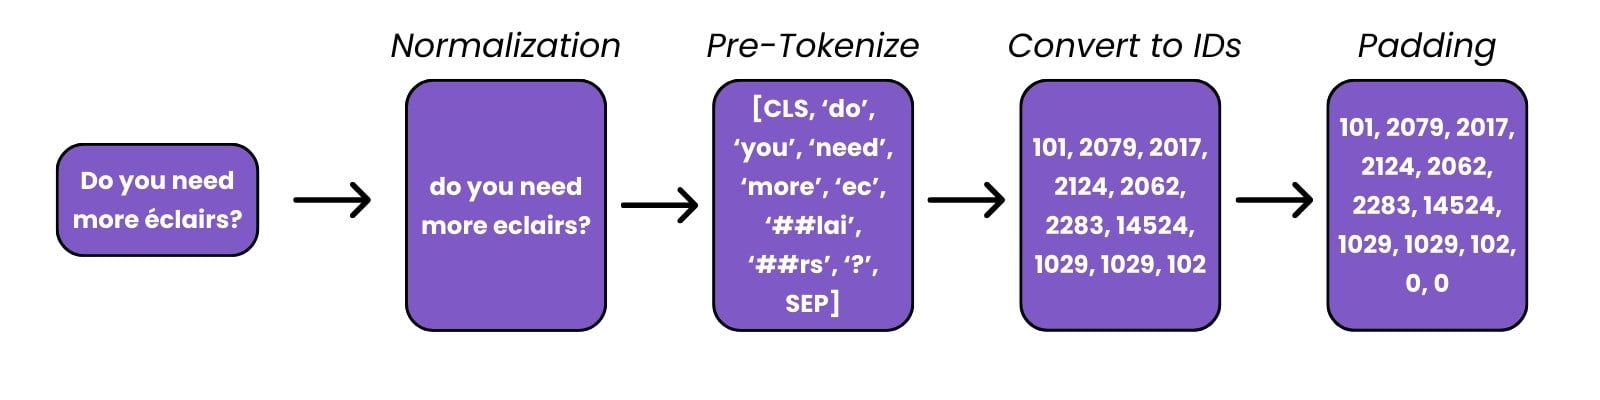
    • Доповнення (padding): додавання токенів для однакової довжини
Багатомодальні моделі з Hugging Face

Попередня обробка тексту

from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained('distilbert/distilbert-base-uncased')

text = "Do you need more éclairs?"
print(tokenizer.backend_tokenizer.normalizer.normalize_str(text))
do you need more eclairs
tokenizer(text, return_tensors='pt', padding=True)
{'input_ids': tensor([[  101,  ..., 102]]), ...}
Багатомодальні моделі з Hugging Face

Попередня обробка зображень

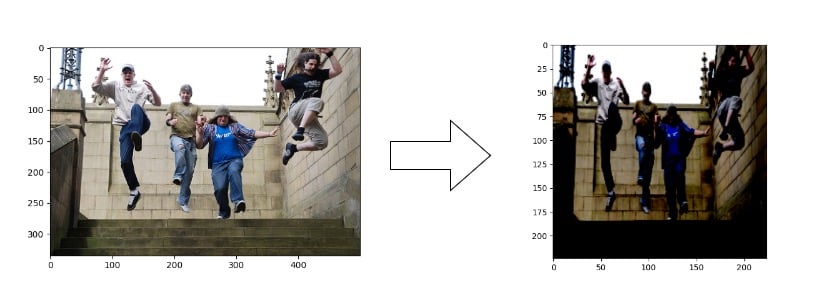
  • Нормалізація: масштабування інтенсивності пікселів
  • Зміна розміру: узгодження з вхідним шаром моделі
  • Загальне правило → використовуйте препроцесинг оригінальної моделі

зображення групи людей, що стрибають, до і після попередньої обробки

1 https://huggingface.co/datasets/nlphuji/flickr30k
Багатомодальні моделі з Hugging Face

Попередня обробка зображень

Мультимодальні задачі потребують узгодженого препроцесингу:

from transformers import BlipProcessor, BlipForConditionalGeneration

checkpoint = "Salesforce/blip-image-captioning-base"
model = BlipForConditionalGeneration.from_pretrained(checkpoint) processor = BlipProcessor.from_pretrained(checkpoint)

Кодуйте зображення → перетворіть у текстове кодування → декодуйте текст

image = load_dataset("nlphuji/flickr30k")['test'][11]["image"]
inputs = processor(images=image, return_tensors="pt")

output = model.generate(**inputs)
print(processor.decode(output[0]))
[{'generated_text': 'a group of people jumping'}]
Багатомодальні моделі з Hugging Face

Попередня обробка аудіо

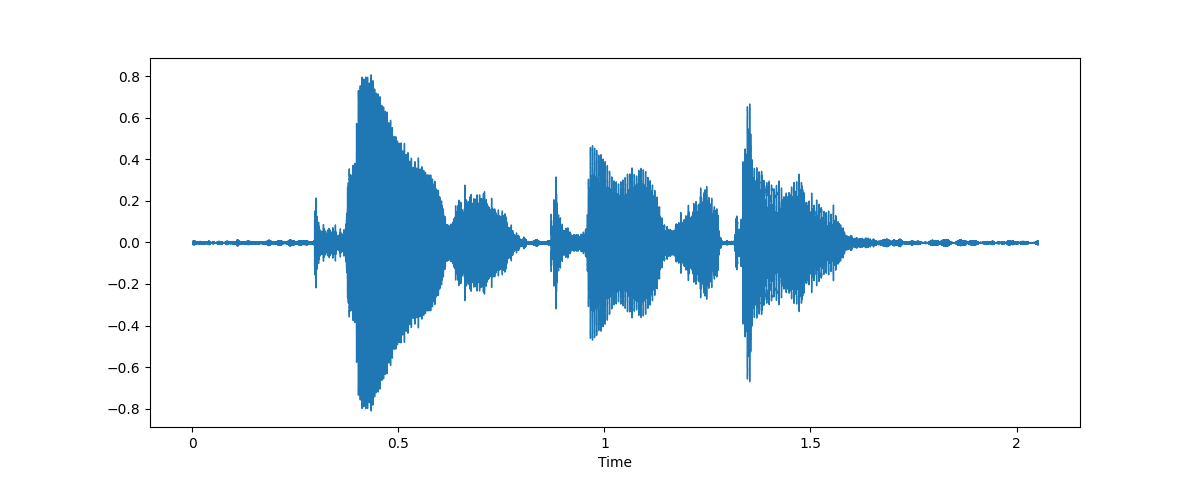
Аудіоспектр

  • Попередня обробка аудіо:
    • Послідовний масив → фільтрація/доповнення
    • Частота дискретизації → ресемплінг

Добування ознак як вхід моделі (спектрограма)
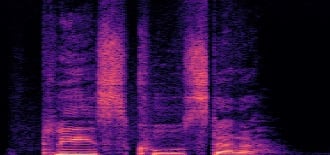
spectro

Багатомодальні моделі з Hugging Face

Попередня обробка аудіо

from datasets import load_dataset, Audio

dataset = load_dataset("CSTR-Edinburgh/vctk")["train"] dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))
  • Повні препроцесори для конкретних моделей зазвичай доступні:
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("openai/whisper-small")
audio_pp = processor(dataset[0]["audio"]["array"], 
                     sampling_rate=16_000, return_tensors="pt")
  • Частота дискретизації має відповідати вимогам моделі
1 https://huggingface.co/datasets/CSTR-Edinburgh/vctk
Багатомодальні моделі з Hugging Face

Давайте потренуємось!

Багатомодальні моделі з Hugging Face

Preparing Video For Download...