Візуальне питання‑відповідь (VQA)

Багатомодальні моделі з Hugging Face

James Chapman

Curriculum Manager, DataCamp

Мультимодальні завдання QA
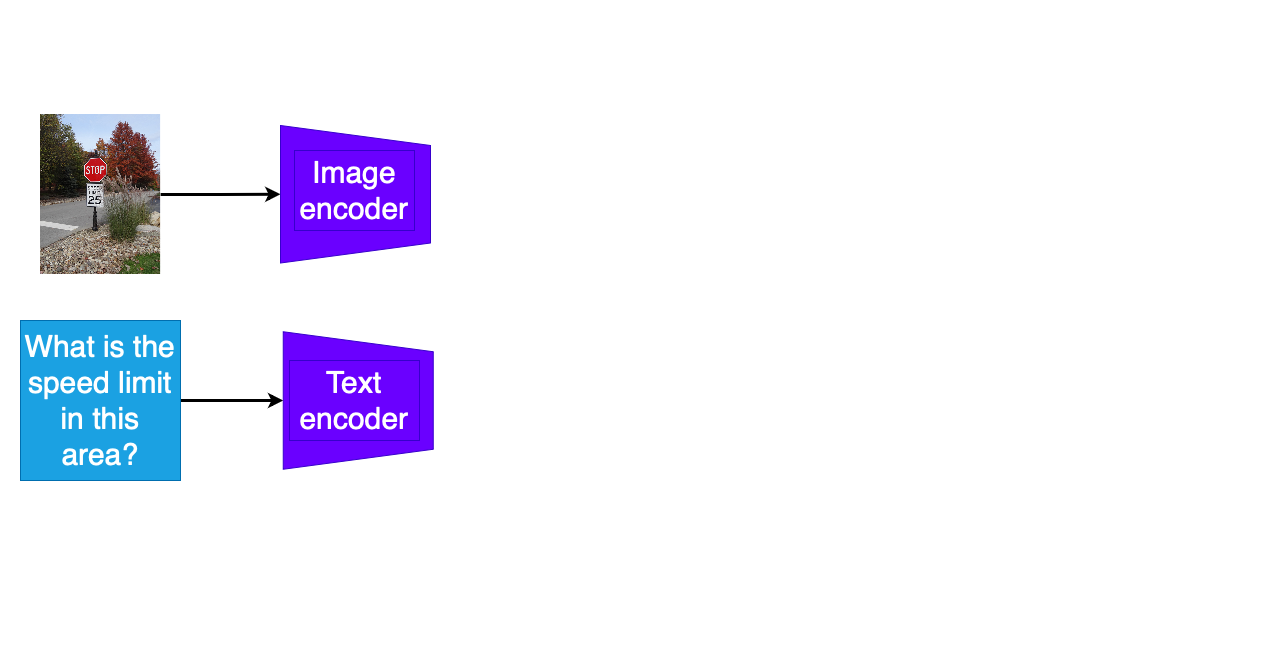
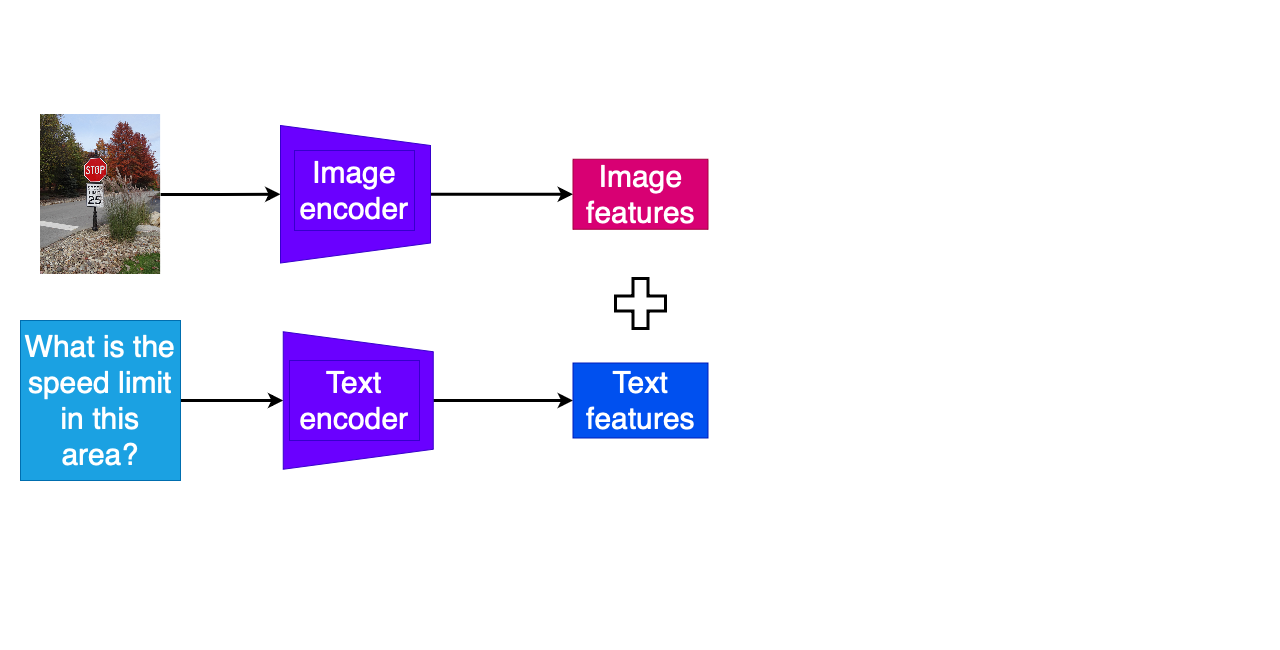
Схема обробки зображення й тексту в моделі VQA

  1. Окреме кодування тексту запитання та іншої модальності
Багатомодальні моделі з Hugging Face

Мультимодальні завдання QA

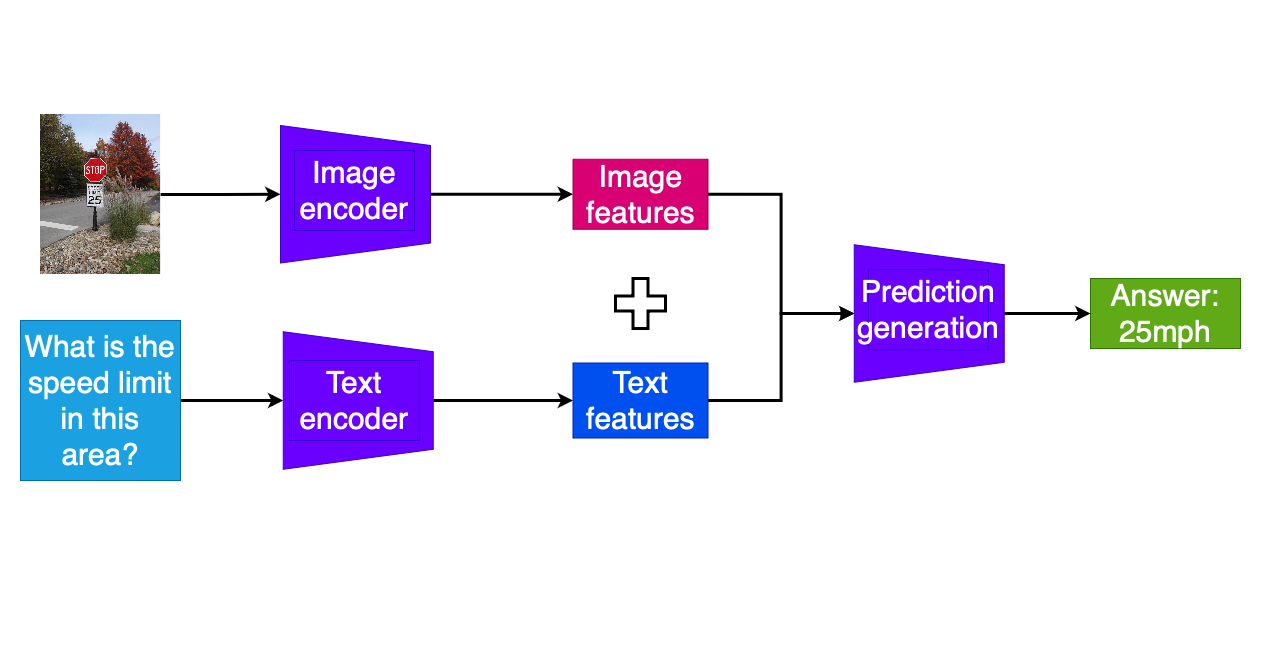
Схема обробки зображення й тексту в моделі VQA

  1. Окреме кодування тексту запитання та іншої модальності
  2. Поєднання закодованих ознак
Багатомодальні моделі з Hugging Face

Мультимодальні завдання QA

Схема обробки зображення й тексту в моделі VQA

  1. Окреме кодування тексту запитання та іншої модальності
  2. Поєднання закодованих ознак
  3. Додаткові шари моделі для передбачення токенів відповіді
Багатомодальні моделі з Hugging Face

VQA

import requests
from PIL import Image

url = "https://www.worldanimalprotection
.org/cdn-cgi/image/width=1920,format=
auto/globalassets/images/elephants/1
033551-elephant.jpg"


image = Image.open(requests.get(url, stream=True).raw)
text = "What animal is in this photo?"

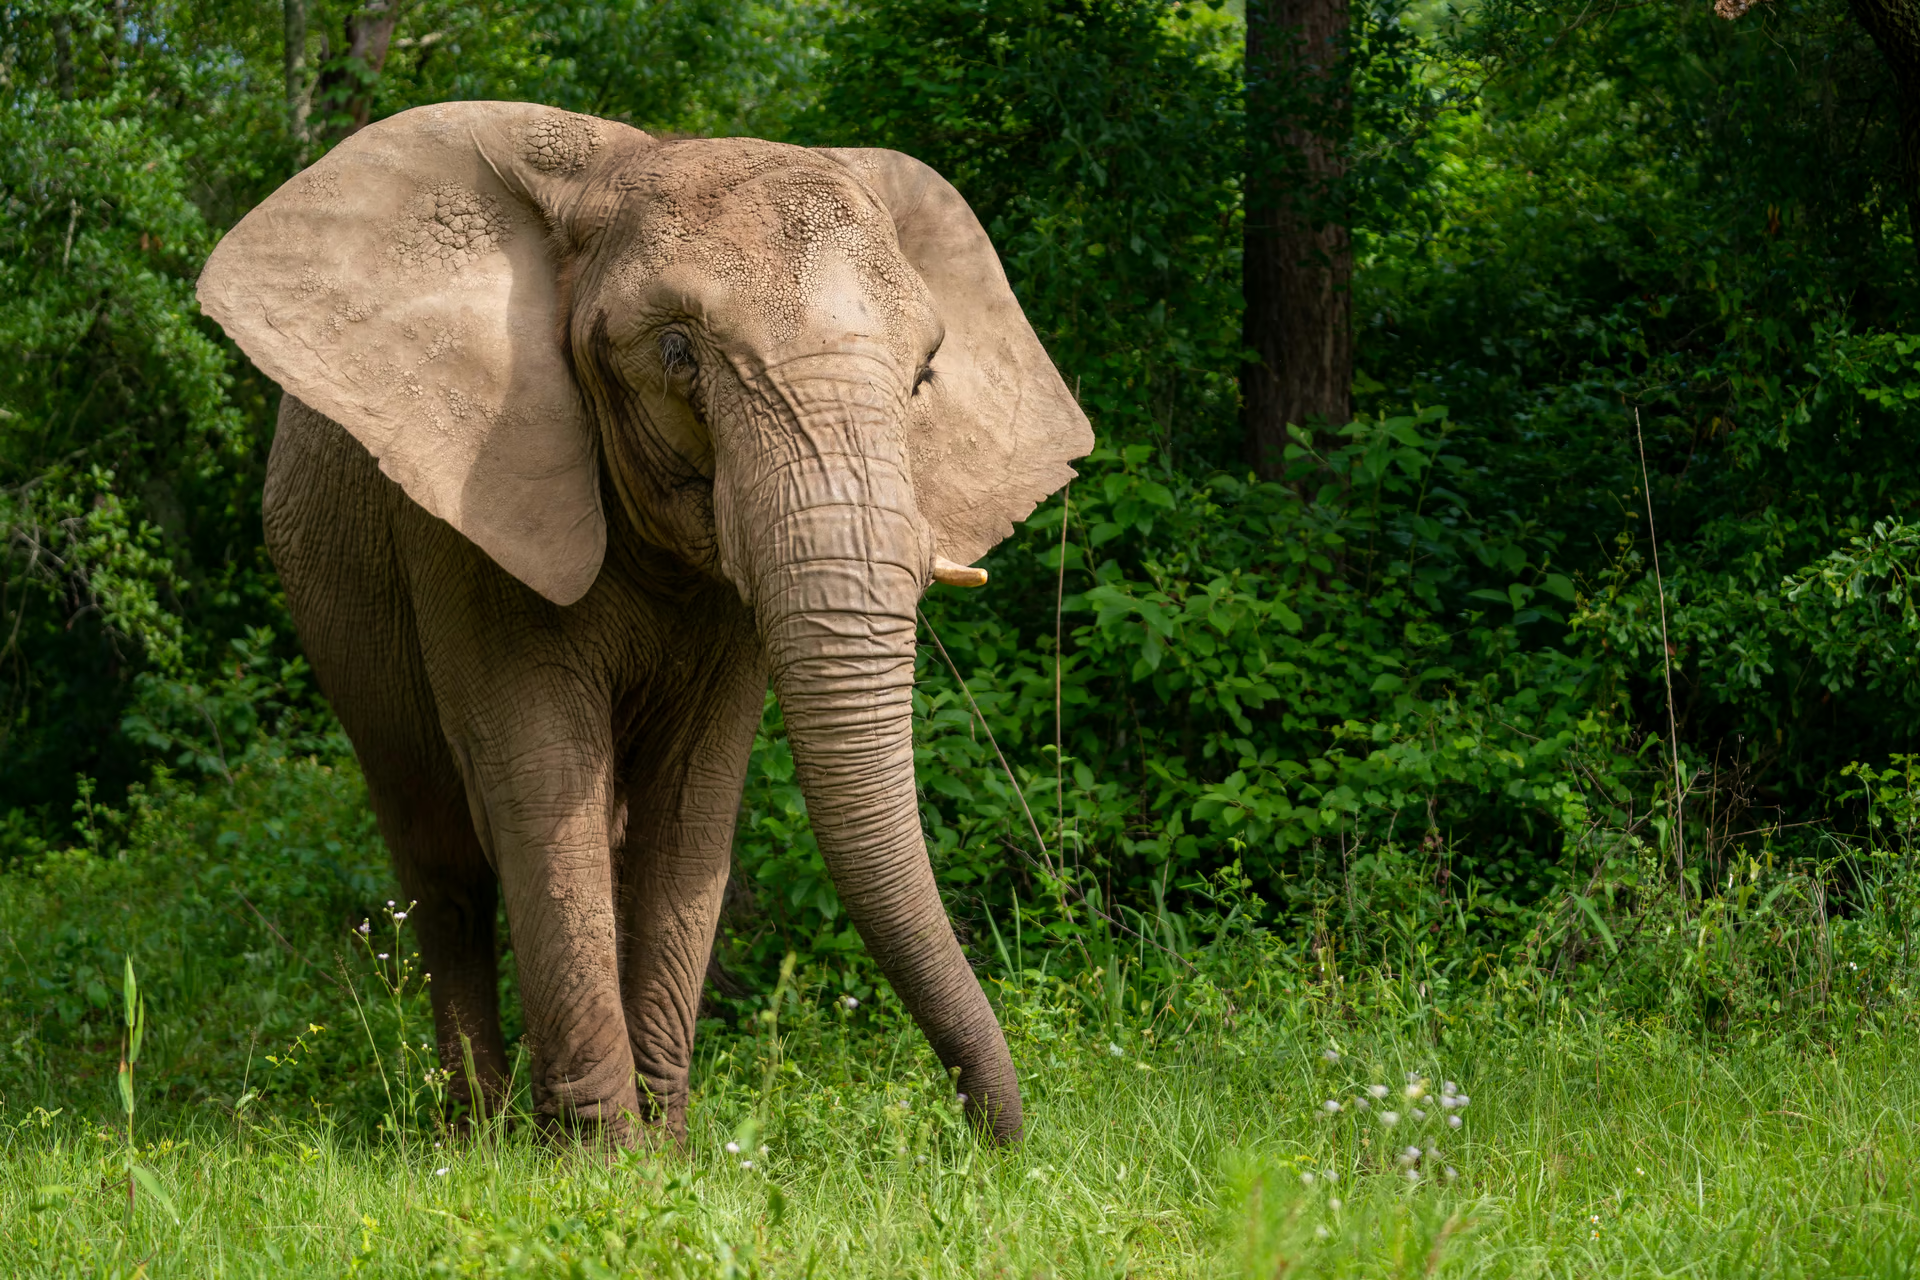
Фото слона в дикій природі

Багатомодальні моделі з Hugging Face

VQA


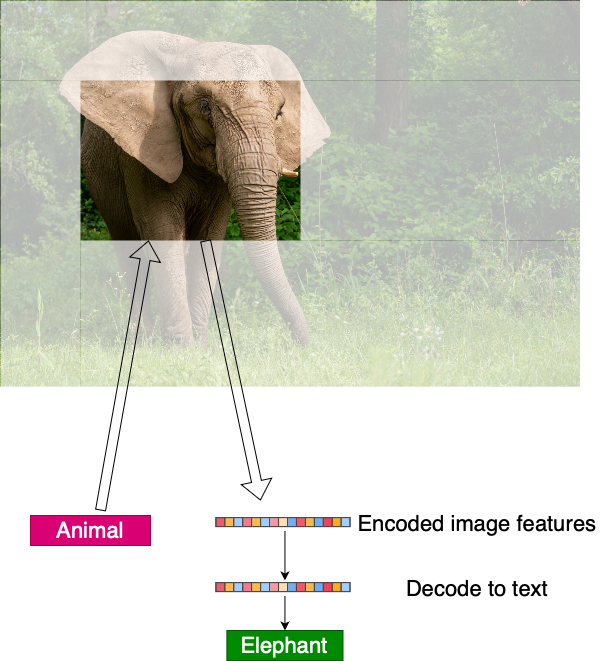
  • Модель знає ознаки зображень і тексту для багатьох об'єктів
  • Повторне використання моделей без додаткового fine-tuning

Схема фокусування на тварині та ідентифікації

Багатомодальні моделі з Hugging Face

VQA

from transformers import ViltProcessor, ViltForQuestionAnswering


processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa") model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
encoding = processor(image, text, return_tensors="pt")
outputs = model(**encoding)
idx = outputs.logits.argmax(-1).item()
print("Predicted answer:", model.config.id2label[idx])
Передбачена відповідь: elephant
Багатомодальні моделі з Hugging Face

Document VQA

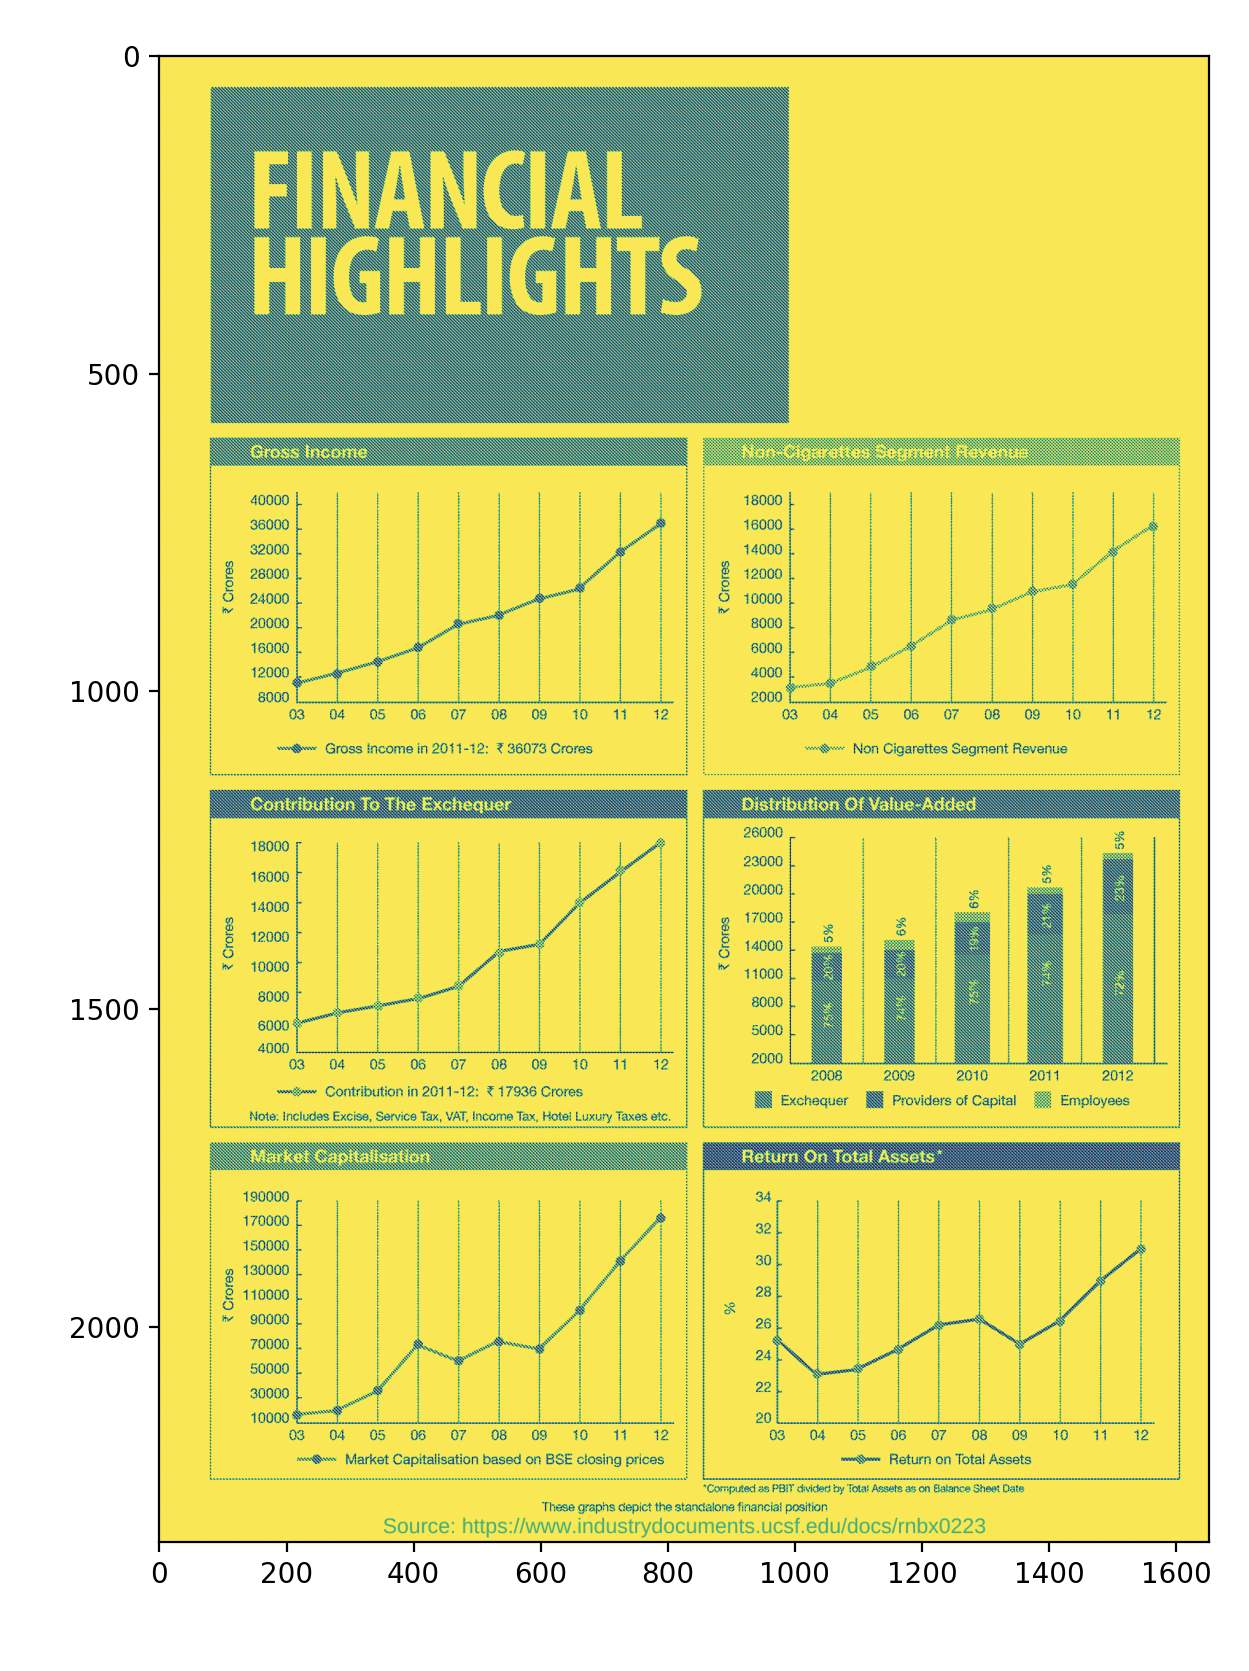
  • Розширення VQA для виявлення графіків, таблиць і тексту (OCR) на зображеннях
from datasets import load_dataset
from transformers import pipeline

dataset = load_dataset("lmms-lab/DocVQA")


import matplotlib.pyplot as plt plt.imshow(dataset["test"][2]["image"]) plt.show()

Зображення документа з графіками та стовпчиковими діаграмами

Багатомодальні моделі з Hugging Face

Document VQA

Логотип Google Tesseract

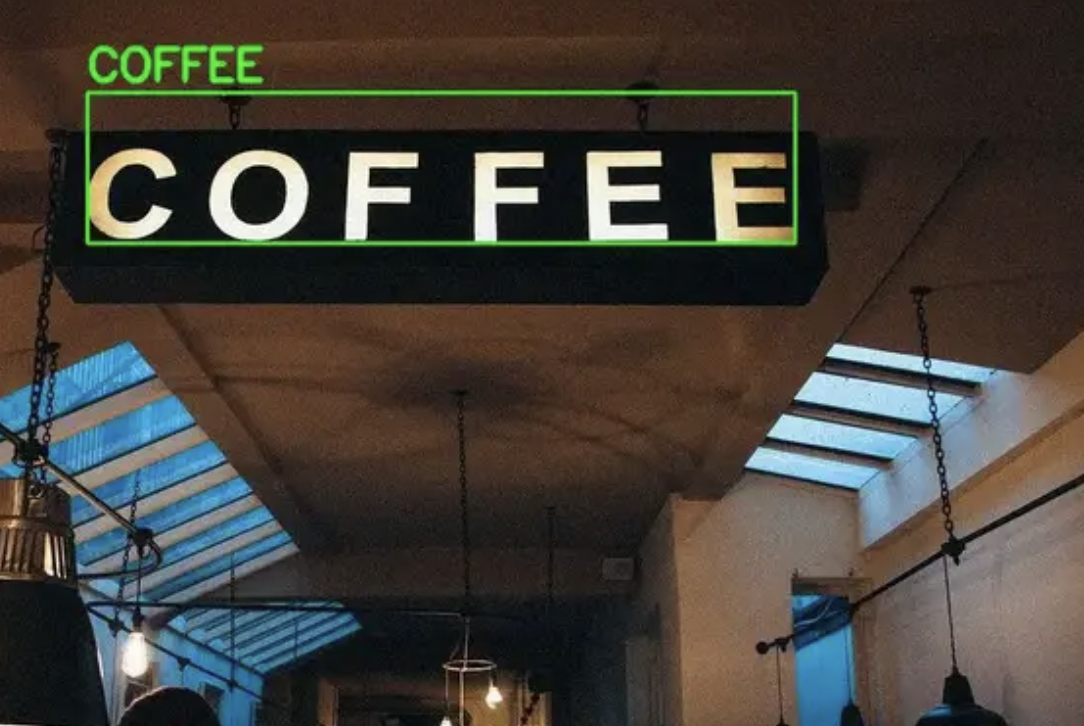
  • Потрібні додаткові залежності для запуску OCR
  • pytesseract встановлюється через pip
  • Tesseract OCR через пакетний інсталятор (напр., apt-get, exe або homebrew/macports)

Фото вивіски «coffee» з результатом OCR

Багатомодальні моделі з Hugging Face

Document VQA

from transformers import pipeline
pipe = pipeline("document-question-answering", "impira/layoutlm-document-qa")

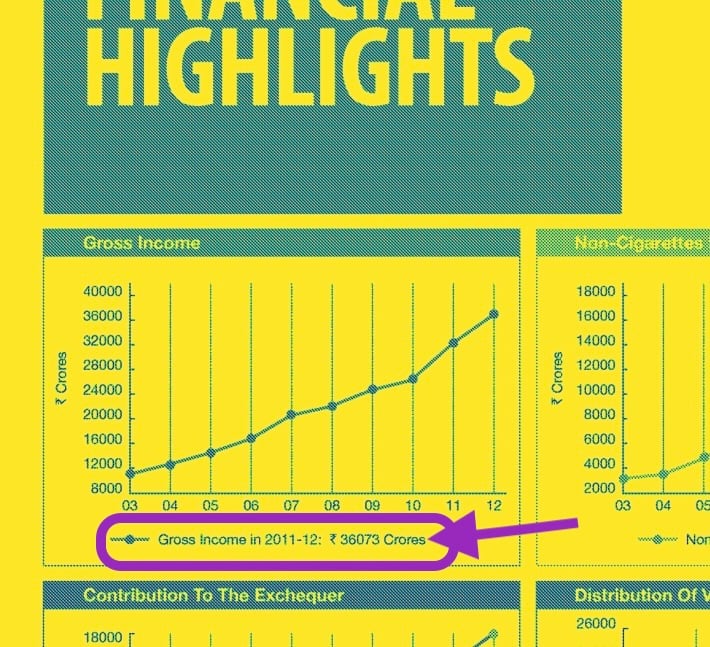
result = pipe( dataset["test"][2]["image"], "What was the gross income in 2011-2012?" )
Багатомодальні моделі з Hugging Face

Document VQA

print(result)
[{'score': 0.05149758607149124,
  'answer': '3 36073 Crores', ...}]

Зображення документа з графіками та стовпчиковими діаграмами

Багатомодальні моделі з Hugging Face

Давайте потренуємось!

Багатомодальні моделі з Hugging Face

Preparing Video For Download...