Ta bort data

Feature Engineering med PySpark

John Hogue

Lead Data Scientist, General Mills

Var kan data bli felaktig?
  • Felaktigt registrerat
  • Unika händelser
  • Felaktigt formaterat
  • Dubbletter
  • Saknas
  • Inte relevant

Dominos

Feature Engineering med PySpark

Ta bort kolumner

df.select(['NO', 'UNITNUMBER', 'CLASS']).show()
+----+----------+-----+
|  NO|UNITNUMBER|CLASS|
+----+----------+-----+
|   1|      null|   SF|
| 156|        A8|   SF|
| 157|       207|   SF|
| 158|      701G|   SF|
| 159|        36|   SF|

Flera fält behövs inte för vår analys

  • 'NO' automatiskt genererat postnummer
  • 'UNITNUMBER' irrelevant data
  • 'CLASS' alltid konstant
Feature Engineering med PySpark

Ta bort kolumner

drop(*cols)

  • *cols – ett kolumnnamn att ta bort, eller en lista med kolumnnamn att ta bort.
  • Returnerar en ny DataFrame utan de angivna kolumnerna
# List of columns to drop
cols_to_drop = ['NO', 'UNITNUMBER', 'CLASS']

# Drop the columns df = df.drop(*cols_to_drop)
Feature Engineering med PySpark

Textfiltrering

  • where(condition)
    • condition – en kolumn av typen types.BooleanType eller ett SQL-uttryck som sträng.
    • Filtrerar DataFrame där villkoret är sant
  • like(other)
    • other – ett SQL LIKE-mönster
    • Returnerar en boolesk kolumn
  • ~
    • NOT-villkoret
df = df.where(~df['POTENTIALSHORTSALE'].like('Not Disclosed'))
Feature Engineering med PySpark

Filtrering av extremvärden

Filtrera data inom tre standardavvikelser (3σ) från medelvärdet (μ)
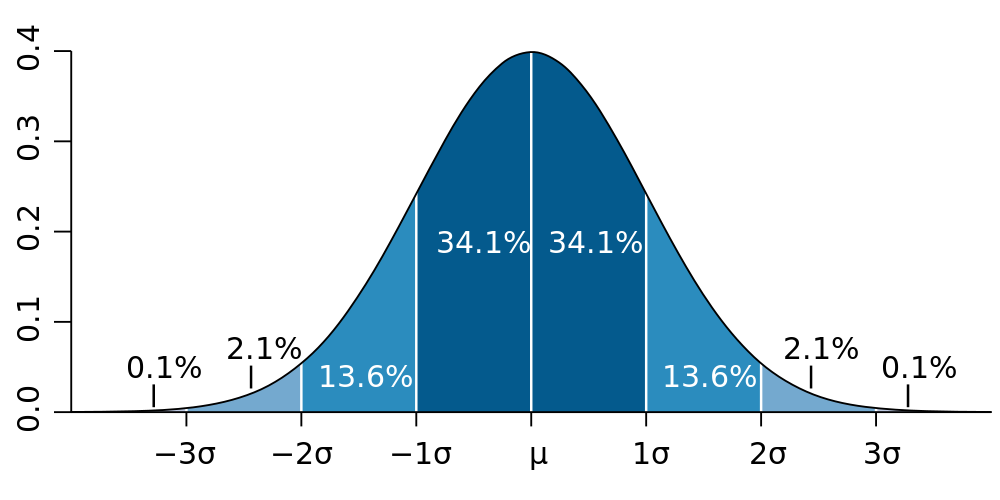
Standardnormalfördelning

Feature Engineering med PySpark

Exempel på värdefiltrering

# Calculate values used for filtering
std_val = df.agg({'SALESCLOSEPRICE': 'stddev'}).collect()[0][0]
mean_val = df.agg({'SALESCLOSEPRICE': 'mean'}).collect()[0][0]

# Create three standard deviation (μ ± 3σ) upper and lower bounds for data hi_bound = mean_val + (3 * std_val) low_bound = mean_val - (3 * std_val)
# Use where() to filter the DataFrame between values df = df.where((df['LISTPRICE'] < hi_bound) & (df['LISTPRICE'] > low_bound))
Feature Engineering med PySpark

Ta bort NA- och NULL-värden

DataFrame.dropna()

  • how: 'any' eller 'all'. Med 'any' tas en post bort om den innehåller något null-värde. Med 'all' tas den bara bort om alla värden är null.
  • thresh: int, standard None. Om angivet tas poster bort som har färre än thresh icke-null-värden. Detta åsidosätter parametern how.
  • subset: valfri lista med kolumnnamn att ta hänsyn till.
Feature Engineering med PySpark

Ta bort NA- och NULL-värden

# Drop any records with NULL values
df = df.dropna()

# drop records if both LISTPRICE and SALESCLOSEPRICE are NULL df = df.dropna(how='all', subset['LISTPRICE', 'SALESCLOSEPRICE '])
# Drop records where at least two columns have NULL values df = df.dropna(thresh=2)
Feature Engineering med PySpark

Ta bort dubbletter

Vad är en dubblett?

  • Två eller fler poster innehåller exakt samma information
  • Kontrollera efter dubbletter när kolumner tagits bort eller datamängder slagits ihop

dropDuplicates()

  • Kan köras över hela DataFrame eller en lista med kolumner
  • I PySpark finns ingen garanterad ordning för vilken post som tas bort
# Entire DataFrame
df.dropDuplicates()

# Check only a column list df.dropDuplicates(['streetaddress'])
Feature Engineering med PySpark

Nu kör vi en övning!

Feature Engineering med PySpark

Preparing Video For Download...