Visuell datagranskning

Feature Engineering med PySpark

John Hogue

Lead Data Scientist, General Mills

Deskriptiv statistik med DataFrame.describe()

df.describe(['LISTPRICE']).show()
+-------+------------------+
|summary|         LISTPRICE|
+-------+------------------+
|  count|              5000|
|   mean|        263419.365|
| stddev|143944.10818036905|
|    min|            100000|
|    max|             99999|
+-------+------------------+
Feature Engineering med PySpark

Många deskriptiva funktioner finns redan tillgängliga

  • Medelvärde
    • pyspark.sql.functions.mean(col)
  • Skevhet
    • pyspark.sql.functions.skewness(col)
  • Minimum
    • pyspark.sql.functions.min(col)
  • Kovarians
    • cov(col1, col2)
  • Korrelation
    • corr(col1, col2)
Feature Engineering med PySpark

Exempel med mean()

  • mean(col)
  • Aggregatfunktion: returnerar medelvärdet av värdena i en grupp.
df.agg({'SALESCLOSEPRICE': 'mean'}).collect()
[Row(avg(SALESCLOSEPRICE)=262804.4668)]
Feature Engineering med PySpark

Exempel med cov()

  • cov(col1, col2)
  • Parametrar:
    • col1 – första kolumnen
    • col2 – andra kolumnen
df.cov('SALESCLOSEPRICE', 'YEARBUILT')
1281910.3840634783
Feature Engineering med PySpark

seaborn: statistisk datavisualisering

Seaborn

Feature Engineering med PySpark

Om visualisering

Visualisering av PySpark DataFrames med standardbibliotek som Seaborn kräver konvertering till Pandas

VARNING: Gör ett urval av PySpark DataFrames innan du konverterar till Pandas!

  • sample(withReplacement, fraction, seed=None)
    • withReplacement tillåter upprepningar i urvalet
    • fraction andel poster att behålla
    • seed slumpfrö för reproducerbarhet
# Sample 50% of the PySpark DataFrame and count rows
df.sample(False, 0.5, 42).count()
2504
Feature Engineering med PySpark

Förberedelse inför fördelningsplot

Seaborn distplot()

  • seaborn.distplot(a)
  • a : Series, endimensionell array eller lista. Observerade data.
# Import your favorite visualization library
import seaborn as sns

# Sample the dataframe sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)
# Convert the sample to a Pandas DataFrame pandas_df = sample_df.toPandas()
# Plot it sns.distplot(pandas_df)
Feature Engineering med PySpark

Fördelningsplot över försäljningspris vid avslut
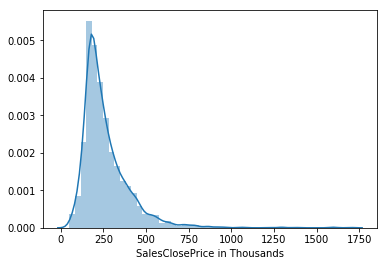
Displot

Feature Engineering med PySpark

Visualisering av samband

Seaborn lmplot()

  • seaborn.lmplot(x, y, data)
  • x, y : strängar, indatavariabler – ska vara kolumnnamn i data.
  • data : Pandas DataFrame
# Import your favorite visualization library
import seaborn as sns

# Select columns s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND']) # Sample dataframe s_df = s_df.sample(False, 0.5, 42)
# Convert to Pandas DataFrame pandas_df = s_df.toPandas()
# Plot it sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)
Feature Engineering med PySpark

Linjär modellplot: kvadratmeter ovan mark vs. försäljningspris
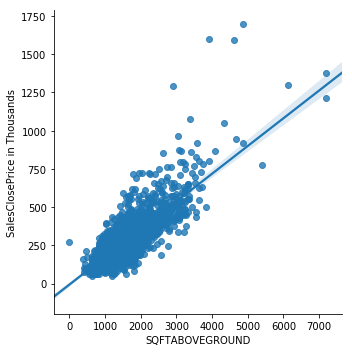
Linjär modellplot

Feature Engineering med PySpark

Nu kör vi en övning!

Feature Engineering med PySpark

Preparing Video For Download...