การลบข้อมูล

Feature Engineering with PySpark

John Hogue

Lead Data Scientist, General Mills

ข้อมูลมีปัญหาได้จากอะไรบ้าง?
  • บันทึกผิดพลาด
  • เหตุการณ์ที่เกิดขึ้นครั้งเดียว
  • รูปแบบไม่ถูกต้อง
  • ข้อมูลซ้ำ
  • ข้อมูลหายไป
  • ไม่เกี่ยวข้องกับการวิเคราะห์

โดมิโน

Feature Engineering with PySpark

การลบคอลัมน์

df.select(['NO', 'UNITNUMBER', 'CLASS']).show()
+----+----------+-----+
|  NO|UNITNUMBER|CLASS|
+----+----------+-----+
|   1|      null|   SF|
| 156|        A8|   SF|
| 157|       207|   SF|
| 158|      701G|   SF|
| 159|        36|   SF|

หลายคอลัมน์ไม่จำเป็นสำหรับการวิเคราะห์

  • 'NO' หมายเลขเรคคอร์ดที่สร้างอัตโนมัติ
  • 'UNITNUMBER' ข้อมูลที่ไม่เกี่ยวข้อง
  • 'CLASS' ค่าคงที่ทั้งหมด
Feature Engineering with PySpark

การลบคอลัมน์

drop(*cols)

  • *cols – ชื่อคอลัมน์หรือรายการชื่อคอลัมน์ที่ต้องการลบ
  • คืนค่า DataFrame ใหม่ที่ลบคอลัมน์ที่ระบุออกแล้ว
# List of columns to drop
cols_to_drop = ['NO', 'UNITNUMBER', 'CLASS']

# Drop the columns df = df.drop(*cols_to_drop)
Feature Engineering with PySpark

การกรองข้อความ

  • where(condition)
    • condition – คอลัมน์ชนิด types.BooleanType หรือ SQL expression ในรูปแบบสตริง
    • กรองเฉพาะแถวที่เงื่อนไขเป็นจริง
  • like(other)
    • other – รูปแบบ SQL LIKE
    • คืนค่าคอลัมน์ชนิด boolean
  • ~
    • เงื่อนไข NOT
df = df.where(~df['POTENTIALSHORTSALE'].like('Not Disclosed'))
Feature Engineering with PySpark

การกรอง Outlier

กรองข้อมูลให้อยู่ภายในสามส่วนเบี่ยงเบนมาตรฐาน (3σ) จากค่าเฉลี่ย (μ)
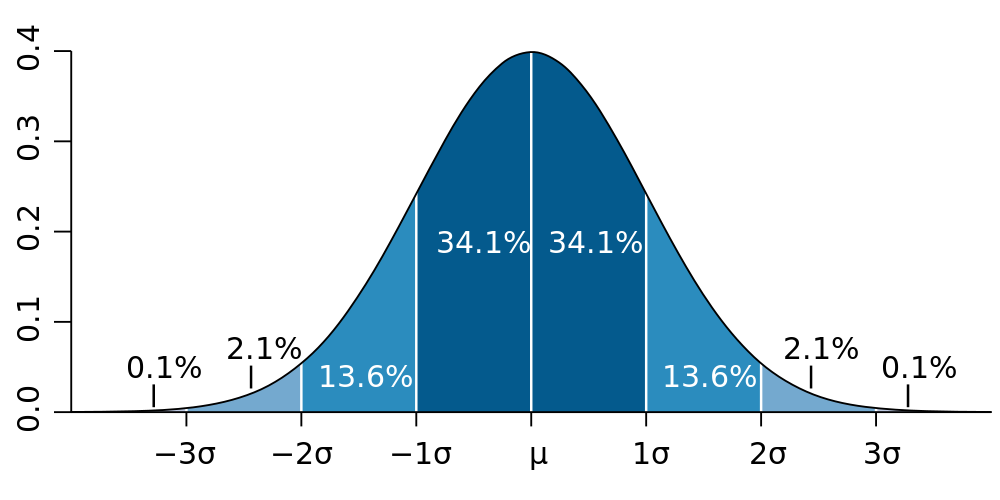
การแจกแจงปกติมาตรฐาน

Feature Engineering with PySpark

ตัวอย่างการกรองค่า

# Calculate values used for filtering
std_val = df.agg({'SALESCLOSEPRICE': 'stddev'}).collect()[0][0]
mean_val = df.agg({'SALESCLOSEPRICE': 'mean'}).collect()[0][0]

# Create three standard deviation (μ ± 3σ) upper and lower bounds for data hi_bound = mean_val + (3 * std_val) low_bound = mean_val - (3 * std_val)
# Use where() to filter the DataFrame between values df = df.where((df['LISTPRICE'] < hi_bound) & (df['LISTPRICE'] > low_bound))
Feature Engineering with PySpark

การลบค่า NA หรือ NULL

DataFrame.dropna()

  • how: 'any' หรือ 'all' — ถ้าเป็น 'any' จะลบเรคคอร์ดที่มีค่า null อย่างน้อยหนึ่งค่า ถ้าเป็น 'all' จะลบเรคคอร์ดเมื่อทุกค่าเป็น null
  • thresh: int ค่าเริ่มต้นคือ None — ถ้าระบุ จะลบเรคคอร์ดที่มีค่าไม่ใช่ null น้อยกว่า thresh โดยจะแทนที่พารามิเตอร์ how
  • subset: รายการชื่อคอลัมน์ที่ต้องการพิจารณา (ไม่บังคับ)
Feature Engineering with PySpark

การลบค่า NA หรือ NULL

# Drop any records with NULL values
df = df.dropna()

# drop records if both LISTPRICE and SALESCLOSEPRICE are NULL df = df.dropna(how='all', subset['LISTPRICE', 'SALESCLOSEPRICE '])
# Drop records where at least two columns have NULL values df = df.dropna(thresh=2)
Feature Engineering with PySpark

การลบข้อมูลซ้ำ

ข้อมูลซ้ำคืออะไร?

  • เรคคอร์ดตั้งแต่สองรายการขึ้นไปที่มีข้อมูลเหมือนกันทุกฟิลด์
  • หลังจากลบคอลัมน์หรือ join ชุดข้อมูล ควรตรวจสอบข้อมูลซ้ำ

dropDuplicates()

  • ใช้กับ DataFrame ทั้งหมด หรือระบุรายการคอลัมน์ได้
  • ใน PySpark ไม่มีการกำหนดลำดับว่าเรคคอร์ดใดจะถูกลบ
# Entire DataFrame
df.dropDuplicates()

# Check only a column list df.dropDuplicates(['streetaddress'])
Feature Engineering with PySpark

มาฝึกกันเถอะ!

Feature Engineering with PySpark

Preparing Video For Download...