Тести на нормальність

Основи інференції в Python

Paul Savala

Assistant Professor of Mathematics

Зріст чоловіків у США
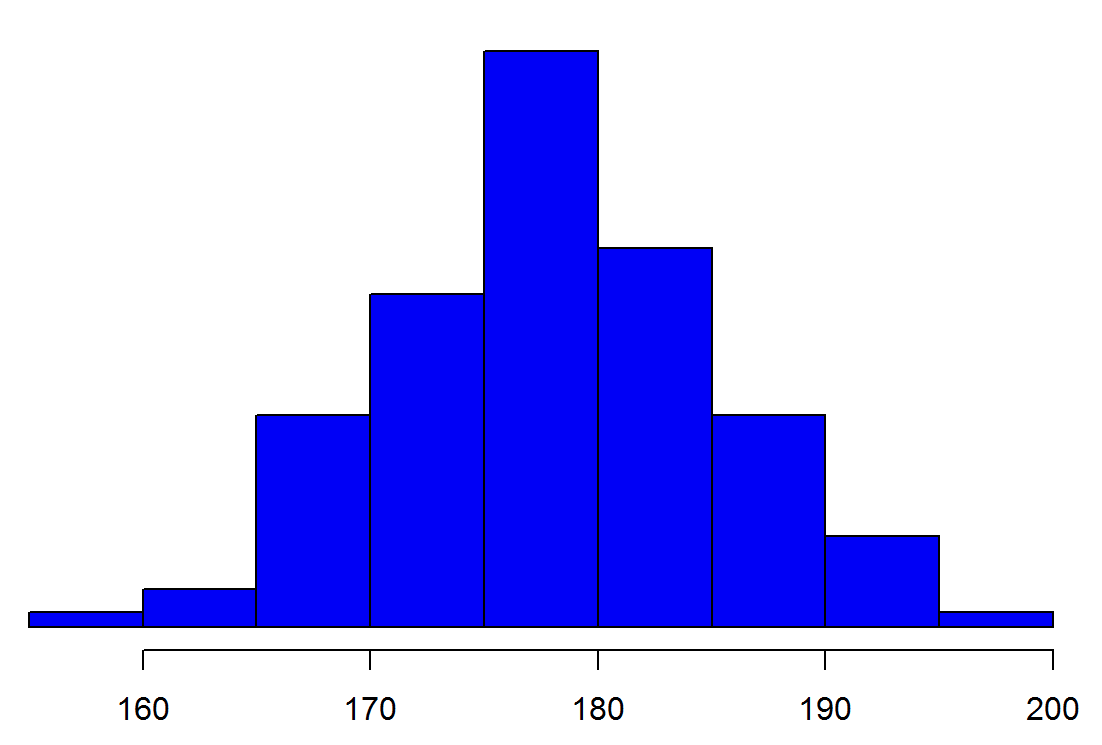
Гістограма, наближено нормально розподілена; середній зріст 180 сантиметрів, мінімум 160, максимум 200.

Основи інференції в Python

Залишки моделі

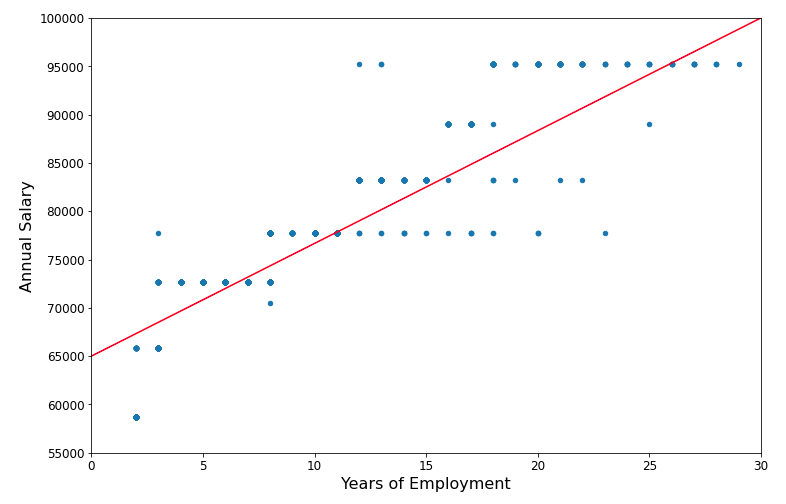
Точкова діаграма: роки роботи на осі x, річна зарплата на осі y, загалом позитивний лінійний тренд. На даних проведено червону лінію найкращого наближення.

Очікуйте рівний розподіл вище й нижче прогнозу

Основи інференції в Python

Залишки моделі

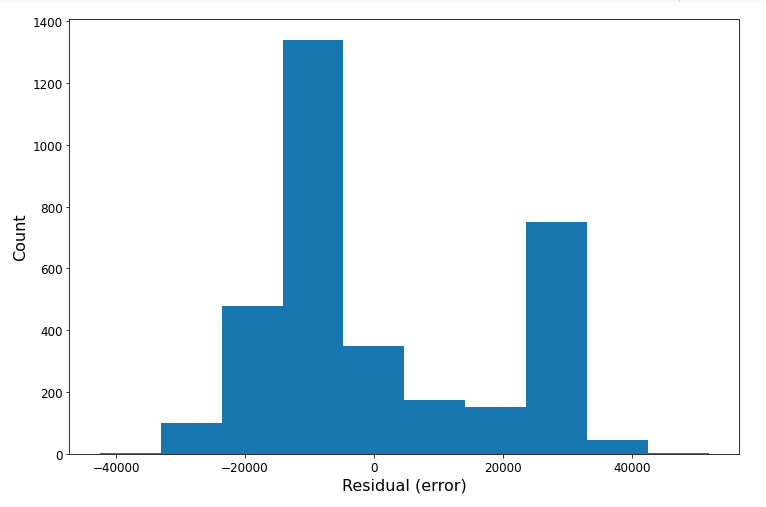
Гістограма з «residual (error)» на осі x, «count» на осі y та бімодальним розподілом: мода близько −10 тисяч і ще одна близько +30 тисяч.

Основи інференції в Python

Застосування нормальних розподілів

  • Параметричні тести — перевірки гіпотез із припущенням нормальності
  • T‑тест для порівняння середніх:
    • Припускає, що вибіркові середні нормально розподілені
    • Інакше висновки некоректні
Основи інференції в Python

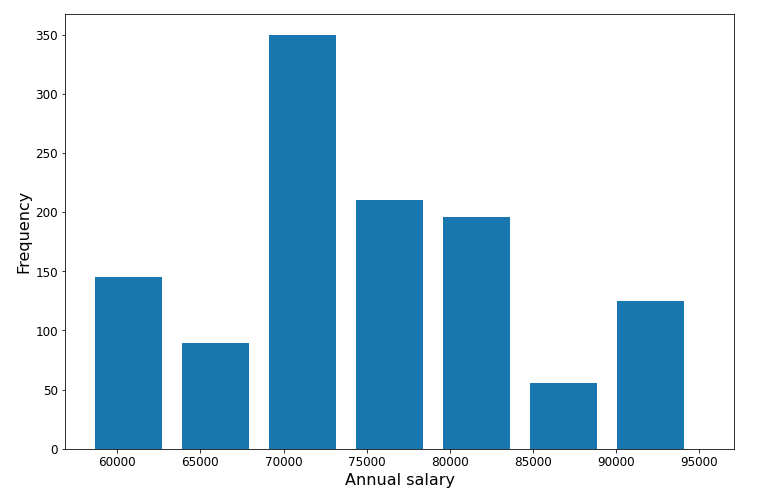
Гістограма із зарплатами від шістдесяти до дев'яноста п'яти тисяч на осі x та частотою на осі y. Розподіл близький до нормального.

Основи інференції в Python

Критерій Андерсона — Дарлінга на нормальність

  • Перевіряє припущення про нормальність

$H_0$: Дані мають нормальний розподіл

$H_a$: Дані _не_ мають нормального розподілу

Основи інференції в Python

Критерій Андерсона — Дарлінга в SciPy

result = stats.anderson(police_df['Annual Salary'])

result.statistic
27.41
result.critical_values
[0.574, 0.654, 0.784, 0.915, 1.088]
result.significance_level[result.statistic > result.critical_values]
[15.  10.   5.   2.5  1. ]
Основи інференції в Python

Підгонка нормального розподілу

mu, std = stats.norm.fit(police_df['Annual Salary'])

estimated_pct_under_70k = stats.norm.cdf(70000, loc=mu, scale=std)
print(estimated_pct_under_70k)
0.27
actual_under_70k = police_df[police_df['Annual Salary'] < 70000]

print(len(actual_under_70k) / len(police_df))
0.20
Основи інференції в Python

Давайте потренуємось!

Основи інференції в Python

Preparing Video For Download...