Klustring och klustermodeller

Diskret händelsesimulering i Python

Diogo Costa (PhD, MSc)

Adjunct Professor, University of Saskatchewan, Canada & CEO of ImpactBLUE-Scientific

Histogram över modellresultat

  • Utforska modellresultat
  • Identifiera flaskhalsar och kritiska punkter
  • Optimera systemet

Histogram

  • Graf som visar frekvensfördelningar
  • Anger antal observationer i ett givet intervall

Paketet Matplotlib

import matplotlib.pyplot as plt

Användning: Skapa ett histogram av datamängden data med 50 klasser

plt.hist(data, bins=50)
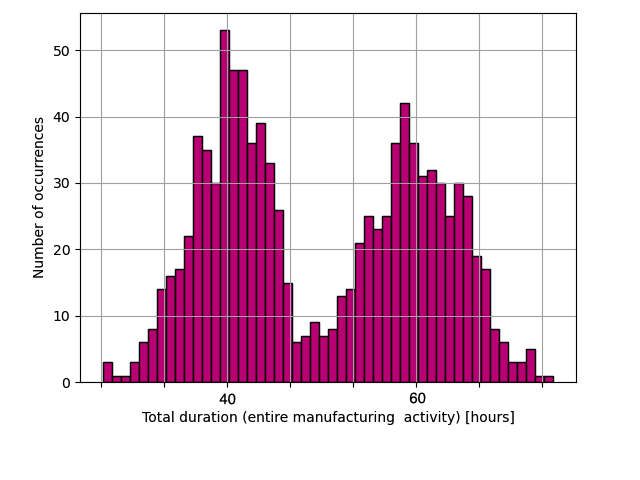
Ett histogram med 50 dataklasser som visar två gaussfördelningar och antyder två kluster av data.

Diskret händelsesimulering i Python

Klusteranalys och tillämpning på modeller

  • Tillämpningar
    • Mönsterigenkänning (t.ex. modellresultat)
    • Bildanalys

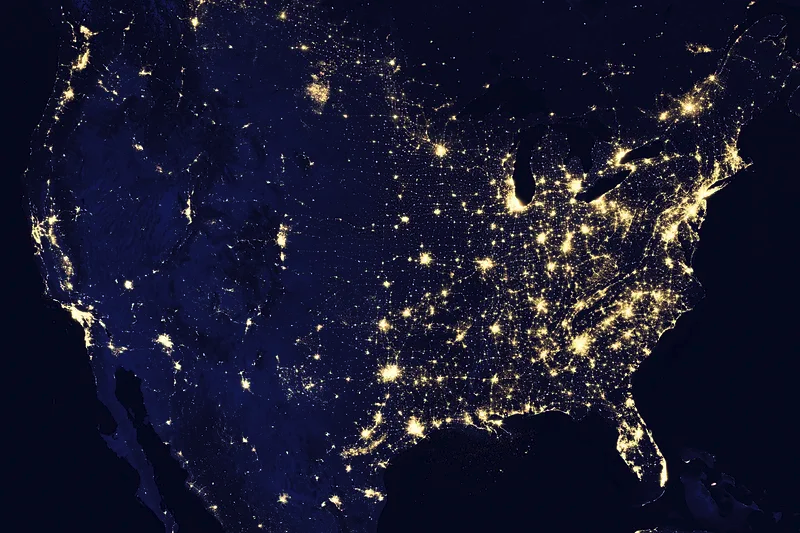
En satellitbild av nattbelysning i Nordamerika.

  • Datakomprimering
  • Datorgrafik
  • Maskininlärning

    En bild av ett neuralt nätverk i en hjärna som anspelar på tekniken inom maskininlärning och framväxten av datamönster och klustring.

  • I diskreta händelsemodeller

    • Identifiera mönster i modellutdata
    • Mer användbar information
Diskret händelsesimulering i Python

k-means-klustring

Vårt fokus

  • k-means-klustring (centroidmodell)
  • Uppdelning av observationer i k kluster
  • Varje observation tillhör klustret med närmaste medelvärde
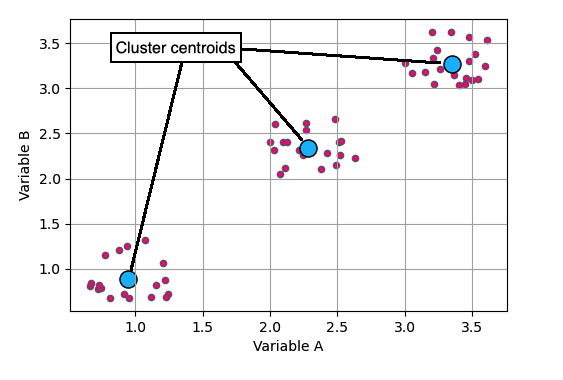
  • Klusternas medelvärden kallas "klustercentroider"

Observationer och klustercentroider

Graf som visar data med klustercentroider beräknade med k-means-klustring.

Diskret händelsesimulering i Python

k-means-klustring med SciPy

SciPy-metod

scipy.cluster.vq.kmeans()

Implementering

import scipy
scipy.cluster.vq.kmeans(
obs, k_or_guess, iter=20, thresh=1e-05,
check_finite=True, *, seed=None)
  • obs är en numpy-array
  • Returnerar:
    1. Klustercentroider
    2. Distorsion (medelavstånd mellan observationer och genererade centroider)
Diskret händelsesimulering i Python

Whitening av data: Dekorrelation och omskalning

Innan k-means körs: whitening av data

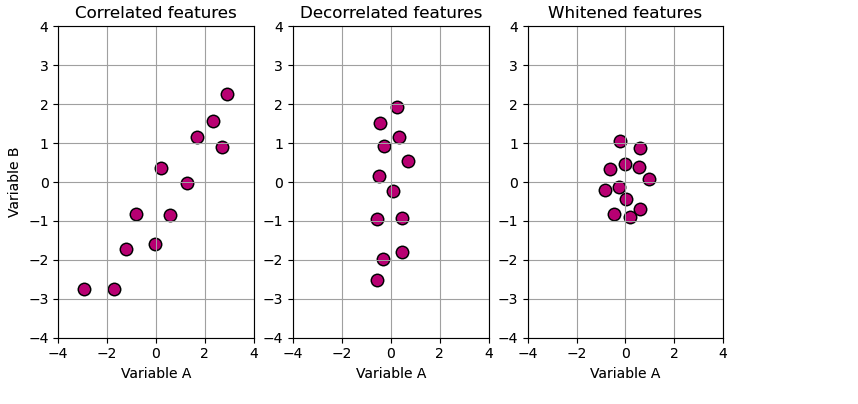
  1. Dekorrelera obs-data
  2. Skala om varje dimension i obs med dess standardavvikelse

Diagrammet visar tre paneler: den första visar korrelerade data, den andra dekorrelerade data och den tredje whitened data.

I SciPy

scipy.cluster.vq.whiten(
obs, check_finite=True)
  • obs är en numpy-array
Diskret händelsesimulering i Python

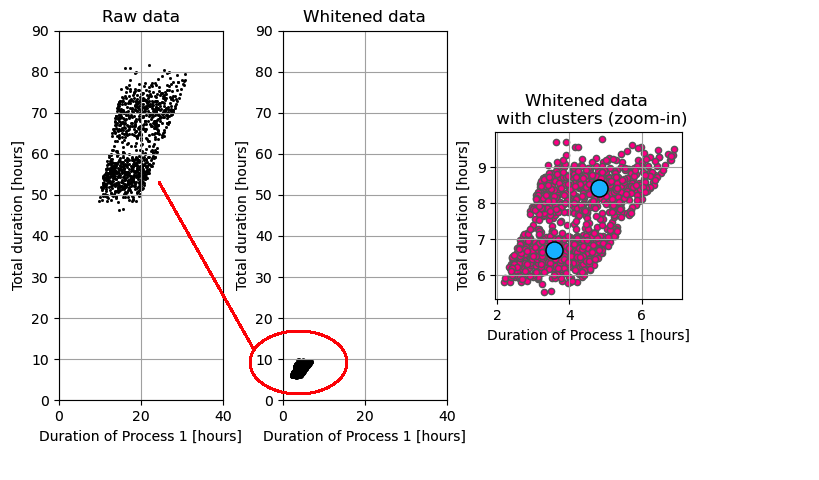
Exempel på whitening och k-means

  • Tillverkningsprocess med flera delprocesser
  • Vi undersöker effekten av Process 1

Diagram som visar varaktigheten för process 1 mot den totala varaktigheten för rådata och whitened data med kluster beräknade via k-means.

Importera paket

import scipy.cluster.vq as scvq

Whiten modellresultat

white_data = scvq.whiten(model_results)

Hitta 2 kluster (blå punkter)

cluster_centroids, distortion = 
scvq.kmeans(white_data, 2)
Diskret händelsesimulering i Python

Optimalt antal kluster

Metoder

  • Enkel metod (maximalt antal kluster)
  • Armbågsmetoden
  • Silhuettkoefficient
  • Gap-statistik

Enkel metod

  • Bestäm maximalt antal kluster
  • Formel: $\Big(\dfrac{nobs}{2}\Big)^{0.5}$
    • nobs = antal observationer
num_clusters = 
  int((model_results.shape[0]/2)**0.5)
  • Konsolutdata
    22
    
Diskret händelsesimulering i Python

Optimalt antal kluster: Silhuettpoängsmetoden

  • Importera bibliotek
from sklearn.metrics import silhouette_score

Beräkna silhuettpoäng för k antal kluster

for k in range(2, 6):
  model = KMeans(n_clusters=k)
  model.fit(model_results)
  pred = model.predict(model_results)
  score = silhouette_score(model_results, pred)

Konsolutdata

Silhouette Score for k = 2: 0.591
Silhouette Score for k = 3: 0.472
Silhouette Score for k = 4: 0.381
Silhouette Score for k = 5: 0.364
Silhouette Score for k = 6: 0.373

Tolka resultaten

  • Bästa värde: score = 1
  • Sämsta värde: score = -1
  • Överlappande kluster: score nära 0
Diskret händelsesimulering i Python

Nu kör vi en övning!

Diskret händelsesimulering i Python

Preparing Video For Download...