Кластеризація та кластерні моделі
Дискретно-подієве моделювання в Python

Diogo Costa (PhD, MSc)
Adjunct Professor, University of Saskatchewan, Canada & CEO of ImpactBLUE-Scientific
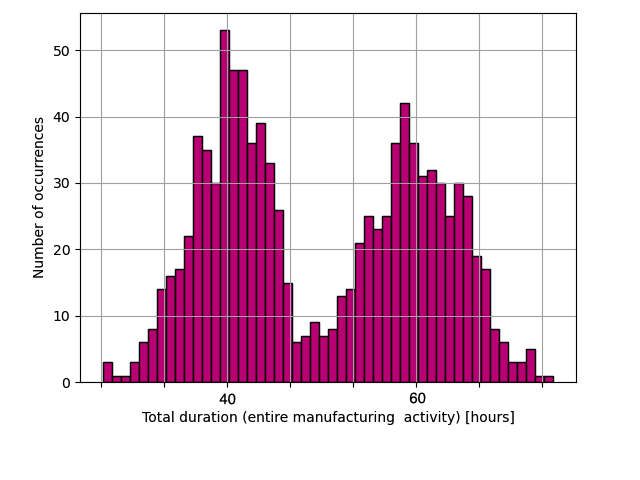
Гістограми результатів моделі
Використання: побудуйте гістограму набору даних data з 50 бінів
plt.hist(data, bins=50)
Кластерний аналіз і застосування в моделях
- Застосування
- Розпізнавання шаблонів (наприклад, результати моделей)
- Обробка зображень
- Стиснення даних
- Комп'ютерна графіка
Машинне навчання
У дискретно-подієвих моделях
- Виявляйте патерни у виході моделі
- Більше придатної до дій інформації
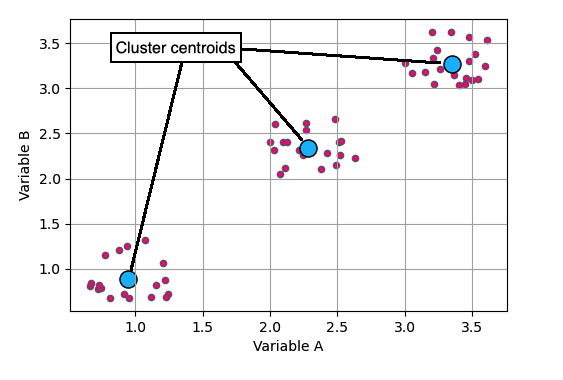
k-means кластеризація
Спостереження та центроїди кластерів
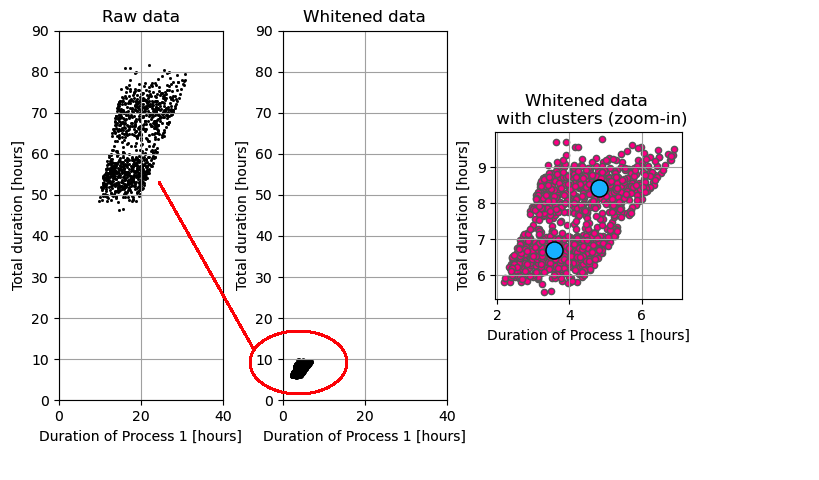
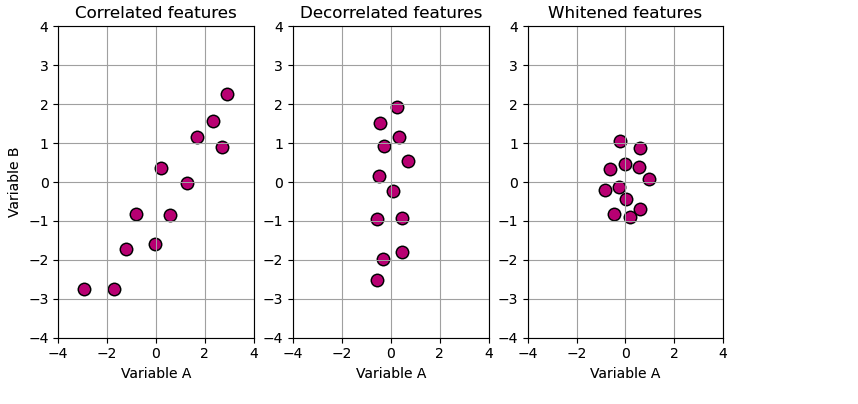
Вибілювання даних: декореляція та масштабування
Перед запуском k-means: вибілювання даних
- Декорелюйте дані
obs - Масштабуйте кожний вимір
obsза його стандартним відхиленням
Приклад вибілювання та k-means
- Виробничий процес із кількома стадіями
- Розгляньмо вплив
Process 1