ChIP-seq med Bioconductor i R
Peter Humburg
Statistician, Macquarie University


Läs in data:
reads <- readGAlignments(bam)
reads_gr <- granges(reads[[1]])
Beräkna genomsnittlig fragmentlängd:
frag_length <- fragmentlength(qc_report)["GSM1598218"]
Utöka läsningar och beräkna täckning:
reads_ext <- resize(reads_gr, width=frag_length)
cover_ext <- coverage(reads_ext)

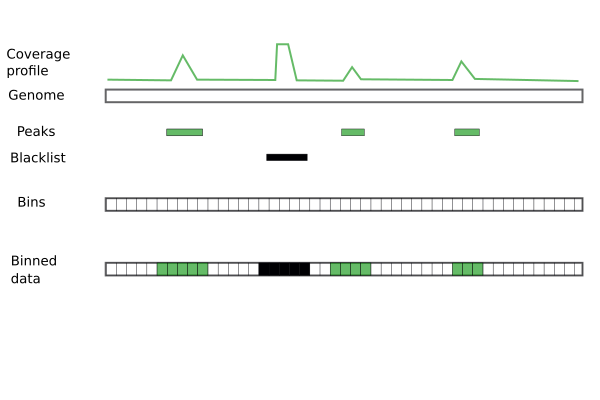
Skapa 200 bp-fack längs genomet.
bins <- tileGenome(seqinfo(reads), tilewidth=200,
cut.last.tile.in.chrom=TRUE)
Hitta alla fack som överlappar med toppar.
peak_bins_overlap <- findOverlaps(bins, peaks)
peak_bins <- bins[from(peak_bins_overlap), ]
Räkna antalet läsningar som överlappar varje toppfack.
peak_bins$score <- countOverlaps(peak_bins, reads)
count_bins <- function(reads, target, bins){
# Find all bins overlapping peaks
overlap <- from(findOverlaps(bins, target))
target_bins <- bins[overlap, ]
# Count the number of reads overlapping each peak bin
target_bins$score <- countOverlaps(target_bins, reads)
target_bins
}
peak_bins <- count_bins(reads_ext, peaks, bins)
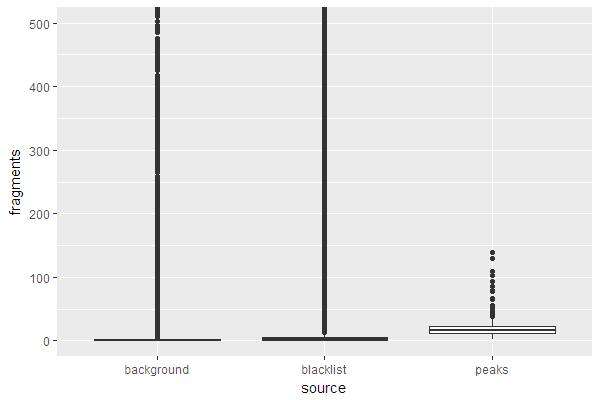
bl_bins <- count_bins(reads_ext, blacklist.hg19, bins)
Ta bort alla redan redovisade fack.
bkg_bins <- subset(bins, !bins %in% peak_bins & !bins %in% bl_bins)
Räkna antalet läsningar som överlappar varje återstående fack.
bkg_bins$score <- countOverlaps(bkg_bins, reads_ext)


ChIP-seq med Bioconductor i R