การจัดการกับชุดข้อมูลที่ไม่สมดุล

การตรวจจับการฉ้อโกงใน R

Bart Baesens

Professor Data Science at KU Leuven

ชุดข้อมูลที่ไม่สมดุล
  • ความท้าทายหลัก: การระบุว่าธุรกรรมใดเป็นการฉ้อโกงหรือไม่
    • เป็นปัญหาสำคัญสำหรับวิธีการจำแนกประเภทและการตรวจจับความผิดปกติ
  • Classifier มักเอนเอียงไปหาคลาสส่วนใหญ่ (= ไม่ฉ้อโกง)
    • ส่งผลให้เกิดข้อผิดพลาดสูงในการจำแนกกรณีฉ้อโกง
  • Classifier เรียนรู้ได้ดีขึ้นจากการกระจายข้อมูลที่ สมดุล

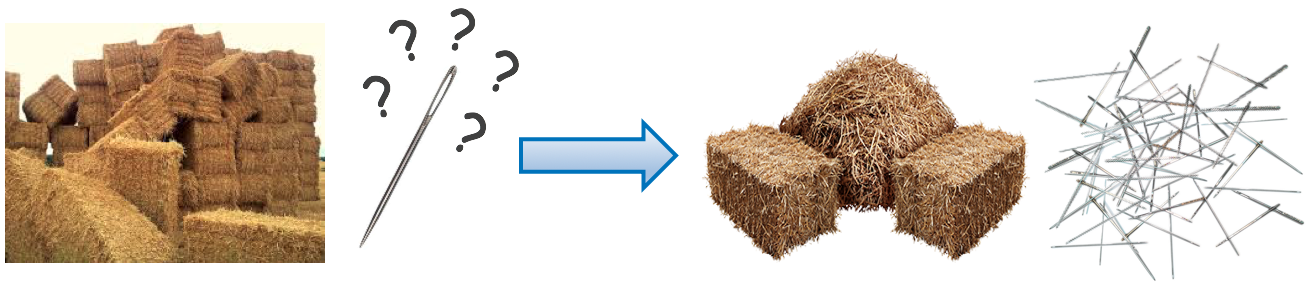
haystack_and_needle_v2

การตรวจจับการฉ้อโกงใน R

ชุดข้อมูลที่ไม่สมดุล

  • ความท้าทายหลัก: การระบุว่าธุรกรรมใดเป็นการฉ้อโกงหรือไม่
    • เป็นปัญหาสำคัญสำหรับวิธีการจำแนกประเภทและการตรวจจับความผิดปกติ
  • Classifier มักเอนเอียงไปหาคลาสส่วนใหญ่ (= ไม่ฉ้อโกง)
    • ส่งผลให้เกิดข้อผิดพลาดสูงในการจำแนกกรณีฉ้อโกง
  • Classifier เรียนรู้ได้ดีขึ้นจากการกระจายข้อมูลที่ สมดุล
  • แนวทางแก้ไขที่เป็นไปได้: เปลี่ยนการกระจายคลาส ด้วยวิธีการสุ่มตัวอย่าง

haystack_and_needle_v1

การตรวจจับการฉ้อโกงใน R

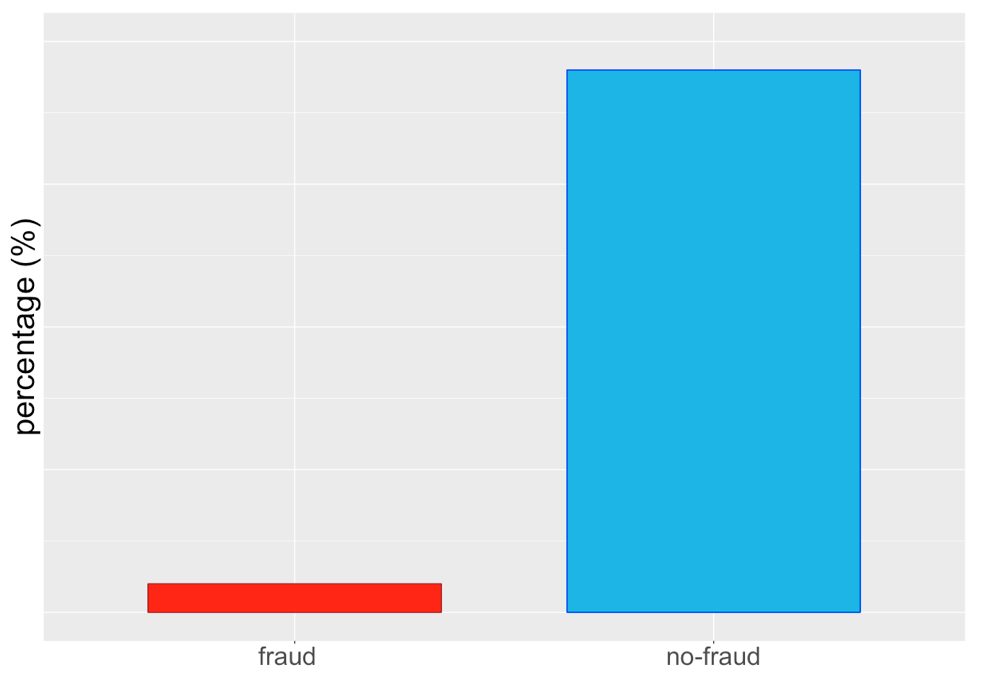
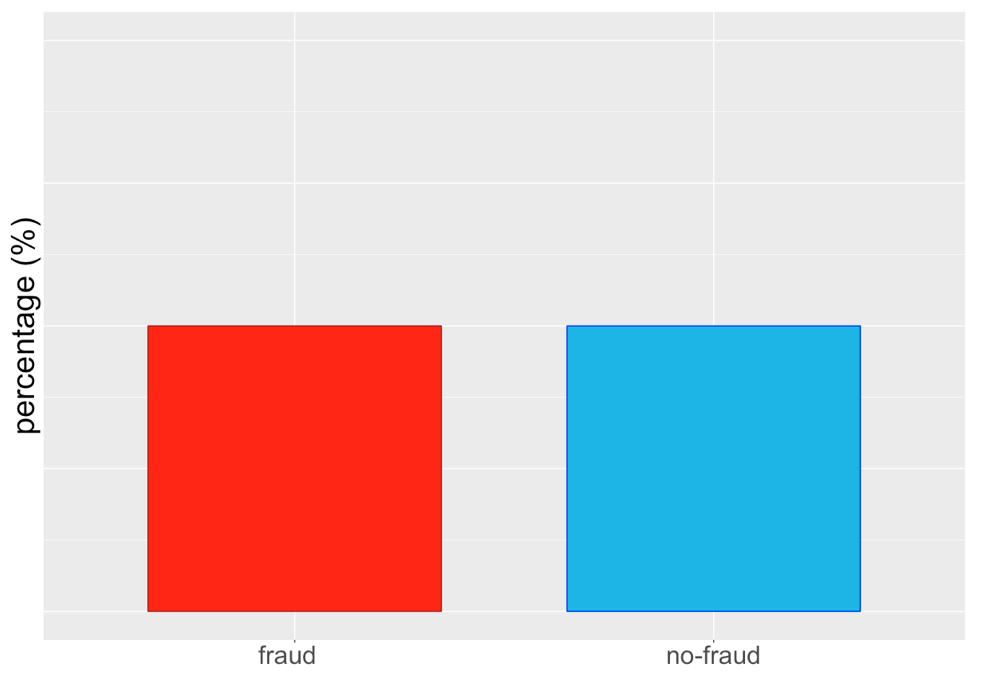
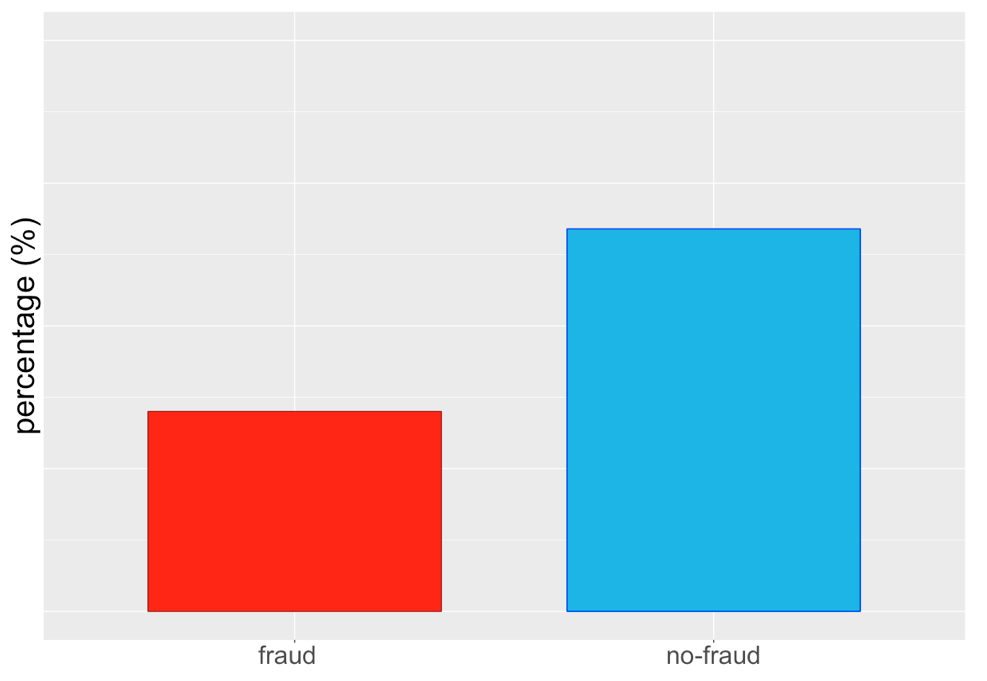
ความไม่สมดุลเดิม

กราฟแท่งคลาสดั้งเดิม

การตรวจจับการฉ้อโกงใน R

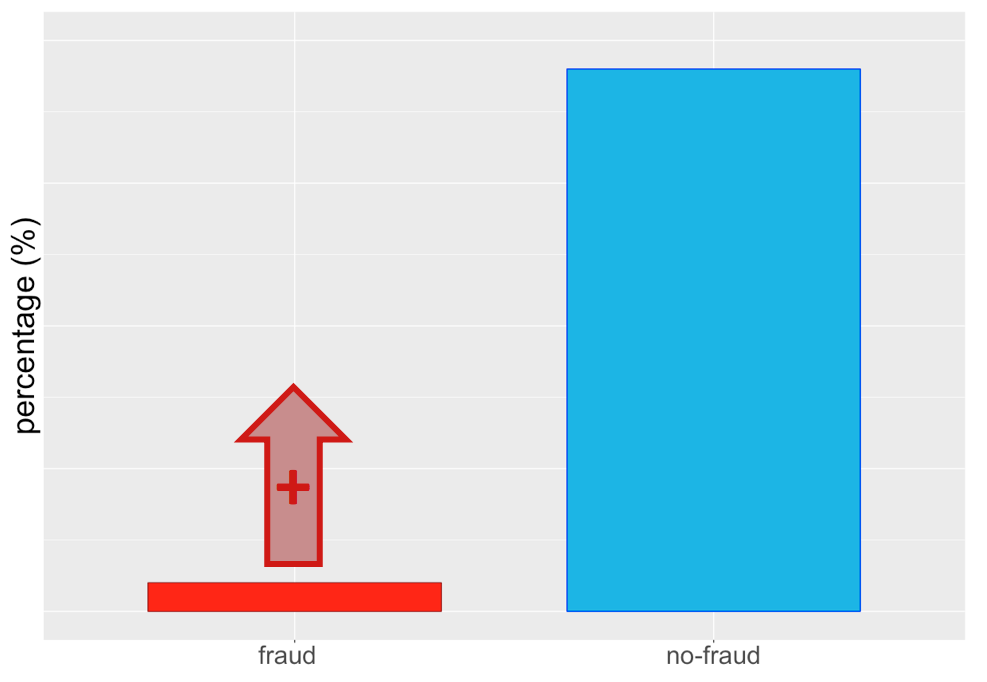
Over-sampling คลาสส่วนน้อย...

กราฟแท่งคลาสหลัง over-sampling

การตรวจจับการฉ้อโกงใน R

... หรือ under-sampling คลาสส่วนใหญ่ ...
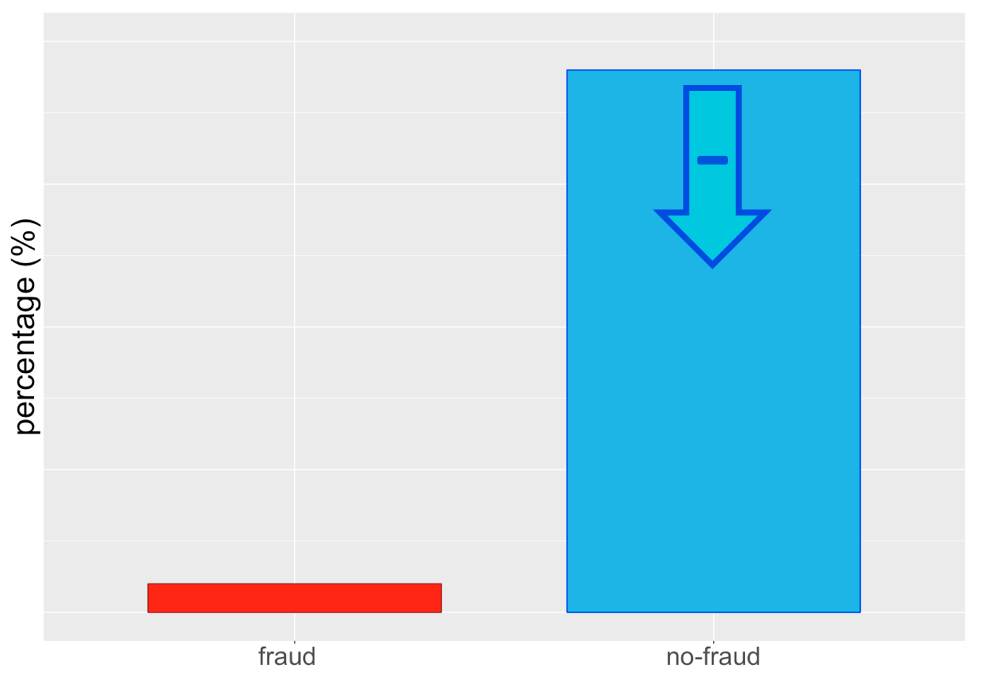
กราฟแท่งคลาสหลัง under-sampling

การตรวจจับการฉ้อโกงใน R

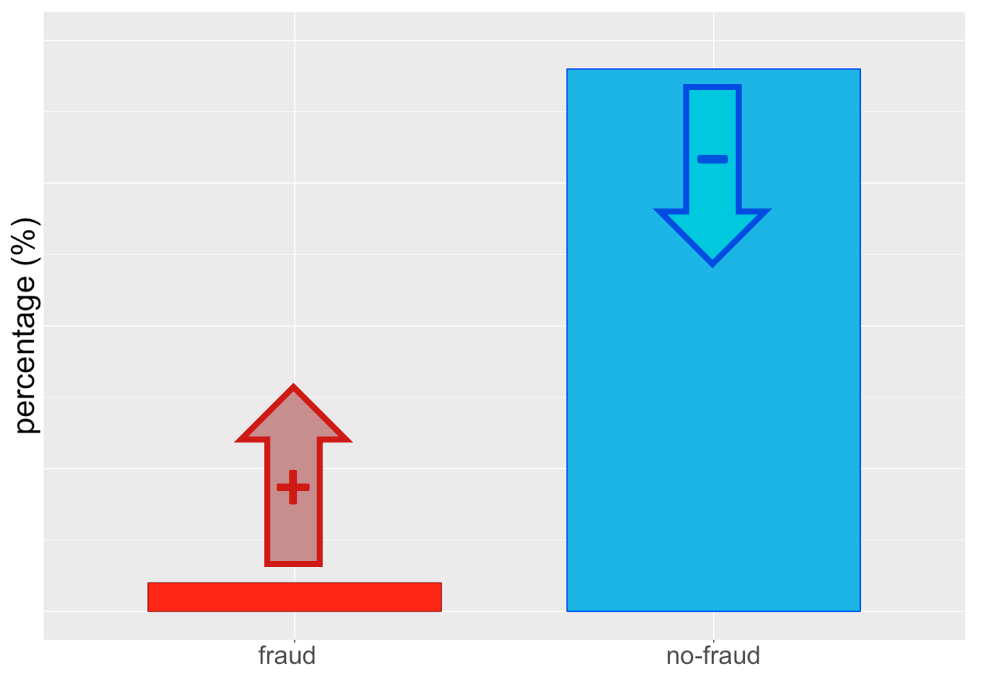
... หรือทั้งสองอย่าง!

กราฟแท่งคลาสหลังใช้ทั้งสองวิธี

การตรวจจับการฉ้อโกงใน R

ผลลัพธ์หลังการสุ่มตัวอย่าง...

กราฟแท่งคลาสผลลัพธ์แบบ 2

การตรวจจับการฉ้อโกงใน R

... หรือแบบนี้

กราฟแท่งคลาสผลลัพธ์แบบ 1

การตรวจจับการฉ้อโกงใน R

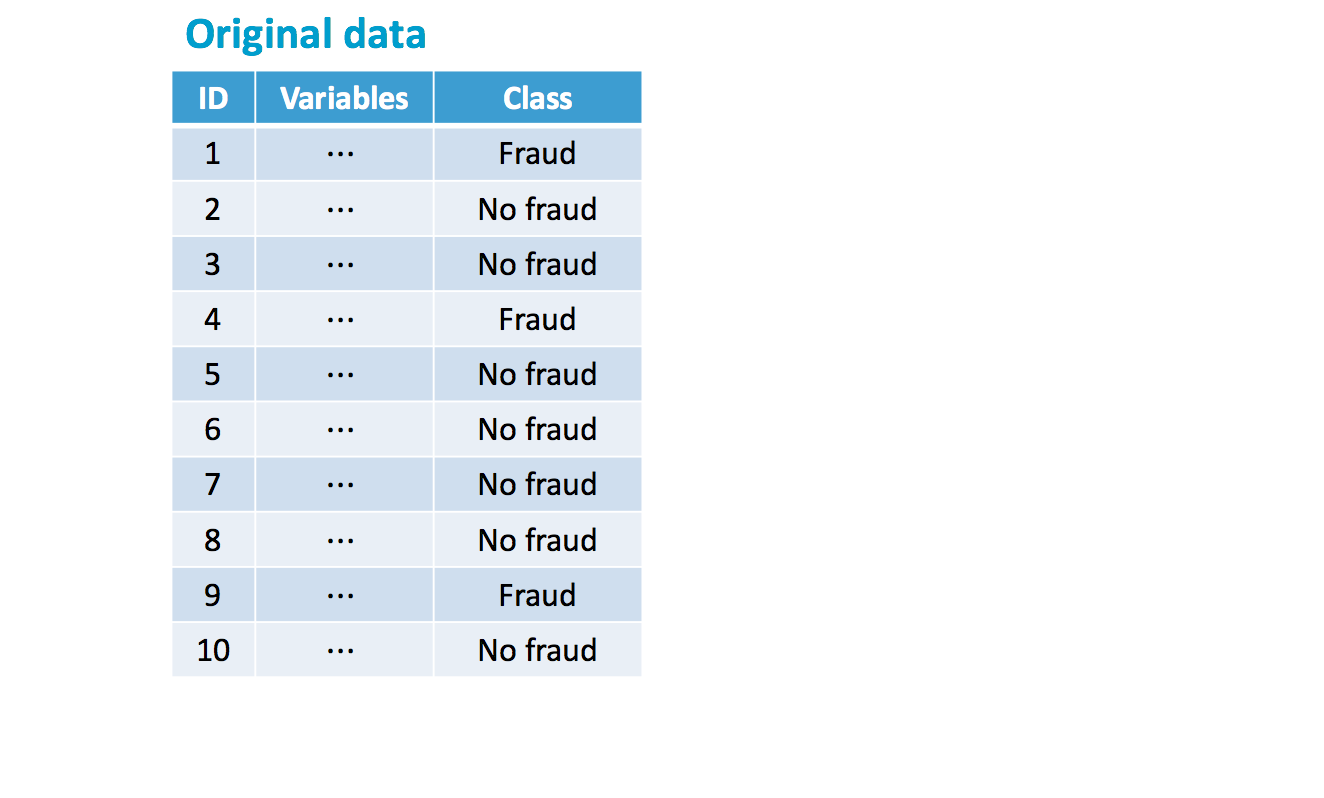
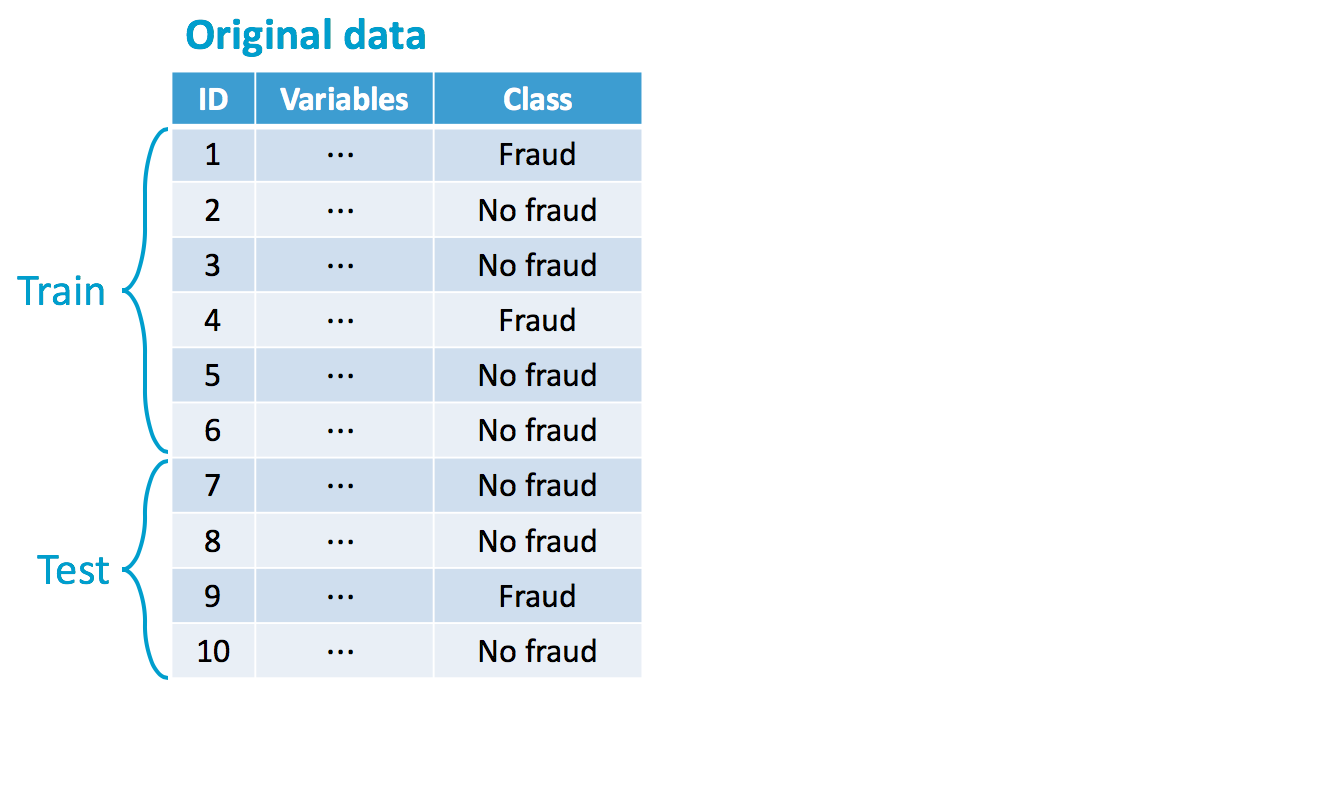
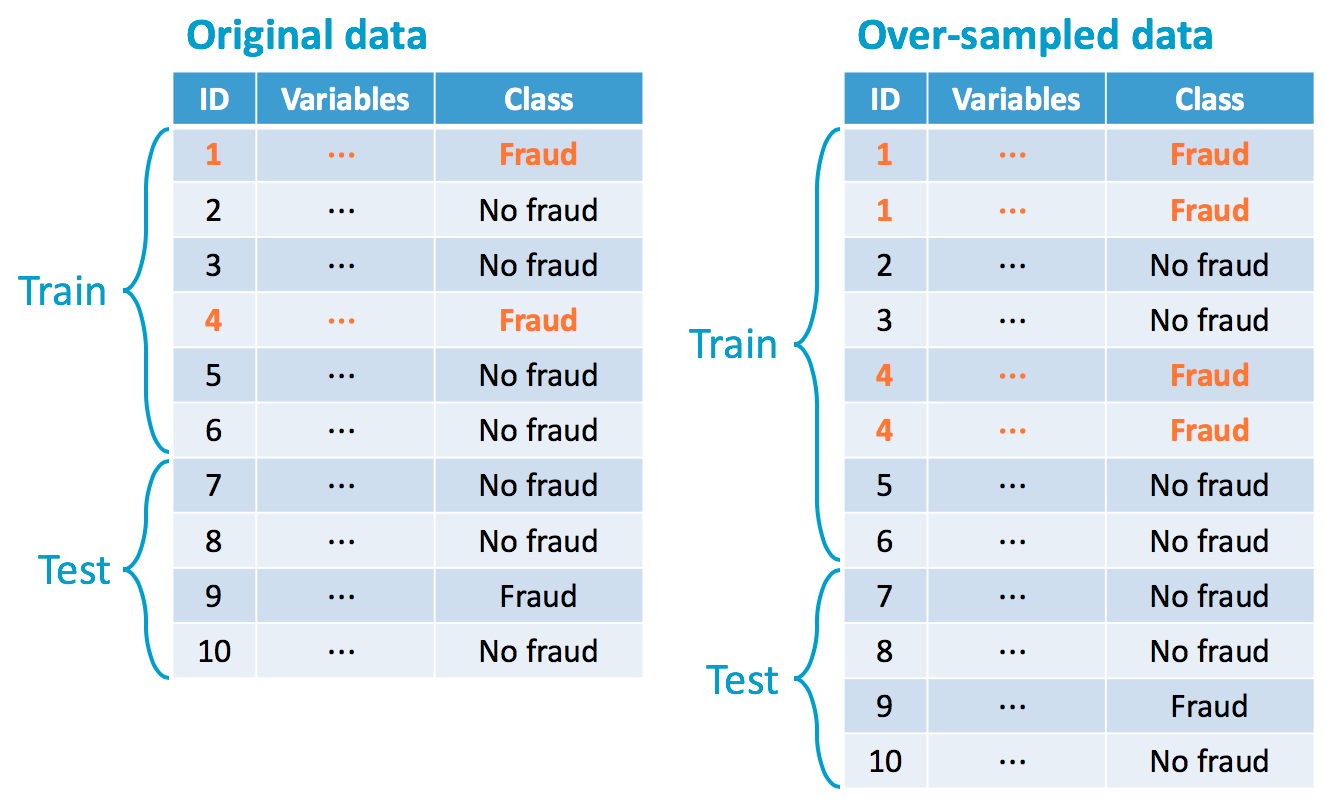
Random over-sampling (ROS)

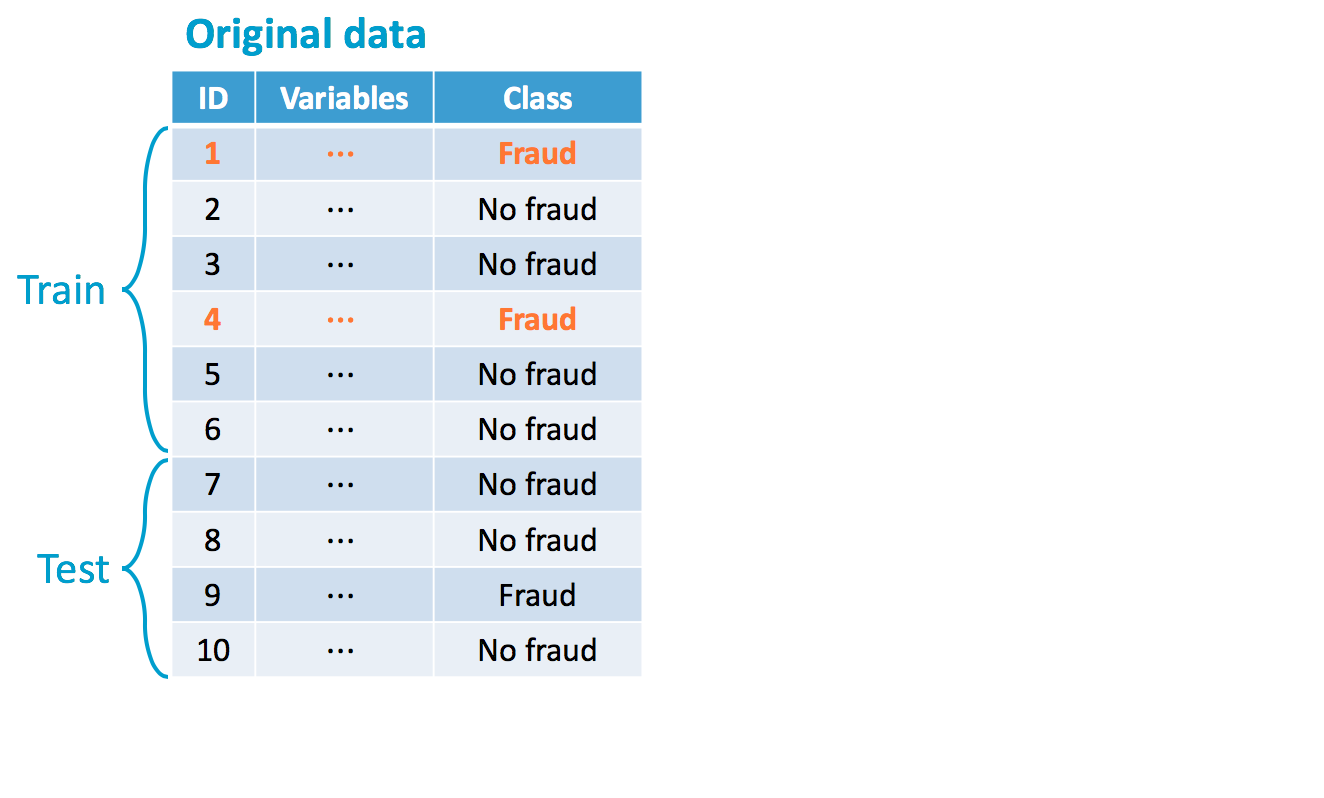
ข้อมูลดั้งเดิม v0

การตรวจจับการฉ้อโกงใน R

ข้อมูลดั้งเดิมแบ่ง train/test

การตรวจจับการฉ้อโกงใน R

random oversampling v0

การตรวจจับการฉ้อโกงใน R

random oversampling v1

การตรวจจับการฉ้อโกงใน R

Random over-sampling ในทางปฏิบัติ

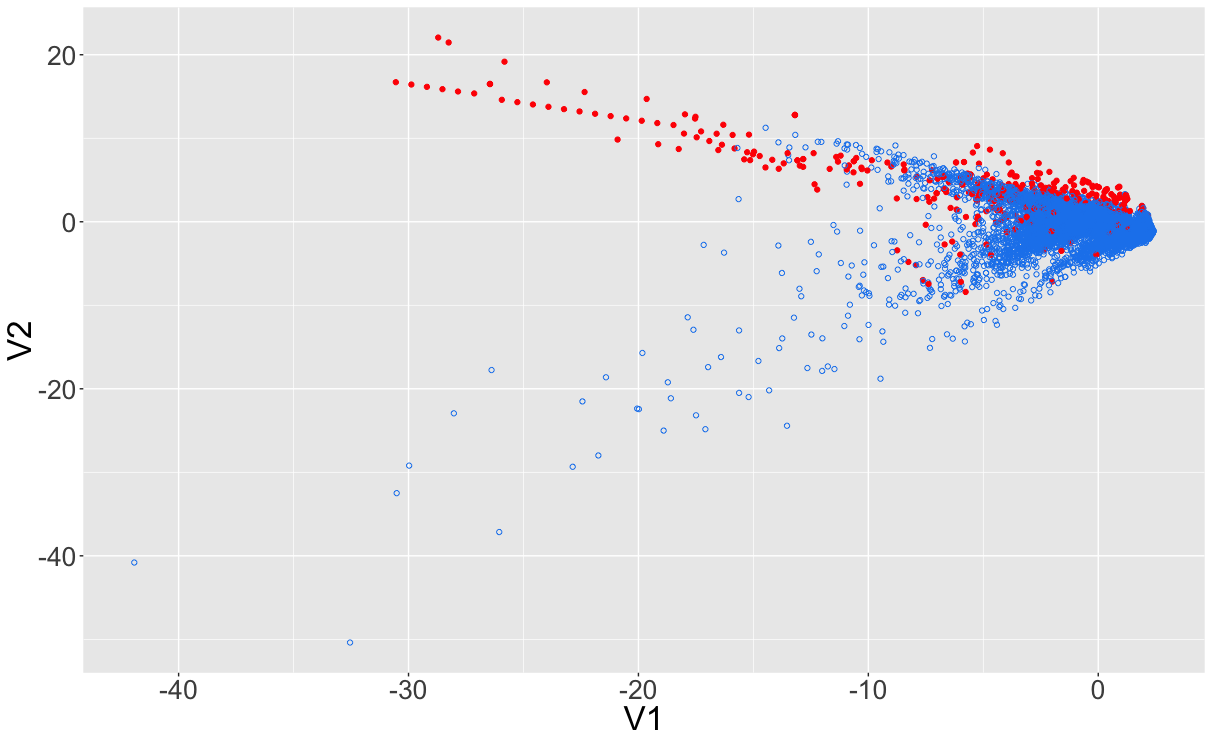
  • ชุดข้อมูล Credit Card Fraud Detection บน Kaggle
    • $\sim$ 300K รายการธุรกรรมบัตรเครดิตที่ผ่านการทำให้ไม่ระบุตัวตน พร้อมป้ายกำกับว่าเป็นการฉ้อโกงหรือปกติ
  • ข้อมูลเกี่ยวกับชุดข้อมูล...
    • ตัวแปรเชิงตัวเลข (ไม่ระบุตัวตน): V1, V2, ... , V28
    • Time = จำนวนวินาทีที่ผ่านไประหว่างแต่ละธุรกรรมกับธุรกรรมแรกในชุดข้อมูล
    • Amount = จำนวนเงินของธุรกรรม
    • Class = ตัวแปรตอบสนอง: ค่า 1 หมายถึงฉ้อโกง และ 0 หมายถึงปกติ
การตรวจจับการฉ้อโกงใน R

กราฟ creditcard V2 vs V1

การตรวจจับการฉ้อโกงใน R

ตรวจสอบความไม่สมดุล

head(creditcard)
  Time         V1         V2  ...            V27         V28 Amount Class
1    0  1.1918571  0.2661507  ...  -0.0089830991  0.01472417   2.69     0
2   10  0.3849782  0.6161095  ...   0.0424724419 -0.05433739   9.99     0
3   12 -0.7524170  0.3454854  ...  -0.1809975001  0.12939406  15.99     0
4   17  0.9624961  0.3284610  ...   0.0163706433 -0.01460533  34.09     0
5   34  0.2016859  0.4974832  ...   0.1427572469  0.21923761   9.99     0
prop.table(table(creditcard$Class))
   0    1 
0.98 0.02
การตรวจจับการฉ้อโกงใน R

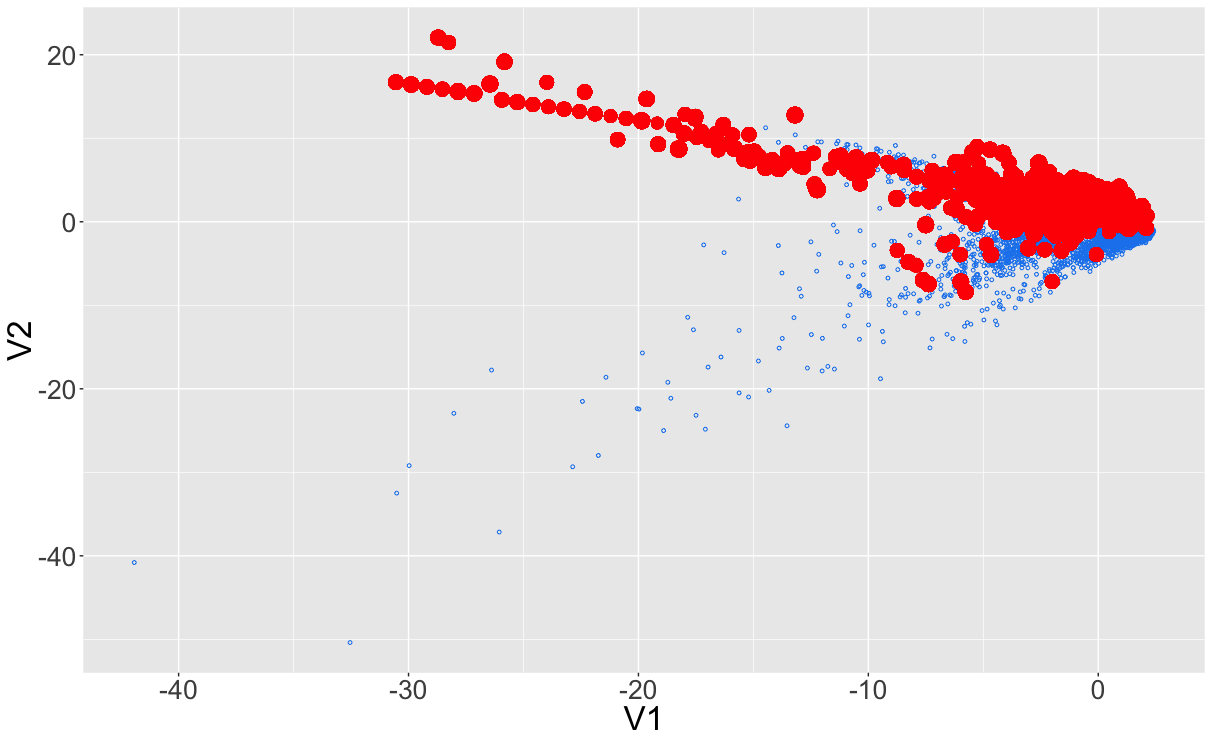
`ovun.sample` จากแพ็กเกจ ROSE

n_legit <- 24108
new_frac_legit <- 0.50
new_n_total <- n_legit / new_frac_legit ## = 24108 / 0.50 = 48216

library(ROSE) oversampling_result <- ovun.sample(formula = Class ~ ., data = creditcard, method = "over", N = new_n_total, seed = 2018)
oversampled_credit <- oversampling_result$data prop.table(table(oversampled_credit$Class))
  0   1 
0.5 0.5
การตรวจจับการฉ้อโกงใน R

กราฟ creditcard V2 vs V1 หลัง over-sampling

การตรวจจับการฉ้อโกงใน R

มาฝึกกันเถอะ!

การตรวจจับการฉ้อโกงใน R

Preparing Video For Download...