Förbered text för modellering

Introduktion till naturlig språkbehandling i R

Kasey Jones

Research Data Scientist

Övervakad inlärning i R: klassificering

Introduktion till naturlig språkbehandling i R

Klassificeringsmodellering

  • övervakad inlärning
  • klassificerar observationer i kategorier
    • vinst/förlust
    • farlig, vänlig eller likgiltig
  • flera tekniker kan användas:
    • logistisk regression
    • beslutsträd/random forest/xgboost
    • neurala nätverk
    • m.m.
Introduktion till naturlig språkbehandling i R

Grundläggande modelleringssteg

  1. Rensa/förbered data
  2. Skapa tränings- och testdatamängder
  3. Träna en modell på träningsdatamängden
  4. Rapportera noggrannhet på testdatamängden
Introduktion till naturlig språkbehandling i R

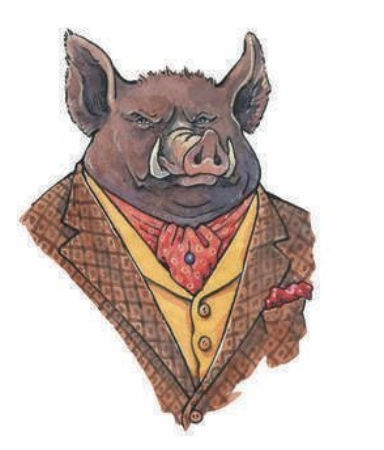
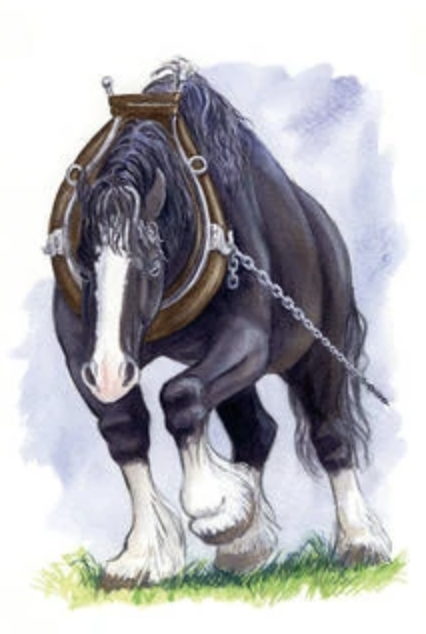
Karaktärsigenkänning

Napoleon Napoleon

Boxer Boxer

1 https://comicvine.gamespot.com/napoleon/4005-141035/ 2 https://hero.fandom.com/wiki/Boxer_(Animal_Farm)
Introduktion till naturlig språkbehandling i R

Djurmeningar

# Make sentences
sentences <- animal_farm %>%
  unnest_tokens(output = "sentence", token = "sentences", input = text_column)
# Label sentences by animal
sentences$boxer <- grepl('boxer', sentences$sentence)
sentences$napoleon <- grepl('napoleon', sentences$sentence)
# Replace the animal name
sentences$sentence <- gsub("boxer", "animal X", sentences$sentence)
sentences$sentence <- gsub("napoleon", "animal X", sentences$sentence)
animal_sentences <- sentences[sentences$boxer + sentences$napoleon == 1, ]
Introduktion till naturlig språkbehandling i R

Meningar, fortsättning

animal_sentences$Name <-
    as.factor(ifelse(animal_sentences$boxer, "boxer", "napoleon"))
# 75 of each
animal_sentences <- 
  rbind(animal_sentences[animal_sentences$Name == "boxer", ][c(1:75), ],
        animal_sentences[animal_sentences$Name == "napoleon", ][c(1:75), ])
animal_sentences$sentence_id <- c(1:dim(animal_sentences)[1])
Introduktion till naturlig språkbehandling i R

Förbered data

library(tm); library(tidytext)
library(dplyr); library(SnowballC)
animal_tokens <- animal_sentences %>%
  unnest_tokens(output = "word", token = "words", input = sentence) %>%
  anti_join(stop_words) %>%
  mutate(word = wordStem(word))
Introduktion till naturlig språkbehandling i R

Förberedelse, fortsättning

animal_matrix <- animal_tokens %>%
  count(sentence_id, word) %>%
  cast_dtm(document = sentence_id, term = word,
           value = n, weighting = tm::weightTfIdf)
animal_matrix
<<DocumentTermMatrix (documents: 150, terms: 694)>>
Non-/sparse entries: 1235/102865
Sparsity           : 99%
Maximal term length: 17
Weighting          : term frequency - inverse document frequency
Introduktion till naturlig språkbehandling i R

Ta bort glesa termer

  • Icke-tomma (1 235) + tomma (102 865)
  • Matrisdimensioner 150 * 694
  • Gleshet: 102 865 / 104 100 (99 %)

Lösning: removeSparseTerms()

Introduktion till naturlig språkbehandling i R

Hur glest är för glest?

removeSparseTerms(animal_matrix, sparse = .90)
<<DocumentTermMatrix (documents: 150, terms: 4)>>
Non-/sparse entries: 207/393
Sparsity           : 66%
removeSparseTerms(animal_matrix, sparse = .99)
<<DocumentTermMatrix (documents: 150, terms: 172)>>
Non-/sparse entries: 713/25087
Sparsity           : 97%
Introduktion till naturlig språkbehandling i R

Nu kör vi en övning!

Introduktion till naturlig språkbehandling i R

Preparing Video For Download...