ทำไมต้องแปลงฟีเจอร์เดิม?

Feature Engineering in R

Jorge Zazueta

Research Professor. Head of the Modeling Group at the School of Economics, UASLP

ทำให้โมเดลทำงานได้ง่ายขึ้น

การทำให้ข้อมูลจัดการได้ง่ายขึ้นช่วยเพิ่มประสิทธิภาพของโมเดล machine learning

glimpse(loans_num)
Rows: 614
Columns: 6
$ Loan_Status       <fct> Y, N, Y, Y, Y, Y, Y, N, Y, N, Y, Y, Y, N...
$ ApplicantIncome   <dbl> 5849, 4583, 3000, 2583, 6000, 5417, 233...
$ CoapplicantIncome <dbl> 0, 1508, 0, 2358, 0, 4196, 1516, 2504, 1...
$ LoanAmount        <dbl> NA, 128, 66, 120, 141, 267, 95, 158, 168...
$ Loan_Amount_Term  <dbl> 360, 360, 360, 360, 360, 360, 360, 360, ...
$ Credit_History    <fct> 1, 1, 1, 1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 1...
Feature Engineering in R

การแปลง Log

การแปลง log สำหรับฟีเจอร์ตัวเลขเพื่อ:

  • จัดการข้อมูลที่มีการกระจายเบ้
  • ลดผลกระทบของค่าผิดปกติ
  • แปลงความสัมพันธ์แบบคูณให้เป็นแบบบวก
  • ทำให้ข้อมูลเหมาะสมกับการสร้างโมเดลมากขึ้น
  • ใช้ได้เฉพาะกับค่าที่เป็นบวกเท่านั้น

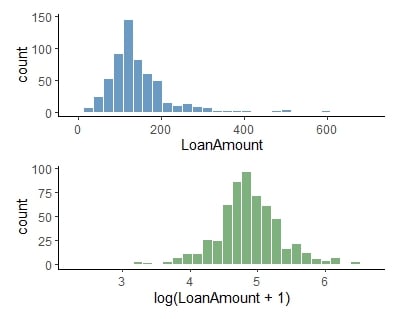
ข้อมูลจำนวนเงินกู้หลังแปลง log

การเปรียบเทียบข้อมูลดิบและข้อมูลหลังแปลง log

Feature Engineering in R

การ Normalize

การ Normalize หรือ Scale ฟีเจอร์ตัวเลขเพื่อ:

  • ป้องกันไม่ให้ฟีเจอร์ใดฟีเจอร์หนึ่งมีอิทธิพลเหนือฟีเจอร์อื่น
  • ช่วยให้เปรียบเทียบขนาดของค่าได้ง่ายขึ้น
  • ทำให้ข้อมูลเหมาะสมกับการสร้างโมเดลมากขึ้น

เช่น ค่า loan amount term มีความแตกต่างกันมาก
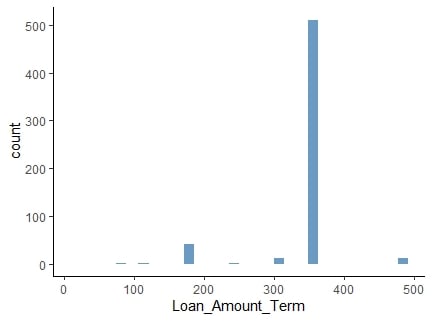
ฮิสโตแกรมแสดงค่า loan amount

Feature Engineering in R

การ Normalize

การ Normalize หรือ Scale ฟีเจอร์ตัวเลขเพื่อ:

  • ป้องกันไม่ให้ฟีเจอร์ใดฟีเจอร์หนึ่งมีอิทธิพลเหนือฟีเจอร์อื่น
  • ช่วยจัดการค่าผิดปกติและ
  • ข้อมูลที่ขาดหาย
  • ทำให้ข้อมูลเหมาะสมกับการสร้างโมเดลมากขึ้น

ค่าที่ผ่านการ Normalize จะยังคงการกระจายเดิมไว้ แต่มีความแปรปรวนอยู่
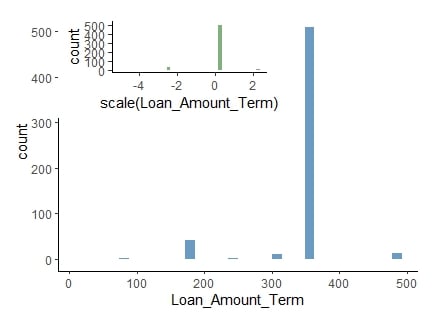
ฮิสโตแกรมแสดงค่า loan amount ทับซ้อนกับข้อมูลที่ผ่านการ Normalize

Feature Engineering in R

กำหนดโมเดลและ Recipe

ตอนนี้สามารถกำหนดโมเดล logistic regression และเพิ่ม recipe สำหรับการ impute, normalize และแปลง log ให้กับฟีเจอร์ที่เกี่ยวข้องได้

lr_model <- logistic_reg()

lr_recipe <- 
  recipe(Loan_Status ~., 
         data = train) %>%
  step_impute_knn(
    all_numeric_predictors())%>%
  step_normalize(Loan_Amount_Term) %>%
  step_log(all_numeric_predictors(),
           -Loan_Amount_Term, offset = 1)

การพิมพ์ออบเจกต์ recipe จะแสดงสรุปขั้นตอนที่ใช้

lr_recipe
Recipe

Inputs:

      role #variables
   outcome          1
 predictor          5

Operations:

K-nearest neighbor imputation for all_numeric_predictors()
Centering and scaling for Loan_Amount_Term
Log transformation on all_numeric_predictors(),-Loan_Amount_Term
Feature Engineering in R

วัดประสิทธิภาพอย่างมีประสิทธิภาพ

กำหนดชุดเมตริก roc_auc, accuracy และ sens เพื่อประเมิน workflow object lr_fit

class_evaluate <- metric_set(
  roc_auc, accuracy, sens)

จากนั้นรันเหมือนฟังก์ชันทั่วไป

lr_aug %>% 
  class_evaluate(
    truth = Loan_Status, 
    estimate = .pred_class, 
    .pred_Y)

ชุดเมตริกที่กำหนดเอง

# A tibble: 3 × 3
  .metric  .estimator .estimate
  <chr>    <chr>          <dbl>
1 accuracy binary         0.813
2 sens     binary         0.467
3 roc_auc  binary         0.288
Feature Engineering in R

มาฝึกกันเถอะ!

Feature Engineering in R

Preparing Video For Download...