Mapeo dinámico de tareas
Creación de canalizaciones de datos con Airflow

Volker Janz
Senior Developer Advocate at Astronomer
El problema de las tareas con valores fijos
@task
def process_file_1():
    transform("/data/file_1.csv")
@task
def process_file_2():
    transform("/data/file_2.csv")
@task
def process_file_3():
    transform("/data/file_3.csv")
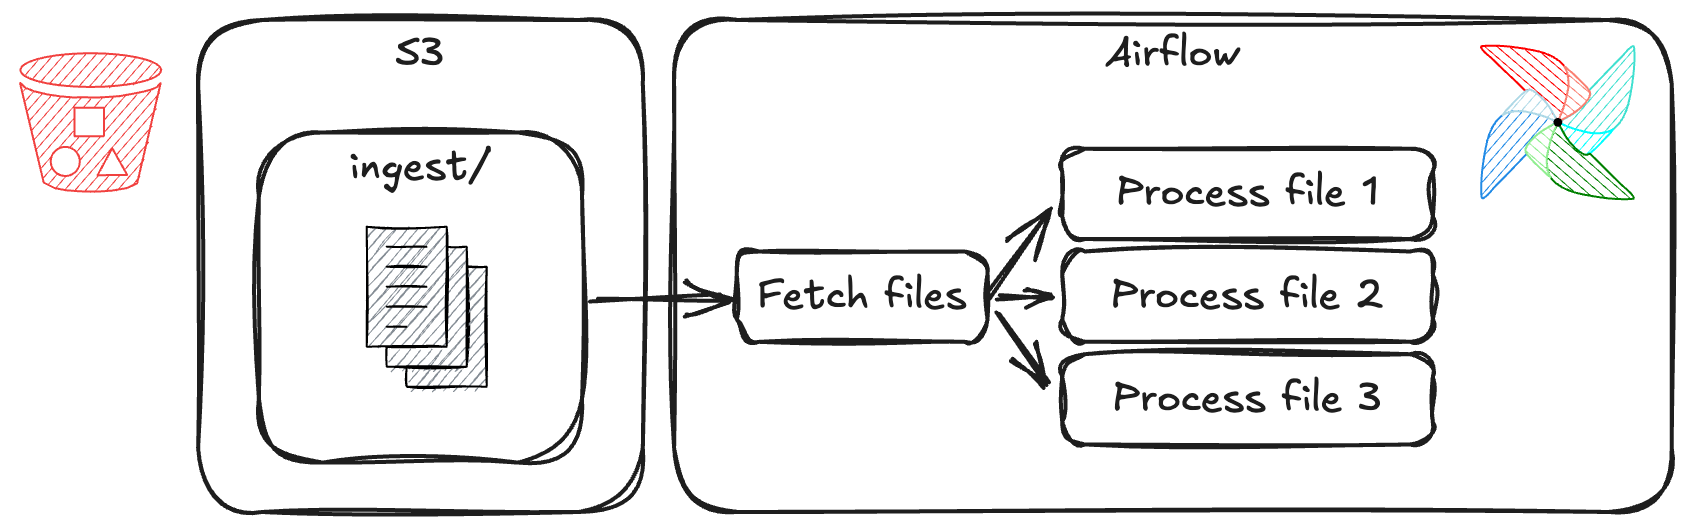
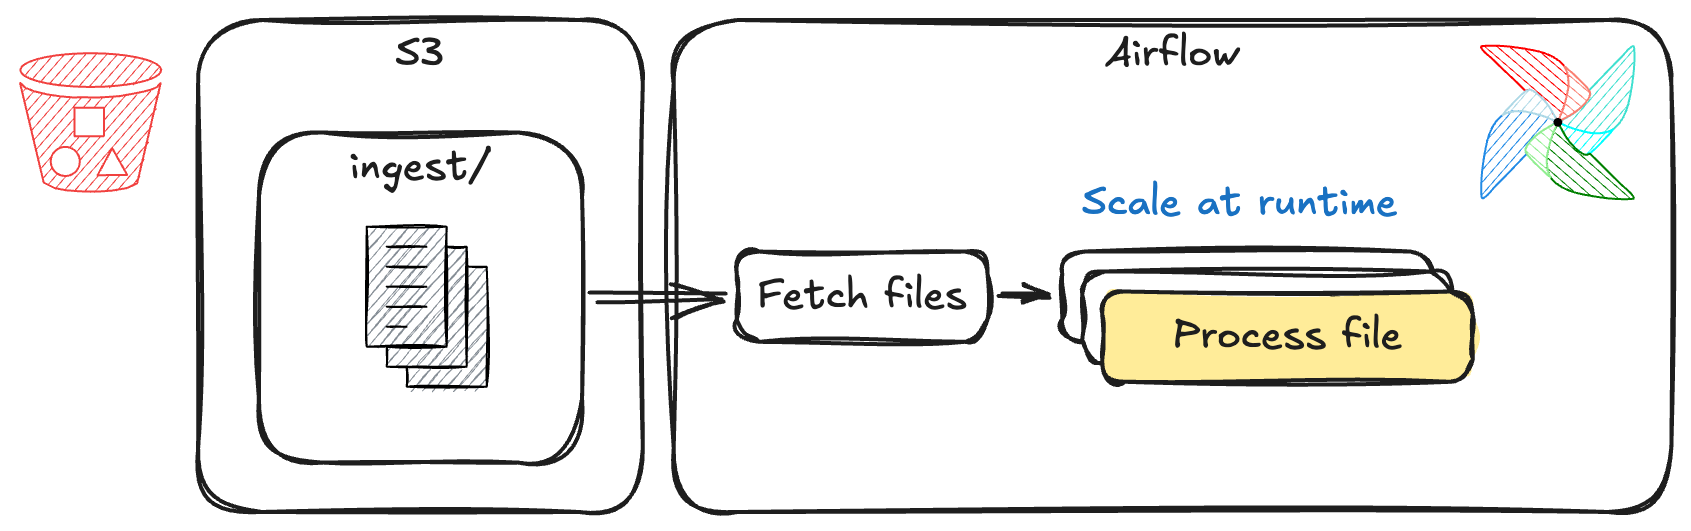
.expand()
@task def fetch_files(): return ["/data/file_1.csv", "/data/file_2.csv", "/data/file_3.csv"]@task(max_active_tis_per_dagrun=2) # controlar la paralelización máxima def process_file(path: str): print(f"processing file: {path}")files = fetch_files() process_file.expand(path=files)
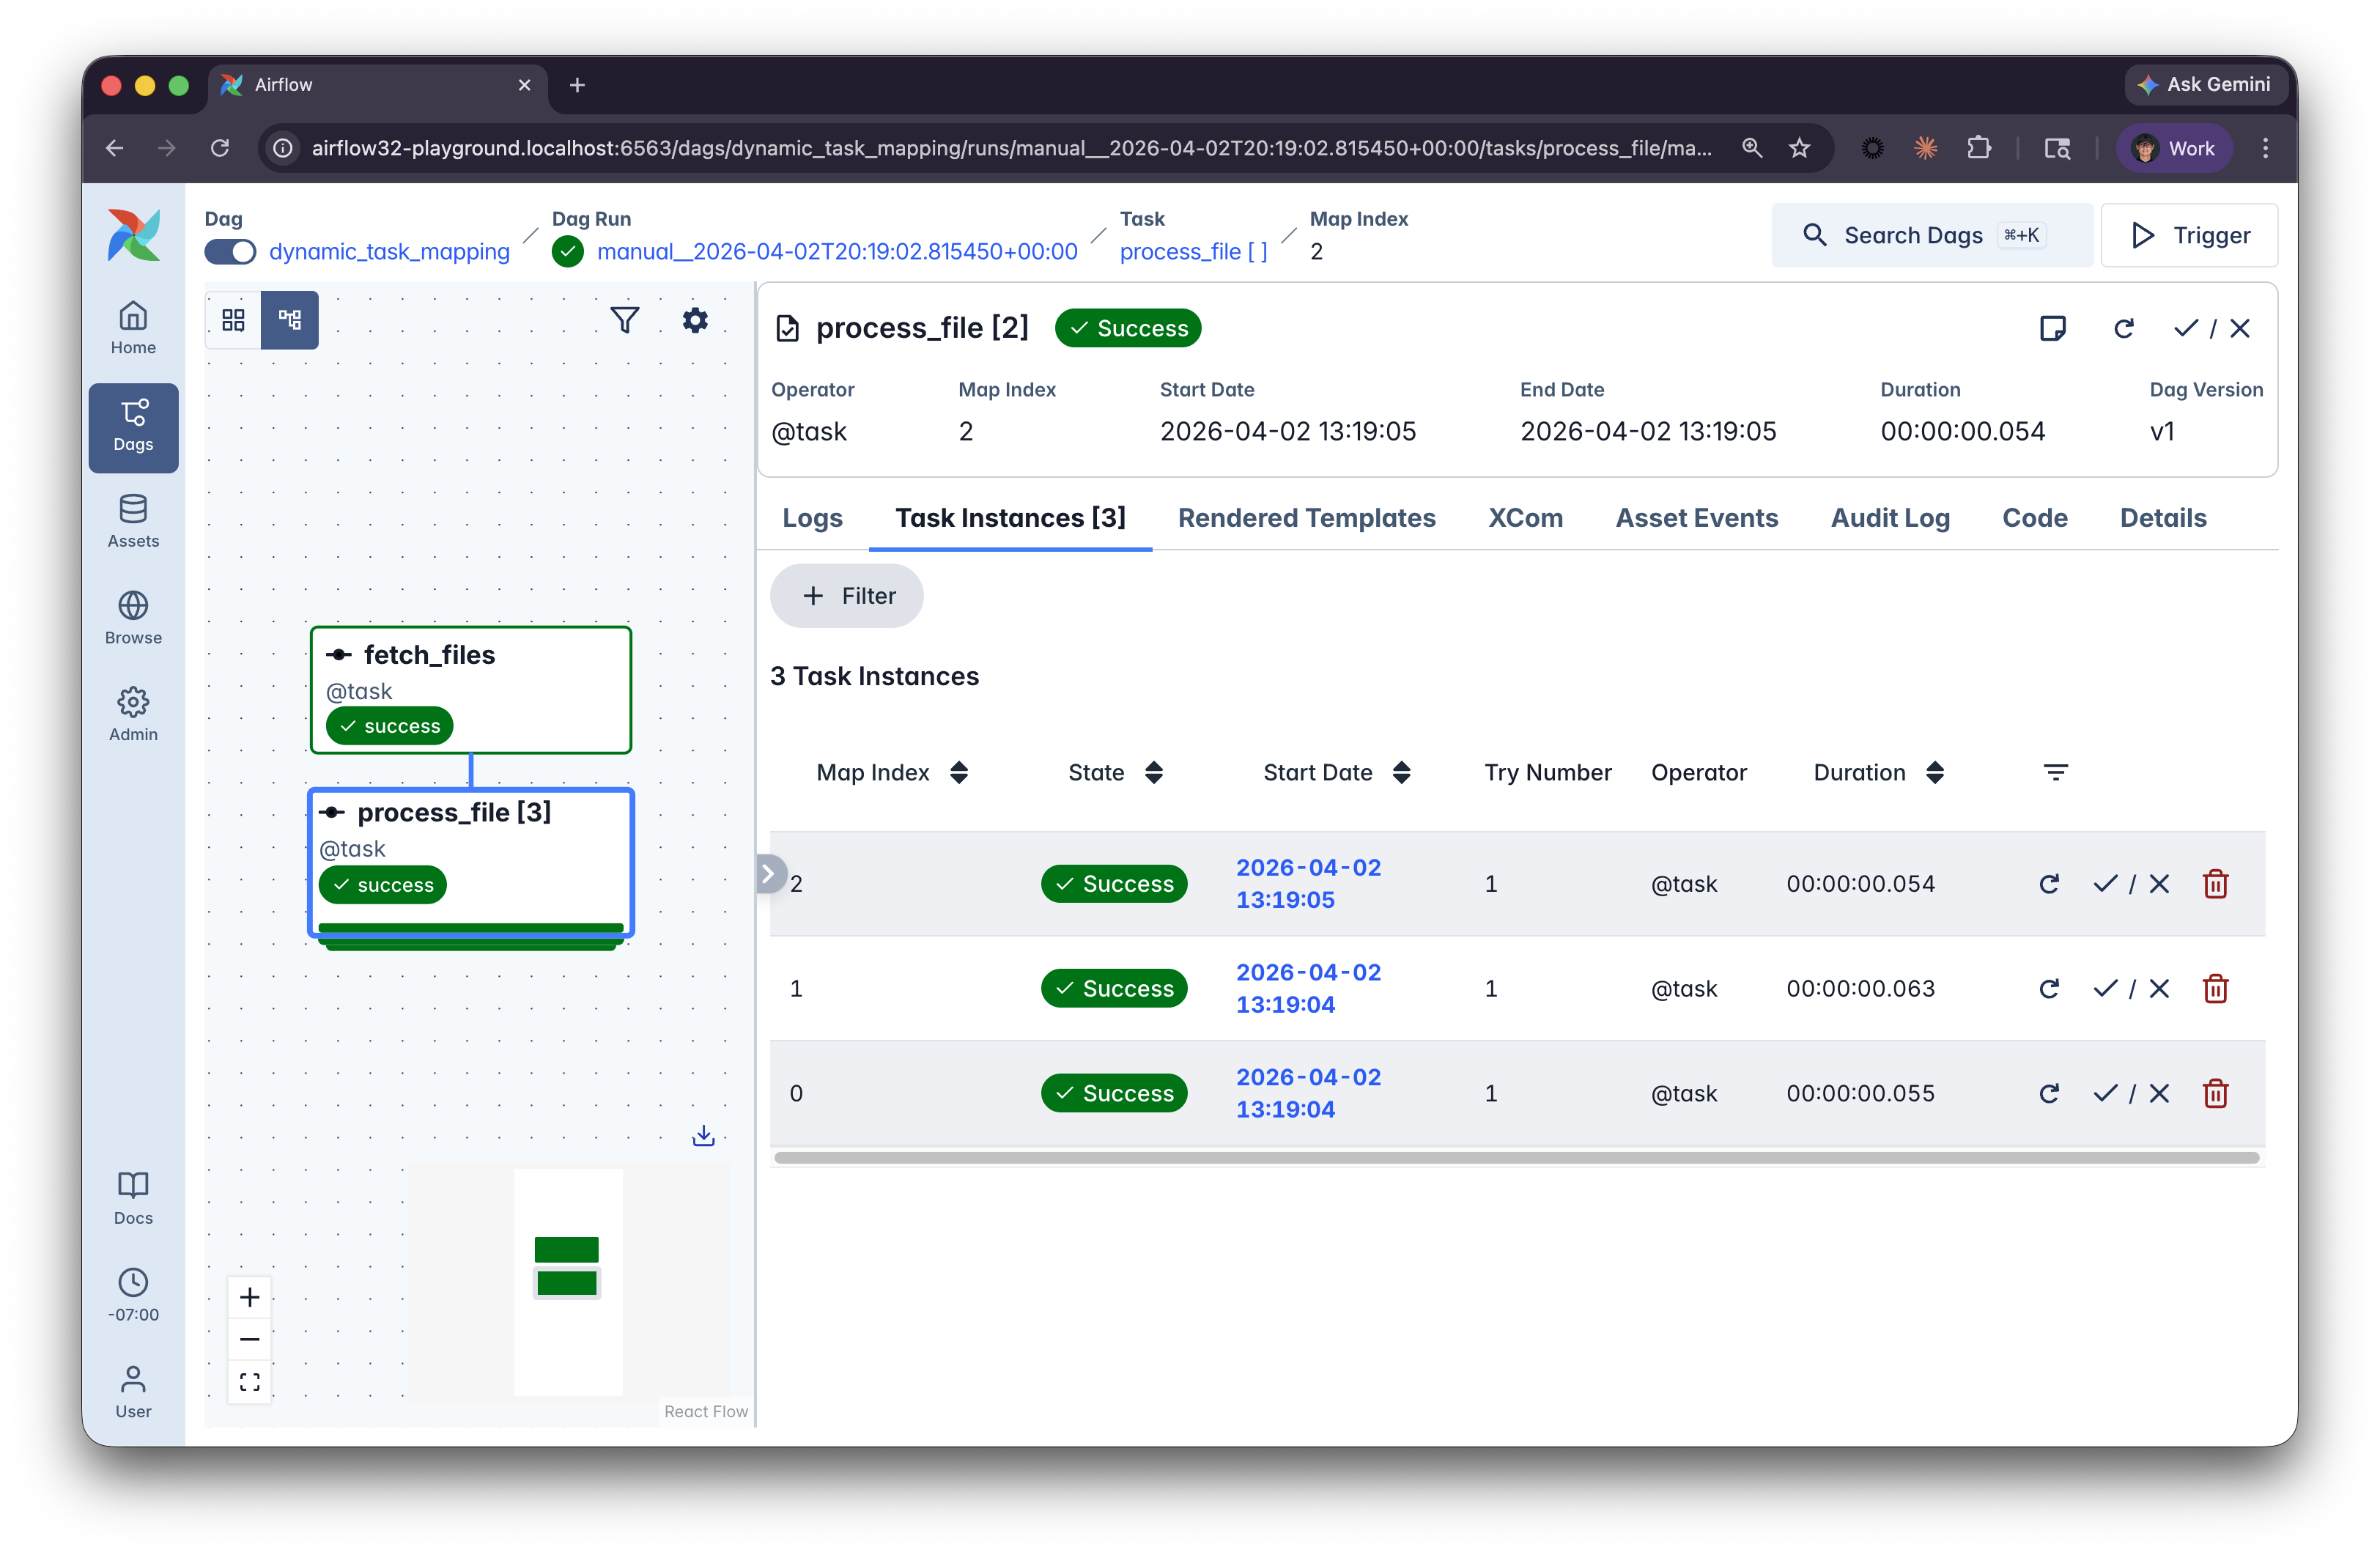
Tareas mapeadas en la interfaz
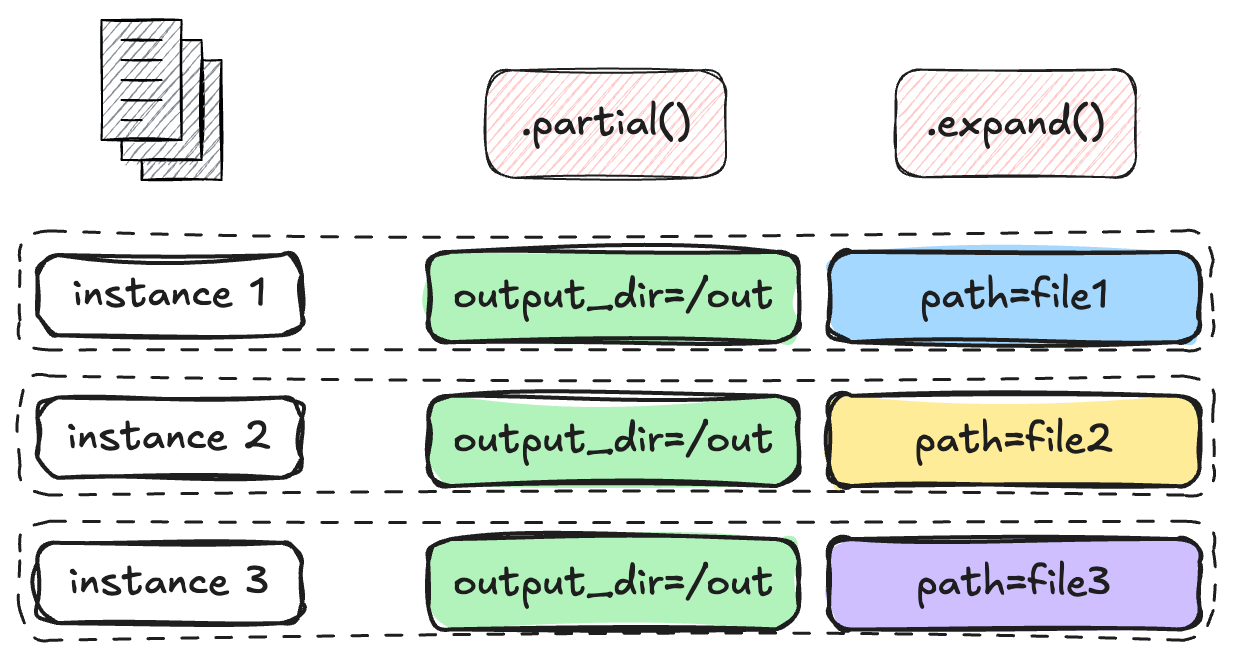
.partial()
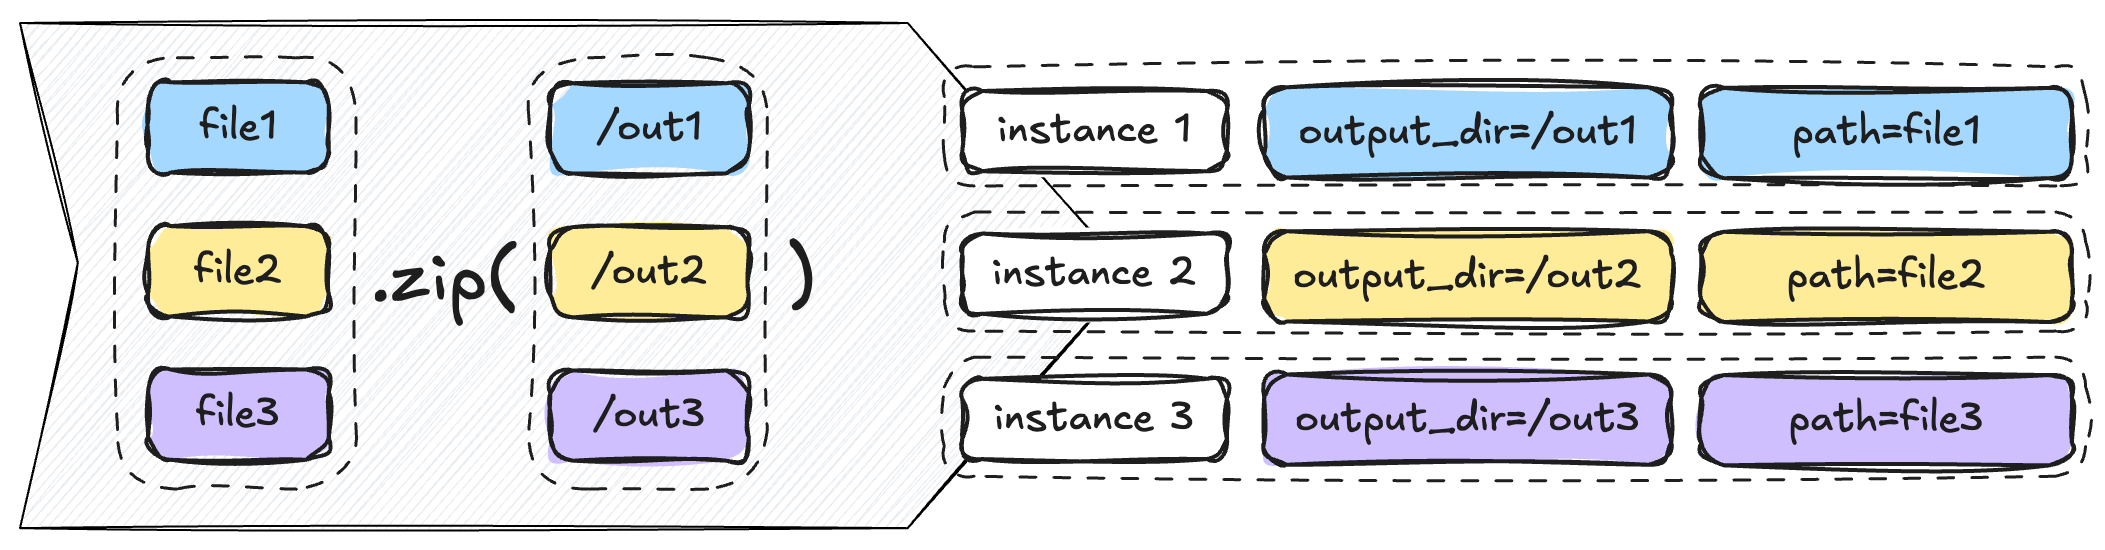
@task def process_file(path: str, output_dir: str): transform(path, output_dir)files = get_files() process_file.partial(output_dir="/out").expand(path=files)
El problema del producto cartesiano
files = get_files() # ["/data/a.csv", "/data/b.csv", "/data/c.csv"] destinations = get_targets() # ["s3://out/a", "s3://out/b", "s3://out/c"]# Producto cartesiano: 3 x 3 = 9 instancias (¡no es lo que queremos!) process.expand(path=files, dest=destinations)