Ejecución de cargas de trabajo SQL

Creación de canalizaciones de datos con Airflow

Volker Janz

Senior Developer Advocate at Astronomer

¿Por qué SQL en Airflow?
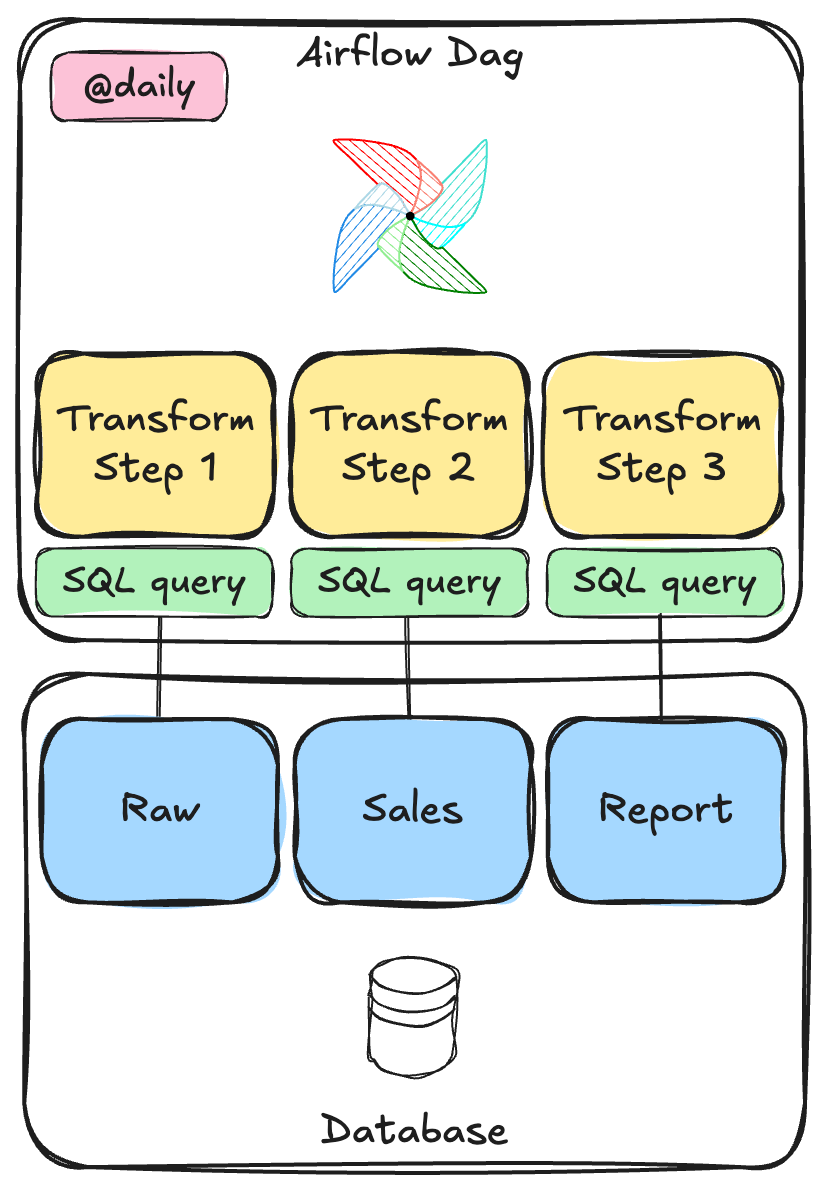
 

  • Las cargas de trabajo de SQL son el caso más común en Airflow
  • Deja que la base de datos haga el trabajo pesado
  • Airflow orquesta el cuándo y el dónde
  • La base de datos se encarga del cómo

Orquestación de SQL en Airflow

Creación de canalizaciones de datos con Airflow

SQLExecuteQueryOperator

from airflow.providers.common.sql.operators.sql import SQLExecuteQueryOperator

SQLExecuteQueryOperator( task_id="load_sales", conn_id="duckdb_analytics", sql="INSERT INTO sales SELECT * FROM staging", )


  • Funciona con cualquier base de datos que tenga un proveedor compatible de Airflow
  • PostgreSQL, Snowflake, BigQuery, DuckDB y más
Creación de canalizaciones de datos con Airflow

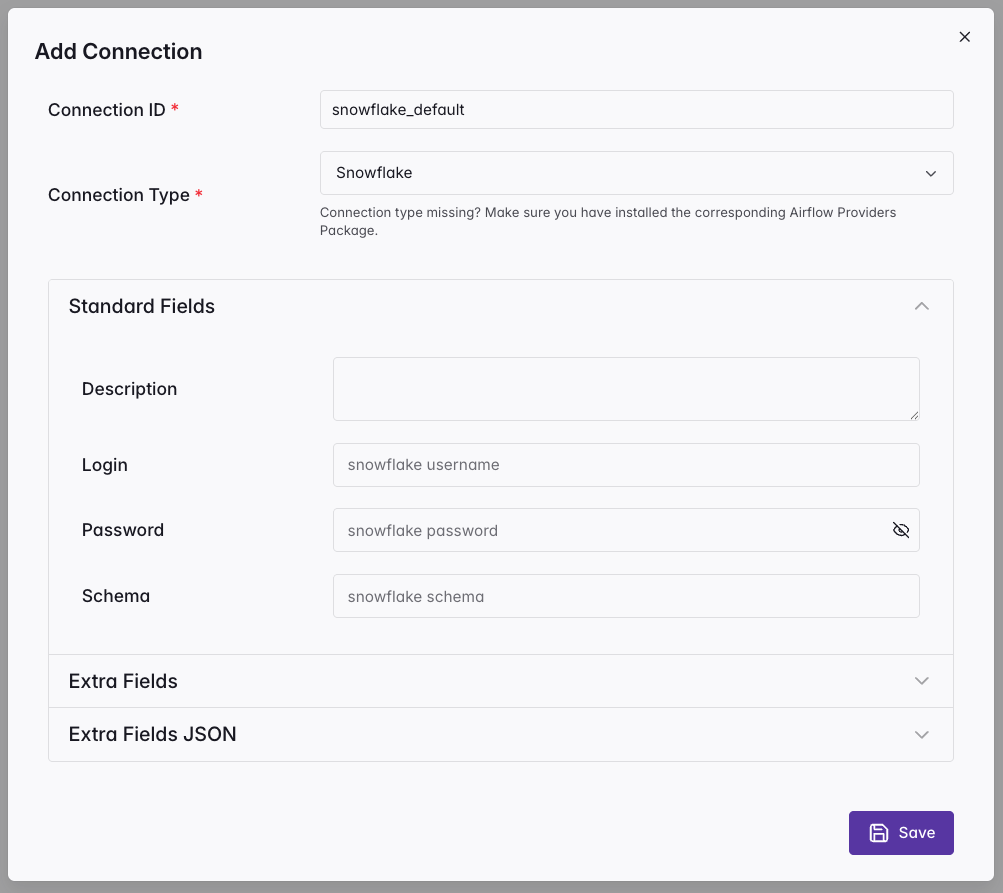
Conexiones

  • Guarda las credenciales fuera de tu código
  • Cada una tiene ID, tipo, host, puerto, usuario
  • Se crean de varias formas: UI, CLI, API o variables de entorno
  • Haz referencia con conn_id en los operadores

UI de conexiones de Airflow

Creación de canalizaciones de datos con Airflow

Crear una canalización SQL

from airflow.sdk import dag, task
from airflow.providers.common.sql.operators.sql import SQLExecuteQueryOperator

@dag(schedule="@daily")
def sales_pipeline():

    aggregate = SQLExecuteQueryOperator(
        task_id="aggregate_daily_sales",
        conn_id="duckdb_analytics",
        sql="""
            INSERT INTO daily_summary (order_date, total_orders, total_revenue)
            SELECT order_date, COUNT(*), SUM(revenue)
            FROM raw_orders GROUP BY order_date
        """,
    )
Creación de canalizaciones de datos con Airflow

Archivos SQL externos

@dag(
    schedule="@daily",
    template_searchpath="/path/to/include/sql",
)
def sales_pipeline():
    aggregate = SQLExecuteQueryOperator(
        task_id="aggregate_daily_sales",
        conn_id="duckdb_analytics",
        sql="aggregate_sales.sql",
    )
  • Define template_searchpath en @dag
  • Referencia el nombre de archivo en sql
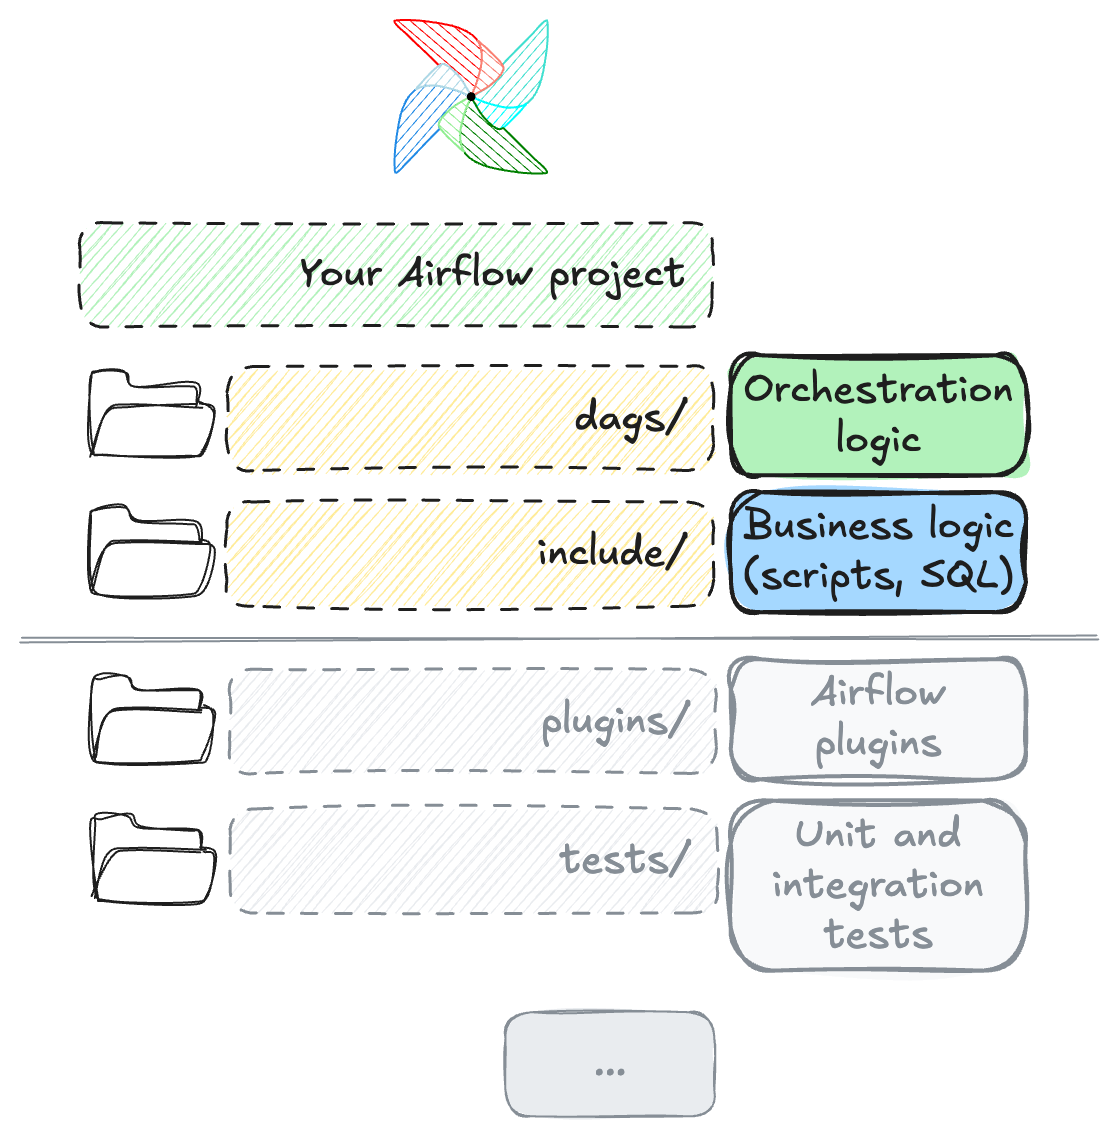
  • Mantén scripts y lógica de negocio fuera de la carpeta dags/ 💡

Estructura de archivos del proyecto

Creación de canalizaciones de datos con Airflow

Plantillas Jinja en archivos SQL

DELETE FROM daily_summary WHERE order_date = '{{ ds }}';

INSERT INTO daily_summary (order_date, total_orders, total_revenue)
SELECT order_date, COUNT(*), SUM(revenue)
FROM raw_orders
WHERE order_date = '{{ ds }}'
GROUP BY order_date;


  • {{ ds }} representa la fecha lógica (YYYY-MM-DD)
  • DELETE y luego INSERT: el patrón idempotente del Capítulo 2
  • Reejecutar la misma fecha produce el mismo resultado
Creación de canalizaciones de datos con Airflow

params vs parameters

params (renderizado con Jinja)

SQLExecuteQueryOperator(
    sql="""SELECT * FROM orders
           WHERE product = '{{ params.product }}'""",
    params={"product": user_input},
)
  • Valor interpolado en la cadena SQL
  • Vulnerable a inyección SQL

parameters (vinculación a nivel de BD)

SQLExecuteQueryOperator(
    sql="SELECT * FROM orders
         WHERE product = $product",
    parameters={"product": user_input},
)
  • Valor pasado al driver de la base de datos
  • Seguro ante inyecciones: el driver gestiona el escape
Creación de canalizaciones de datos con Airflow

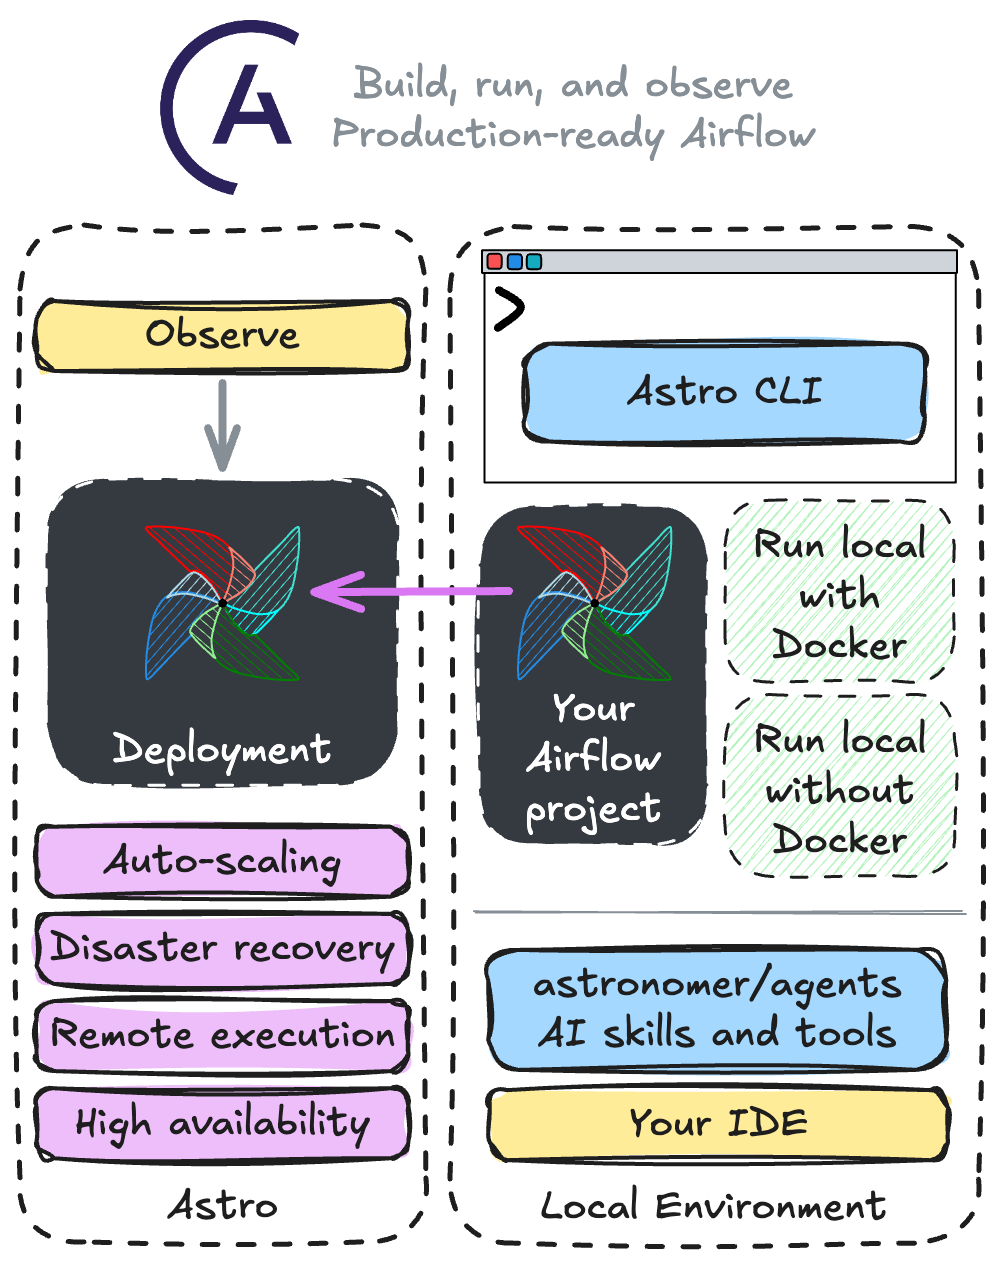
De local a producción con Astro

$$

  • Astronomer's Astro: plataforma gestionada de Airflow

$$

  • Astro CLI: Airflow local con un solo comando

$$

  • Desarrolla en local y despliega a producción sin fricciones

Astro CLI y plataforma

Creación de canalizaciones de datos con Airflow

¡Vamos a practicar!

Creación de canalizaciones de datos con Airflow

Preparing Video For Download...