Organiser des DAG complexes avec des groupes de tâches

Créer des pipelines de données avec Airflow

Volker Janz

Senior Developer Advocate at Astronomer

Le problème de complexité
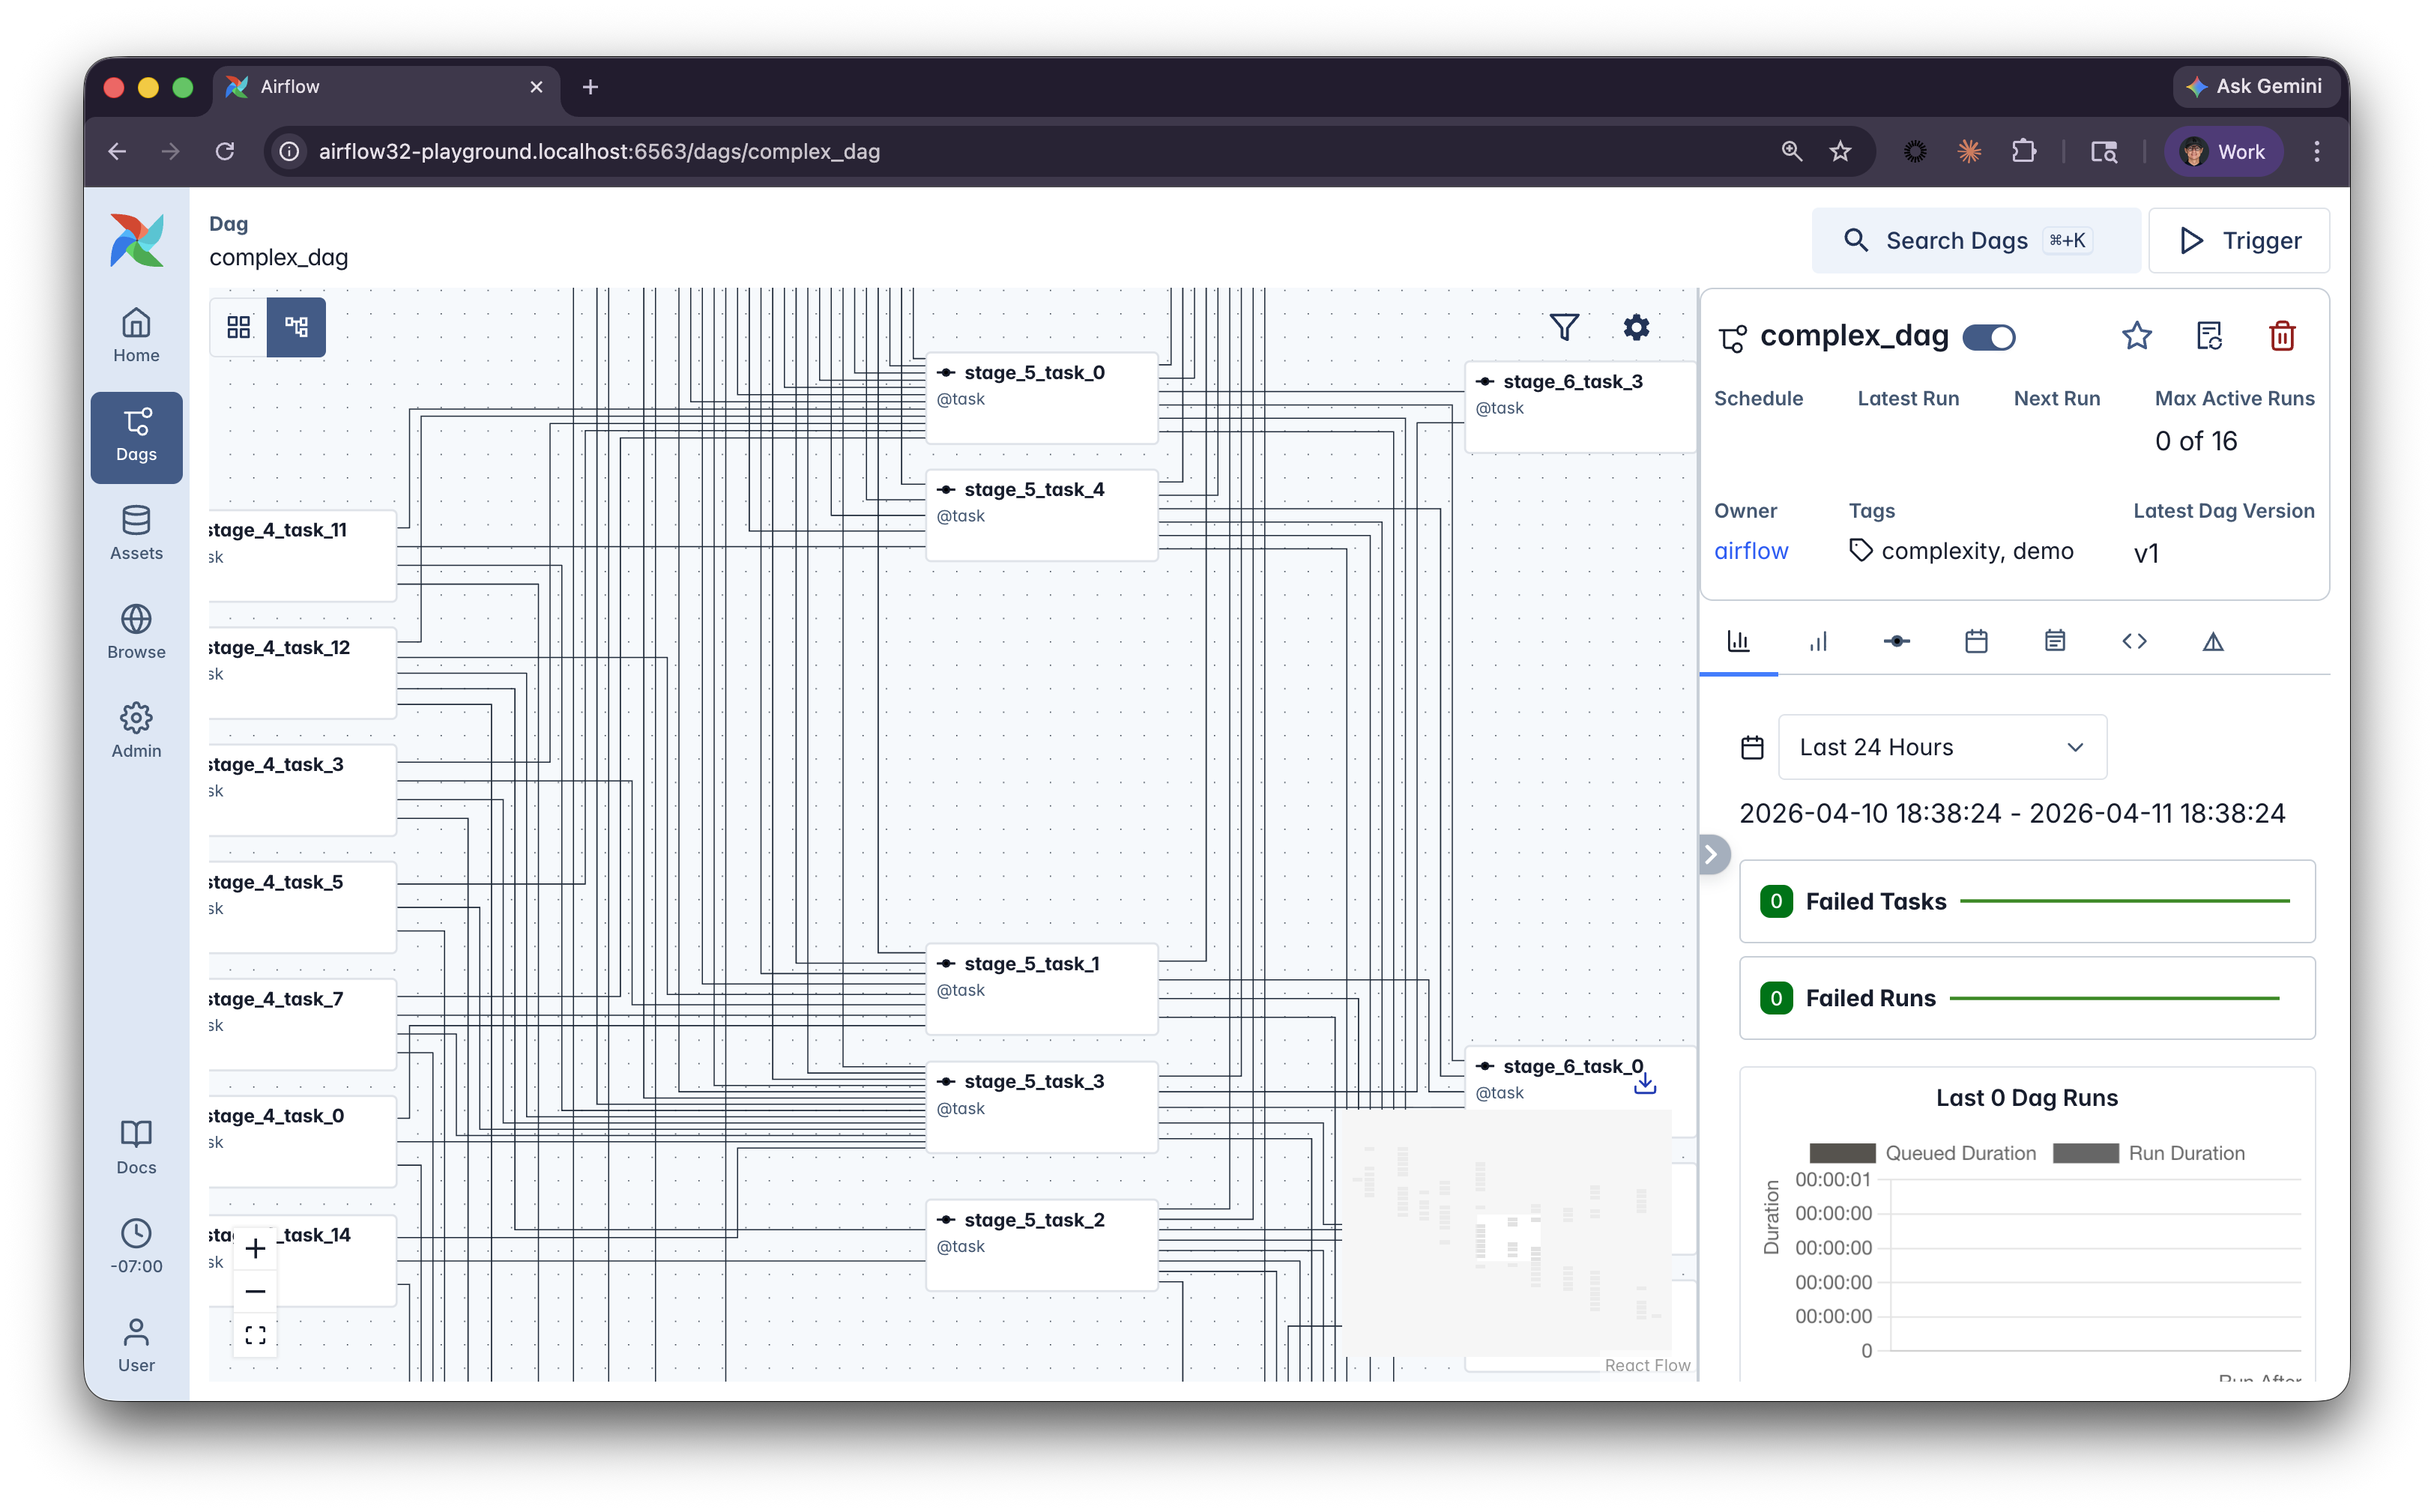
DAG complexe

  • Les DAG volumineux deviennent difficiles à parcourir dans la vue Graph
  • Les noms de tâches se confondent
  • Les nouvelles personnes peinent à repérer ce qui leur revient
Créer des pipelines de données avec Airflow

@task_group

from airflow.sdk import dag, task, task_group

@task_group(
    group_id="ingest_orders",
    default_args={"retries": 3},
)

def process_orders(): @task def extract_orders(): return [{"id": 1, "amount": 99.99}] @task def transform_orders(orders): return [{"id": o["id"], "total": o["amount"] * 1.08} for o in orders] return transform_orders(extract_orders())
  • group_id définit un identifiant personnalisé, par défaut le nom de la fonction
  • default_args s'applique à toutes les tâches du groupe pour éviter de répéter la configuration
  • Les groupes de tâches apparaissent comme des blocs repliables dans l'interface
Créer des pipelines de données avec Airflow

Aperçu dans l'interface Airflow

Sans groupes de tâches

Graphe simple montrant trois tâches alignées : extract_orders, transform_orders, load, toutes au même niveau

  • Toutes les tâches au même niveau

Avec des groupes de tâches
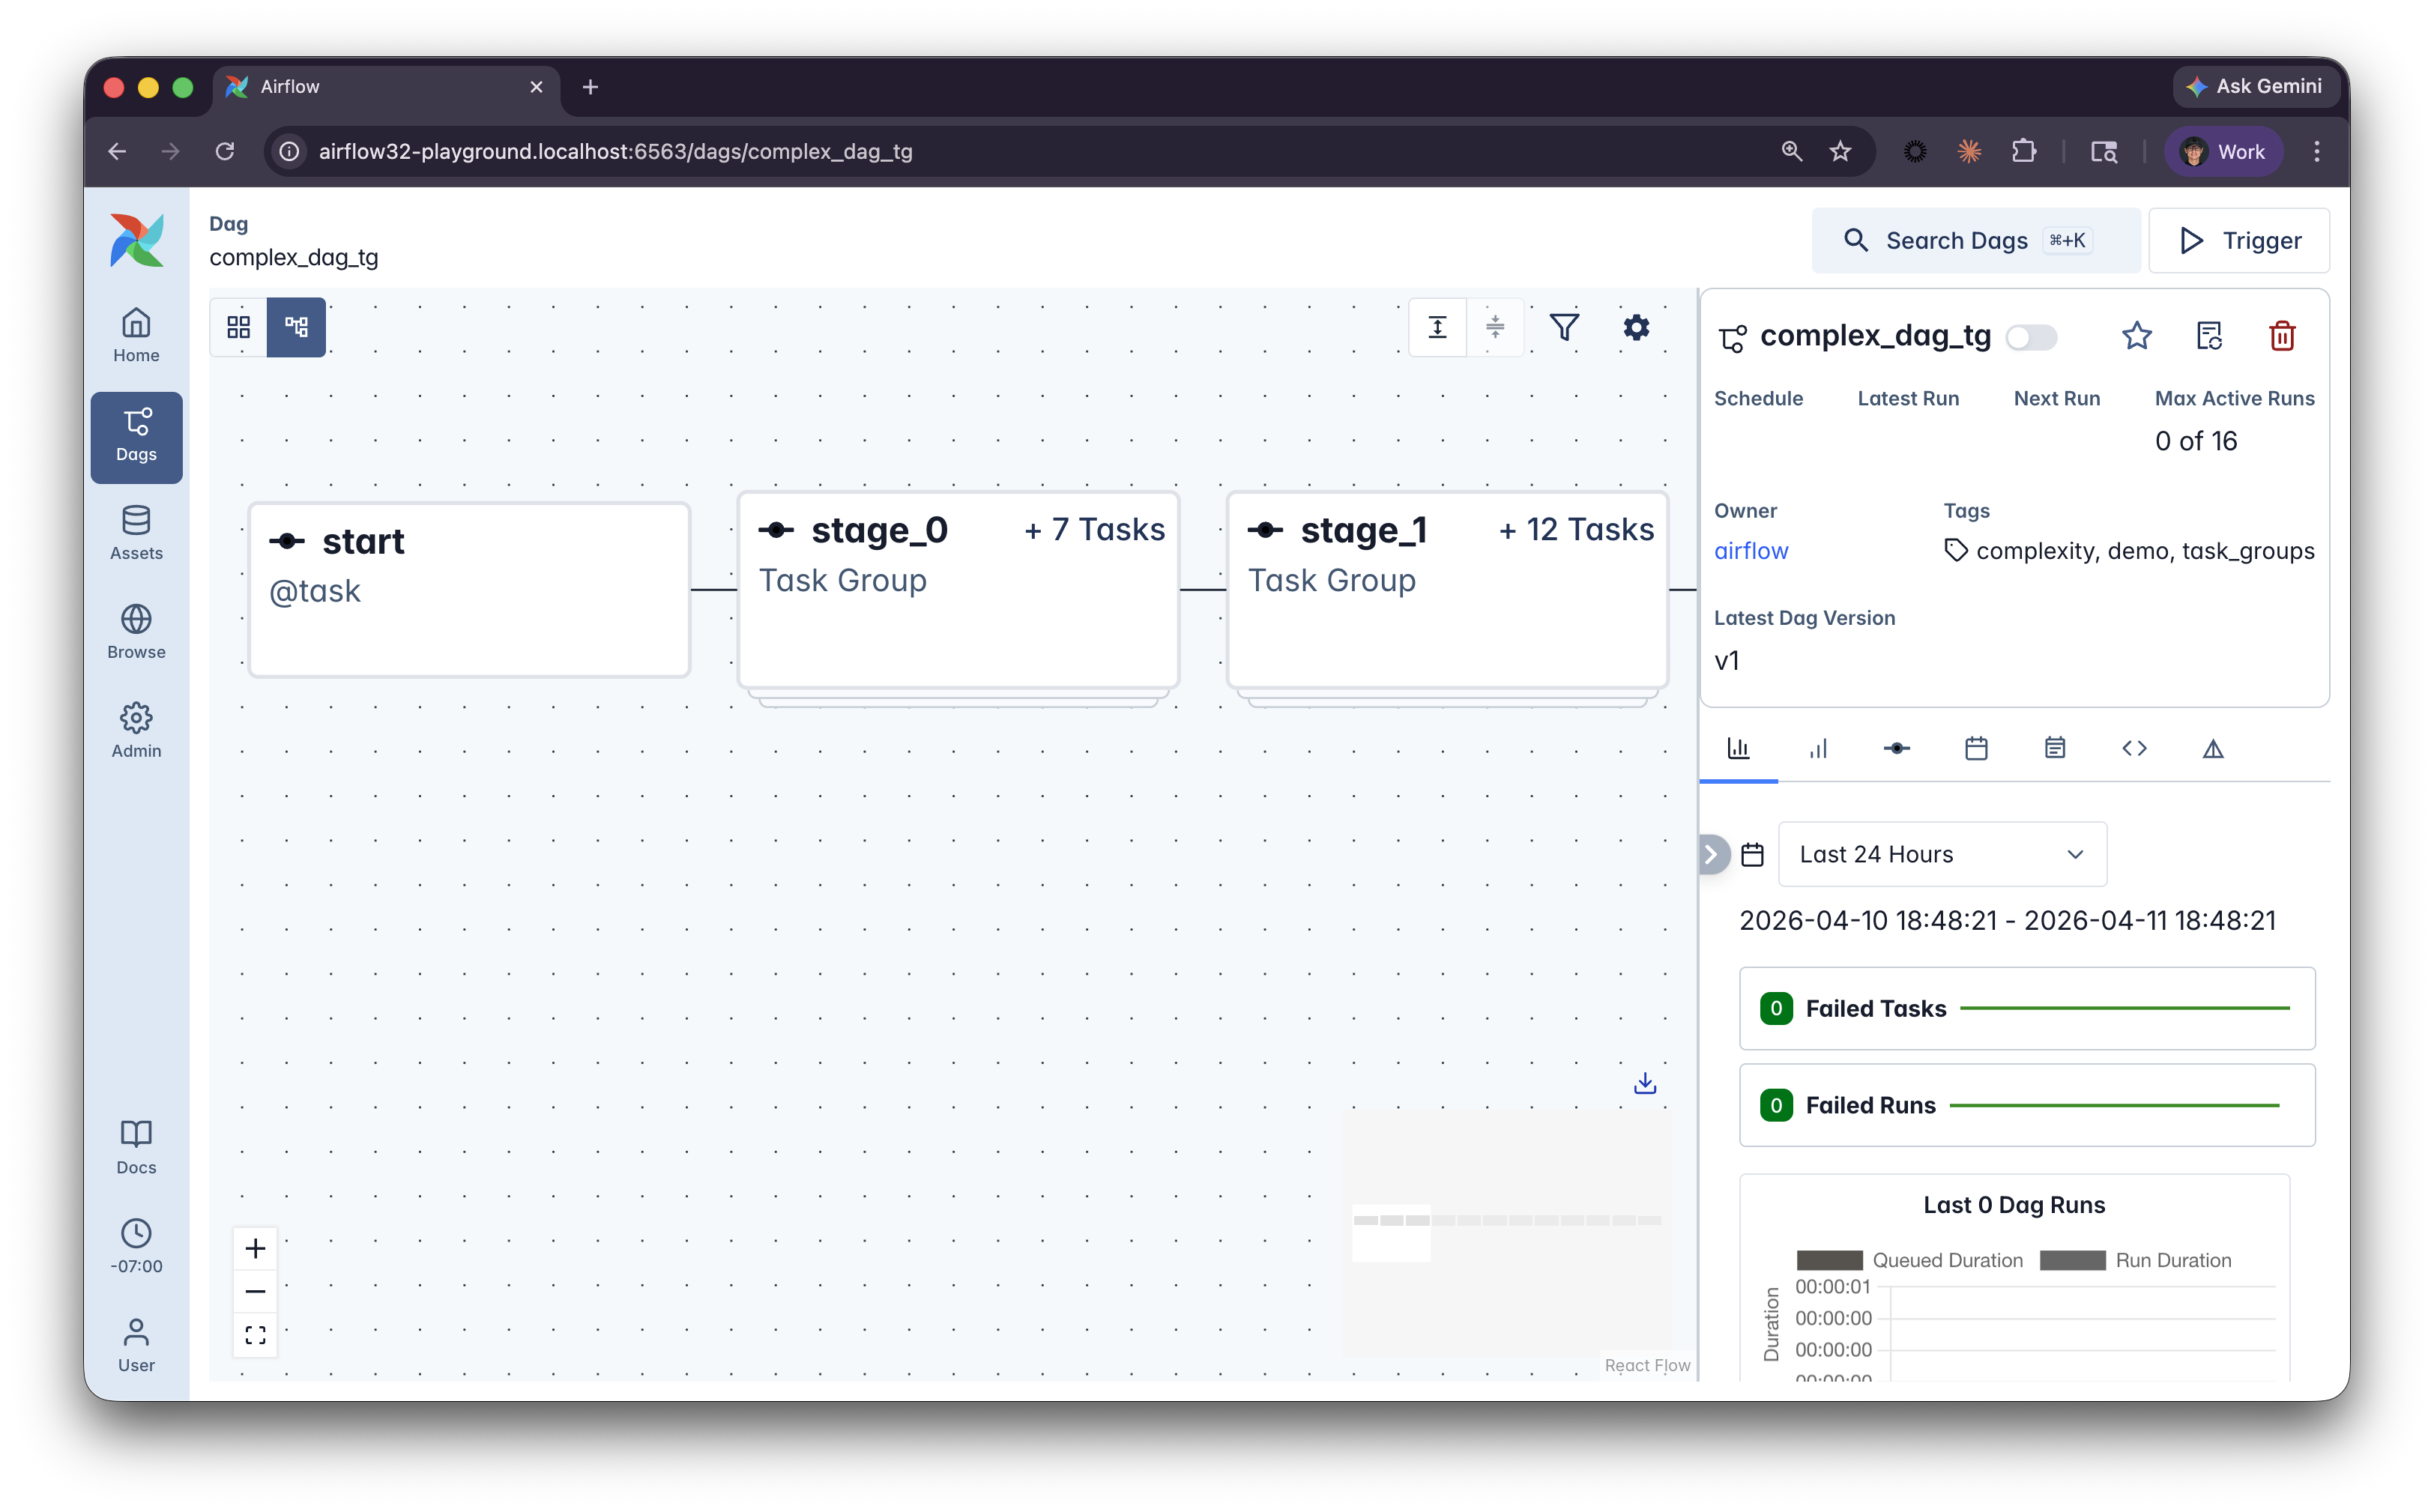
Graphe montrant un bloc replié nommé process_orders contenant extract et transform, suivi d'une tâche load hors du groupe

  • Blocs repliables dans l'interface
Créer des pipelines de données avec Airflow

Imbrication et noms d'affichage personnalisés

@task_group(group_display_name="Process All")
def process_all():

    @task_group(group_display_name="Ingest Orders")
    def orders():
        return transform(extract())

    @task_group(group_display_name="Process Returns")
    def returns():
        return transform(extract())

    return {
        "orders": orders(),
        "returns": returns(),
    }
  • Les groupes de tâches peuvent être imbriqués pour des canalisations plus complexes
  • group_display_name définit une étiquette lisible dans l'interface (même avec des émojis)
Créer des pipelines de données avec Airflow

Le patron de fabrique

@task_group
def process_source(source_name, source_path):

    @task
    def extract():
        return read_data(source_path)

    @task
    def transform(data):
        return clean_data(data)

    return transform(extract())

# Reuse the same pattern for different sources orders = process_source("orders", "/data/orders.csv") returns = process_source("returns", "/data/returns.csv") events = process_source("events", "/data/events.csv")
  • Les groupes de tâches sont des fonctions Python décorées
  • Vous pouvez les appeler plusieurs fois avec des paramètres différents
  • Ce patron de fabrique permet de réutiliser la logique de la canalisation
Créer des pipelines de données avec Airflow

Bonnes pratiques de regroupement

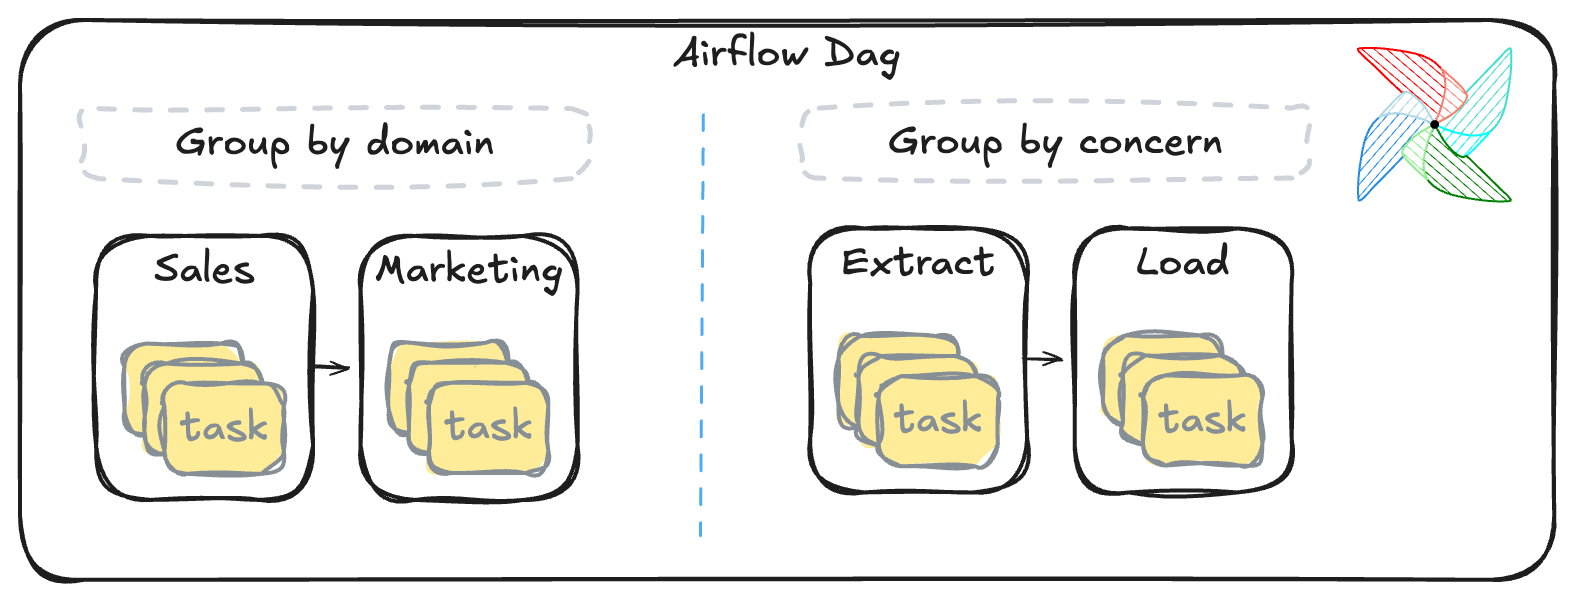
Grouper par domaine ou préoccupation

  • Grouper par domaine ou préoccupation, pas par type d'opérateur
  • Utiliser group_id pour des noms programmatiques clairs, group_display_name pour les étiquettes UI
  • Utiliser default_args pour partager des réglages comme les reprises dans tout le groupe
  • Appliquer la loi de Miller : plus de 7 éléments de premier niveau peut indiquer qu'un groupe de tâches est nécessaire
Créer des pipelines de données avec Airflow

Passons à la pratique !

Créer des pipelines de données avec Airflow

Preparing Video For Download...