Templates, idempotência e backfill

Criando Pipelines de Dados com Airflow

Volker Janz

Senior Developer Advocate at Astronomer

Templates Jinja no Airflow

@task.bash
def export_data():
    return "cp /data/sales.csv /export/sales_{{ ds }}.csv"


  • {{ ds }} gera a data lógica no formato YYYY-MM-DD
  • Cada execução tem sua data, então a mesma tarefa gera saídas diferentes por execução
  • Só funciona em campos com template (como bash_command, sql)
Criando Pipelines de Dados com Airflow

O problema da idempotência


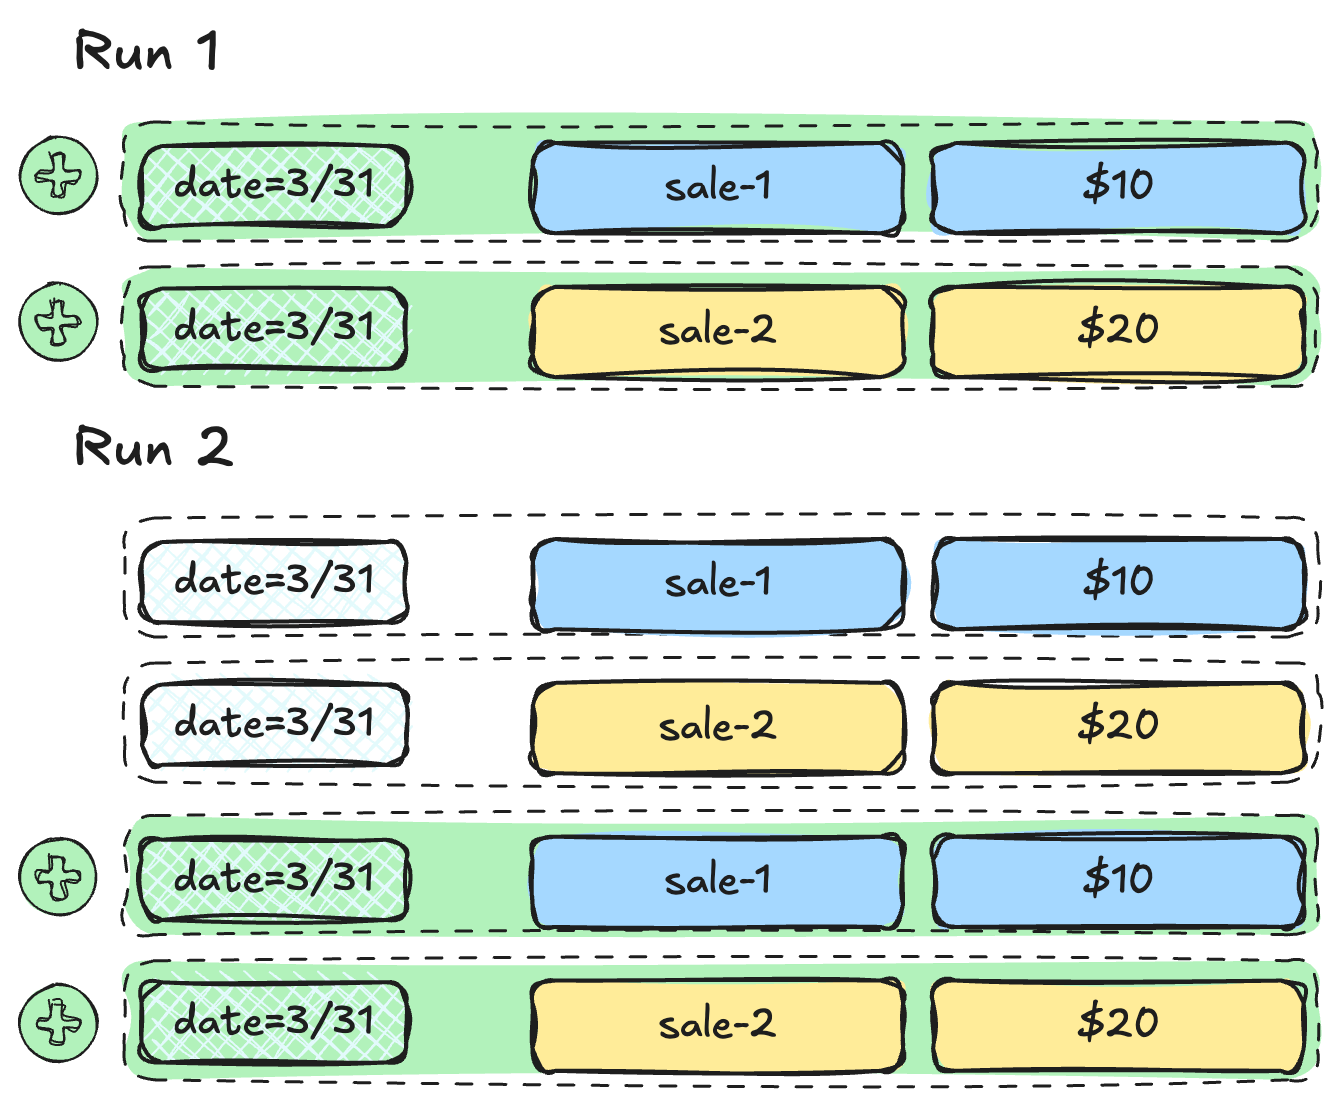
Execução 1 (31 de março):

  • INSERT das vendas de 31 de março
  • Resultado: 3 linhas

Execução 2 (reexecução de 31 de março):

  • INSERT das vendas de 31 de março de novo
  • Resultado: 6 linhas (duplicadas!)

Linhas duplicadas na reexecução

Criando Pipelines de Dados com Airflow

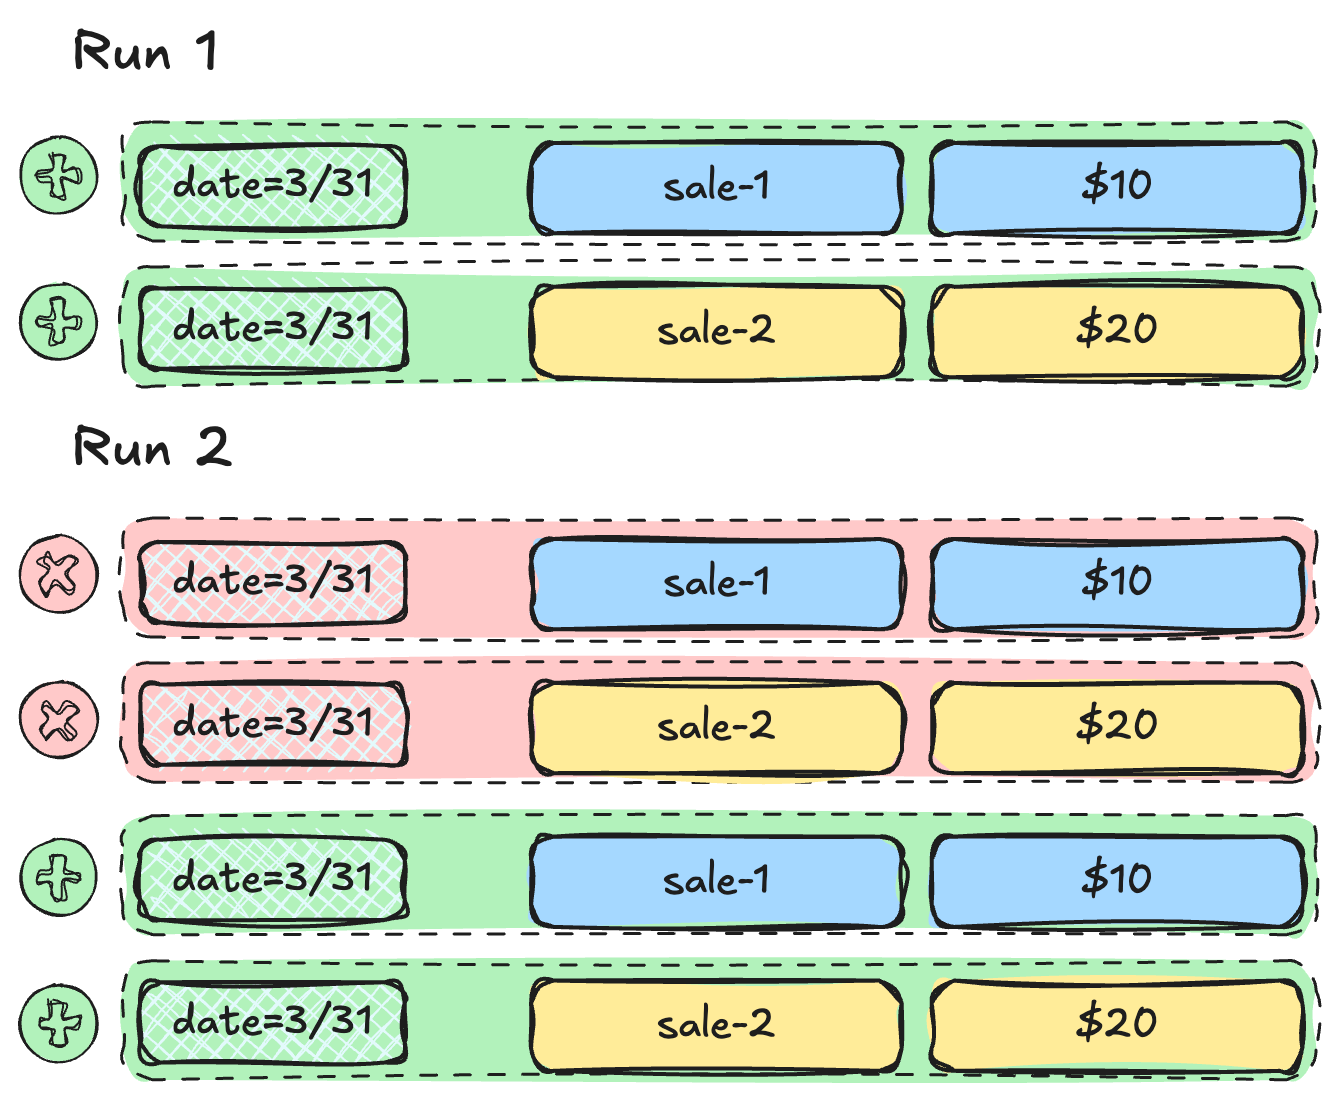
O padrão excluir-depois-inserir

staged_rows = SQLExecuteQueryOperator(
    task_id="get_staged_rows",
    conn_id="duckdb_default",
    sql="SELECT * FROM staging WHERE date = '{{ ds }}'",
)

load = SQLInsertRowsOperator( task_id="load_sales", conn_id="duckdb_default", table_name="sales", columns=["date", "product", "amount"], preoperator="DELETE FROM sales WHERE date = '{{ ds }}';", rows=staged_rows.output, )

$$

  • Também é possível usar UPSERT ou MERGE

Excluir e depois inserir

Criando Pipelines de Dados com Airflow

Backfill


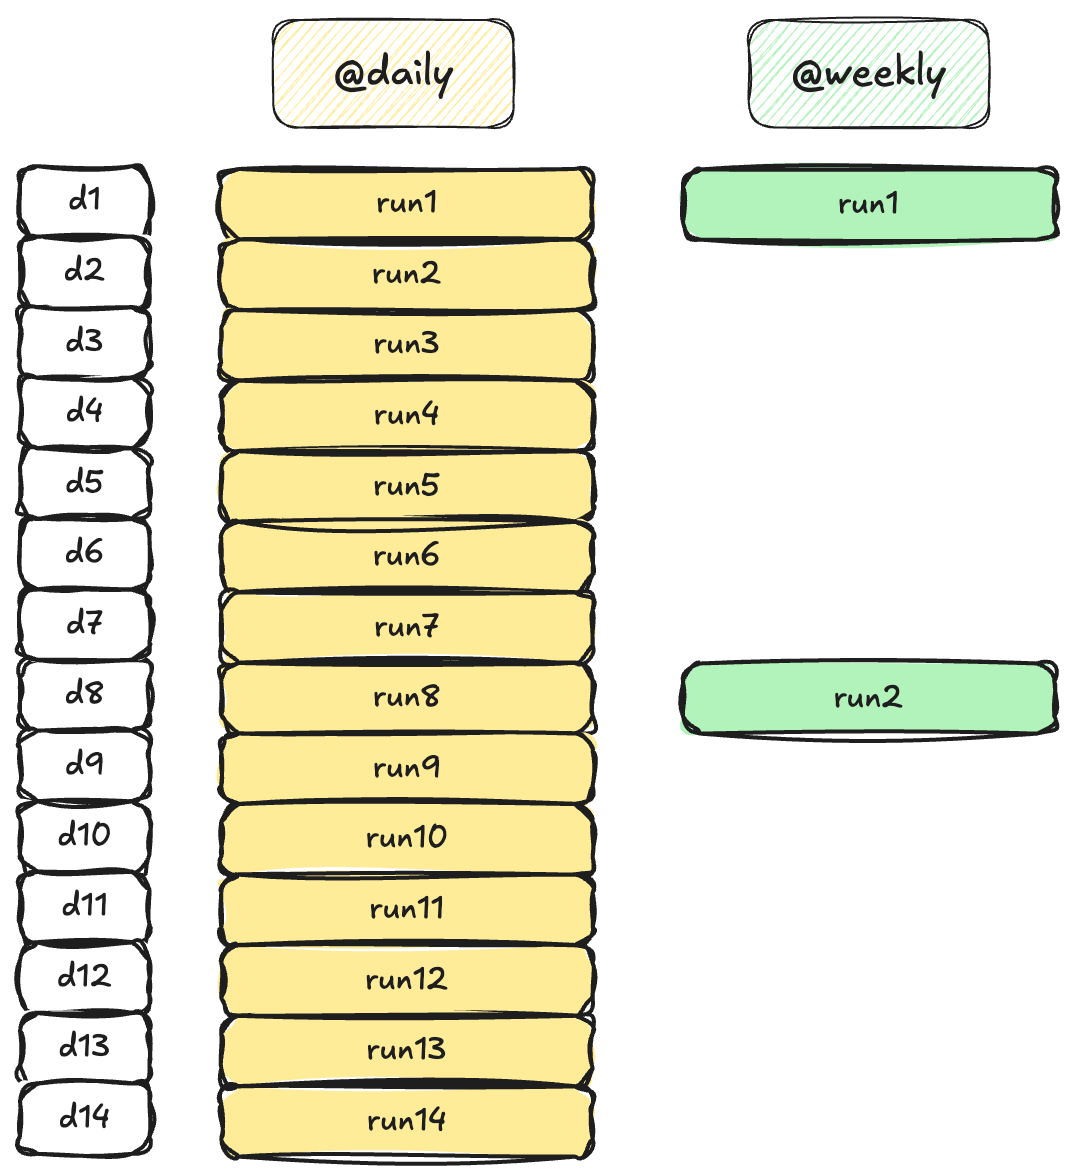
  • Reprocessar um intervalo de datas históricas
  • Airflow cria um run do Dag por data lógica
  • Com idempotência, o backfill é seguro

Backfill depende do agendamento

Criando Pipelines de Dados com Airflow

Backfill na interface

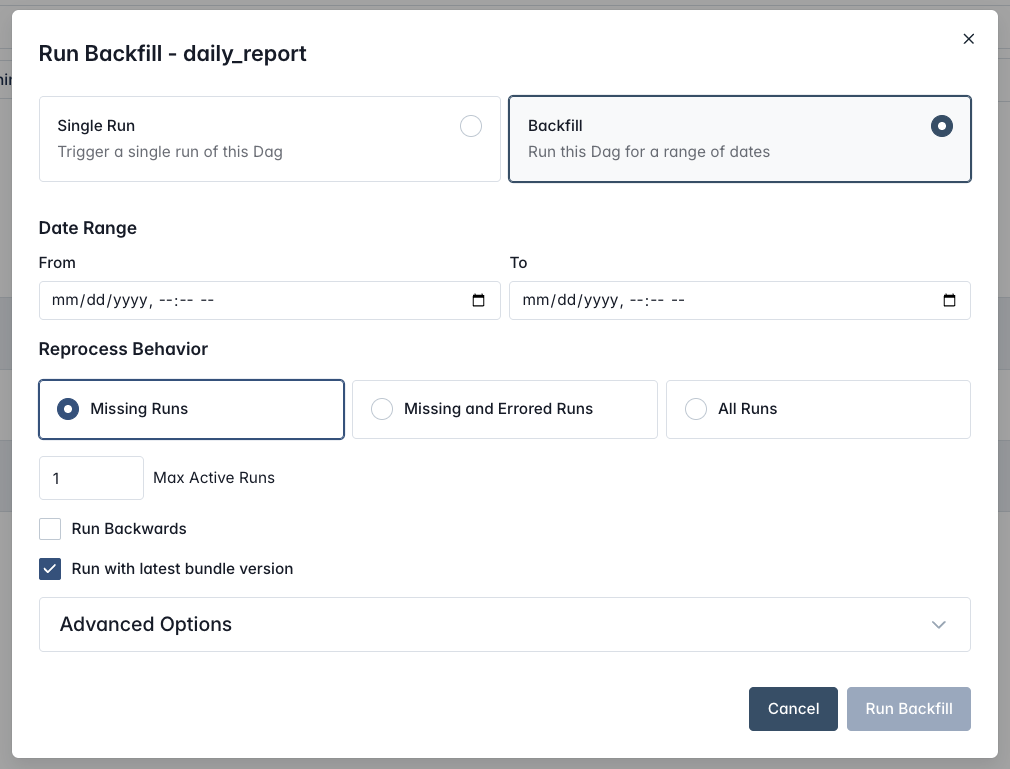
  • Dispare um Dag, selecione Backfill, defina as datas From e To
  • Dá para acionar Missing Runs, Missing and Errored Runs ou All Runs
  • Ajuste o paralelismo com Max Active Runs e mude a ordem de execução
  • Com Run Backfill, o processo inicia e os runs são criados

Interface de backfill do Airflow

Criando Pipelines de Dados com Airflow

Vamos praticar!

Criando Pipelines de Dados com Airflow

Preparing Video For Download...