Executando cargas de trabalho SQL

Criando Pipelines de Dados com Airflow

Volker Janz

Senior Developer Advocate at Astronomer

Por que SQL no Airflow?
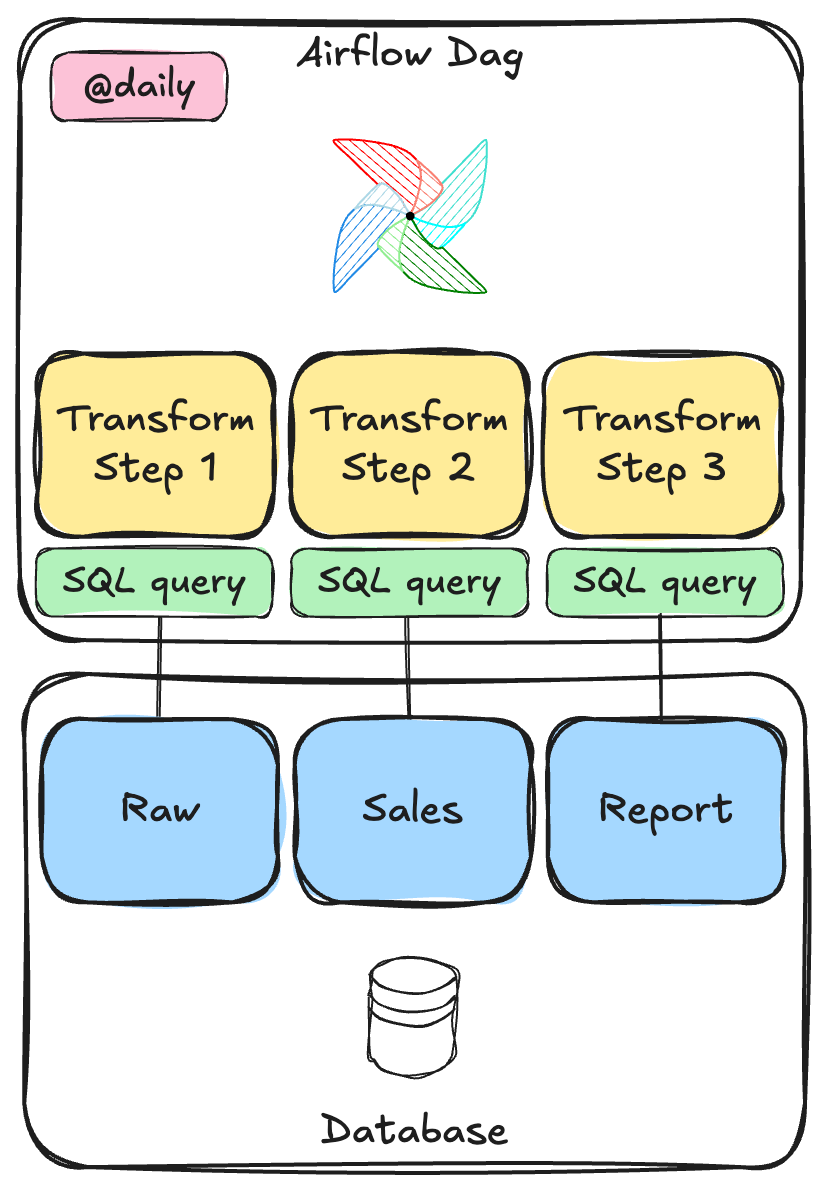
 

  • Cargas de trabalho em SQL são o caso de uso mais comum no Airflow
  • Deixe o banco de dados fazer o trabalho pesado
  • O Airflow orquestra quando e onde
  • O banco de dados cuida do como

Orquestração SQL no Airflow

Criando Pipelines de Dados com Airflow

SQLExecuteQueryOperator

from airflow.providers.common.sql.operators.sql import SQLExecuteQueryOperator

SQLExecuteQueryOperator( task_id="load_sales", conn_id="duckdb_analytics", sql="INSERT INTO sales SELECT * FROM staging", )


  • Funciona com qualquer banco que tenha um provider compatível no Airflow
  • PostgreSQL, Snowflake, BigQuery, DuckDB e mais
Criando Pipelines de Dados com Airflow

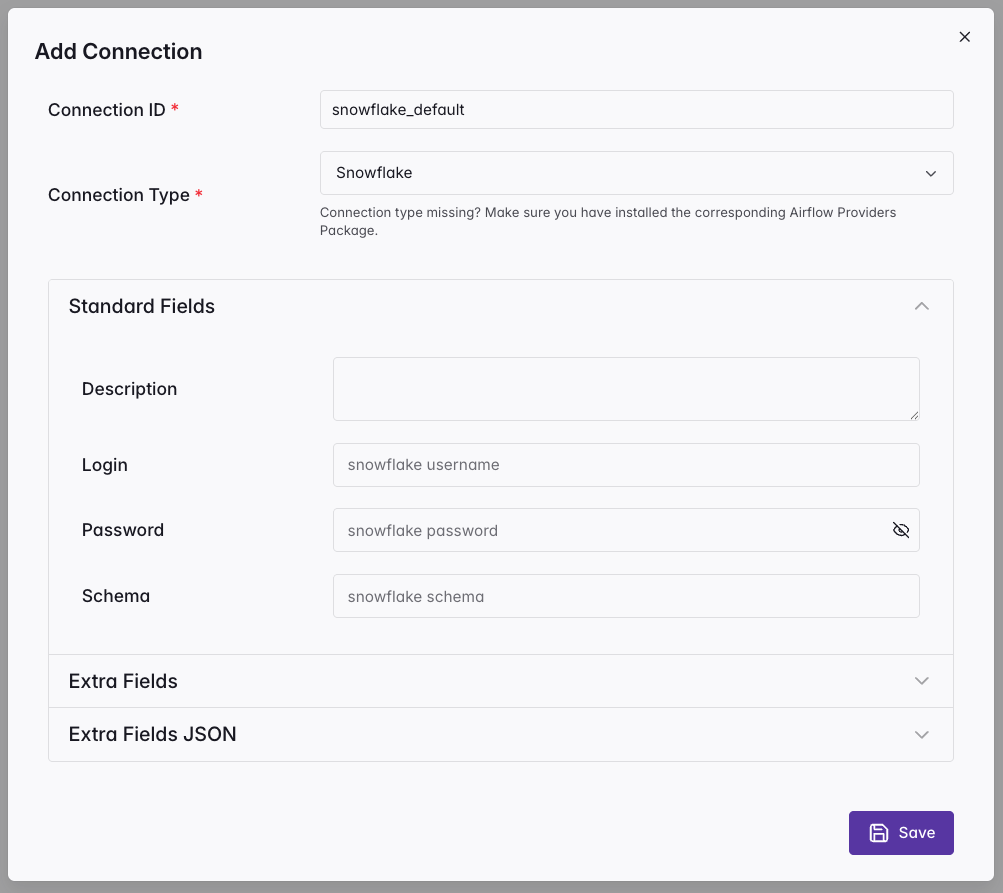
Connections

  • Guarde as credenciais fora do código
  • Cada uma tem ID, tipo, host, porta, login
  • Criadas de várias formas: UI, CLI, API ou variáveis de ambiente
  • Referencie pelo conn_id nos operadores

UI de Connections do Airflow

Criando Pipelines de Dados com Airflow

Construindo um pipeline SQL

from airflow.sdk import dag, task
from airflow.providers.common.sql.operators.sql import SQLExecuteQueryOperator

@dag(schedule="@daily")
def sales_pipeline():

    aggregate = SQLExecuteQueryOperator(
        task_id="aggregate_daily_sales",
        conn_id="duckdb_analytics",
        sql="""
            INSERT INTO daily_summary (order_date, total_orders, total_revenue)
            SELECT order_date, COUNT(*), SUM(revenue)
            FROM raw_orders GROUP BY order_date
        """,
    )
Criando Pipelines de Dados com Airflow

Arquivos SQL externos

@dag(
    schedule="@daily",
    template_searchpath="/path/to/include/sql",
)
def sales_pipeline():
    aggregate = SQLExecuteQueryOperator(
        task_id="aggregate_daily_sales",
        conn_id="duckdb_analytics",
        sql="aggregate_sales.sql",
    )
  • Defina template_searchpath no @dag
  • Referencie o nome do arquivo em sql
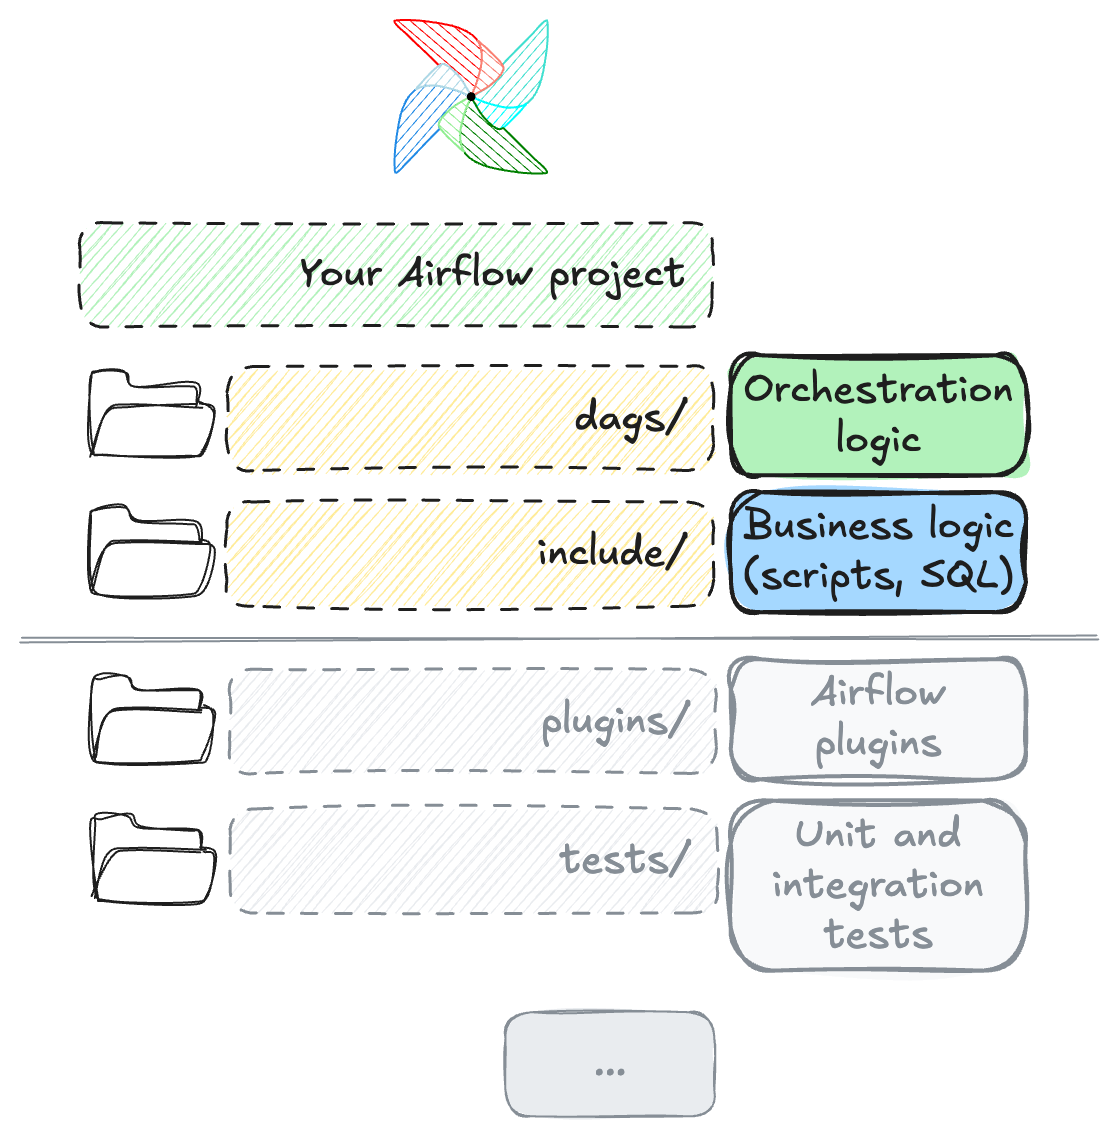
  • Mantenha scripts e lógica de negócio fora da pasta dags/ 💡

Estrutura de arquivos do projeto

Criando Pipelines de Dados com Airflow

Templates Jinja em arquivos SQL

DELETE FROM daily_summary WHERE order_date = '{{ ds }}';

INSERT INTO daily_summary (order_date, total_orders, total_revenue)
SELECT order_date, COUNT(*), SUM(revenue)
FROM raw_orders
WHERE order_date = '{{ ds }}'
GROUP BY order_date;


  • {{ ds }} gera a data lógica (YYYY-MM-DD)
  • DELETE depois INSERT: o padrão idempotente do Capítulo 2
  • Reexecutar a mesma data produz o mesmo resultado
Criando Pipelines de Dados com Airflow

params vs parameters

params (renderização Jinja)

SQLExecuteQueryOperator(
    sql="""SELECT * FROM orders
           WHERE product = '{{ params.product }}'""",
    params={"product": user_input},
)
  • Valor interpolado na string SQL
  • Vulnerável a injeção de SQL

parameters (binding no nível do BD)

SQLExecuteQueryOperator(
    sql="SELECT * FROM orders
         WHERE product = $product",
    parameters={"product": user_input},
)
  • Valor passado para o driver do banco
  • Seguro contra injeção: o driver faz o escaping
Criando Pipelines de Dados com Airflow

Do local à produção com Astro

$$

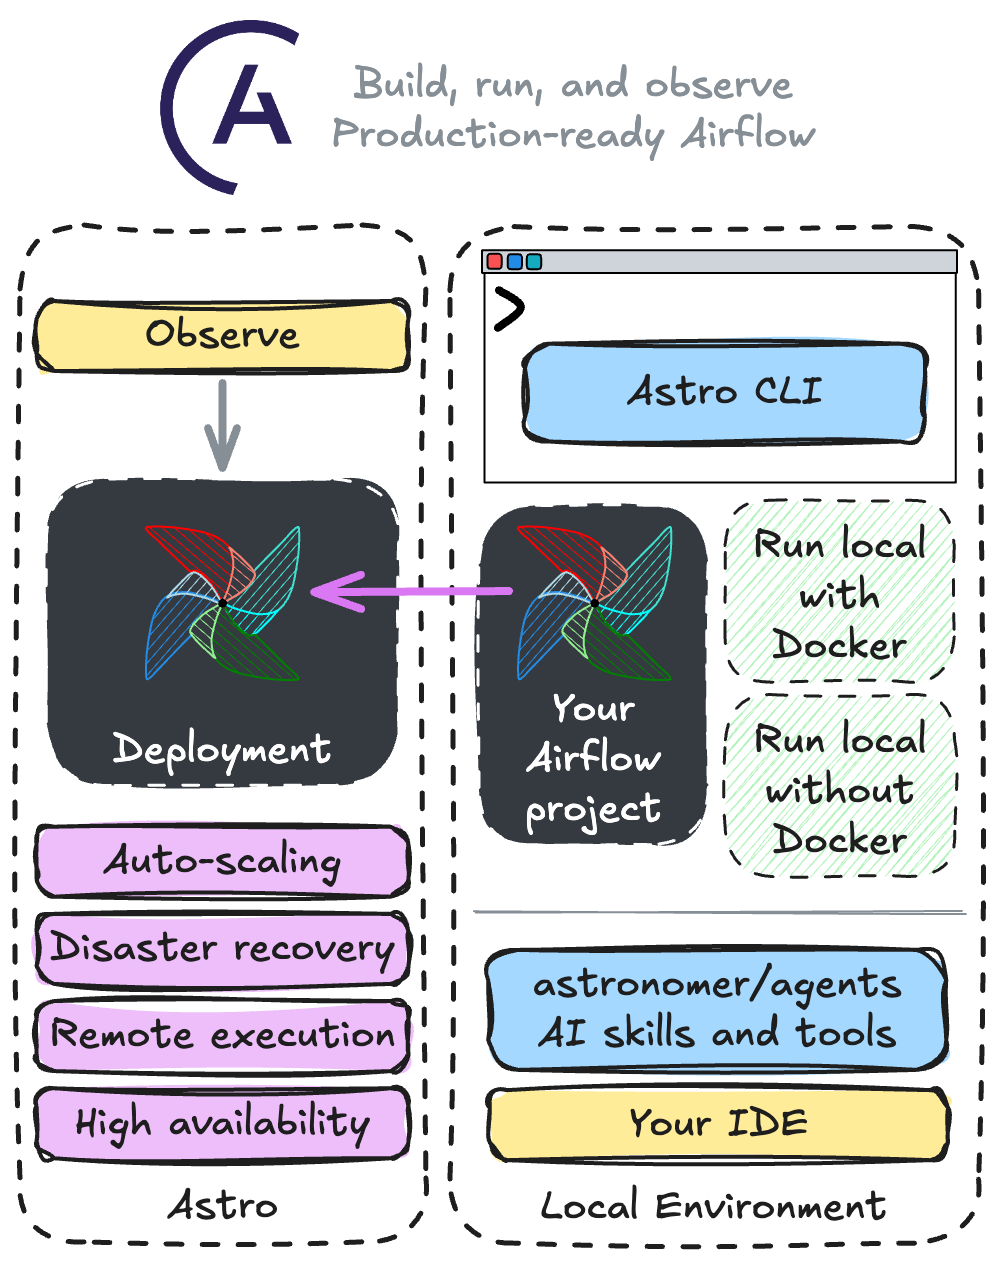
  • Astronomer's Astro: plataforma gerenciada de Airflow

$$

  • Astro CLI: Airflow local com um comando

$$

  • Desenvolva localmente e faça deploy em produção sem atrito

Astro CLI e plataforma

Criando Pipelines de Dados com Airflow

Vamos praticar!

Criando Pipelines de Dados com Airflow

Preparing Video For Download...