การประสานงานบริการและการจัดการสถานะ
การพัฒนาแอปพลิเคชันบน AWS
Ricardo Sueiras
Principal Technologist
การประสานงานบริการ
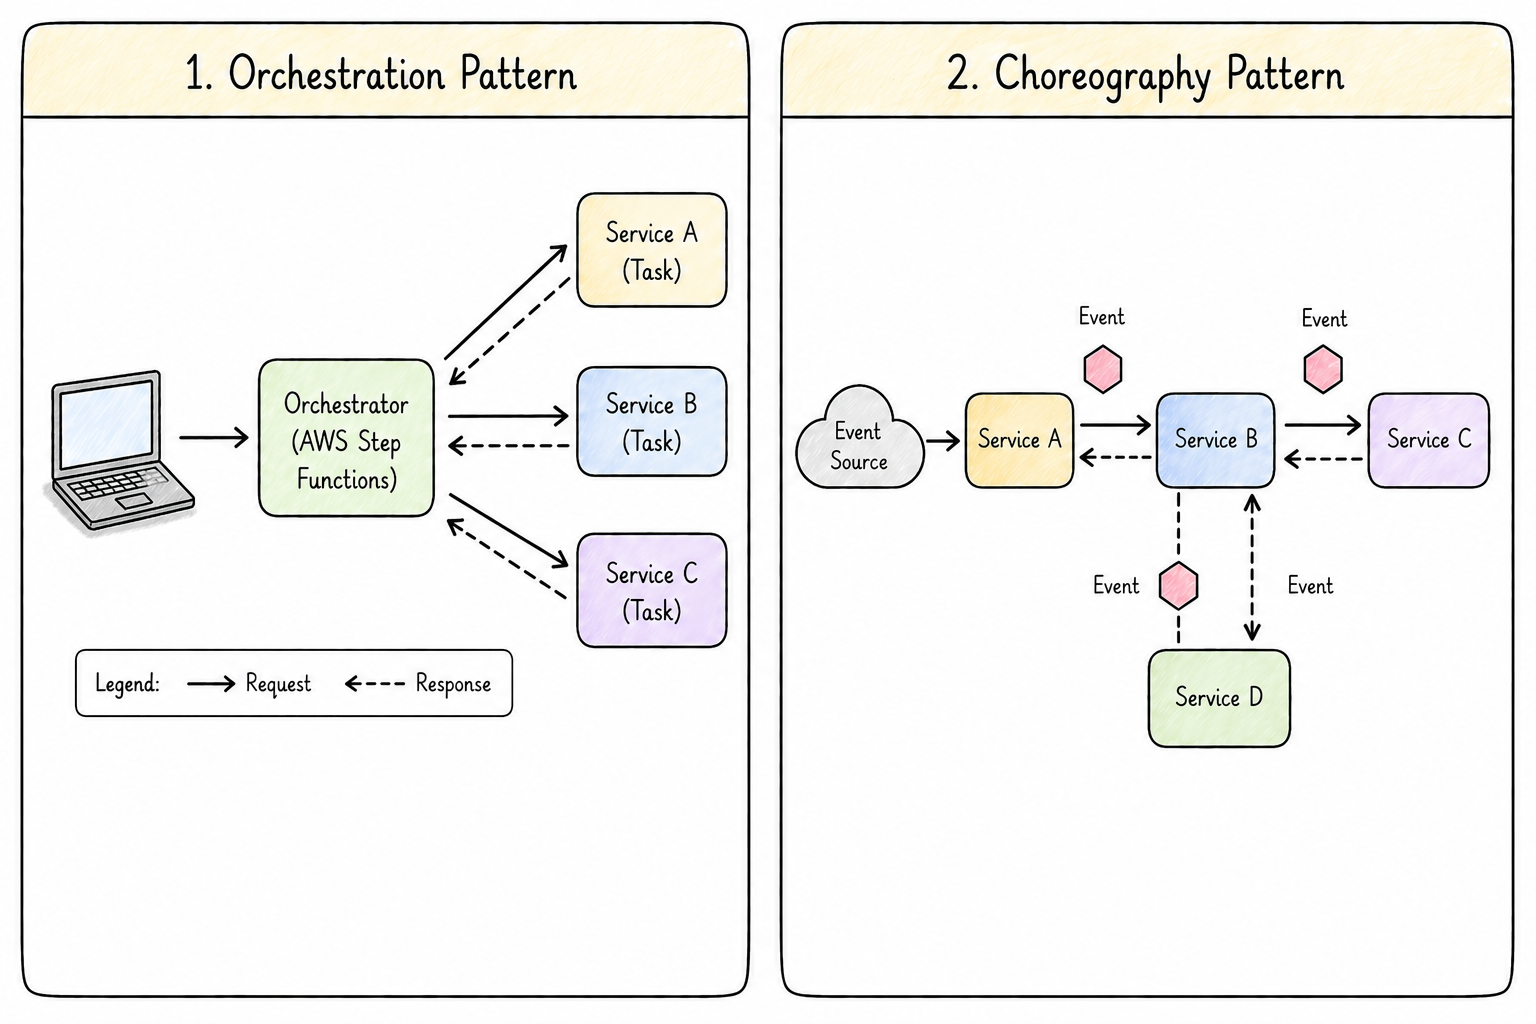
บริการหลายส่วนต้องทำงานร่วมกันเพื่อให้ workflow สำเร็จ
จำเป็นต้องมีกลยุทธ์การประสานงาน
มี 2 แนวทาง: orchestration และ choreography
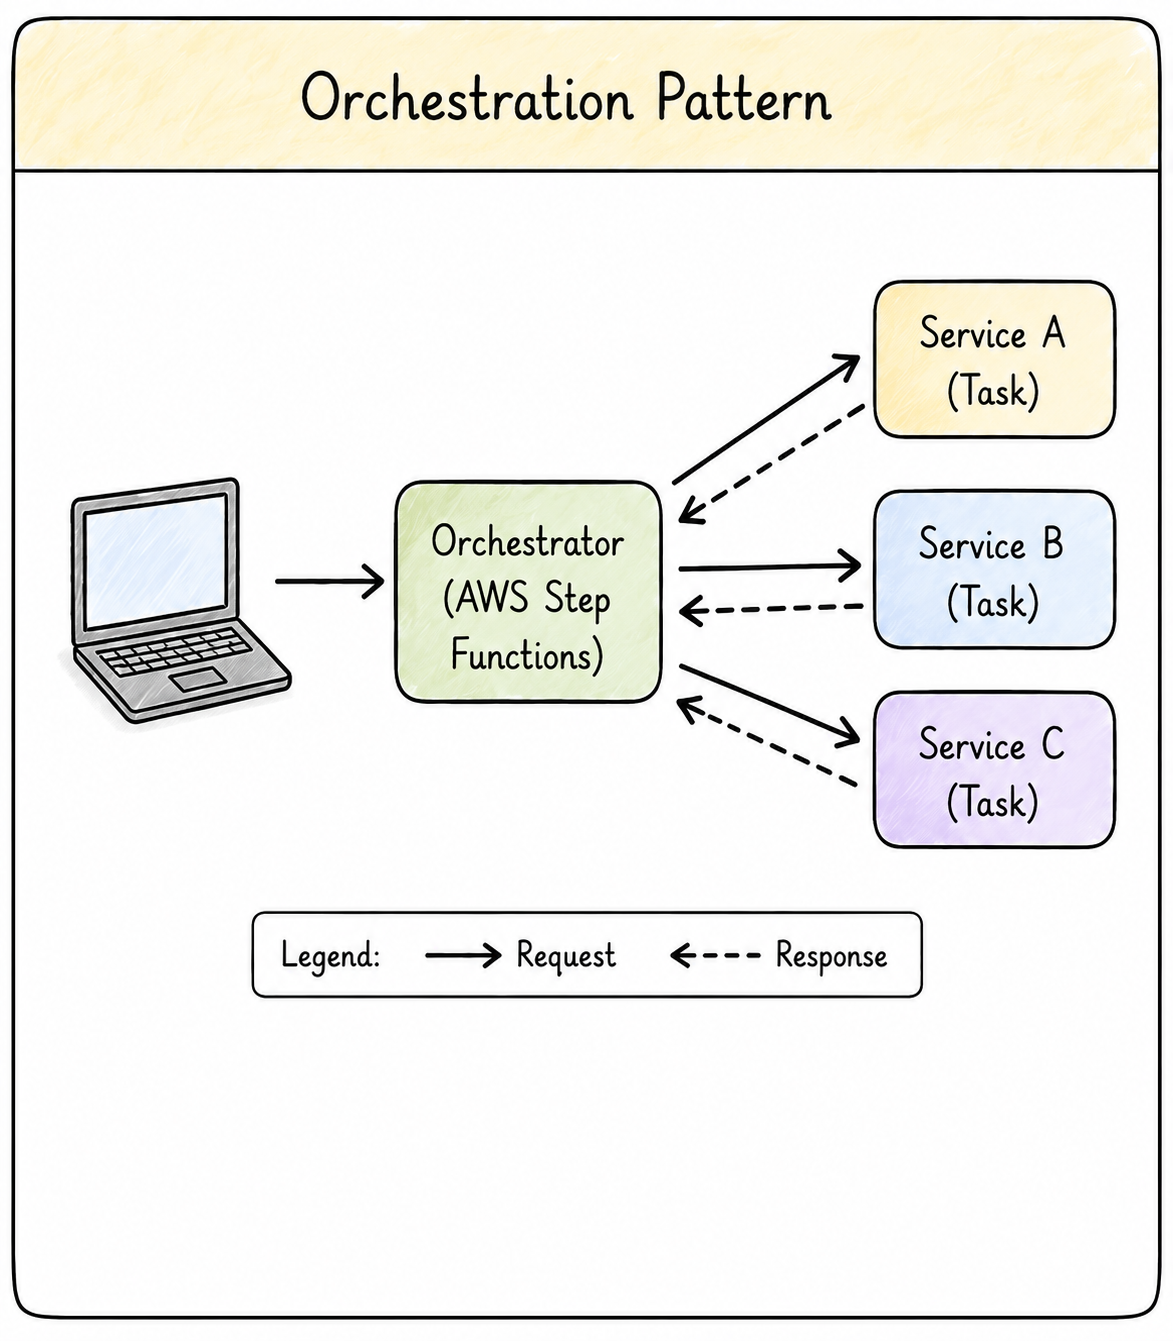
Orchestration
orchestrator ส่วนกลางทำหน้าที่ประสาน workflow
ควบคุมลำดับและตัดสินใจว่าบริการใดจะทำงานถัดไป
เหมาะสำหรับการ retry, conditional logic และการจัดการข้อผิดพลาด
บน AWS: ใช้ Step Functions ร่วมกับ Lambda, ECS, DynamoDB
Orchestration
logic ของ workflow อยู่ที่เดียว ทำให้ debug และ monitor ได้ง่ายขึ้น
ข้อแลกเปลี่ยน: เกิด dependency ที่จุดศูนย์กลาง
Choreography
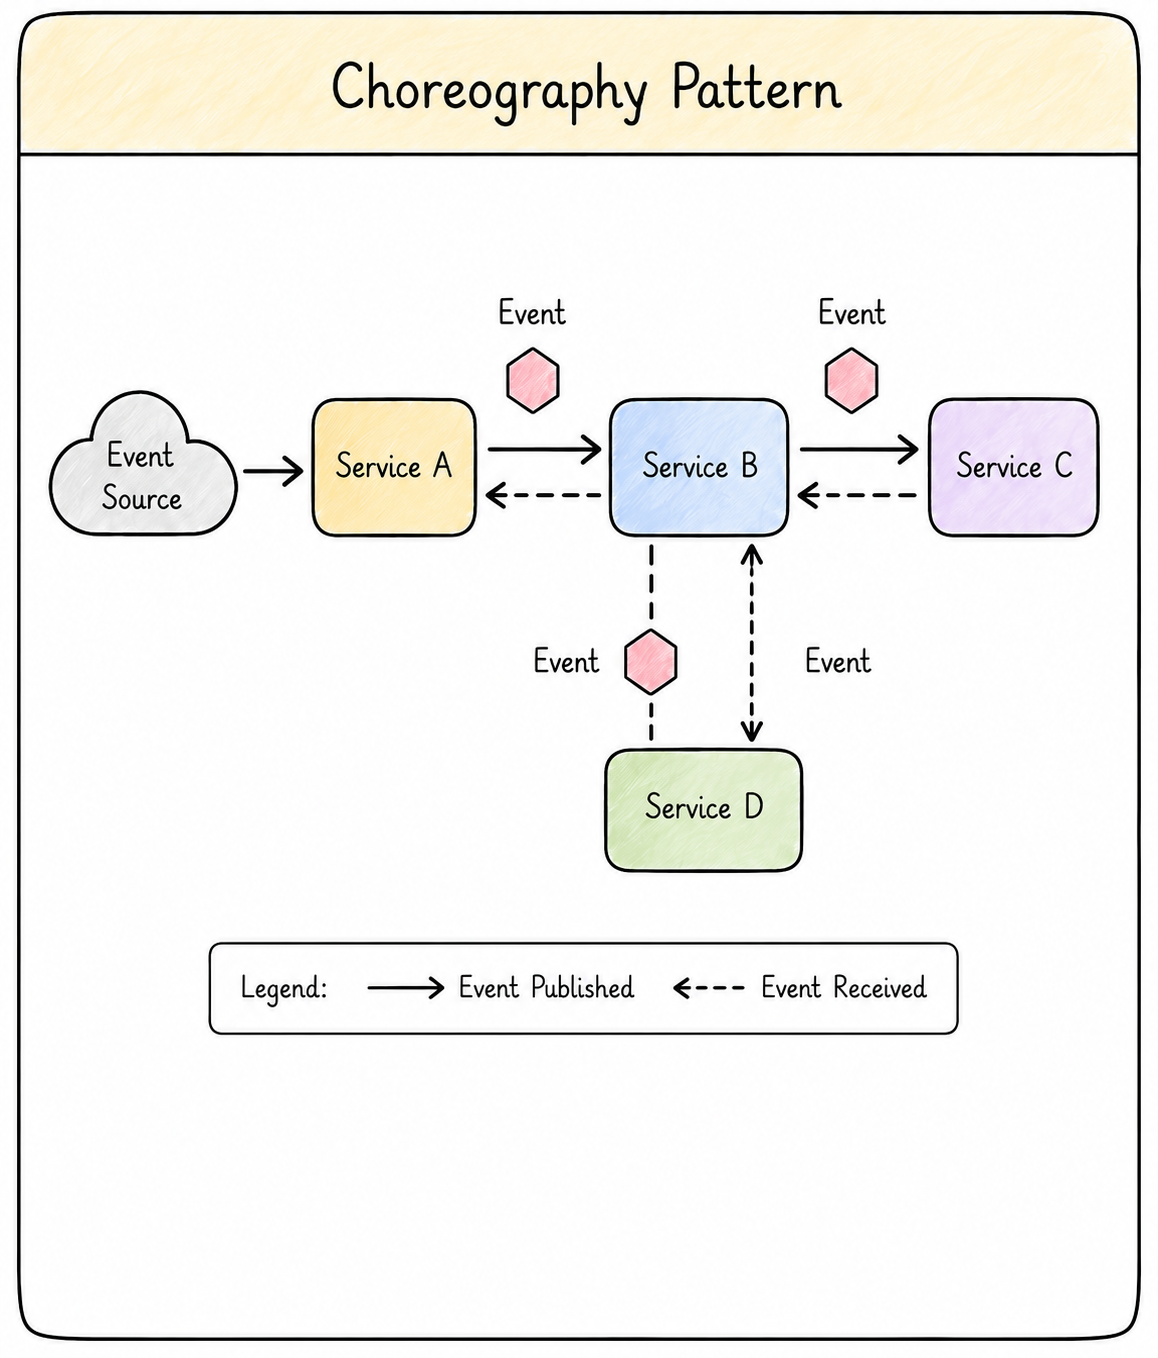
ไม่มี controller ส่วนกลาง
แต่ละบริการตอบสนองต่อ event อย่างอิสระ
แต่ละบริการรับฟัง event ที่เกี่ยวข้องและดำเนินงานของตัวเอง
ไม่จำเป็นต้องรู้ workflow ทั้งหมด
เพิ่ม loose coupling และ scalability
Choreography
บน AWS: EventBridge, SNS, SQS
รองรับการขยายระบบได้สูง
ข้อแลกเปลี่ยน: ยิ่ง workflow ซับซ้อน ยิ่ง debug ยาก
Event-driven architecture
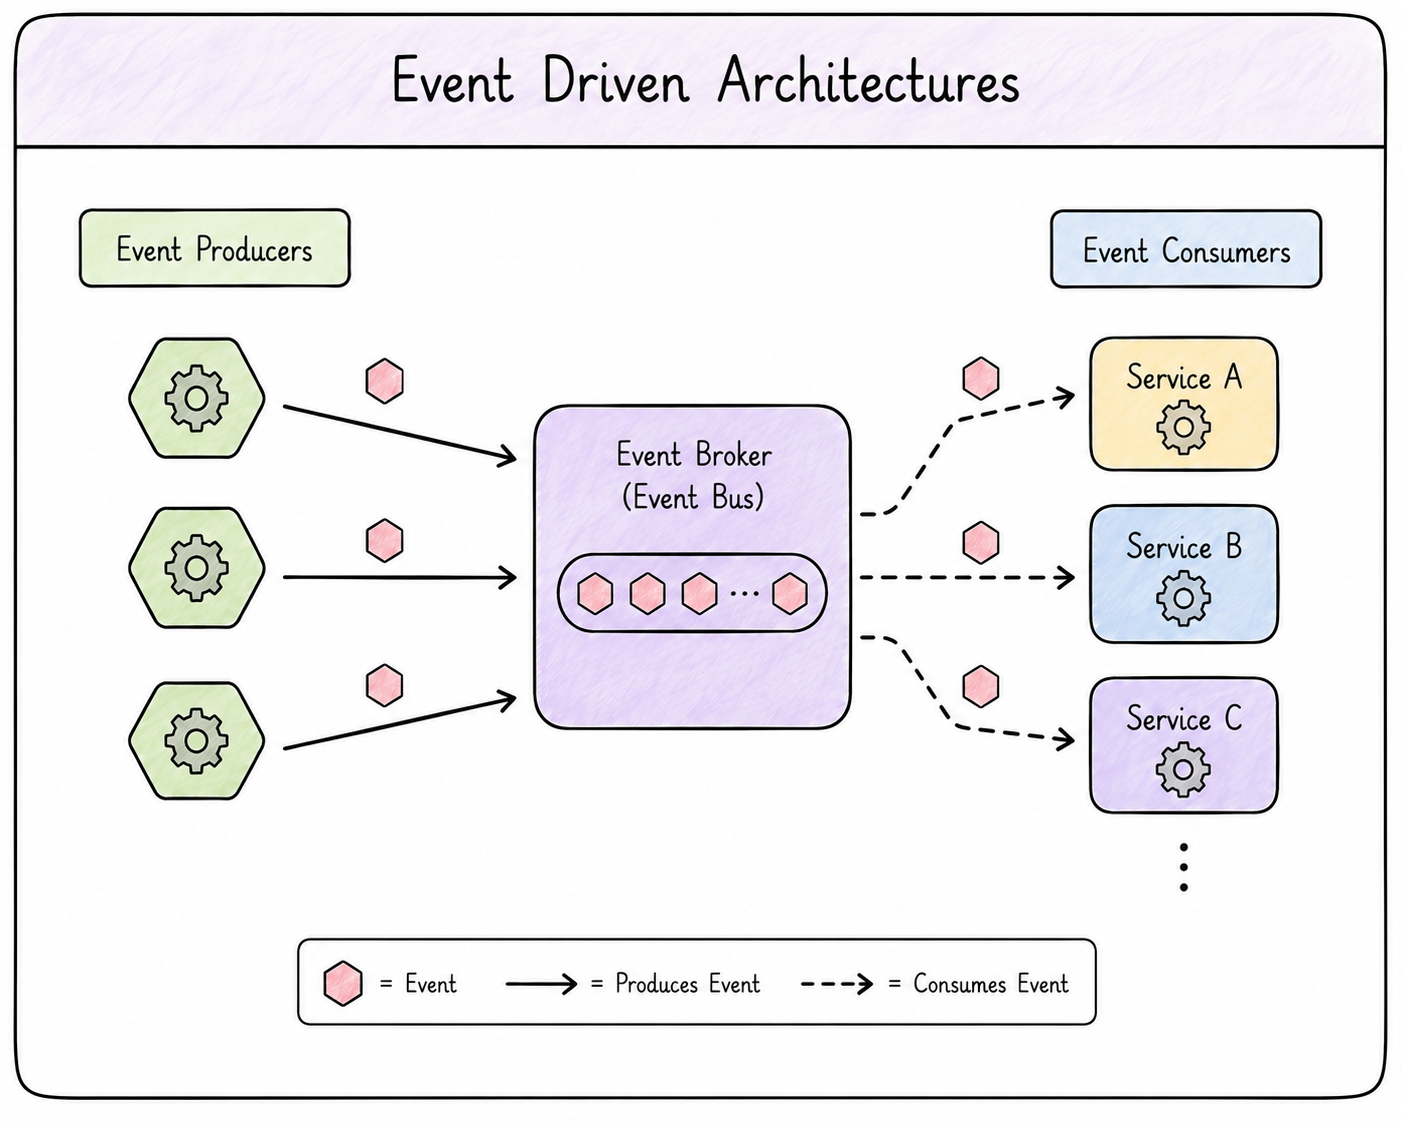
บริการสื่อสารกันโดยการสร้างและรับ event
ส่งเสริม loose coupling ระหว่างบริการ
รองรับ scalability สูง
ประมวลผล event แบบ parallel ได้
เพิ่มบริการใหม่ได้โดยไม่ต้องแก้ไขบริการเดิม
Event-driven architecture
ข้อแลกเปลี่ยนของการใช้ EDA:
ออกแบบให้รองรับ eventual consistency
ใช้หลักการ idempotency
การจัดการความล้มเหลวซับซ้อนกว่า
Idempotency
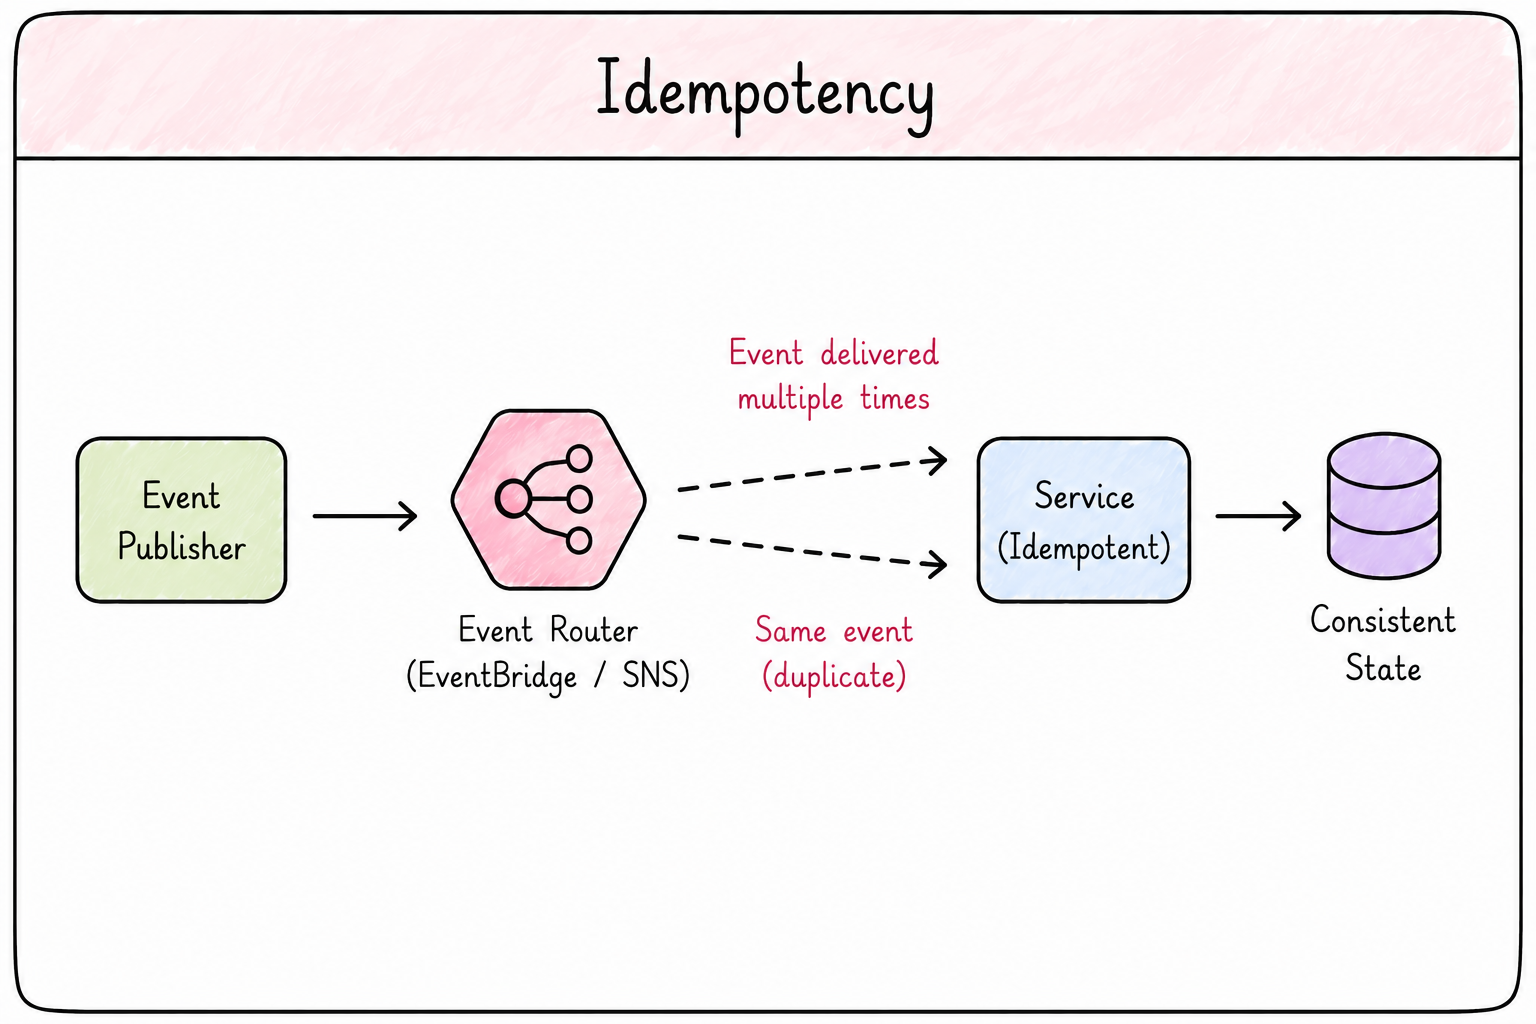
รันการดำเนินการเดิมกี่ครั้งก็ได้ผลลัพธ์เหมือนกันเสมอ
หลักการออกแบบสำคัญในระบบ async และ event-driven
ระบบกระจาย (distributed) อาจส่ง event ซ้ำได้จากการ retry, ความล้มเหลวของเครือข่าย หรือการประมวลผลซ้ำ
ช่วยรักษาความถูกต้องและความน่าเชื่อถือของระบบ
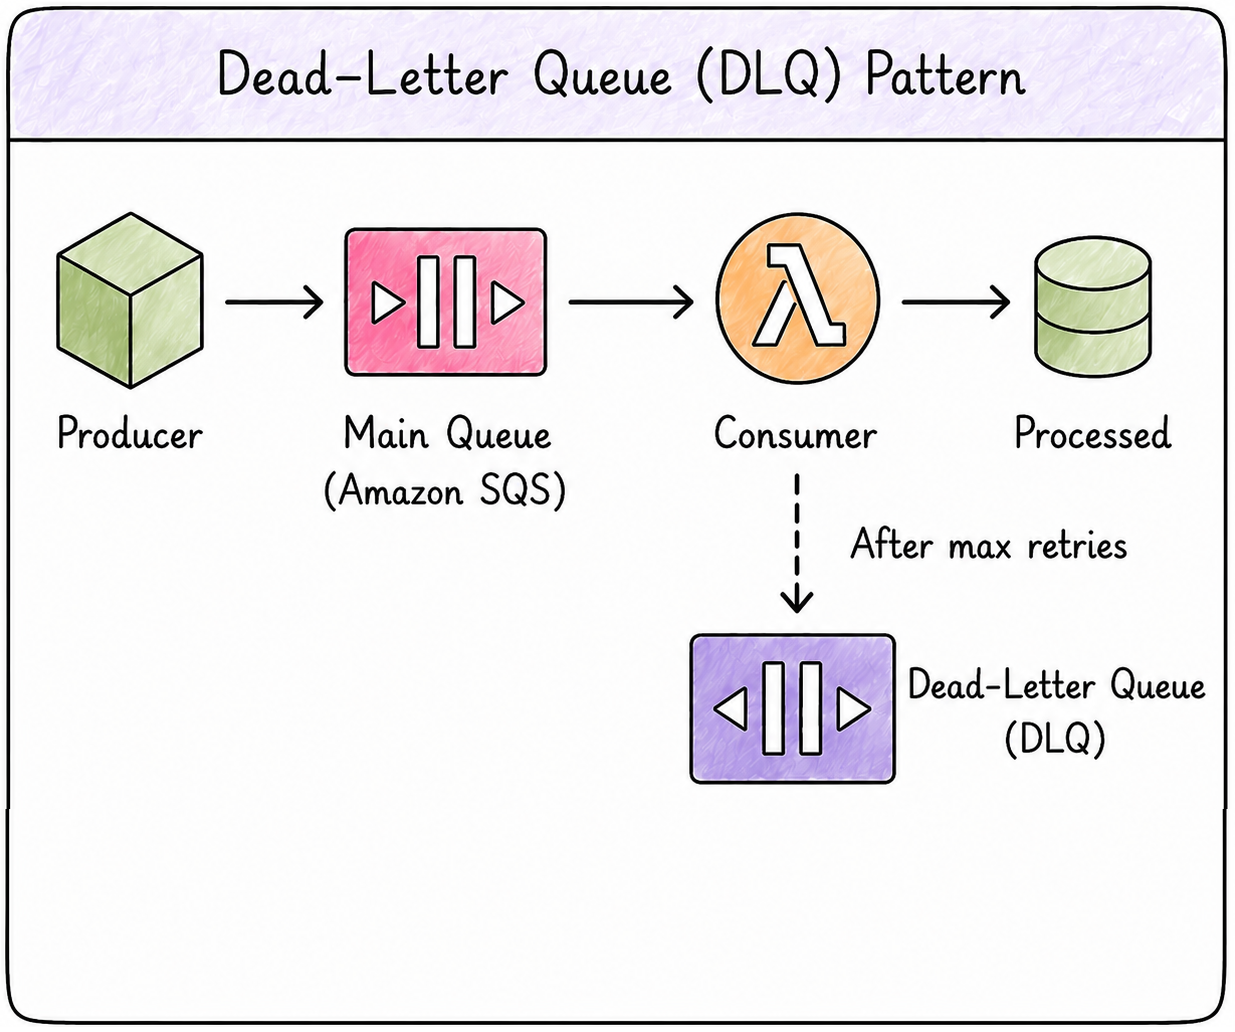
Dead letter queues
จัดการความล้มเหลวในการสื่อสารแบบ asynchronous
แยก message ที่มีปัญหา ("poison" message) ออก
เมื่อ retry ซ้ำแล้วยังล้มเหลว message จะถูกย้ายไปยัง DLQ
กระบวนการประมวลผลหลักทำงานต่อได้ตามปกติ
Dead letter queues
ใช้เมื่อลำดับของ message ไม่สำคัญ
ข้ามได้สำหรับระบบที่ไม่ critical และยอมรับการสูญหายของข้อมูลได้
หลีกเลี่ยงเมื่อต้องรักษาลำดับของ message
การจัดการสถานะ
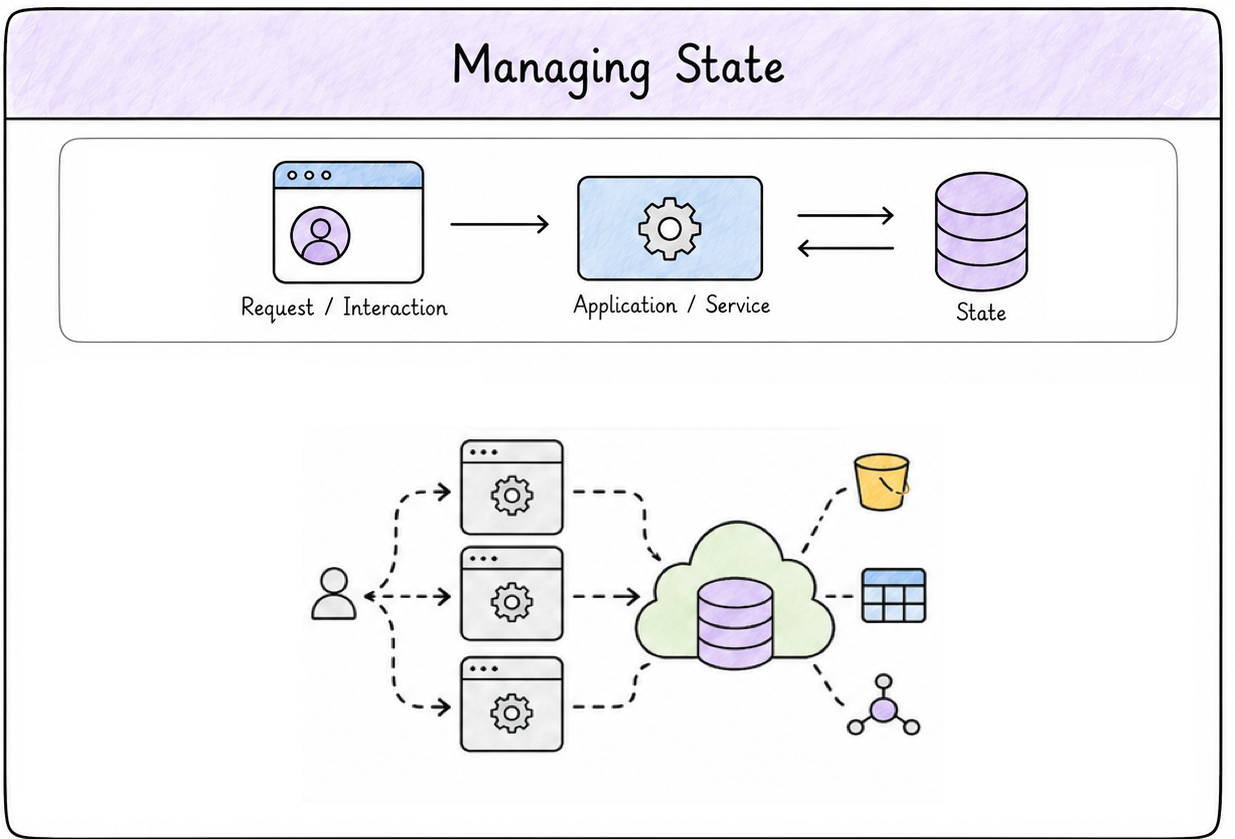
การจัดการสถานะเป็นพื้นฐานของแอป cloud-native
สถานะ คือข้อมูลที่เก็บไว้ระหว่าง interaction
การเก็บสถานะไว้บน server ในเครื่องจำกัด scalability และ resilience
การจัดการสถานะ
การจัดการสถานะมีข้อแลกเปลี่ยนขึ้นอยู่กับสิ่งที่กำลังสร้าง
สถานะภายนอกช่วยเพิ่ม scalability และ resilience
ต้นทุน: latency และความซับซ้อนที่เพิ่มขึ้น
สิ่งที่ต้องพิจารณา: consistency, caching และรูปแบบการเข้าถึงข้อมูล
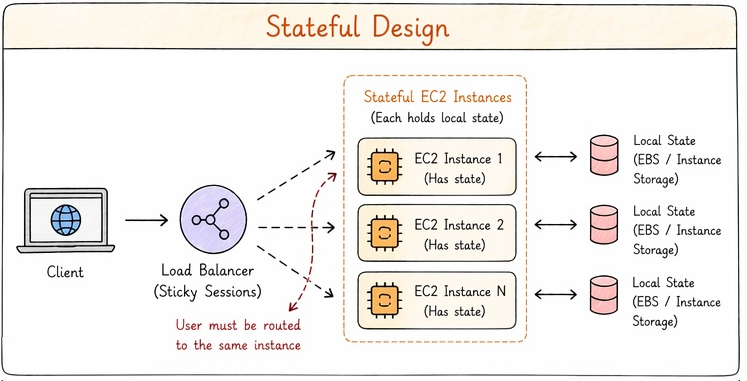
Stateful
ข้อมูล session ถูกเก็บไว้บน server
request ต้องถูกส่งไปยัง instance
เดิม
เสมอ (sticky sessions)
จำกัดความยืดหยุ่นในการขยายระบบ
หาก instance ล้มเหลว session จะหายไป
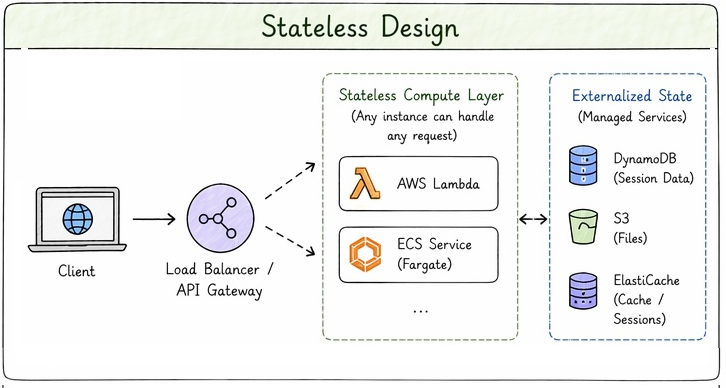
Stateless
ทุก request ได้รับการประมวลผลอย่างอิสระ
ไม่มีการเก็บสถานะบน server
สถานะอยู่ในระบบภายนอก
แนวทางที่แนะนำสำหรับแอป cloud-native
instance ใดก็จัดการ request ใดก็ได้ ทำให้ horizontal scaling ทำได้ง่าย
มาฝึกกันเถอะ!
การพัฒนาแอปพลิเคชันบน AWS
Preparing Video For Download...