Ottimizzazione di prestazioni e risorse
Distribuire applicazioni su AWS
Dunieski Otano
Amazon Web Services Solutions Architect
Lenta e costosa
L'app rallenta nei picchi di traffico
La bolletta Lambda esplode lo stesso mese
Il tuning la rende più veloce e più economica
Concorrenza: costo vs cold start
Reserved: limita e protegge
Impone un tetto e garantisce capacità a una funzione
Controllo più economico, ma non elimina i cold start
Provisioned: paghi per tenerla calda
Mantiene istanze pre-riscaldate: niente cold start
Costa di più; usala solo dove la latenza conta davvero
Dimensionare la memoria con la curva durata-costo
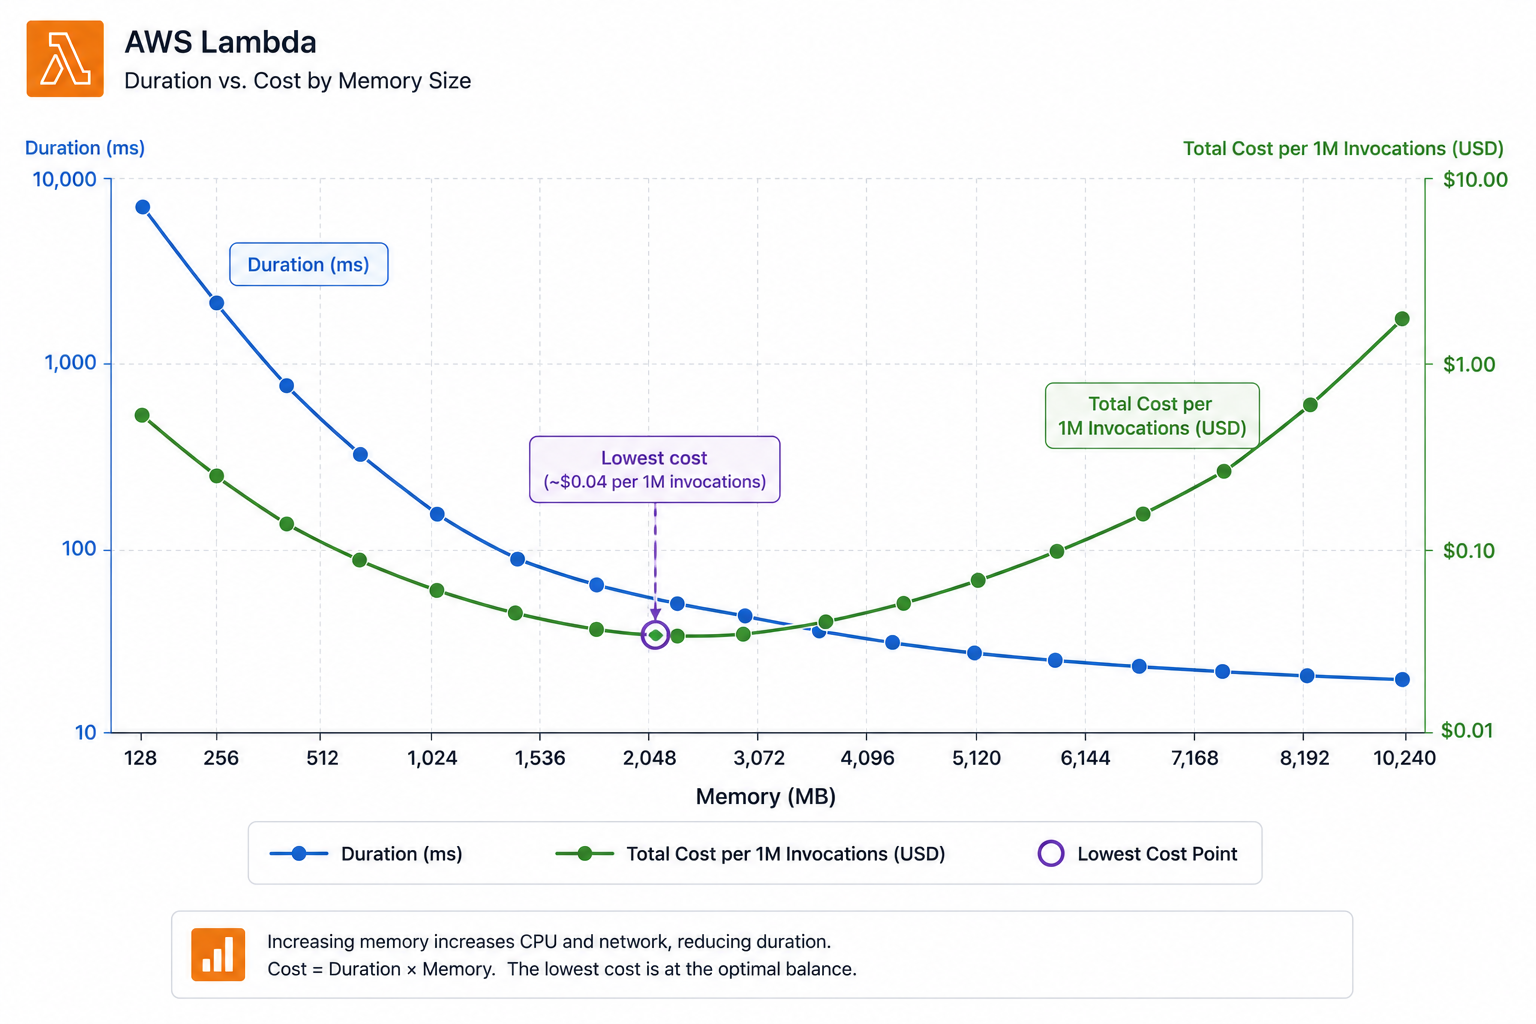
Più memoria = più CPU =
durata più breve
Costo = prezzo memoria x durata
Il punto più economico è spesso
a metà
Profila a varie dimensioni, poi scegli
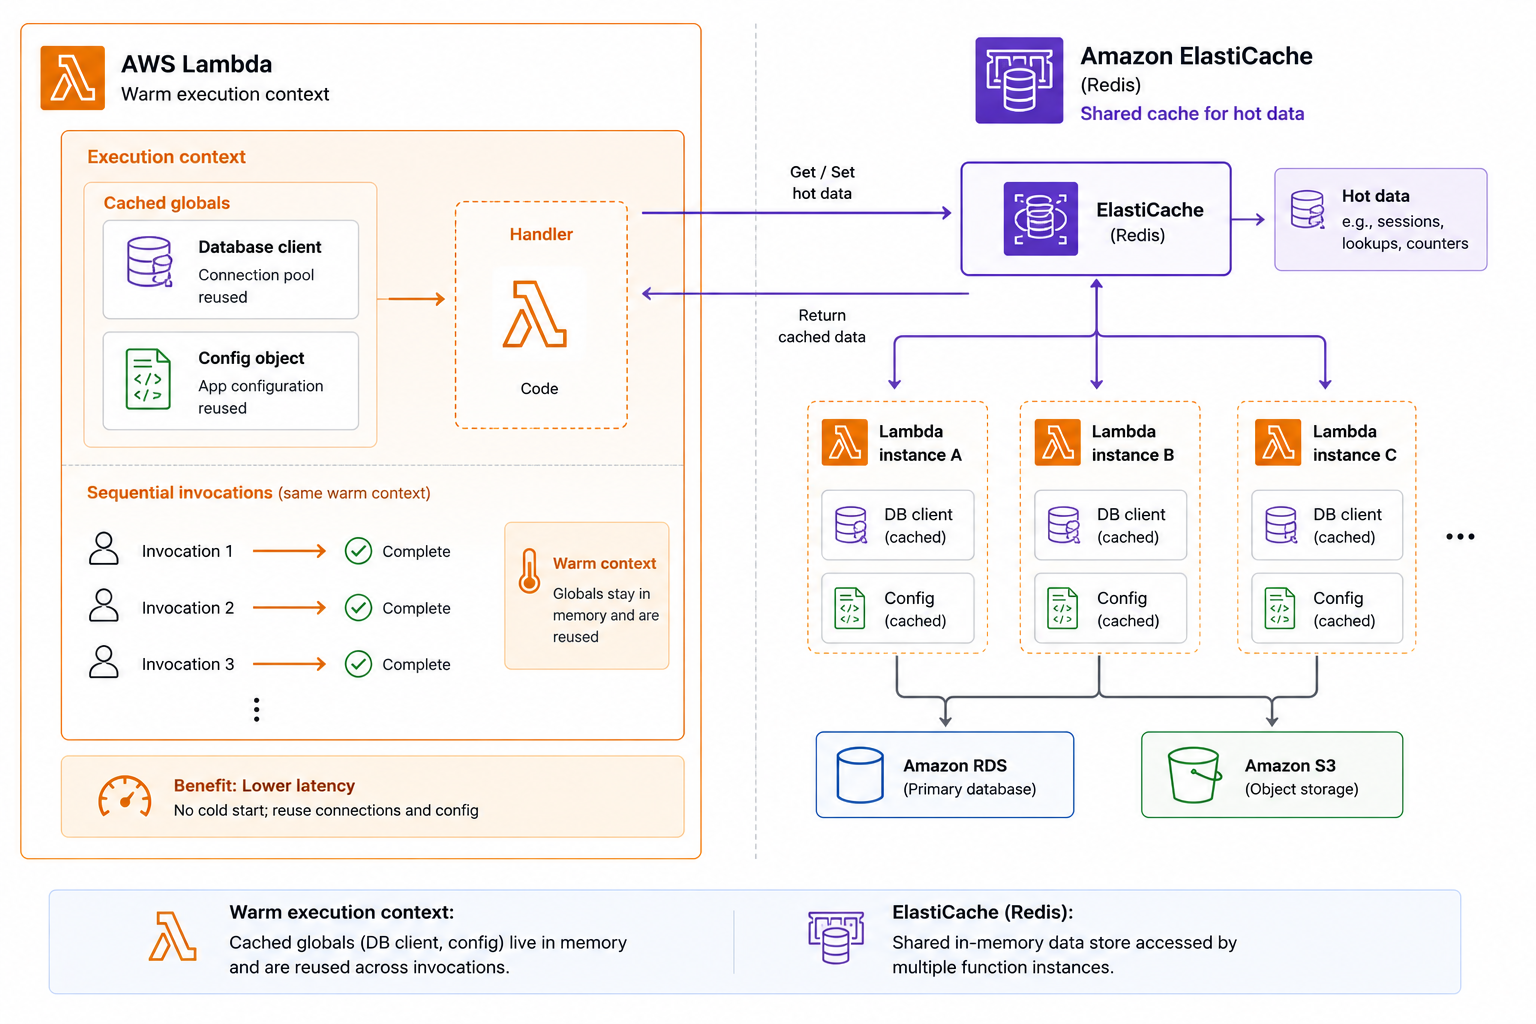
Caching a livello applicativo
Riusa lavoro
dentro il contesto di esecuzione
Una Lambda calda mantiene i global tra invocazioni
Metti in cache config, client e lookup frequenti
ElastiCache
per una cache condivisa tra istanze
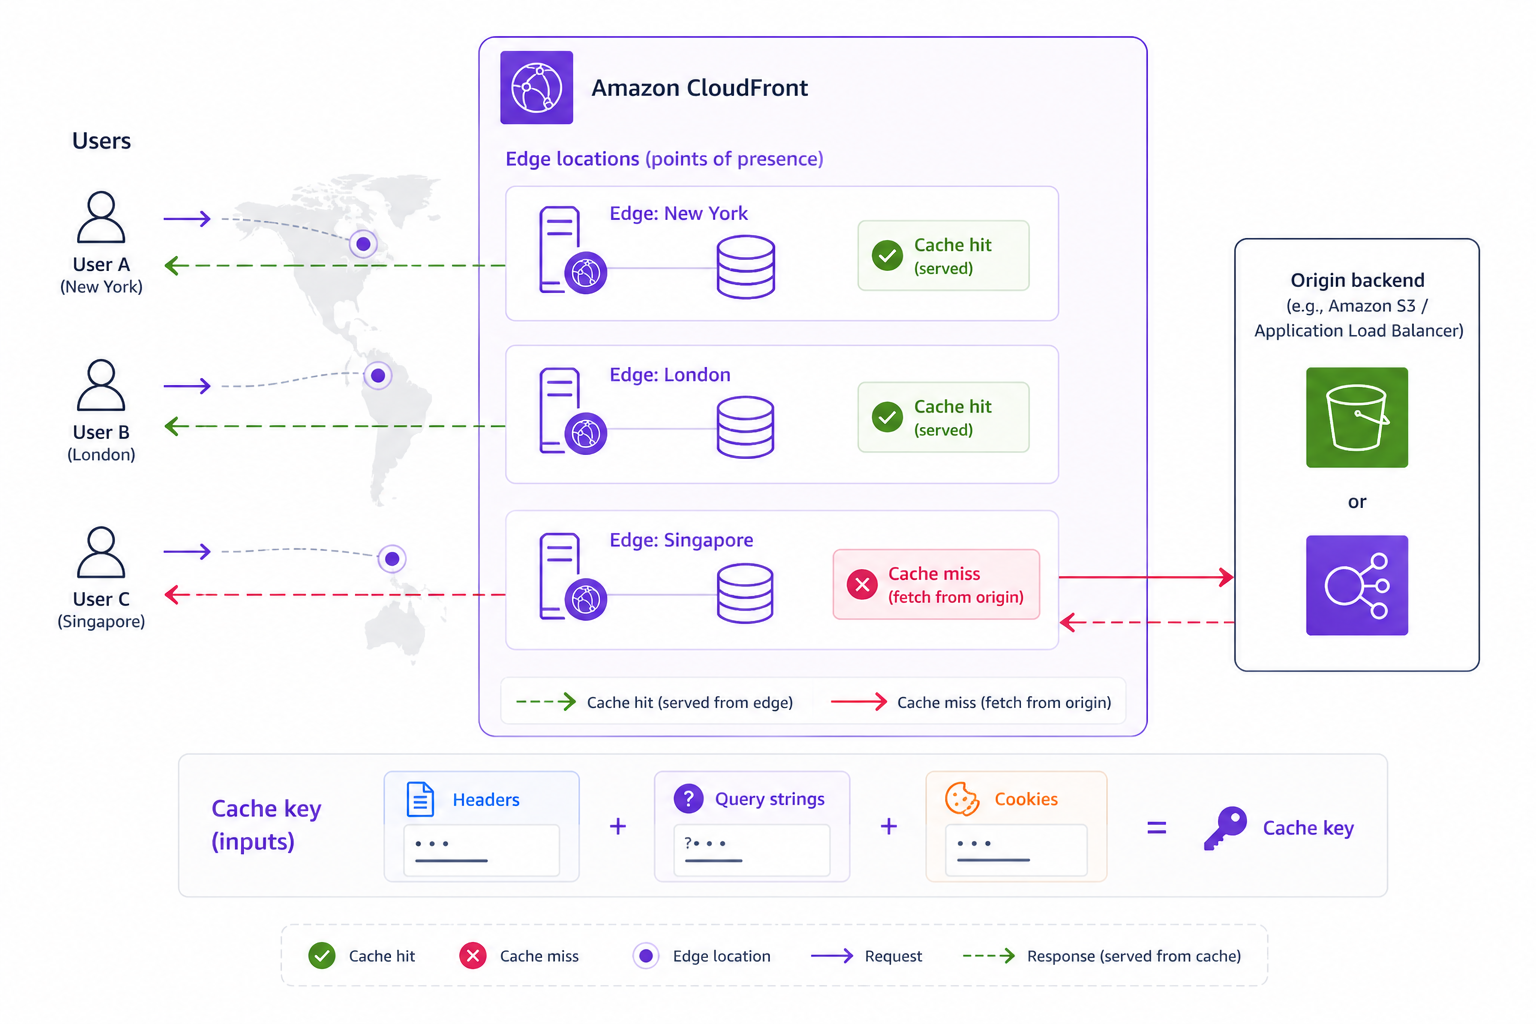
Caching CloudFront al bordo
CloudFront
: cache delle risposte nelle edge location
Serve richieste ripetute senza toccare il backend
Le chiavi di cache possono includere
header, query string, cookie
Contenuti statici e cacheabili scalano gratis
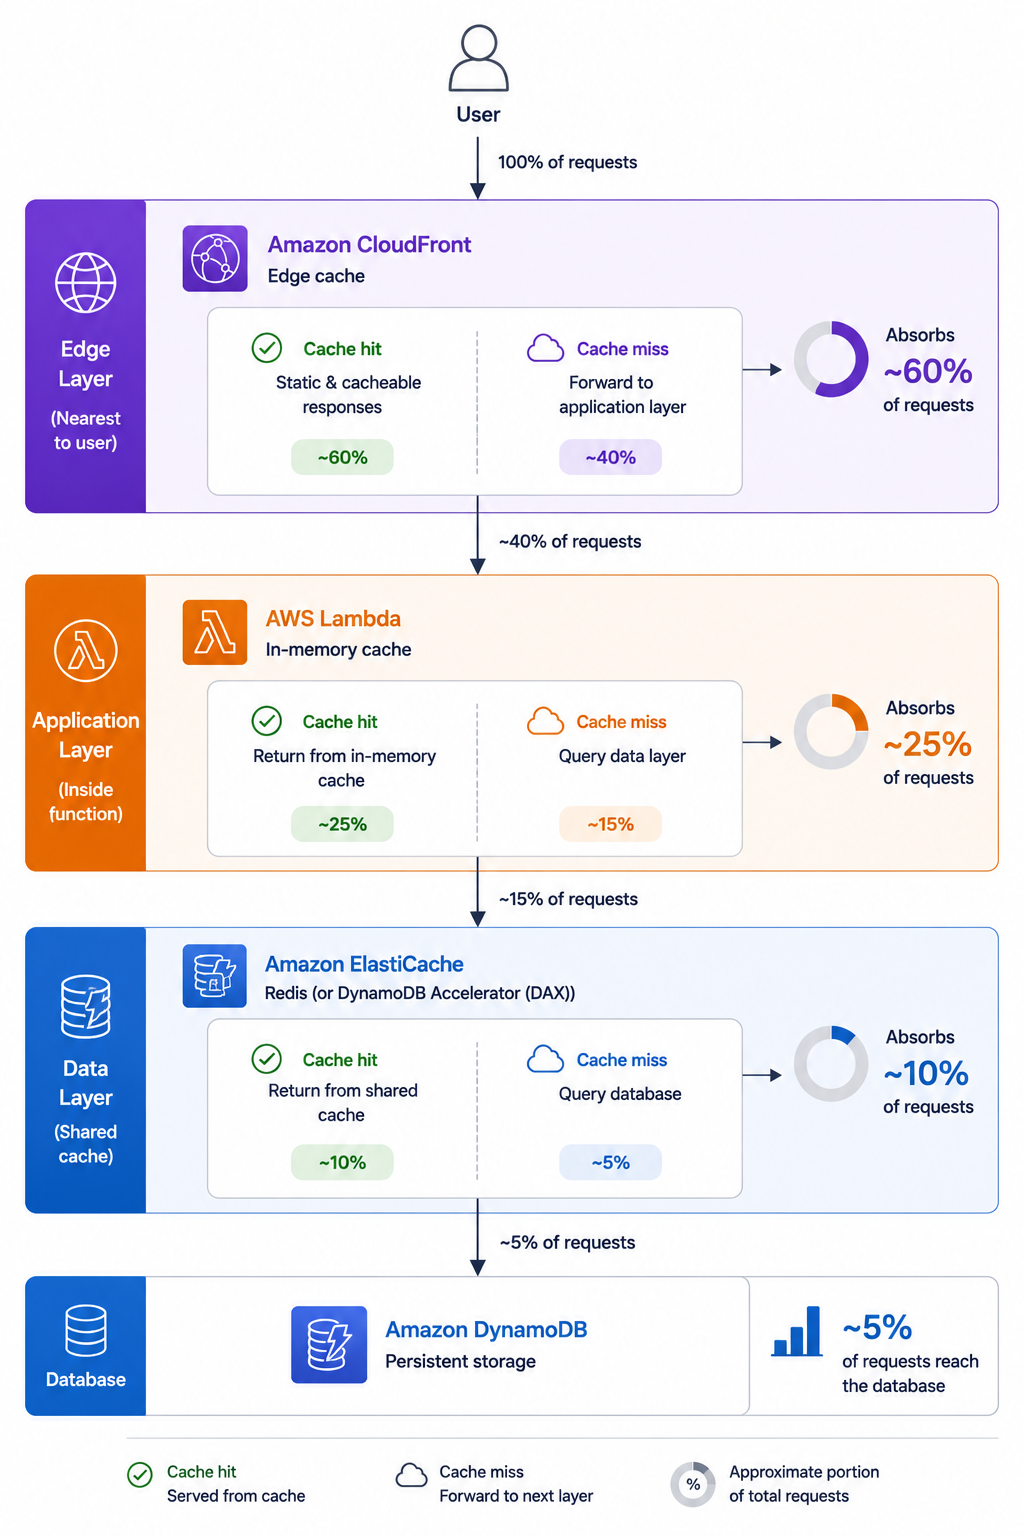
Scegliere il livello di cache giusto
Bordo (CloudFront)
: contenuti statici e molto condivisi
Applicazione (in memoria)
: oggetti caldi per istanza
Dati (ElastiCache/DAX)
: letture calde condivise
Stratifica: ogni livello riduce un costo diverso
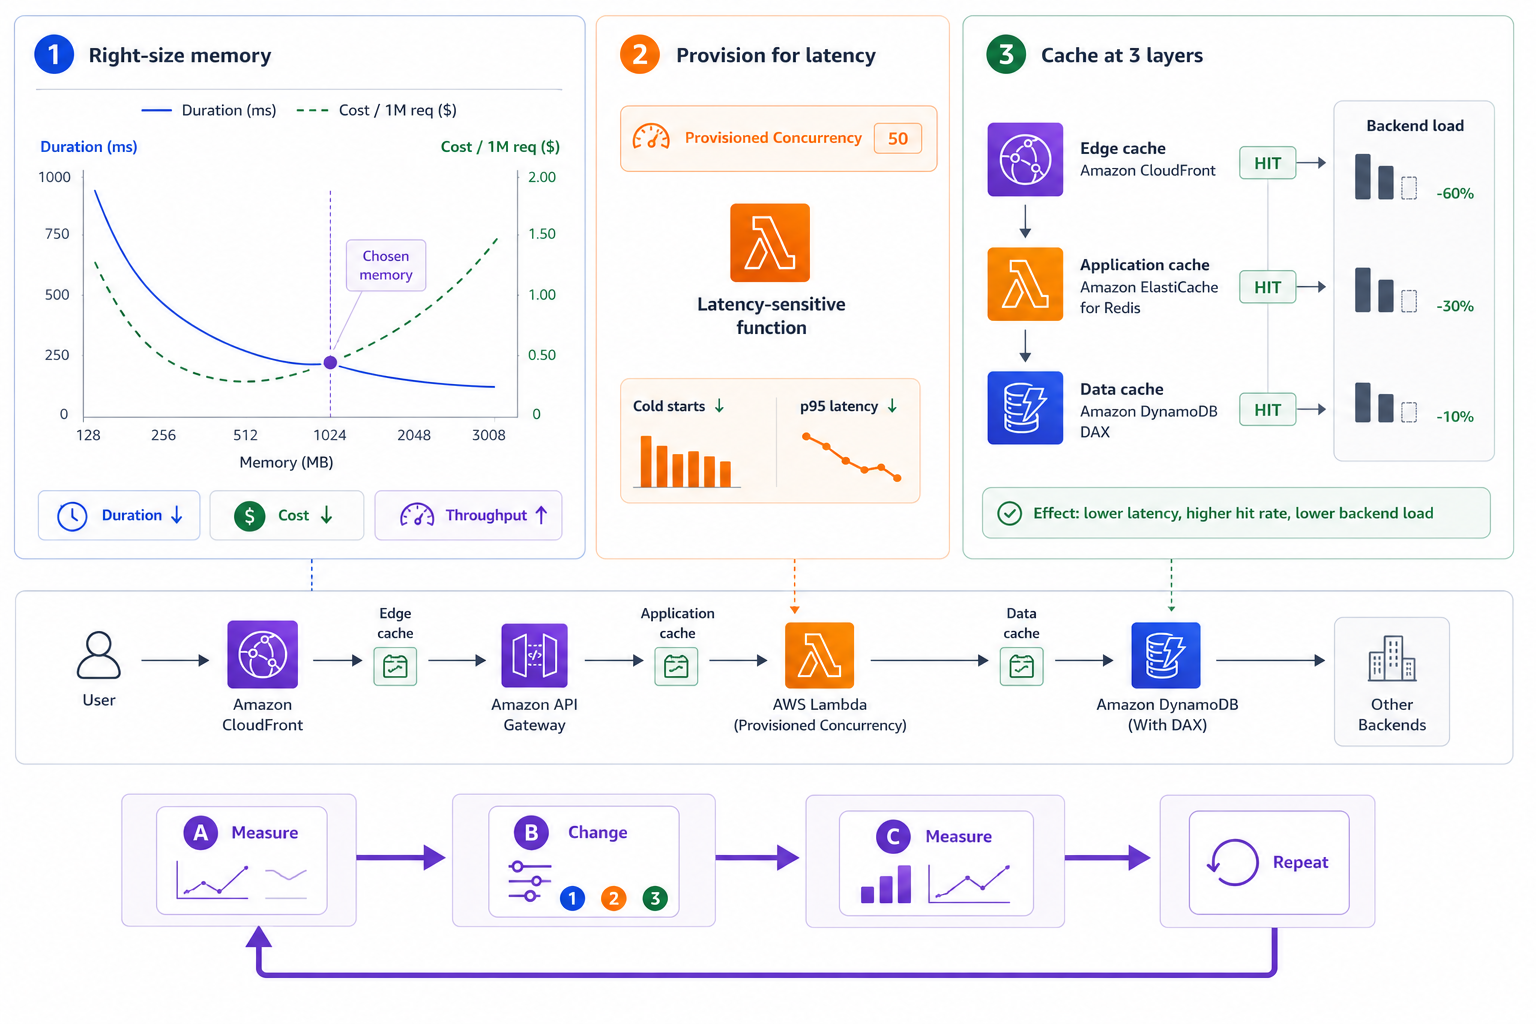
Mettere insieme l'ottimizzazione
Dimensiona la memoria con la
curva durata-costo
Aggiungi concorrenza pre-provisionata solo dove la latenza conta
Fai caching su
bordo, app e dati
Misura, cambia una cosa, misura di nuovo
Esercitiamoci!
Distribuire applicazioni su AWS
Preparing Video For Download...