Optimisation des performances et des ressources
Déployer des applications sur AWS
Dunieski Otano
Amazon Web Services Solutions Architect
Lente et coûteuse
L'appli ralenti lors des pointes de trafic
La facture Lambda grimpe le même mois
Un réglage la rend plus rapide et moins chère
Concurrence : coût vs démarrage à froid
Réservée : plafonner et protéger
Plafonne et garantit la capacité d'une fonction
Contrôle le moins cher, mais n'élimine pas les démarrages à froid
Approvisionnée : payer pour la « chaleur »
Garde des instances préchauffées, donc pas de démarrage à froid
Coûte plus cher ; à utiliser seulement si la latence compte vraiment
Dimensionner la mémoire avec la courbe durée-coût
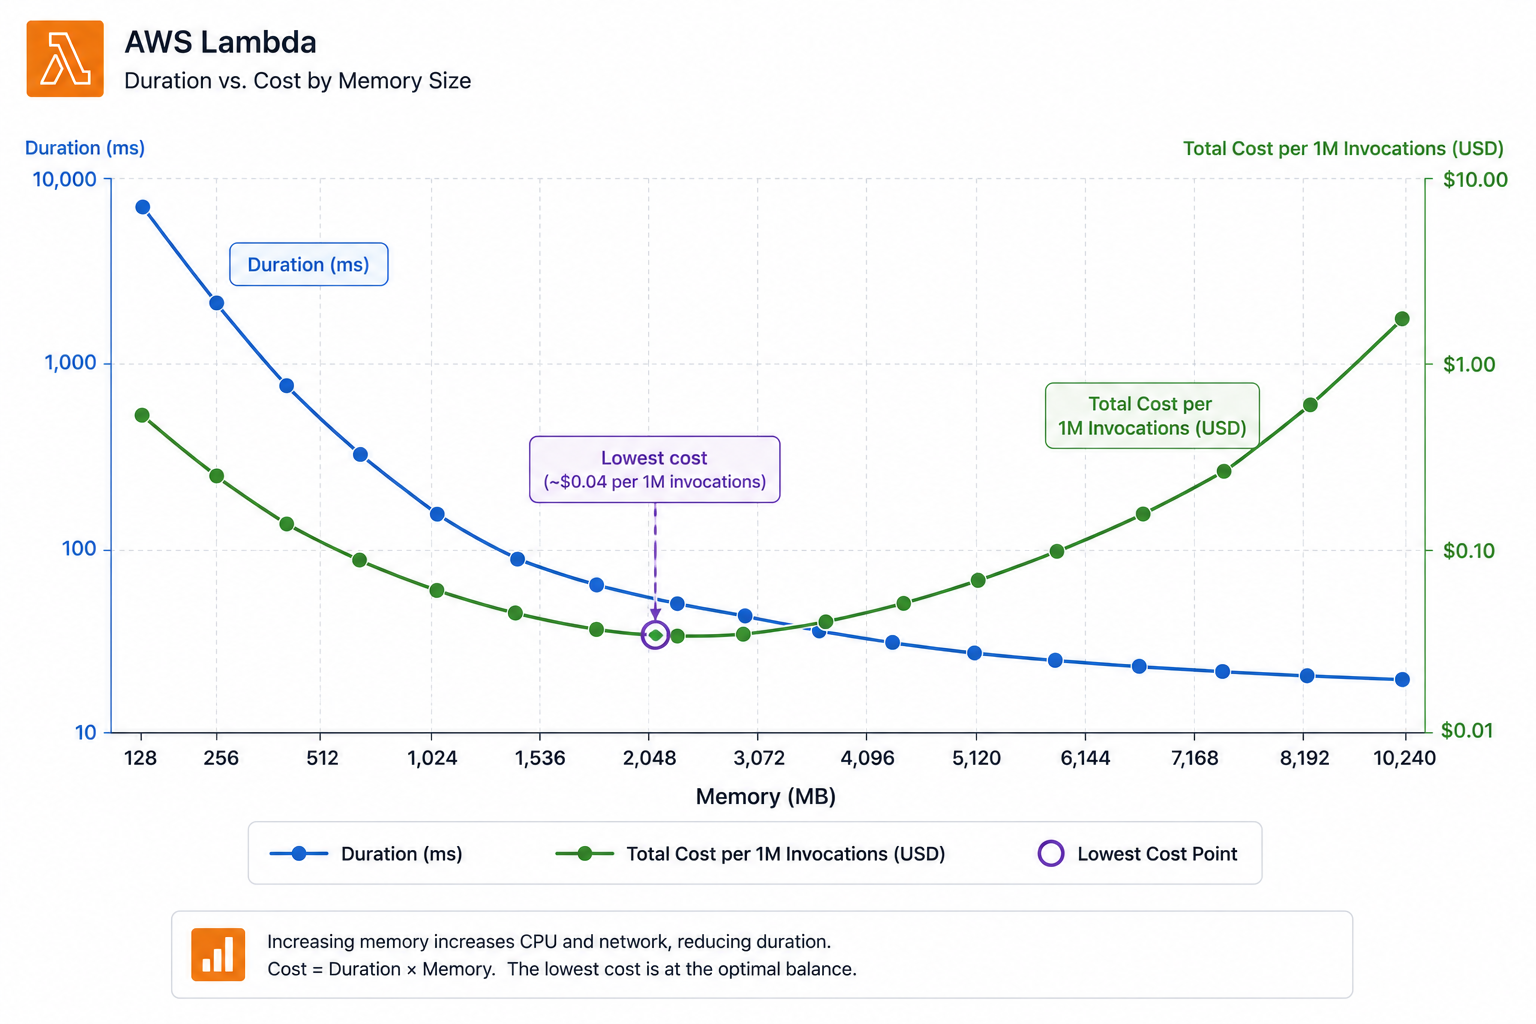
Plus de mémoire = plus de CPU =
durée plus courte
Coût = prix de la mémoire x durée
Le point le moins cher est souvent
au milieu
Dressez un profil à plusieurs tailles, puis choisissez
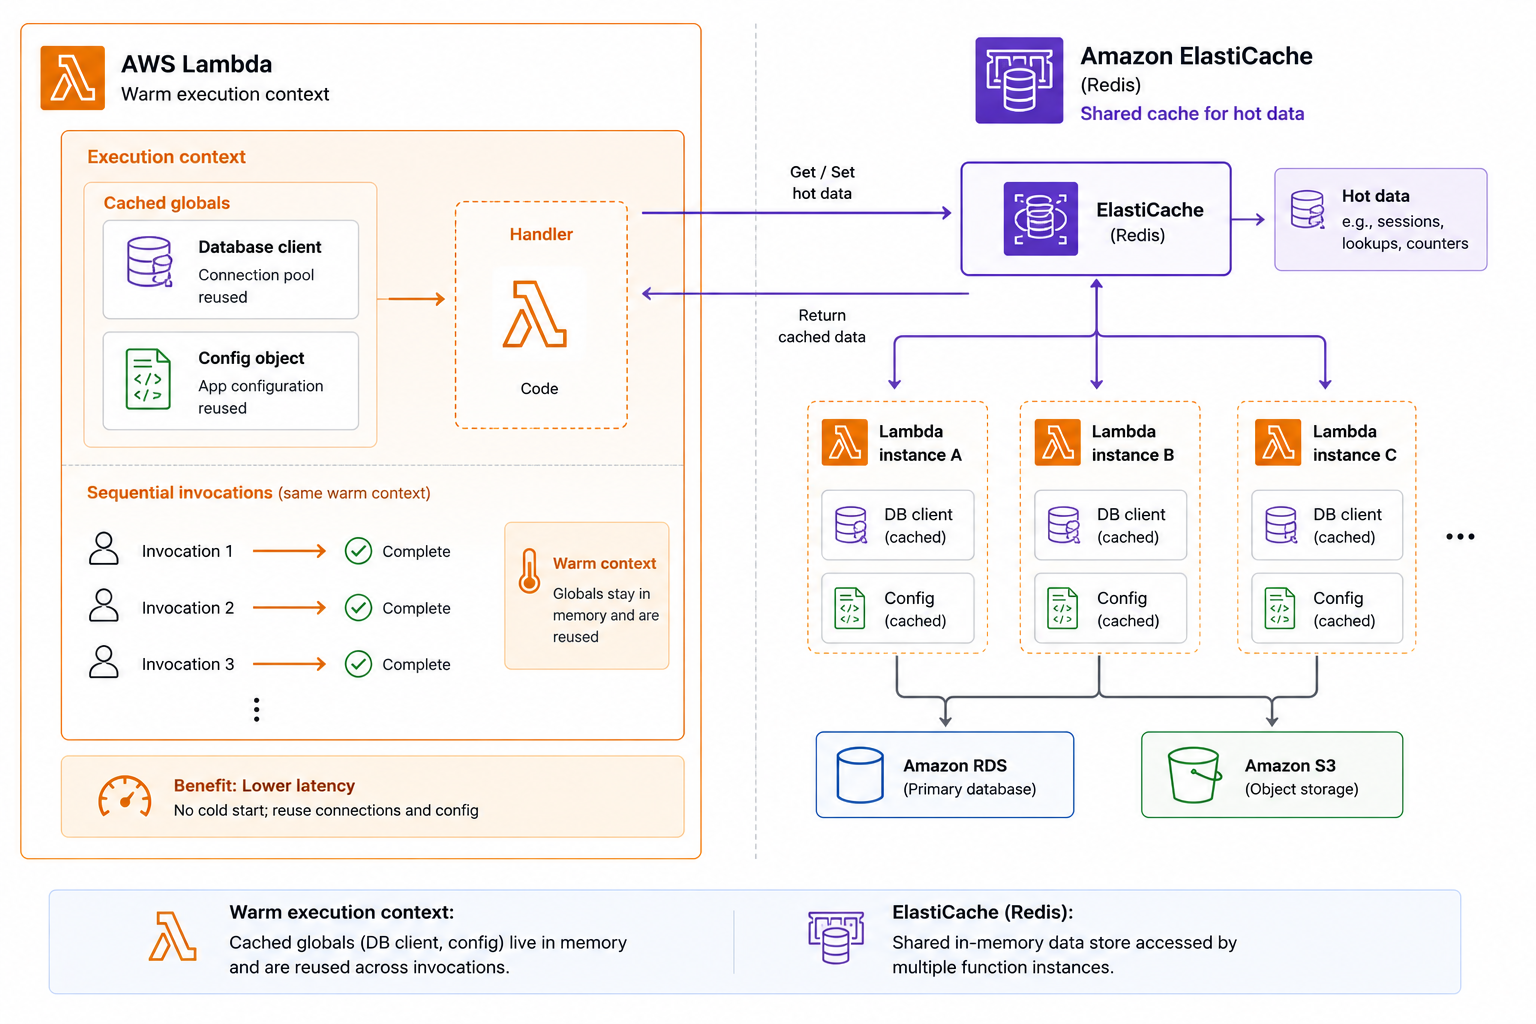
Mise en cache au niveau applicatif
Réutiliser le travail
dans le contexte d'exécution
Une Lambda « chaude » conserve les variables globales entre appels
Mettre en cache config, clients et recherches fréquentes
ElastiCache
pour un cache partagé entre instances
Mise en cache CloudFront en périphérie
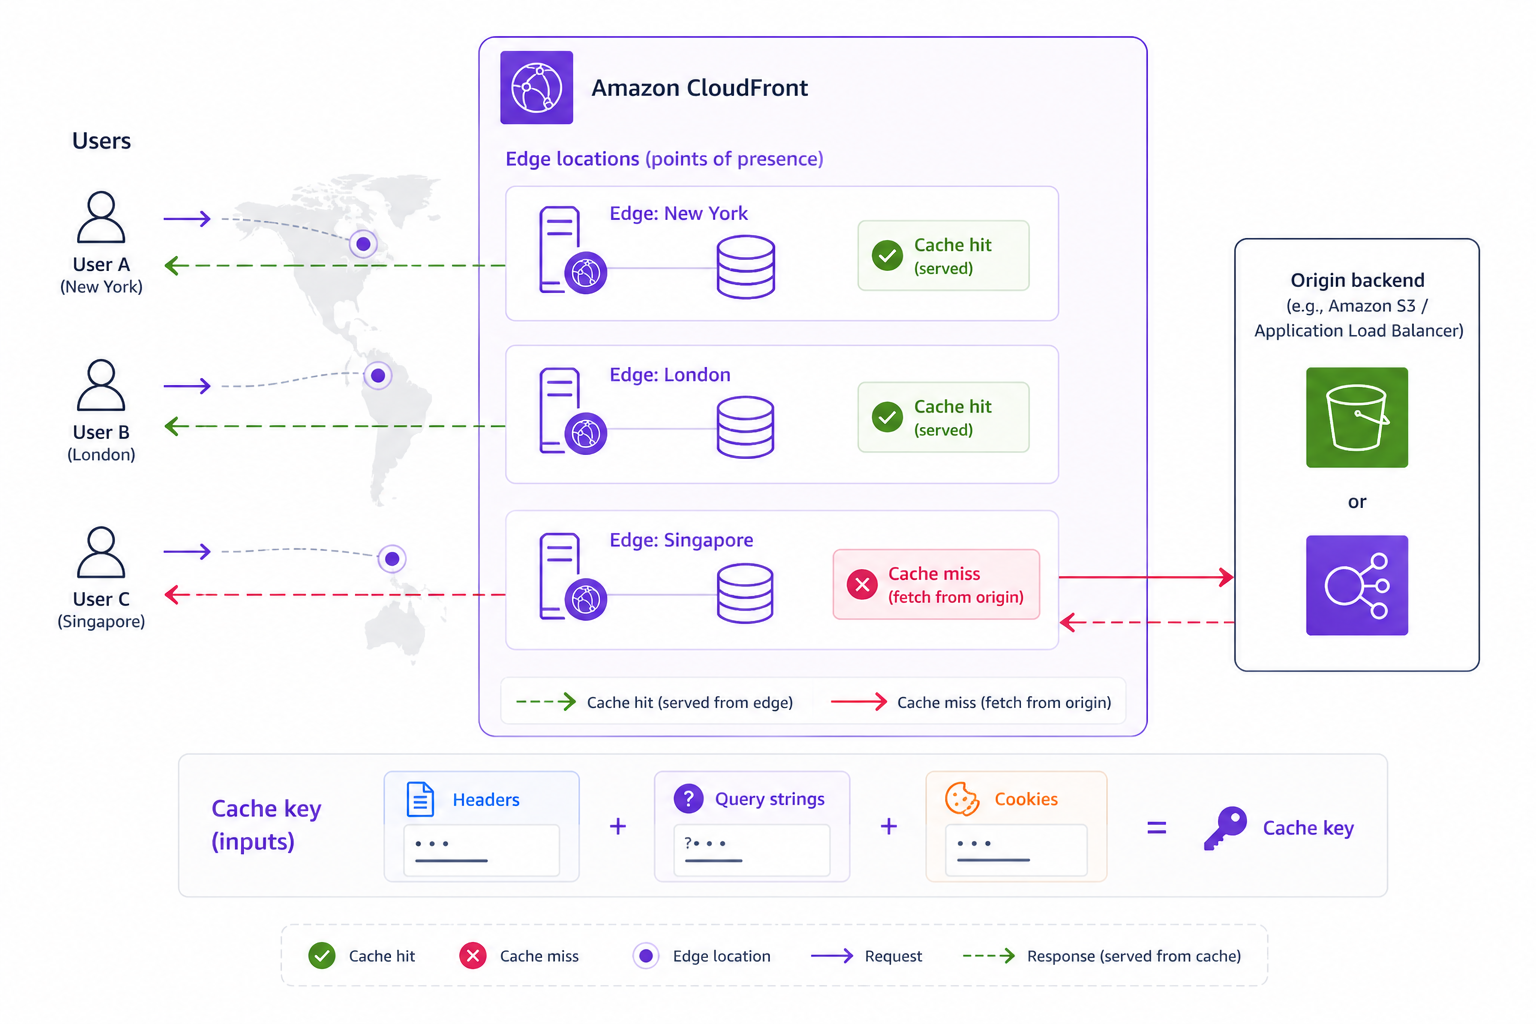
CloudFront
: mettre en cache les réponses aux emplacements périphériques
Servir les requêtes répétées sans toucher l'arrière-plan
Les clés de cache peuvent inclure
en-têtes, chaînes de requête, témoins
Le contenu statique et en cache passe à l'échelle sans frais
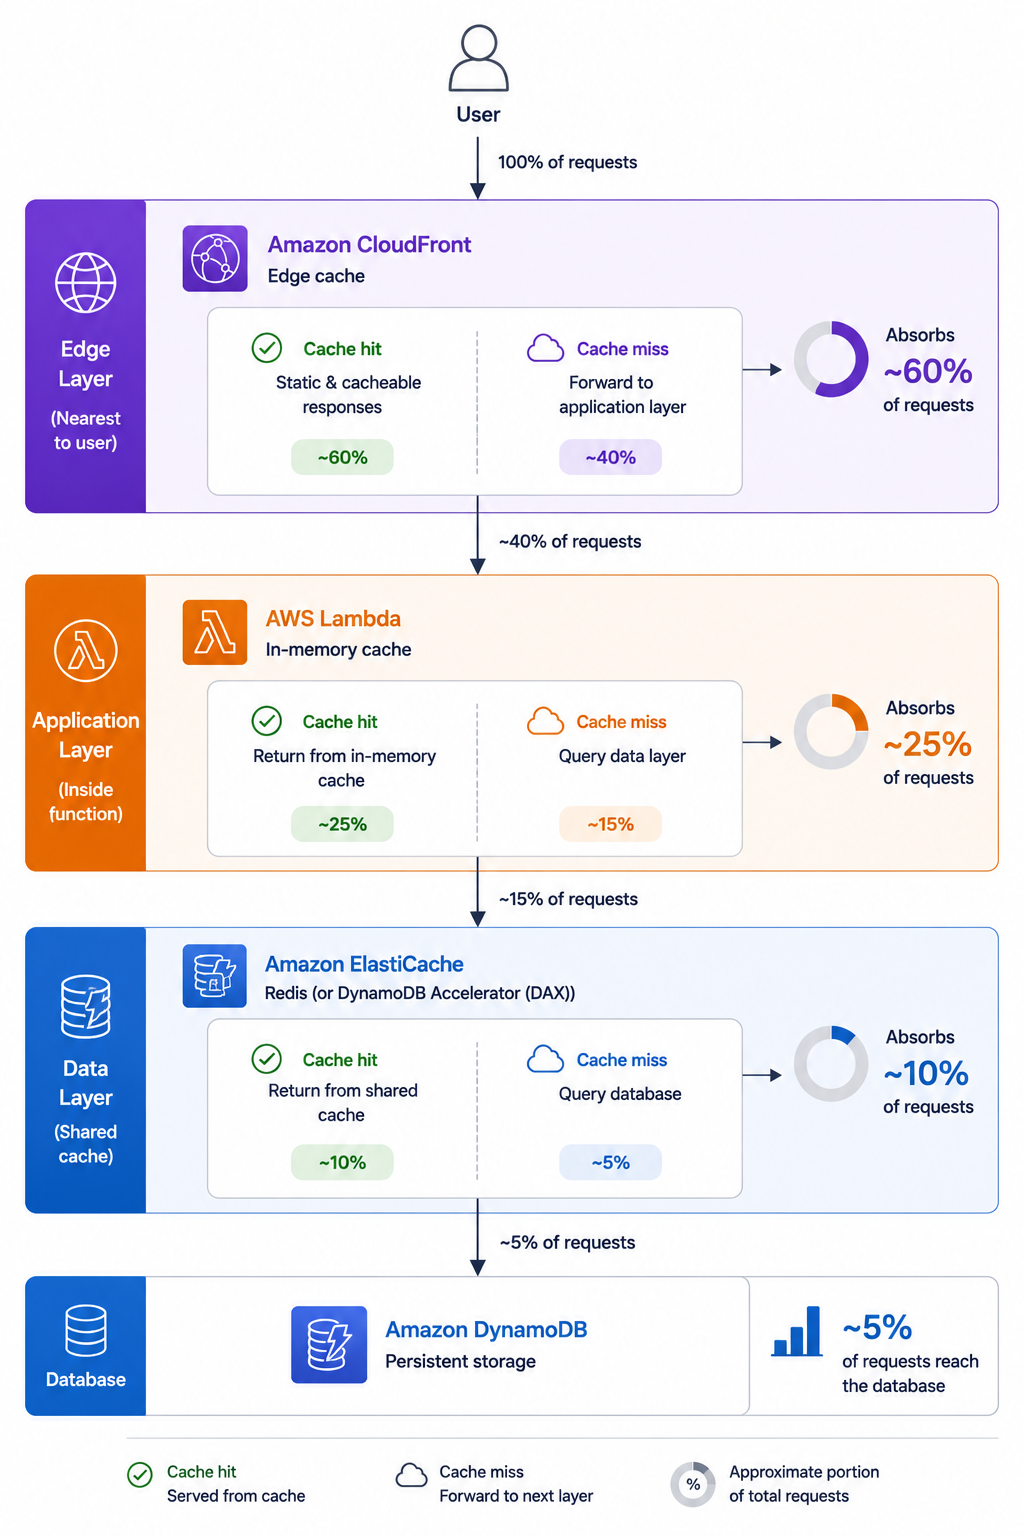
Choisir la bonne couche de cache
Périphérie (CloudFront)
: contenu statique, largement partagé
Application (en mémoire)
: objets chauds par instance
Données (ElastiCache/DAX)
: lectures chaudes partagées
Superposez-les ; chacune réduit un coût différent
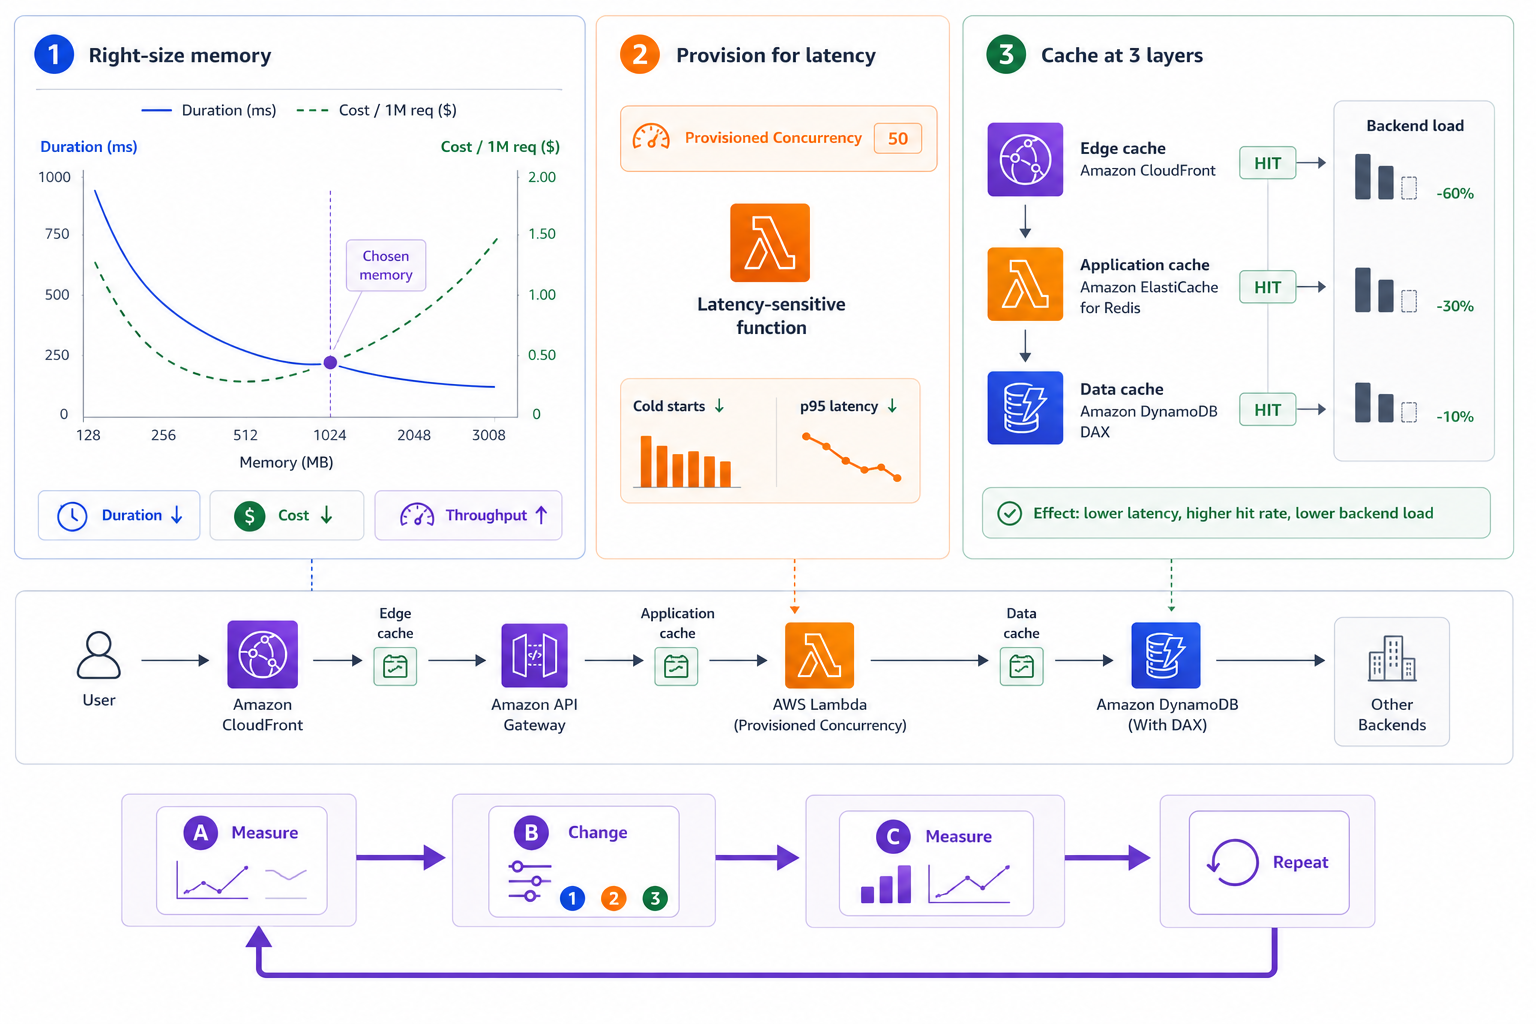
Réunir les optimisations
Dimensionner la mémoire avec la
courbe durée-coût
Ajouter la concurrence approvisionnée seulement où la latence compte
Mettre en cache aux couches
périphérie, appli et données
Mesurer, changer un élément, mesurer encore
Passons à la pratique !
Déployer des applications sur AWS
Preparing Video For Download...