Performance- und Ressourcenoptimierung
Bereitstellen von Anwendungen auf AWS
Dunieski Otano
Amazon Web Services Solutions Architect
Langsam und teuer
Die App wirkt bei Traffic-Spitzen langsam
Die Lambda-Rechnung springt im selben Monat
Tuning macht sie schneller und günstiger
Parallelität: Kosten vs. Cold Start
Reserved: deckeln und schützen
Deckelt und garantiert Kapazität für eine Funktion
Günstigste Steuerung, hilft aber nicht bei Cold Starts
Provisioned: für Wärme zahlen
Hält Instanzen vorgewärmt, kein Cold Start
Teurer; nur dort nutzen, wo Latenz wirklich zählt
Speicher richtig dimensionieren mit der Dauer-Kosten-Kurve
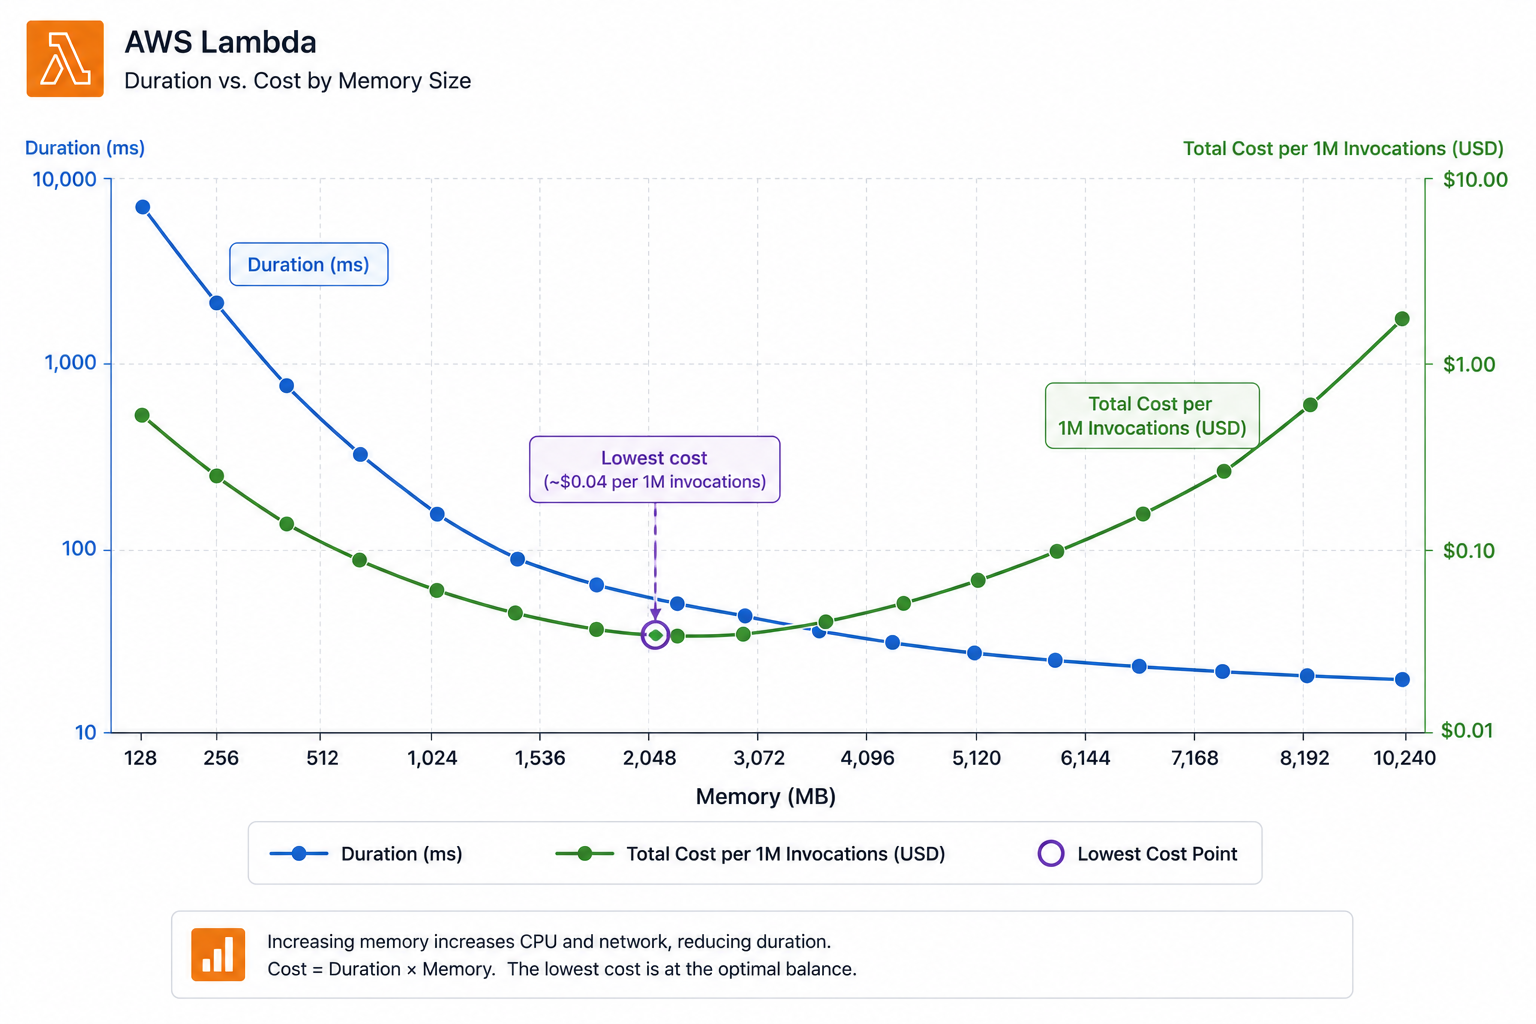
Mehr Speicher = mehr CPU =
kürzere Dauer
Kosten = Speicherpreis × Dauer
Der günstigste Punkt liegt oft
mittig
Profiliere bei mehreren Größen, dann wählen
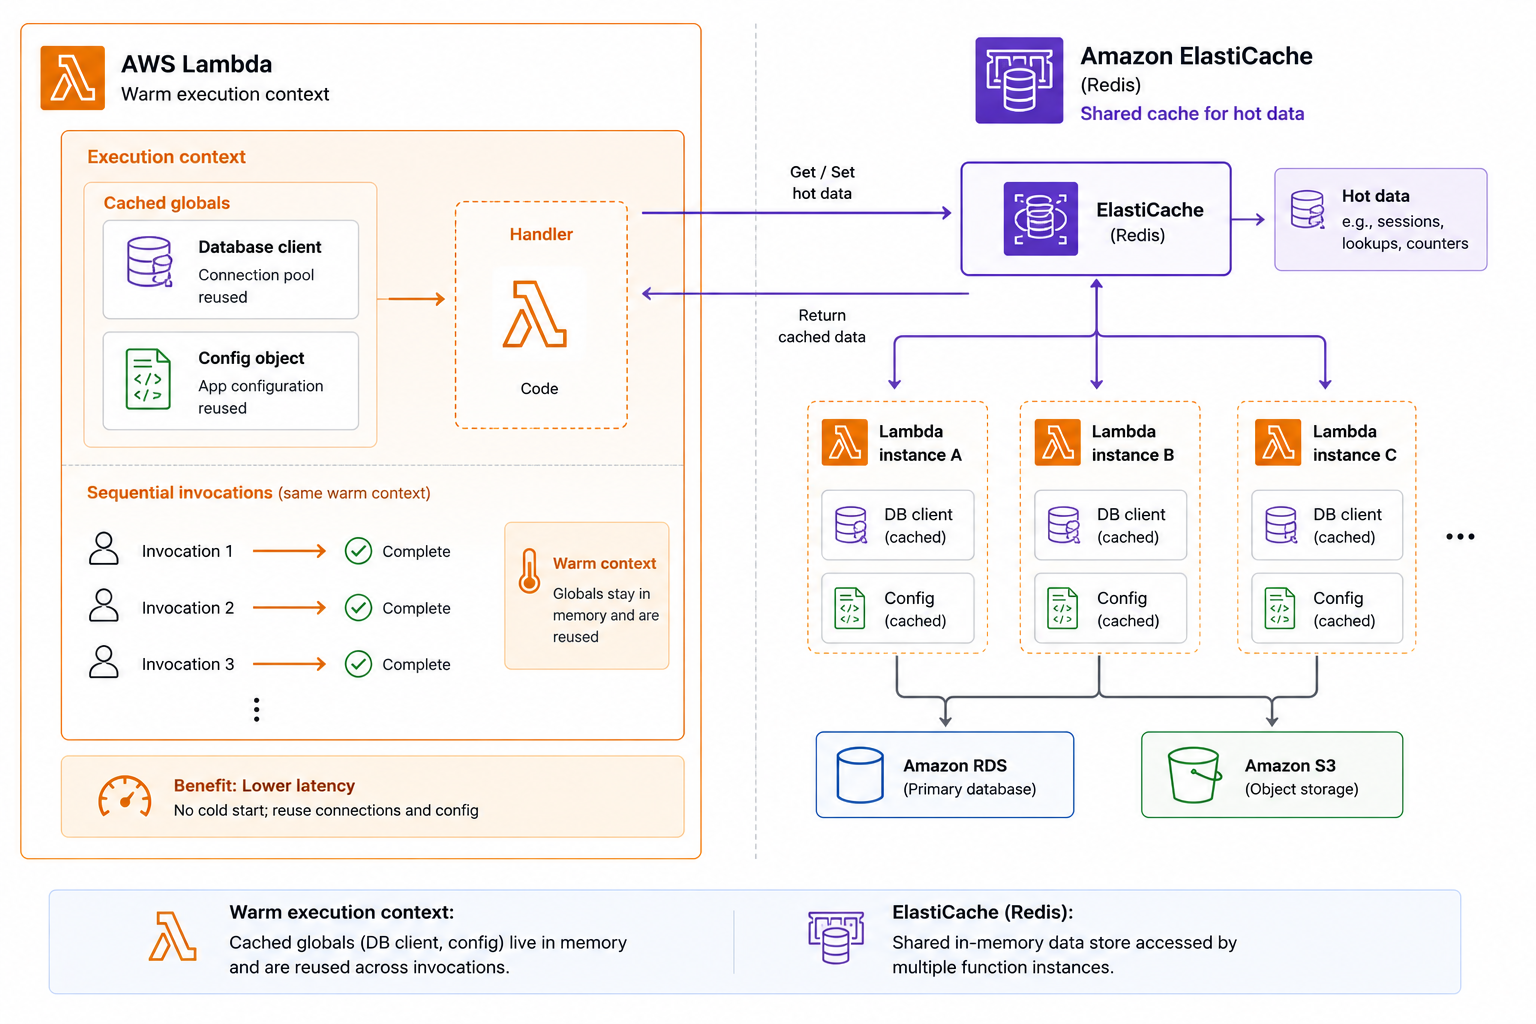
Caching auf Anwendungsebene
Arbeit
im Ausführungskontext
wiederverwenden
Eine warme Lambda behält Globals zwischen Aufrufen
Konfig, Clients und Hot-Lookups cachen
ElastiCache
für einen geteilten Cache über Instanzen
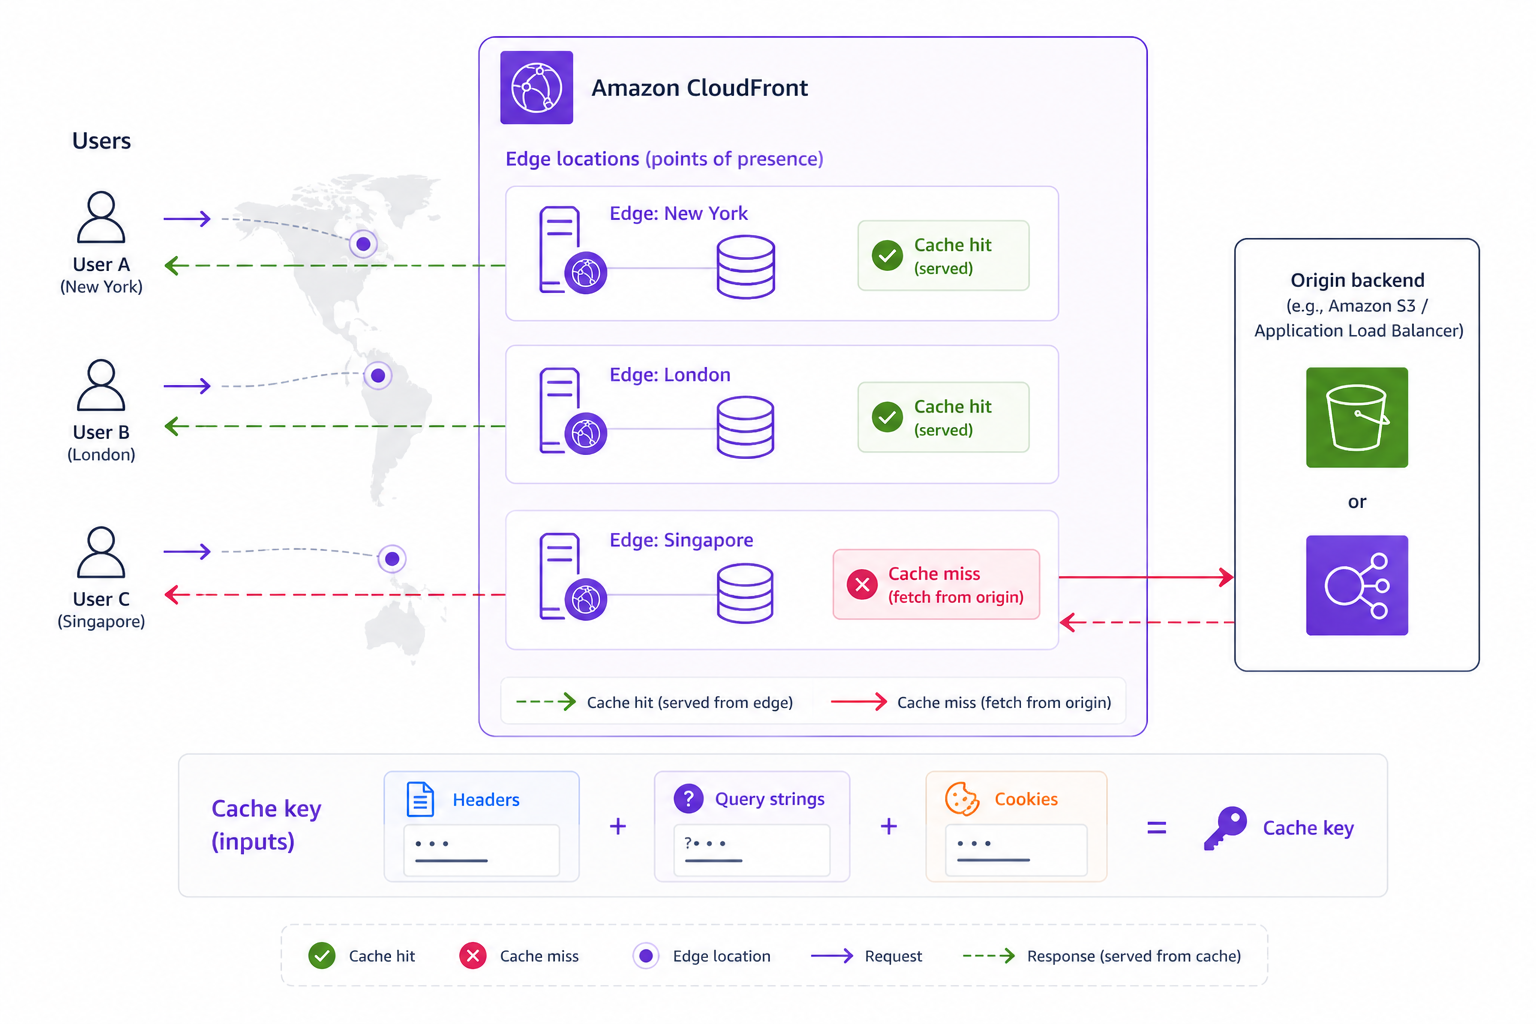
CloudFront-Caching am Edge
CloudFront
: Antworten an Edge-Standorten cachen
Wiederholte Anfragen ohne Backend bedienen
Cache-Keys können
Header, Query-Strings, Cookies
enthalten
Statischer und cachebarer Content skaliert kostenlos
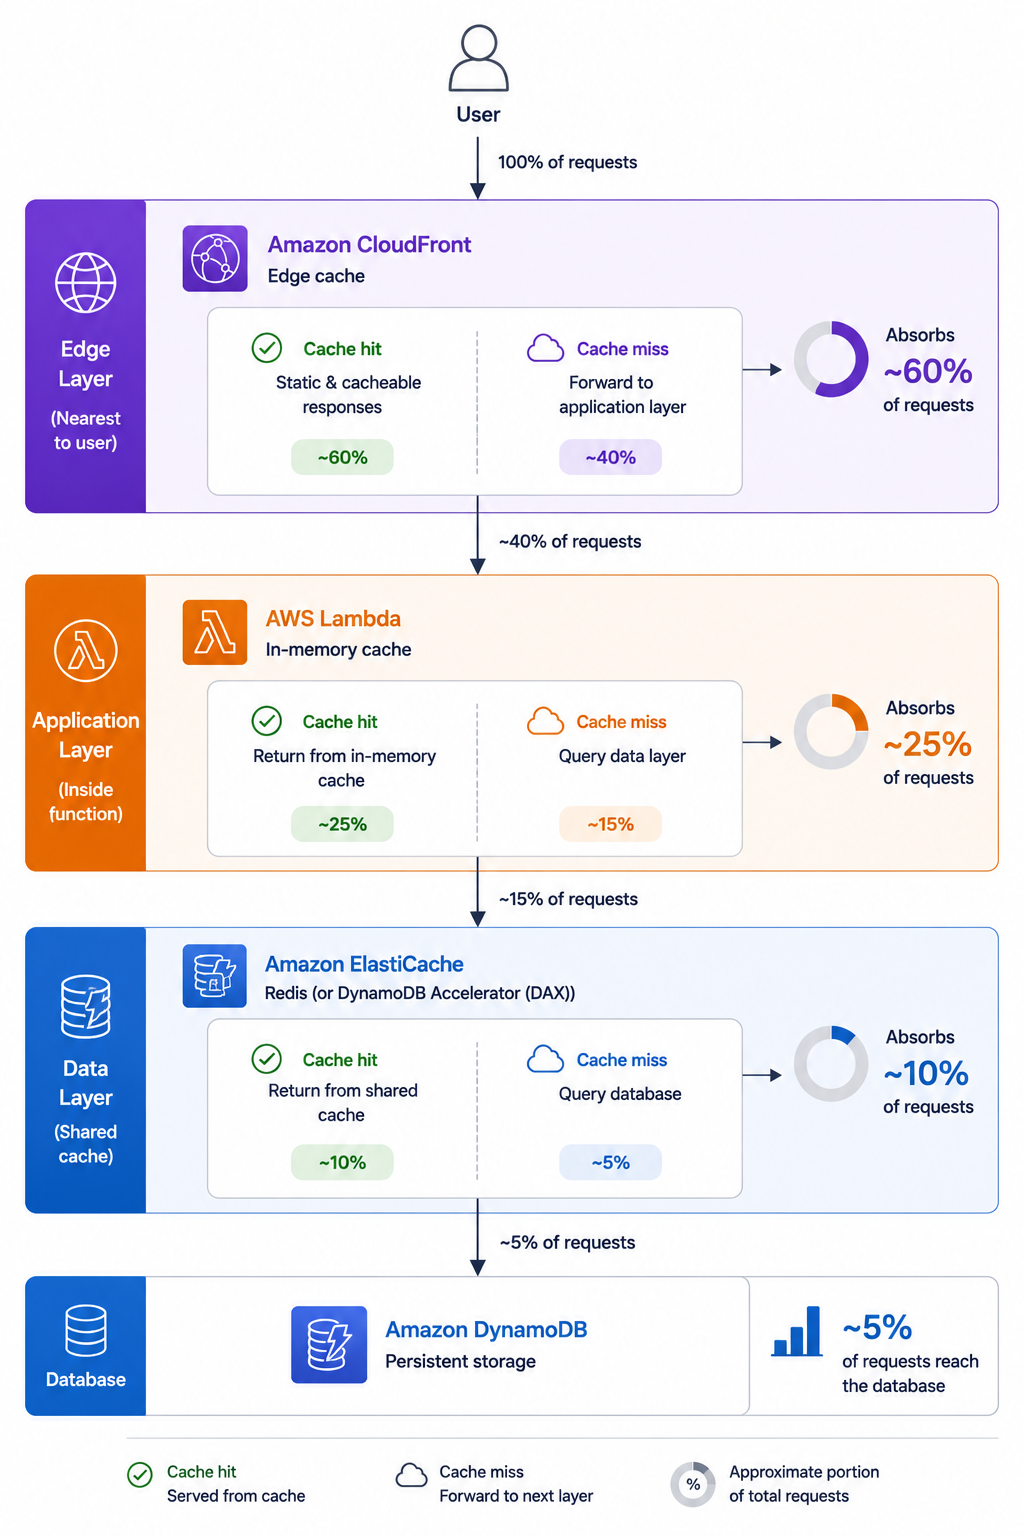
Die richtige Cache-Ebene wählen
Edge (CloudFront)
: statische, breit geteilte Inhalte
Application (in-memory)
: pro Instanz Hot-Objekte
Data (ElastiCache/DAX)
: geteilte Hot-Reads
Stapeln; jede Ebene senkt andere Kosten
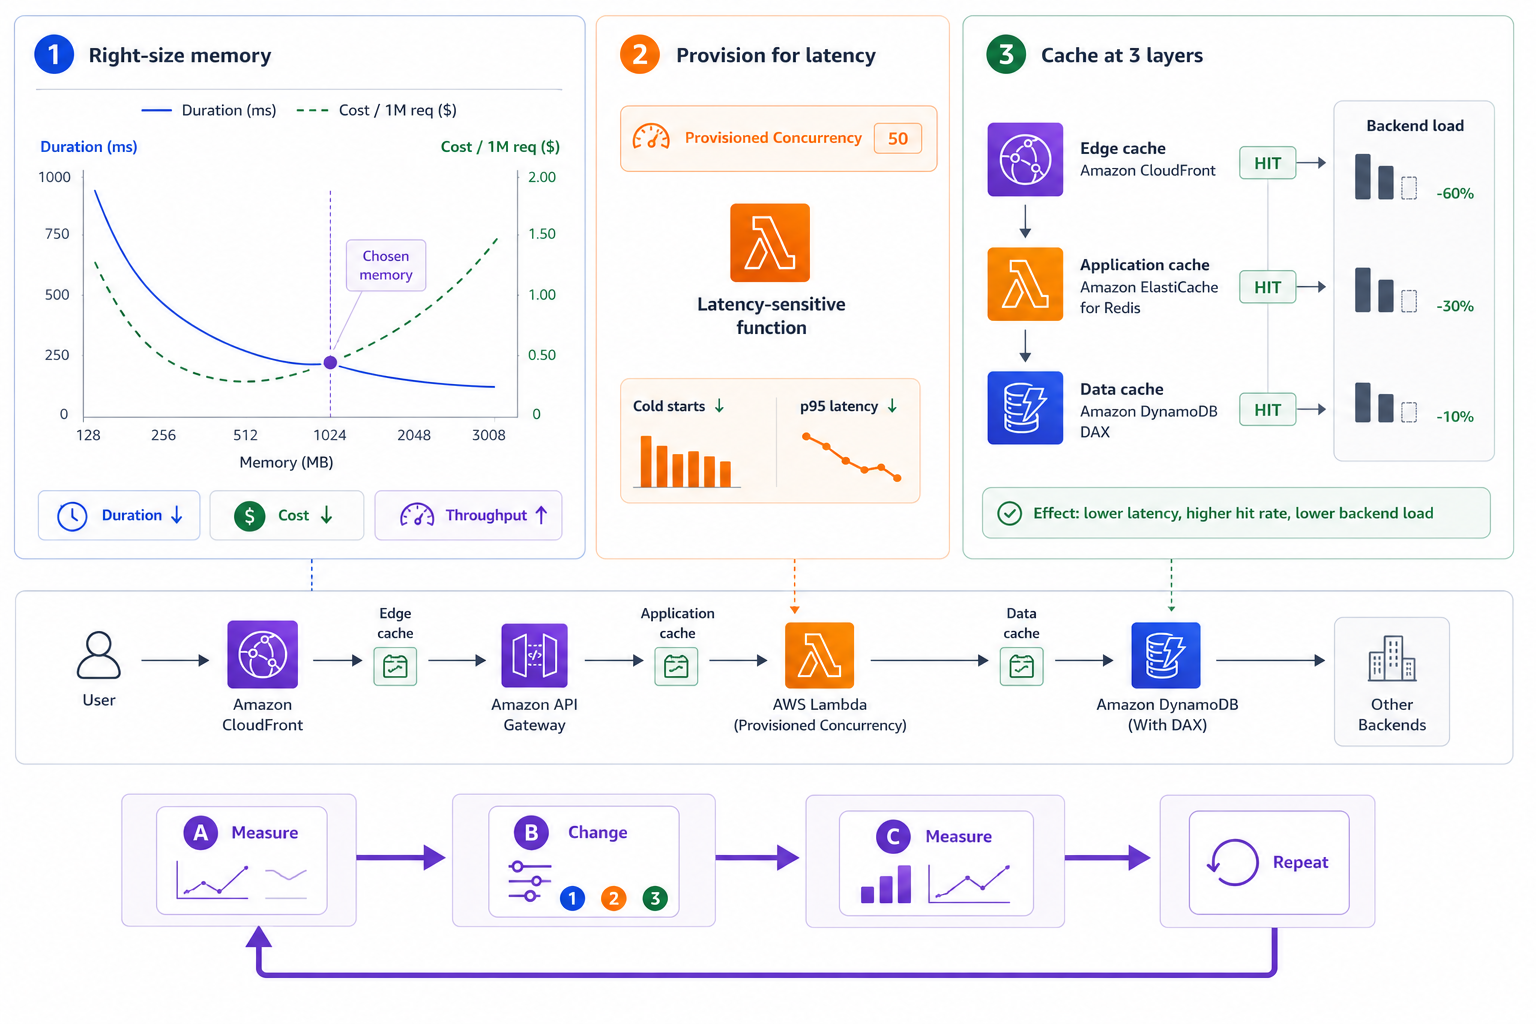
Optimierung zusammenführen
Speicher per
Dauer-Kosten-Kurve
dimensionieren
Provisioned Concurrency nur dort, wo Latenz zählt
Auf
Edge-, App- und Daten
-Ebene cachen
Messen, eine Sache ändern, erneut messen
Lass uns üben!
Bereitstellen von Anwendungen auf AWS
Preparing Video For Download...