Performanță și optimizarea resurselor

Implementarea aplicațiilor pe AWS

Dunieski Otano

Amazon Web Services Solutions Architect

Lentă și scumpă
  • Aplicația devine lentă la vârfuri de trafic
  • Factura Lambda crește în aceeași lună
  • Optimizarea o face mai rapidă și mai ieftină

Indicator viteză-cost care arată o funcție lentă și scumpă, orientat spre optimizare

Implementarea aplicațiilor pe AWS

Concurență: cost vs. porniri la rece


Rezervată: limitare și protecție

  • Limitează și garantează capacitatea unei funcții
  • Cel mai ieftin control, dar nu rezolvă pornirile la rece

Provizionată: plătești pentru disponibilitate

  • Menține instanțele pre-inițializate, fără porniri la rece
  • Costă mai mult; folosește-o doar unde latența contează
Implementarea aplicațiilor pe AWS

Dimensionarea memoriei cu curba durată-cost
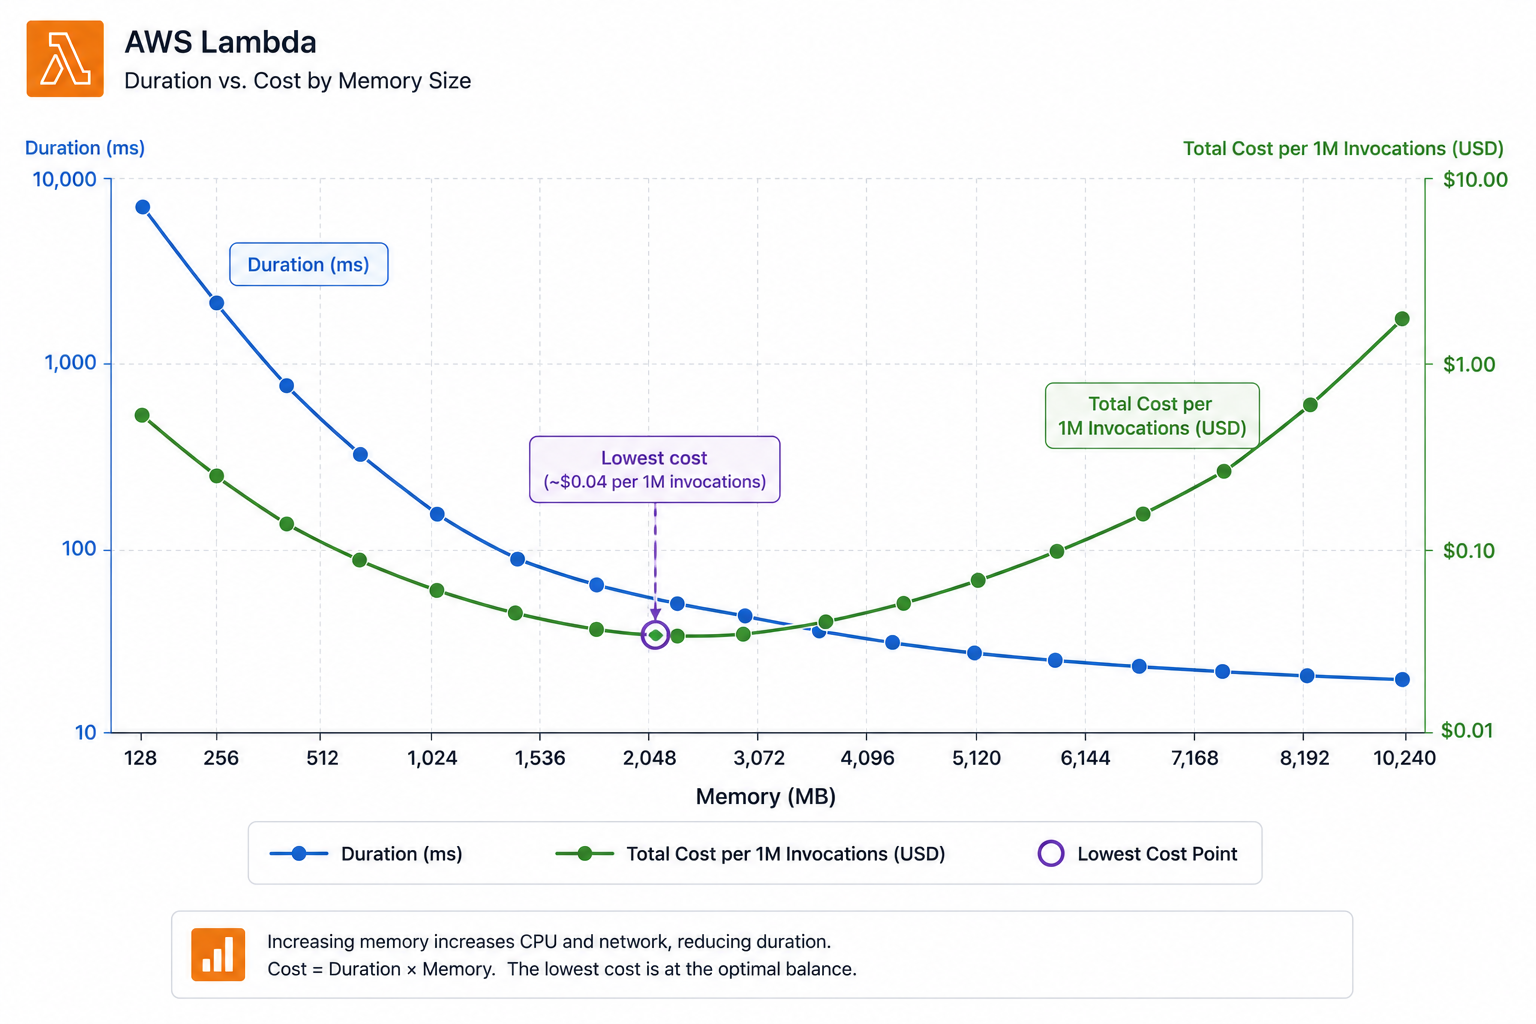
Curbă durată-cost în funcție de memorie: linia duratei scade apoi se aplatizează, costul total formează un U cu setarea optimă evidențiată

  • Mai multă memorie = mai mult CPU = durată mai scurtă
  • Cost = prețul memoriei x durată
  • Punctul cel mai ieftin este adesea la mijloc
  • Profilează la mai multe dimensiuni, apoi alege
Implementarea aplicațiilor pe AWS

Caching la nivel de aplicație

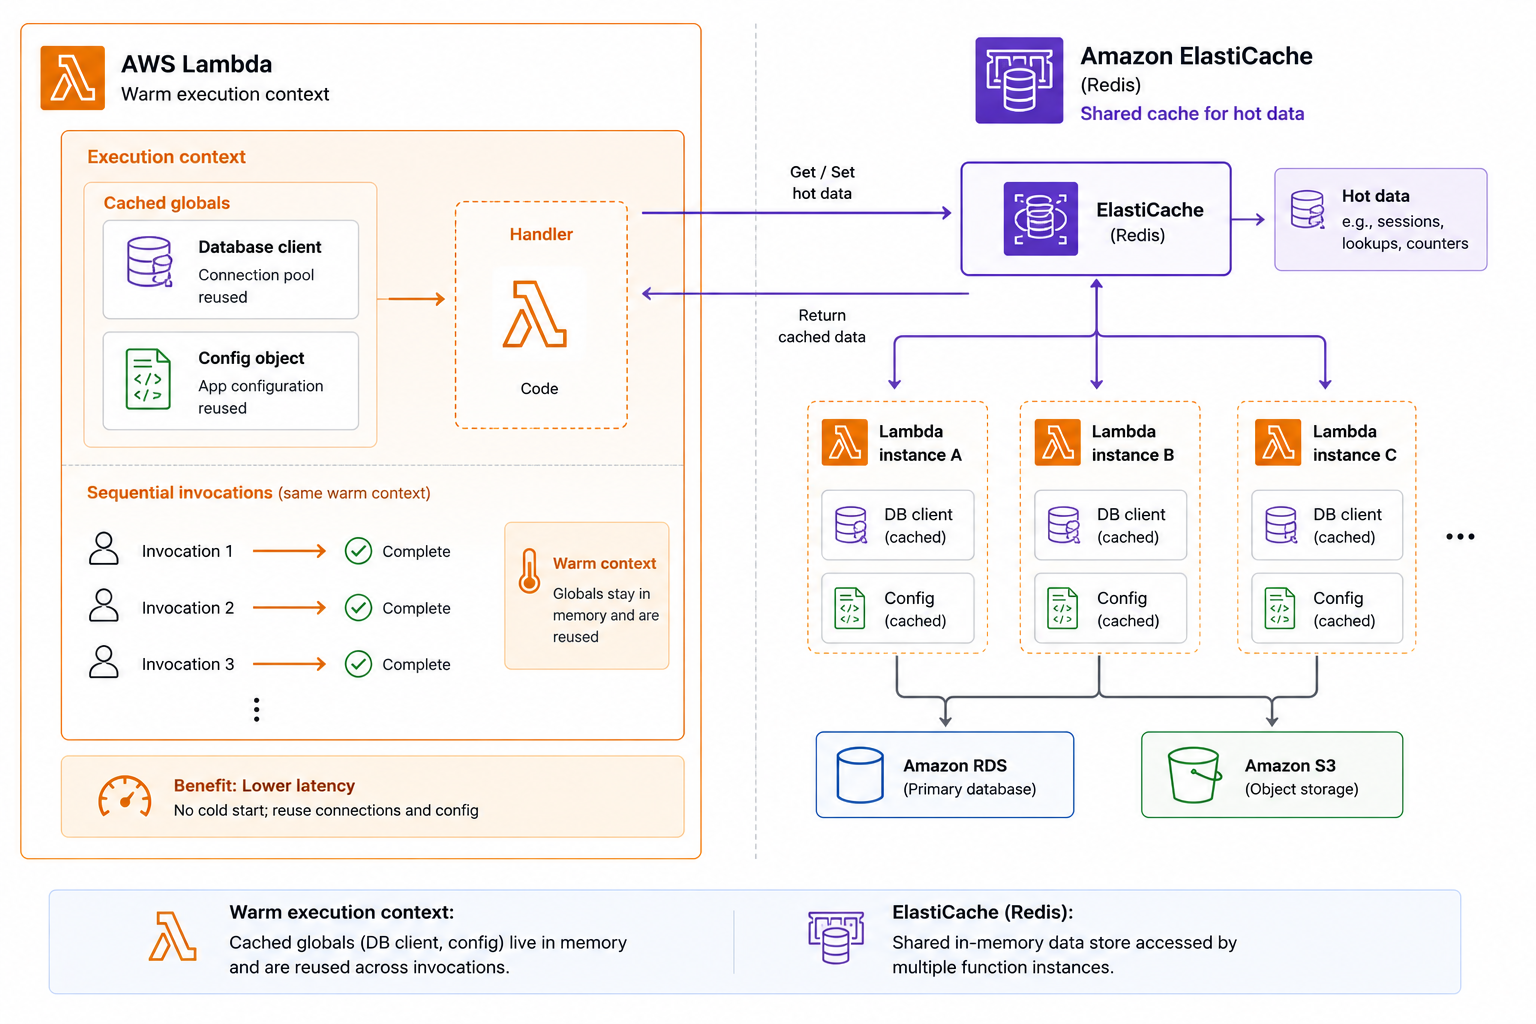
  • Reutilizează lucrul în interiorul contextului de execuție
  • Un Lambda cald păstrează variabilele globale între invocări
  • Memorează în cache configurații, clienți și date frecvente
  • ElastiCache pentru un cache partajat între instanțe

Caching în contextul de execuție Lambda: obiect client global reutilizat la invocări calde și cluster ElastiCache care partajează date frecvente între instanțe

Implementarea aplicațiilor pe AWS

Caching CloudFront la edge

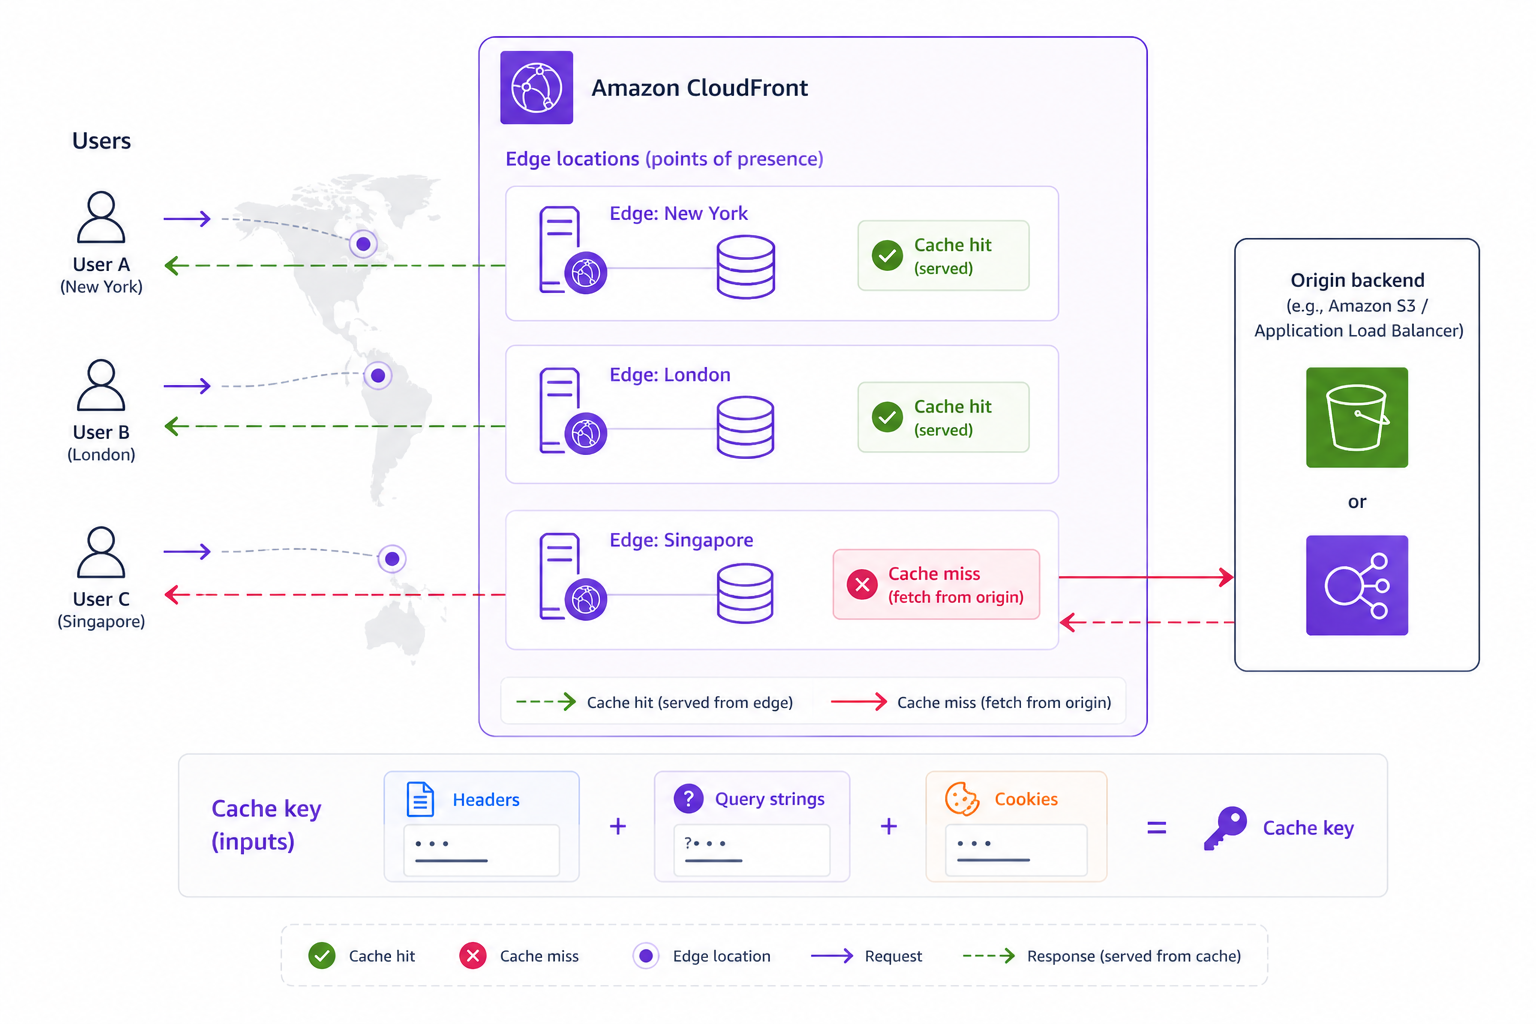
  • CloudFront: memorează răspunsurile în locații edge
  • Servește cererile repetate fără a accesa backend-ul
  • Cheile de cache pot include headere, șiruri de interogare, cookie-uri
  • Conținutul static și memorabil scalează gratuit

Caching edge cu CloudFront: glob cu locații edge care servesc răspunsuri memorate utilizatorilor apropiați, fără a accesa backend-ul, cu configurare chei de cache pentru headere și șiruri de interogare

Implementarea aplicațiilor pe AWS

Alegerea nivelului potrivit de cache

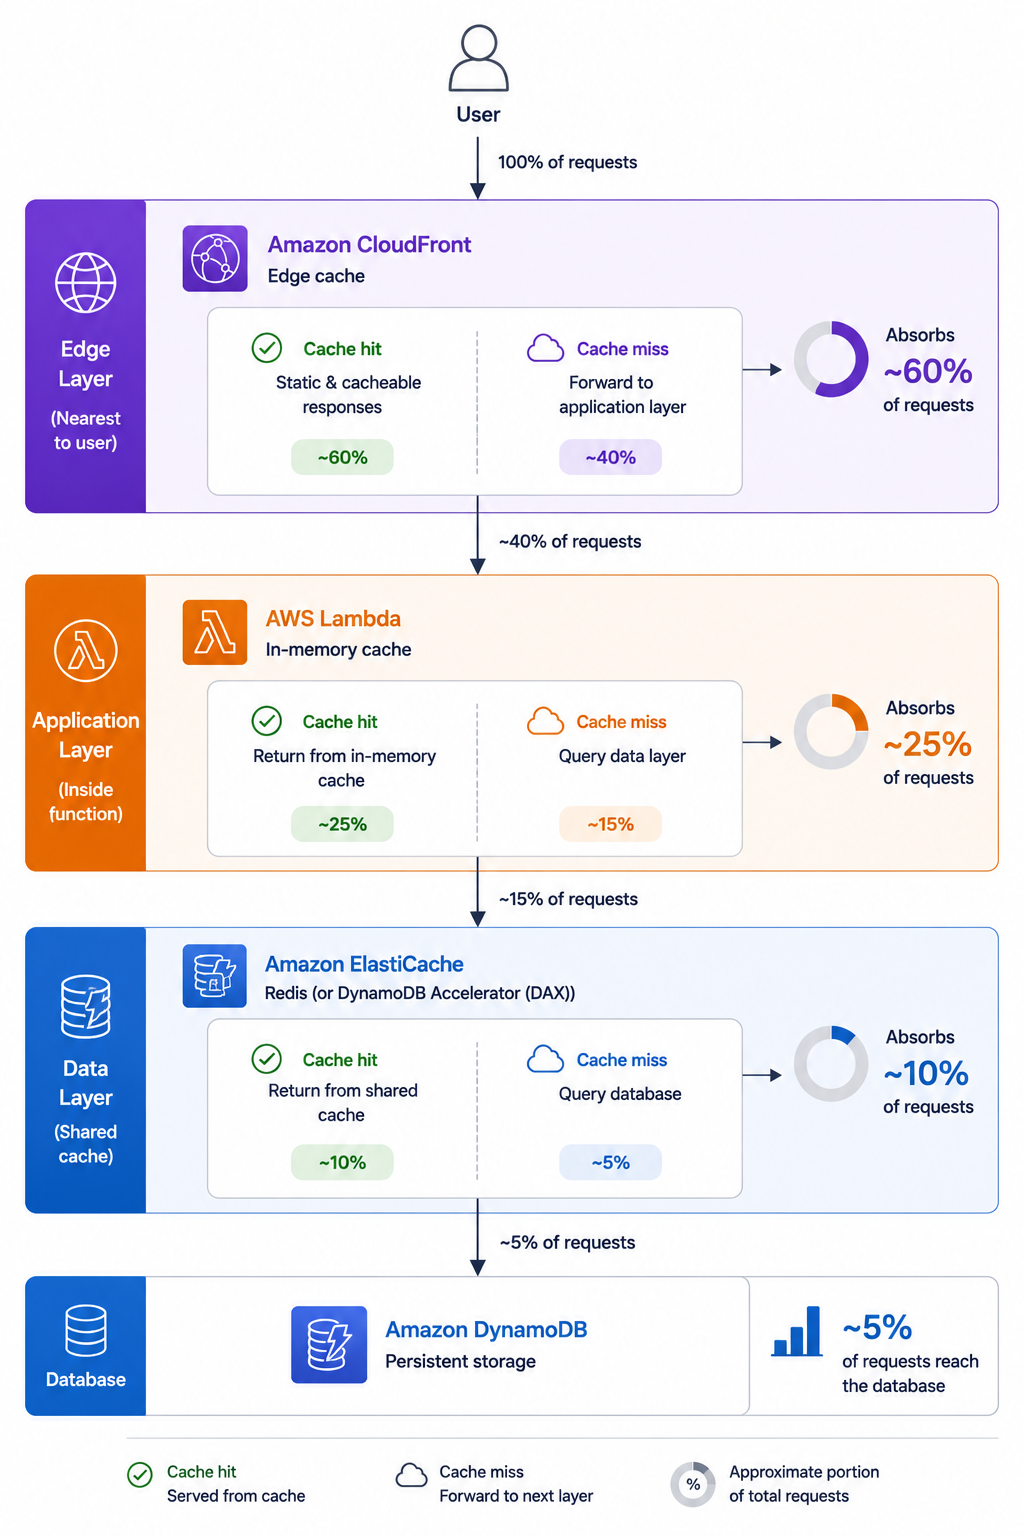
Trei niveluri de cache suprapuse: CloudFront la edge pentru conținut static partajat, cache în memorie per instanță pentru obiecte frecvente și ElastiCache sau DAX pentru citiri partajate cu frecvență ridicată

  • Edge (CloudFront): conținut static, partajat pe scară largă
  • Aplicație (în memorie): obiecte frecvente per instanță
  • Date (ElastiCache/DAX): citiri frecvente partajate
  • Folosește-le în straturi; fiecare reduce alt tip de cost
Implementarea aplicațiilor pe AWS

Optimizarea în ansamblu

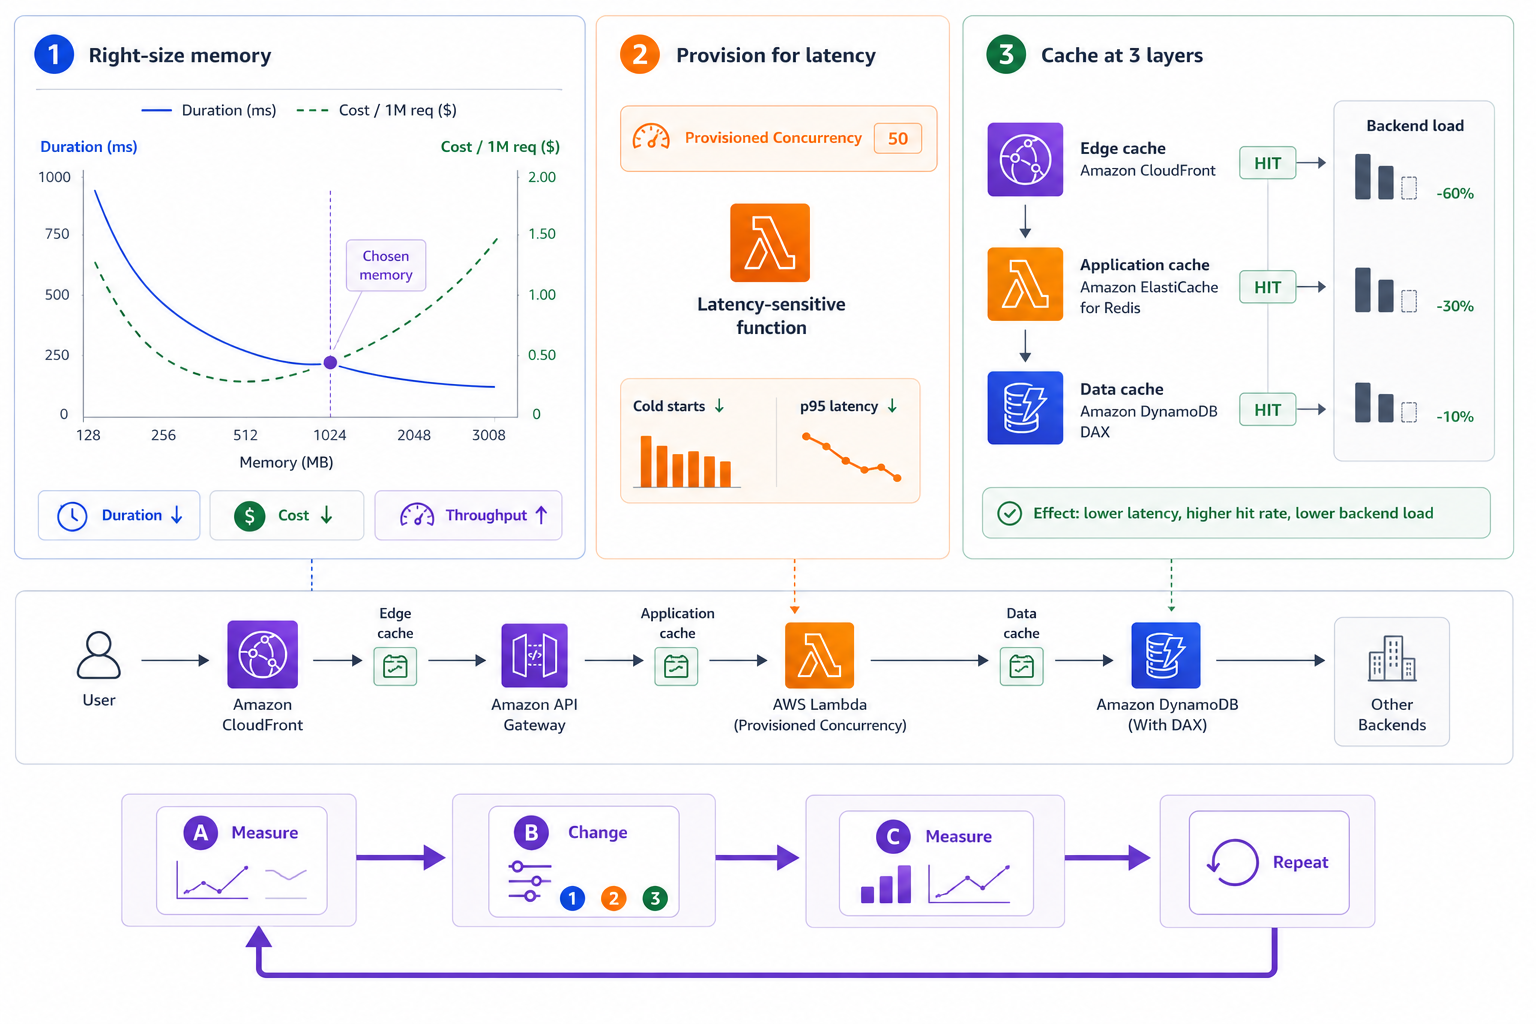
  • Dimensionează memoria cu curba durată-cost
  • Adaugă concurență provizionată doar unde latența contează
  • Memorează în cache la nivelurile edge, aplicație și date
  • Măsoară, schimbă un singur lucru, măsoară din nou

Rezumat optimizare: curbă durată-cost pentru dimensionarea memoriei, decizie concurență provizionată, diagrama celor trei niveluri de cache și ciclul de iterație măsoară-schimbă-măsoară

Implementarea aplicațiilor pe AWS

Hai să exersăm!

Implementarea aplicațiilor pe AWS

Preparing Video For Download...