Coordinación de servicios y gestión del estado
Desarrollo de aplicaciones en AWS
Ricardo Sueiras
Principal Technologist
Coordinación de servicios
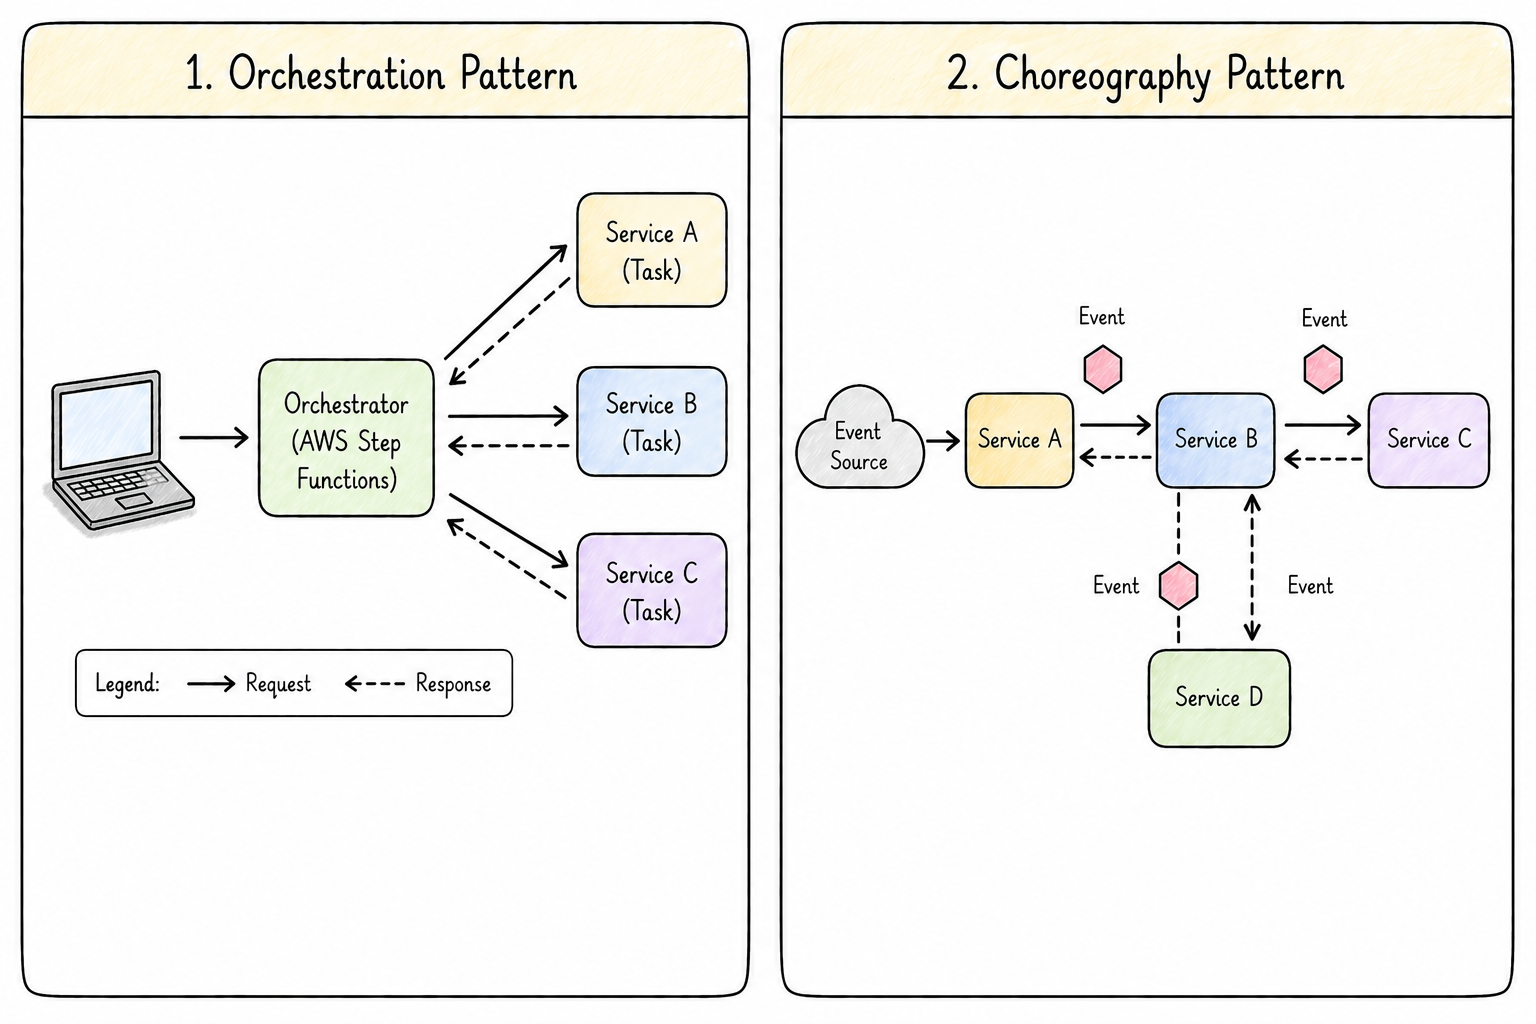
Varios servicios deben colaborar para completar un flujo de trabajo.
Necesitan una estrategia de coordinación.
Dos enfoques: orquestación y coreografía.
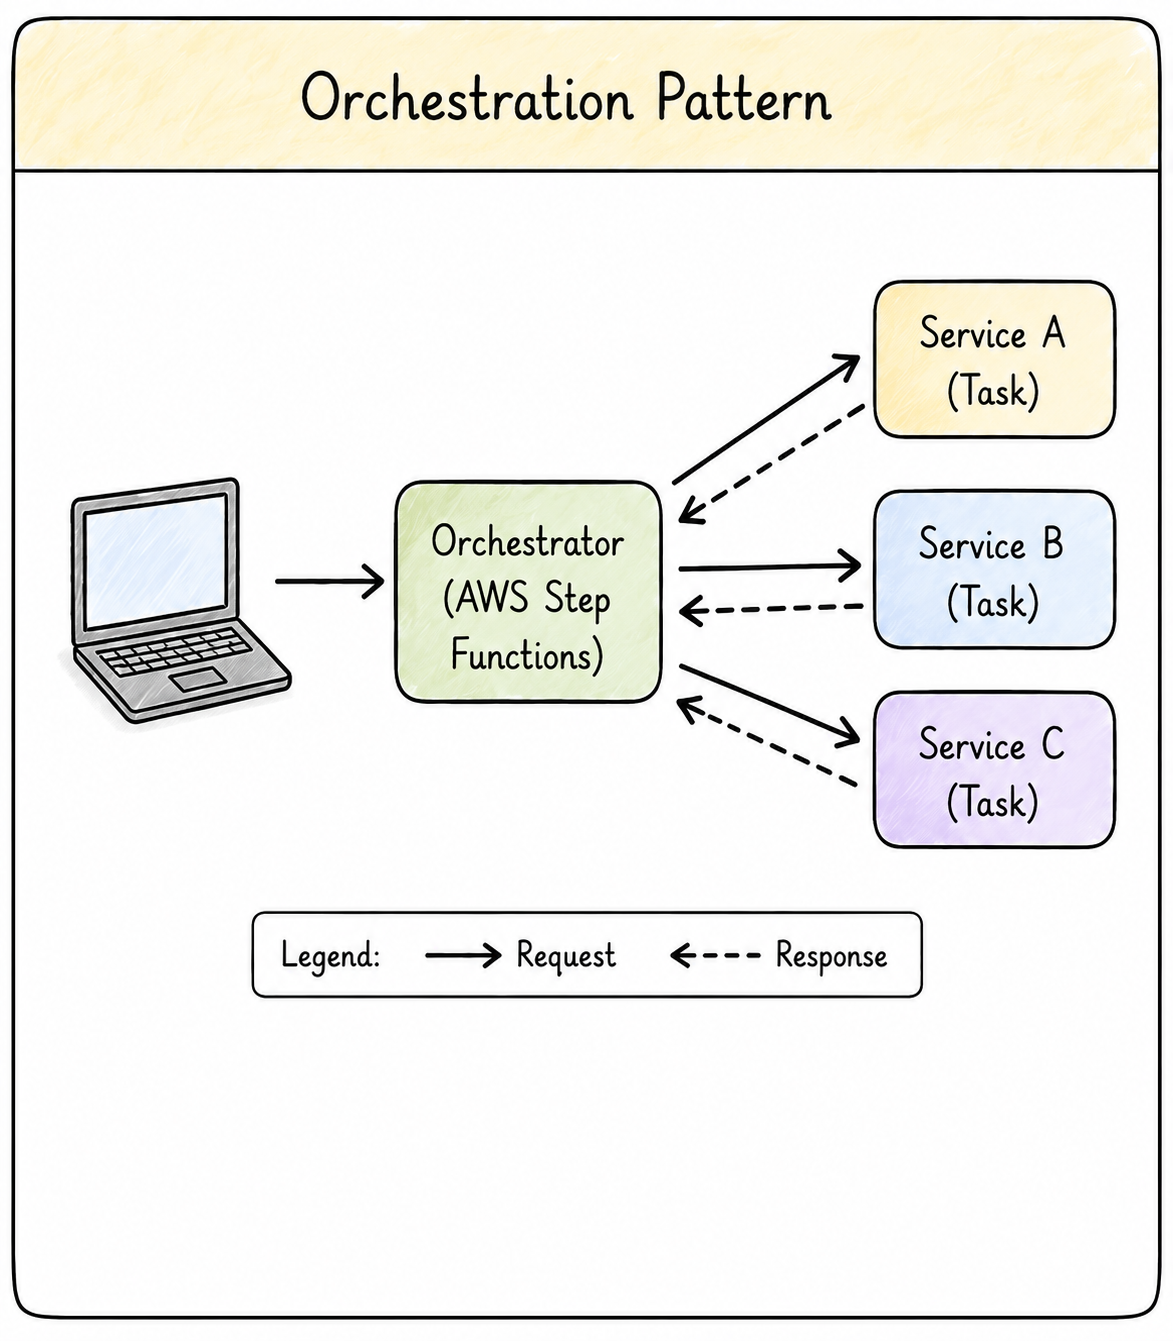
Orquestación
Un orquestador central coordina el flujo.
Controla la secuencia y decide qué servicio va después.
Útil para reintentos, lógica condicional y manejo de errores.
En AWS: se implementa con Step Functions sobre Lambda, ECS, DynamoDB.
Orquestación
La lógica del flujo vive en un único lugar, así que depurar y monitorizar es más fácil.
Contraprestación: introduce una dependencia central.
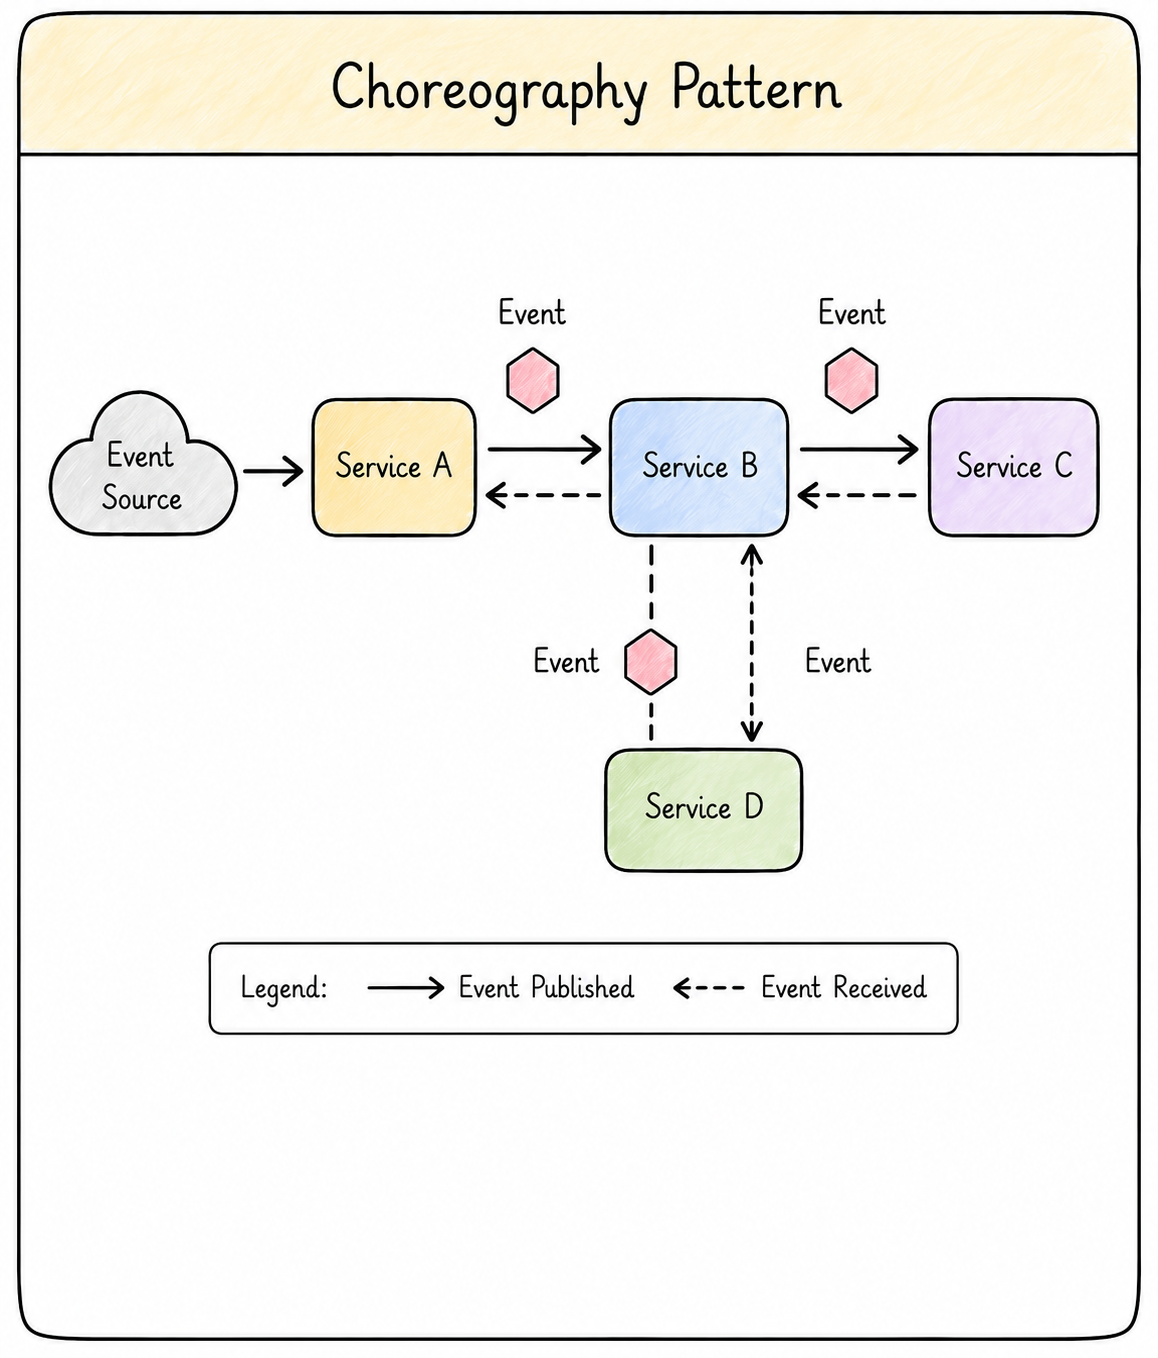
Coreografía
Sin controlador central.
Los servicios reaccionan a eventos de forma independiente.
Cada servicio escucha eventos relevantes y hace su trabajo.
Ningún servicio necesita conocer todo el flujo.
Mejora el acoplamiento débil y la escalabilidad.
Coreografía
En AWS: EventBridge, SNS, SQS.
Altamente escalable.
Contraprestación: más difícil de entender y depurar a medida que crece.
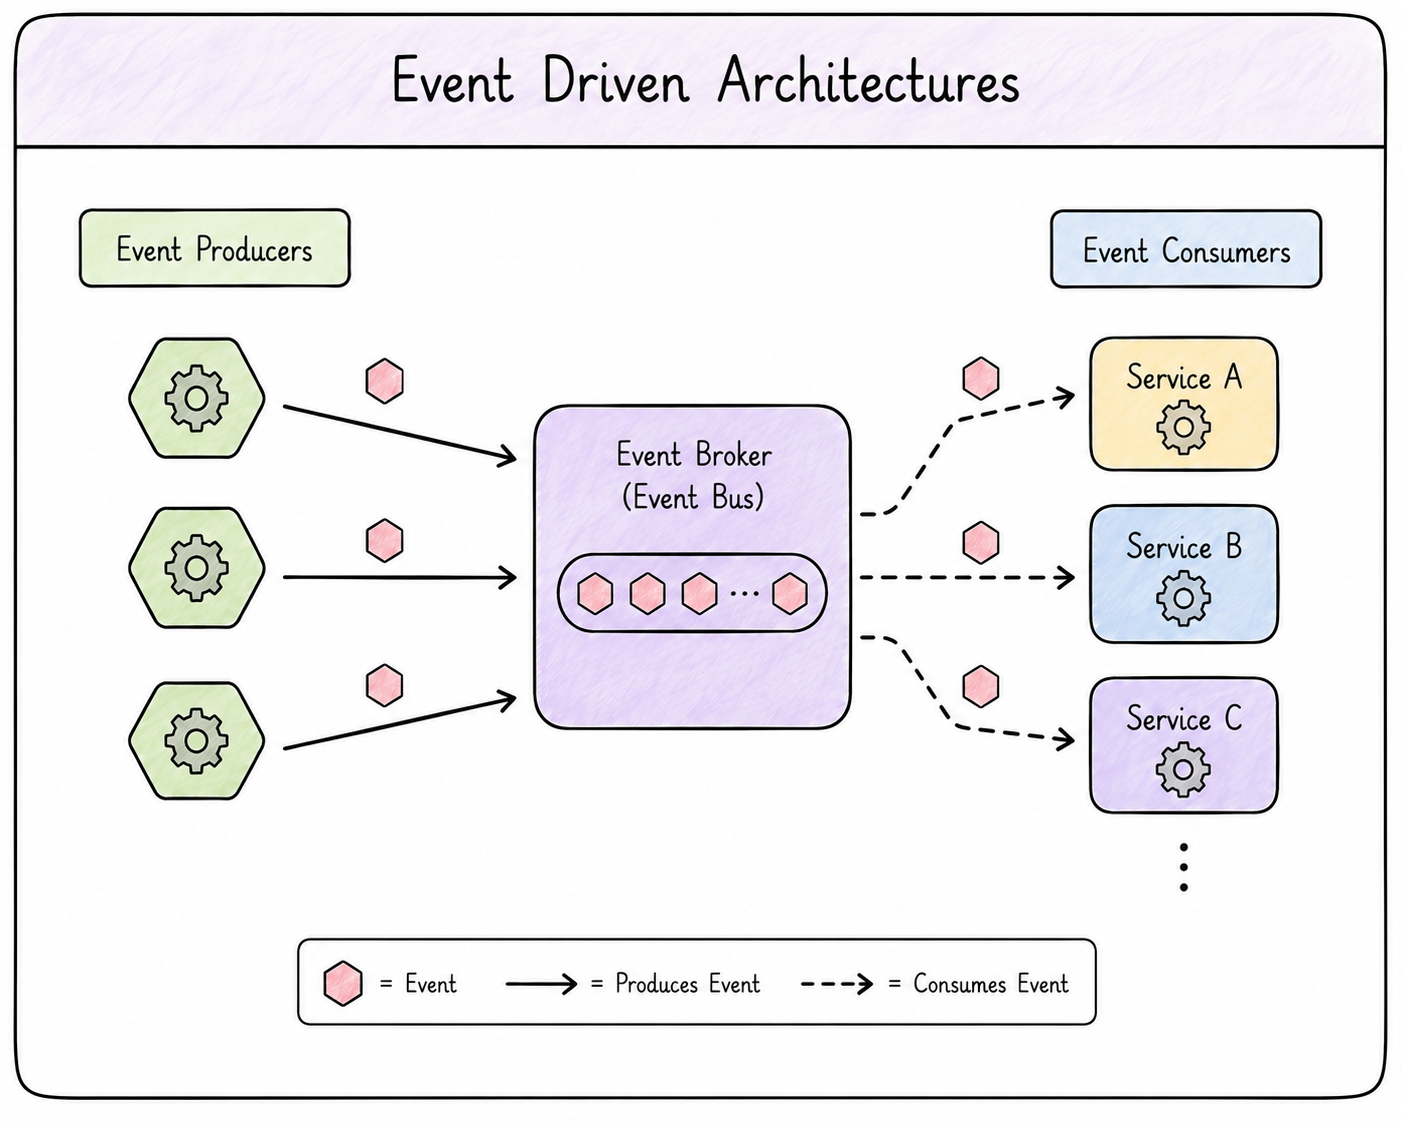
Arquitectura dirigida por eventos
Los servicios se comunican produciendo y consumiendo eventos.
Favorece el acoplamiento débil entre servicios.
Favorece alta escalabilidad.
Permite procesar eventos en paralelo.
Nuevos servicios pueden suscribirse sin modificar los existentes.
Arquitectura dirigida por eventos
Contraprestaciones al implementar EDA:
Diseñar para consistencia eventual.
Implementar idempotencia.
El manejo de fallos es más complejo.
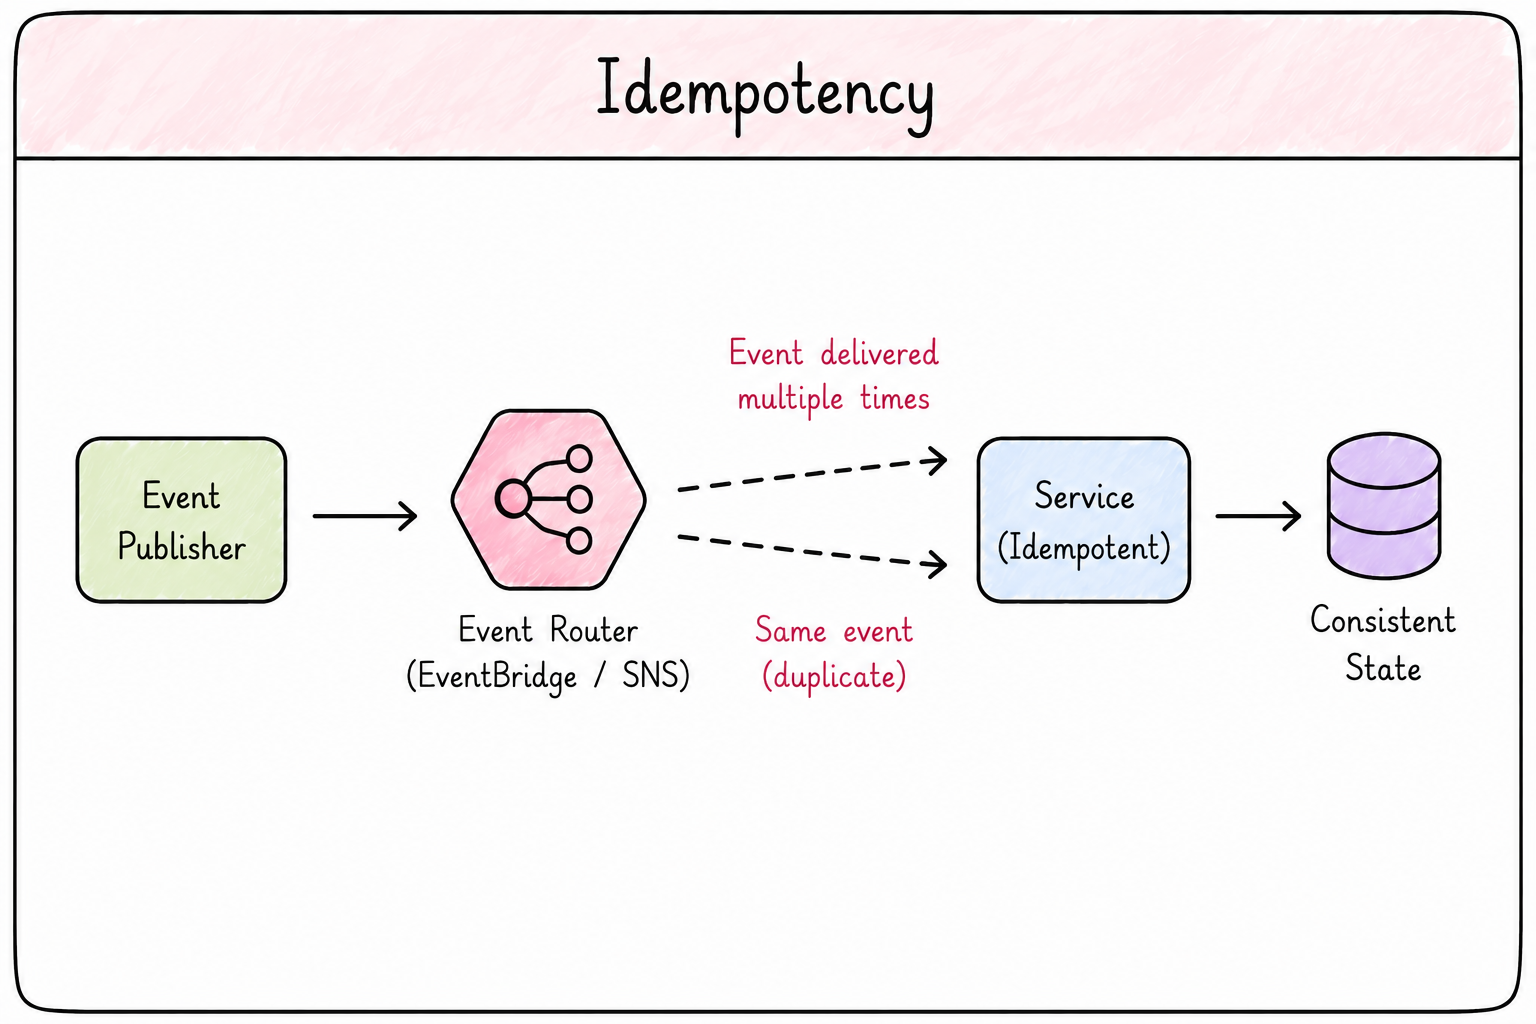
Idempotencia
La misma operación ejecutada varias veces produce el mismo resultado.
Principio clave en sistemas asíncronos y dirigidos por eventos.
Los sistemas distribuidos pueden entregar eventos duplicados (reintentos, fallos de red, reprocesos).
Conserva la corrección y fiabilidad del sistema.
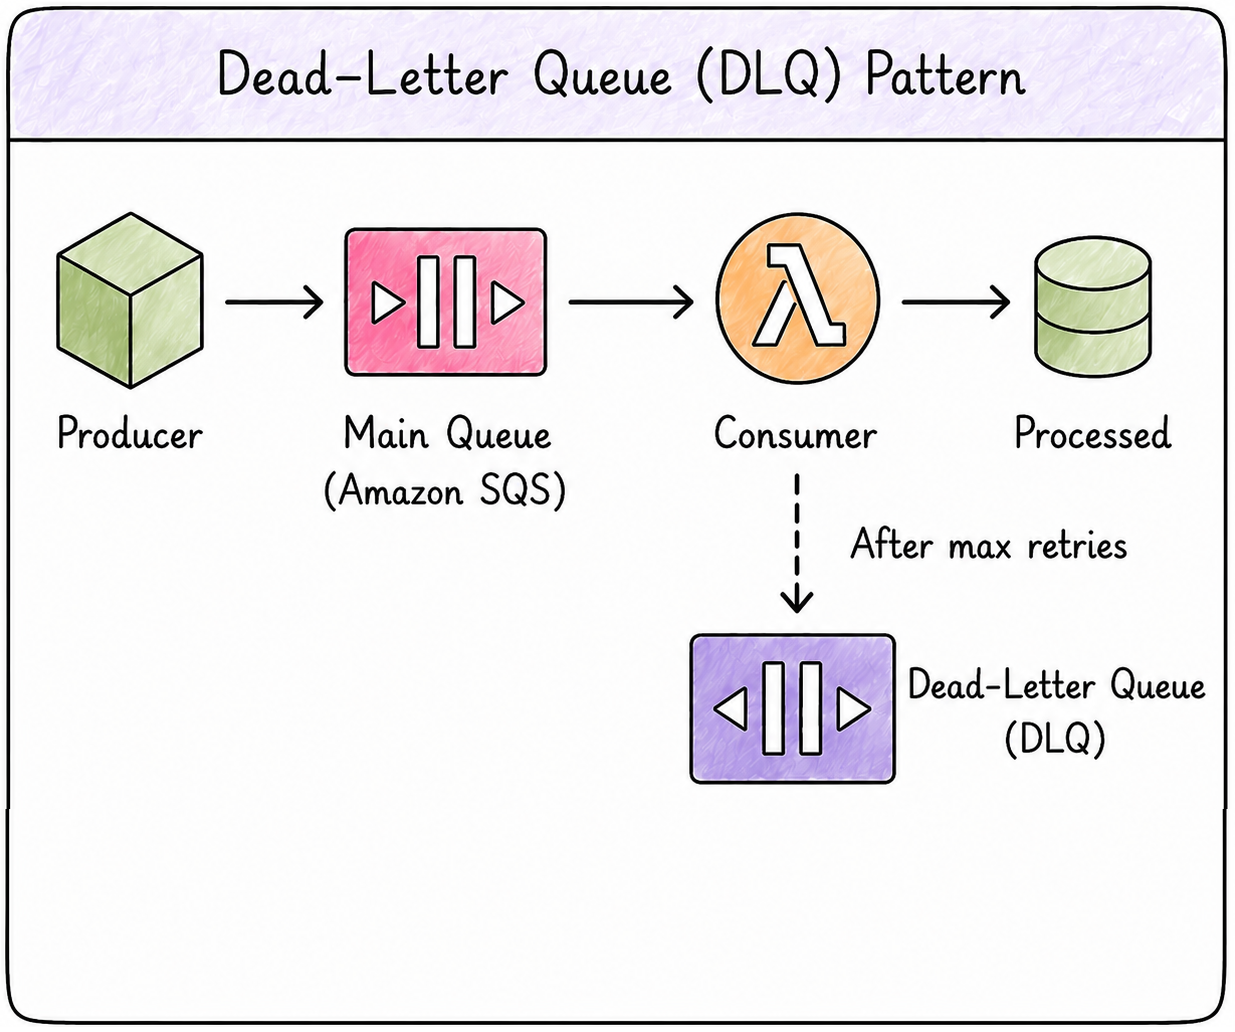
Colas de mensajes muertos (DLQ)
Gestiona fallos en comunicación asíncrona.
Aísla mensajes problemáticos «venenosos».
Tras varios reintentos fallidos, el mensaje pasa a la DLQ.
El flujo principal sigue funcionando.
Colas de mensajes muertos (DLQ)
Úsalas cuando el orden de mensajes no sea crítico.
Omítelas en sistemas no críticos donde se acepte alguna pérdida de datos.
Evítalas cuando deba preservarse el orden de mensajes.
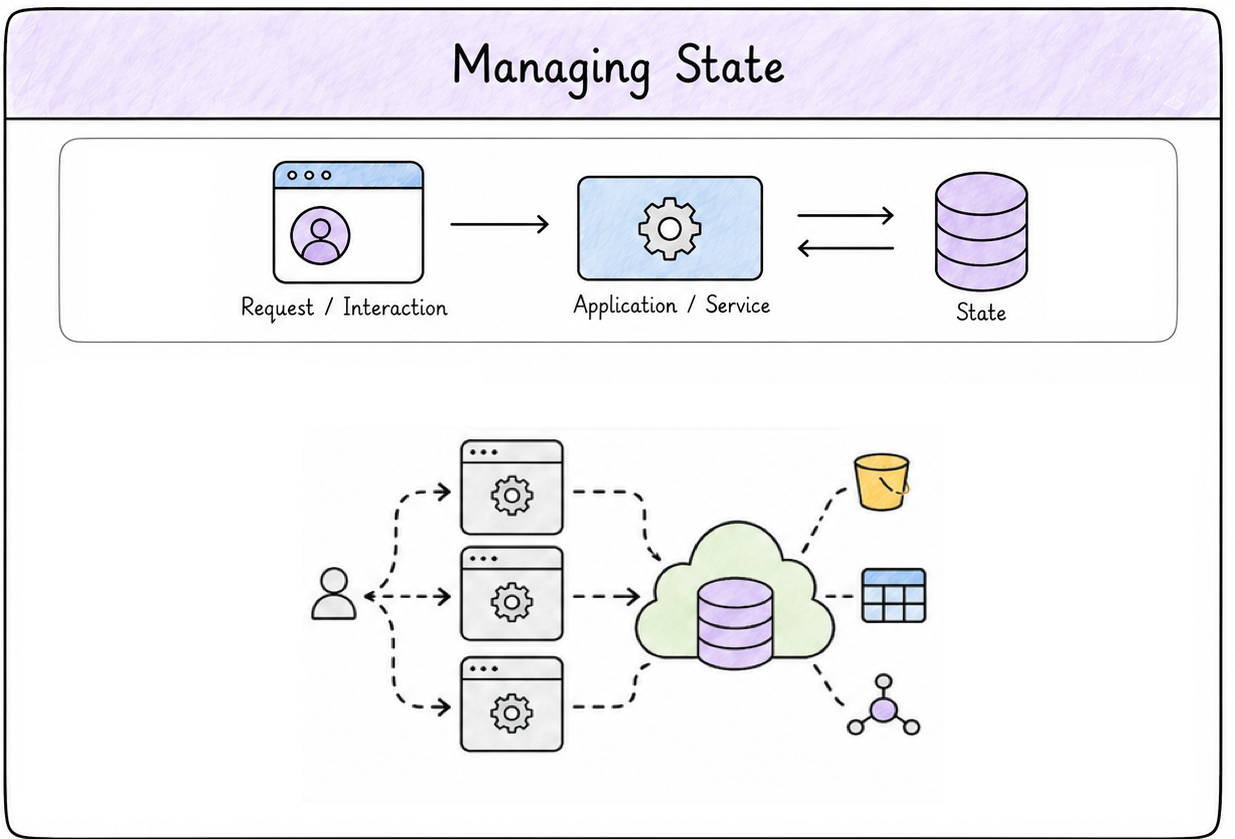
Gestión del estado
Gestionar el estado es fundamental en apps nativas en la nube.
Estado es cualquier dato que persiste entre interacciones.
Guardar estado local en el servidor limita escalabilidad y resiliencia.
Gestión del estado
Gestionar el estado implica decisiones según lo que construyas.
Estado externo mejora escalabilidad y resiliencia.
Costes: más latencia y complejidad.
A considerar: consistencia, caché y patrones de acceso a datos.
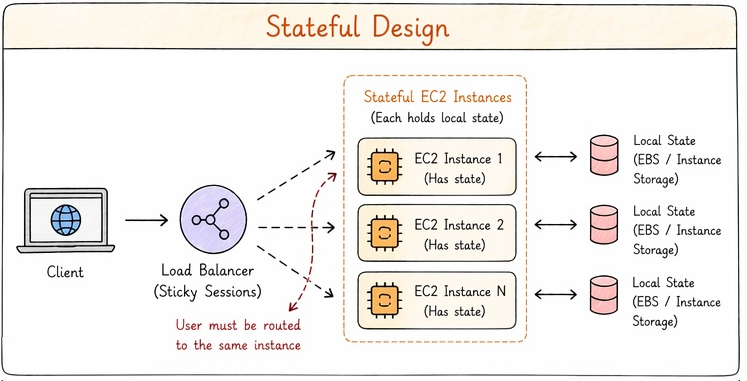
Con estado (stateful)
Los datos de sesión se mantienen en el servidor.
Las peticiones deben ir a la misma instancia (sesiones pegajosas).
Limita la flexibilidad de escalado.
Si falla la instancia, se pierde la sesión.
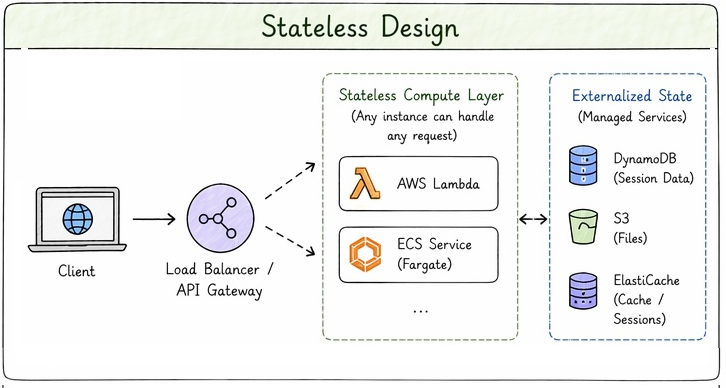
Sin estado (stateless)
Cada petición se trata de forma independiente.
No se guarda estado en el servidor.
El estado vive en sistemas externos.
Enfoque preferido para apps nativas en la nube.
Cualquier instancia puede manejar cualquier petición; escalar horizontalmente es sencillo.
¡Vamos a practicar!
Desarrollo de aplicaciones en AWS
Preparing Video For Download...