Coordinare i servizi e gestire lo stato
Sviluppare applicazioni su AWS
Ricardo Sueiras
Principal Technologist
Coordinamento dei servizi
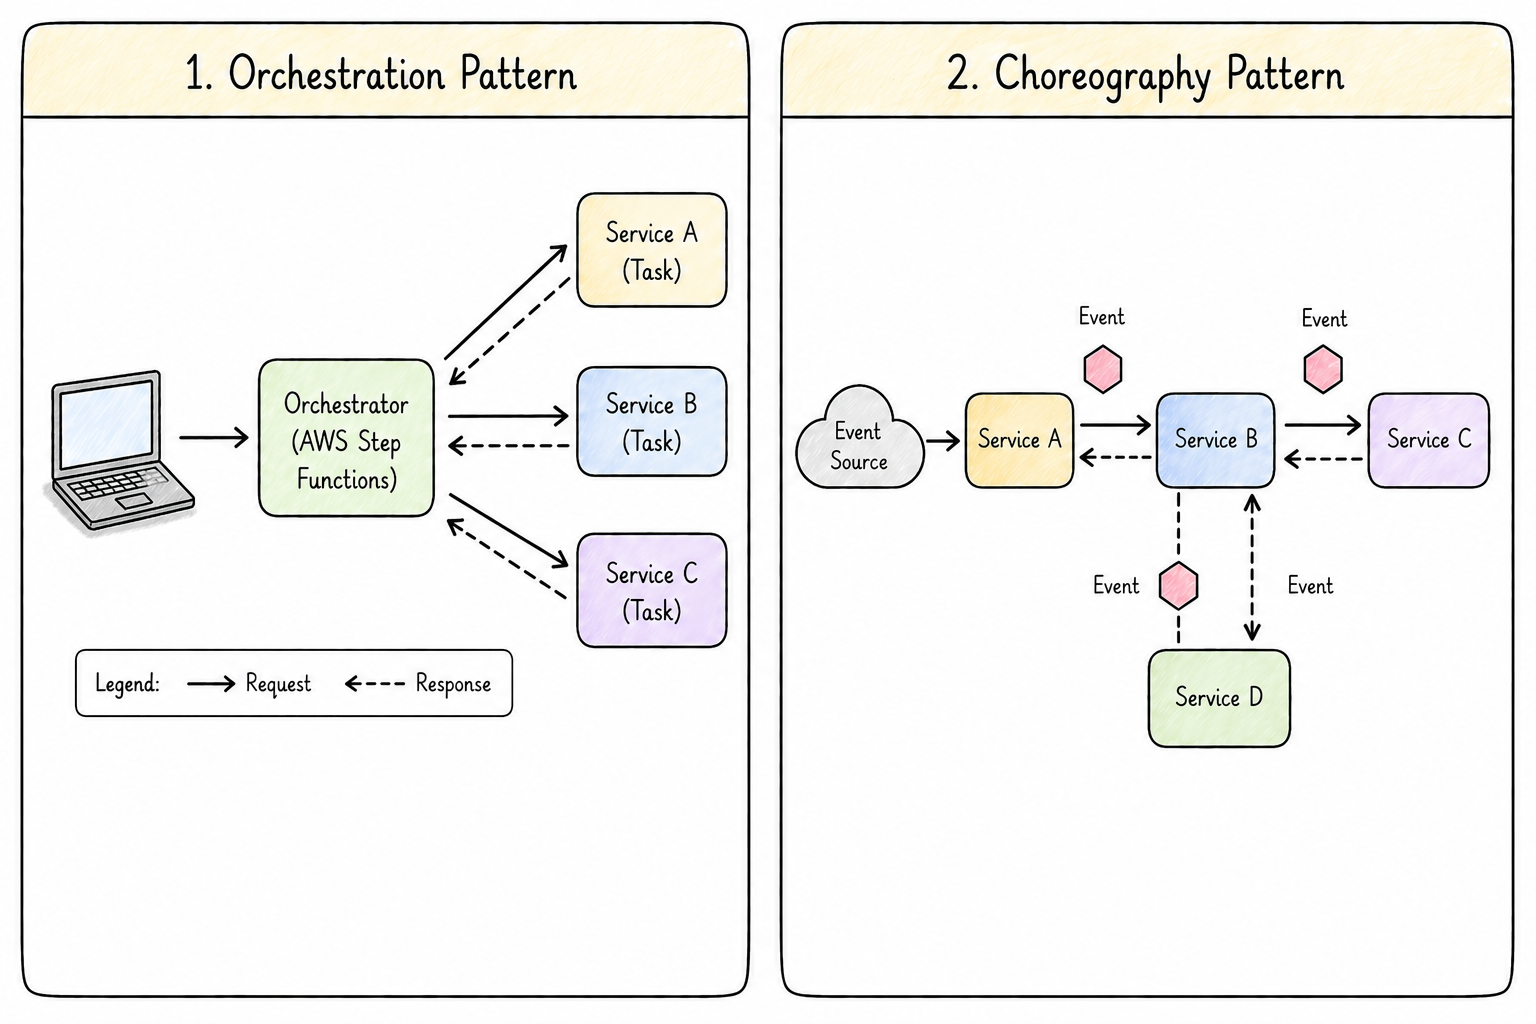
Più servizi devono collaborare per completare un workflow.
Serve una strategia di coordinamento.
Due approcci: orchestrazione e coreografia.
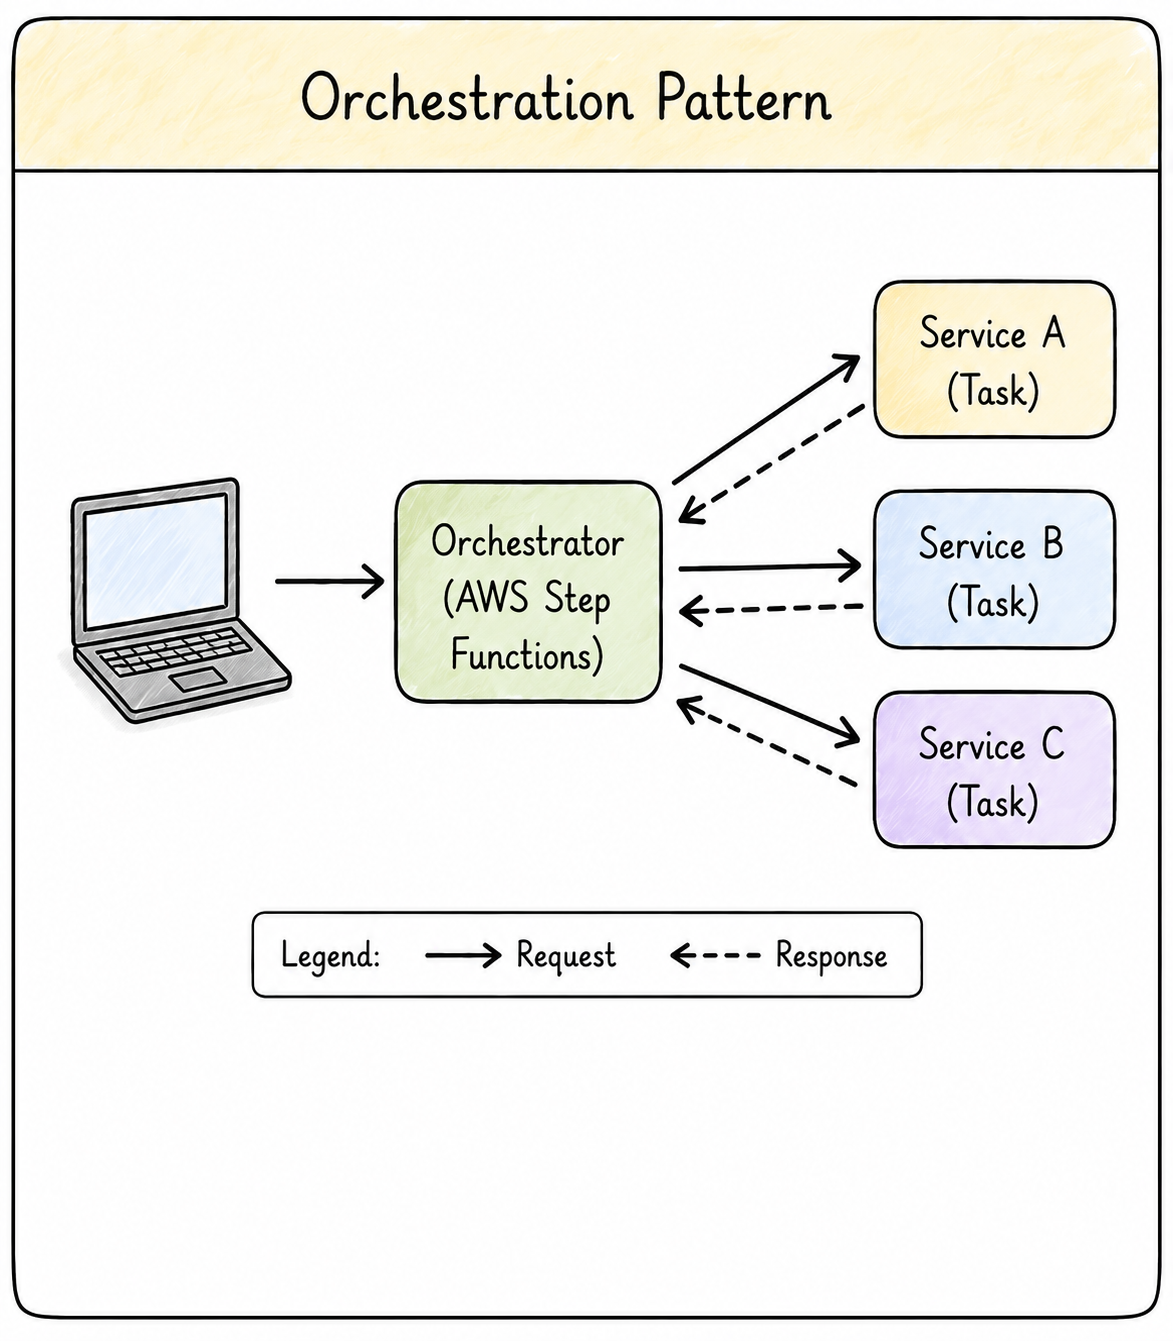
Orchestrazione
Un orchestratore centrale coordina il workflow.
L'orchestratore controlla la sequenza e decide quale servizio esegue dopo.
Utile per retry, logica condizionale e gestione errori.
Su AWS: implementato con Step Functions su Lambda, ECS, DynamoDB.
Orchestrazione
La logica del workflow vive in un solo punto: debug e monitoraggio più semplici.
Compromesso: introduce una dipendenza centrale.
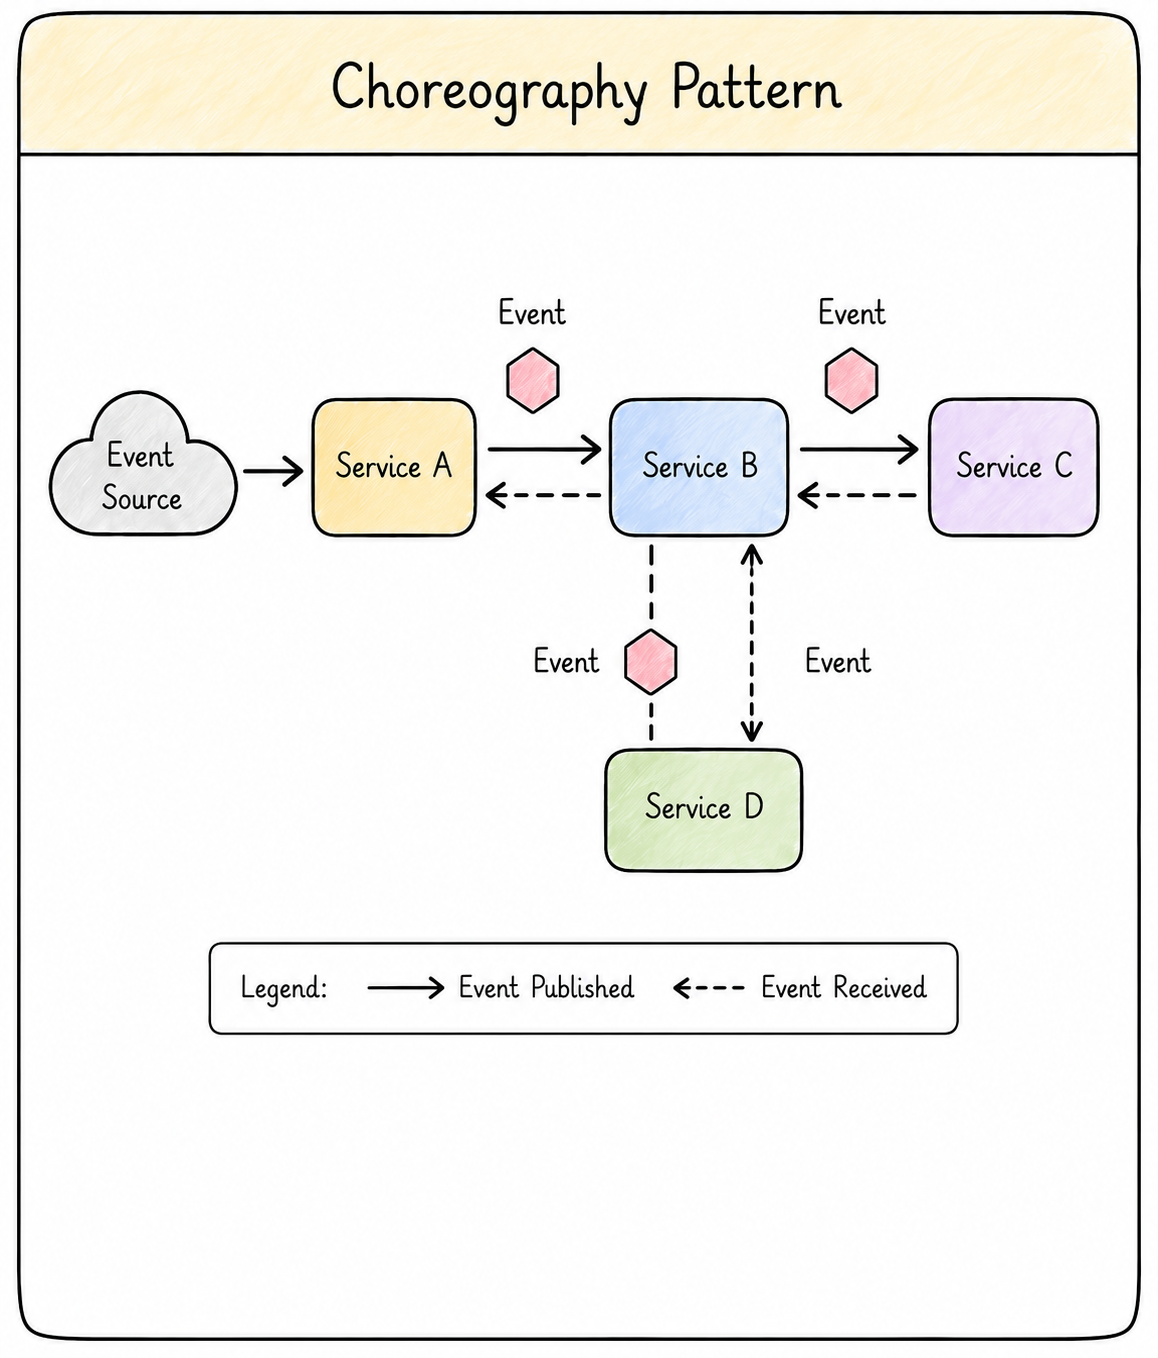
Coreografia
Nessun controller centrale.
I servizi reagiscono agli eventi in modo indipendente.
Ogni servizio ascolta gli eventi rilevanti ed esegue il proprio lavoro.
Nessun servizio deve conoscere l'intero workflow.
Migliora il loose coupling e la scalabilità.
Coreografia
Su AWS: EventBridge, SNS, SQS.
Altamente scalabile.
Compromesso: diventa più difficile da comprendere e fare debug con la crescita dei workflow.
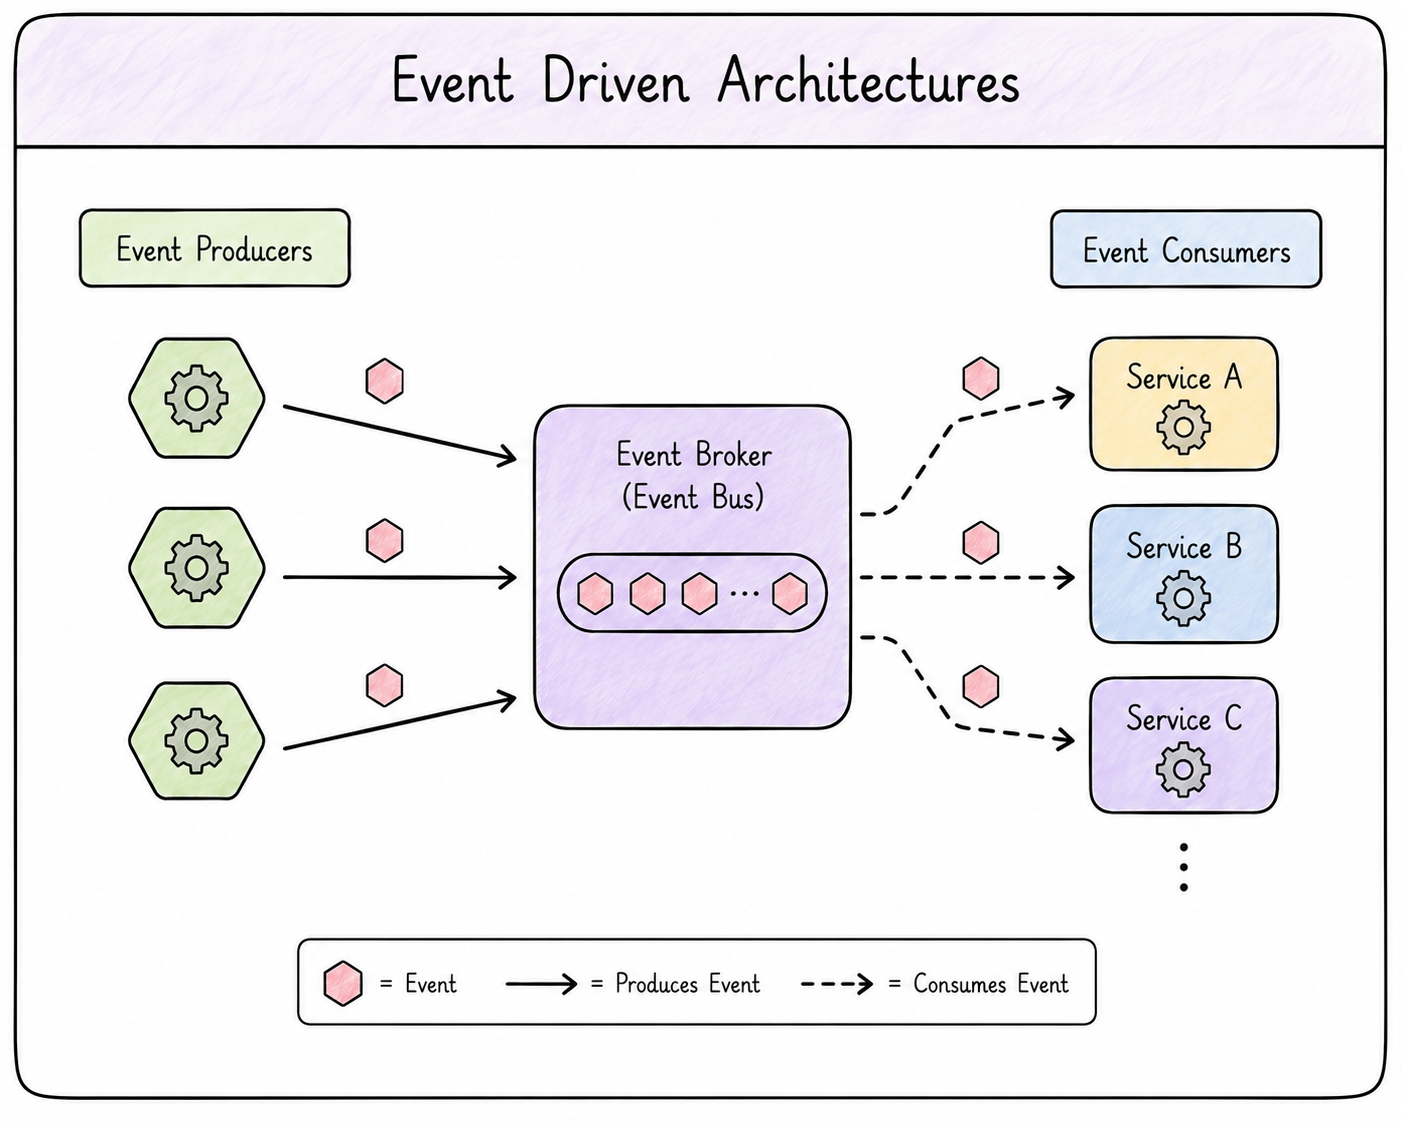
Architettura event-driven
I servizi comunicano producendo e consumando eventi.
Favorisce il loose coupling tra servizi.
Favorisce l'alta scalabilità.
Abilita l'elaborazione parallela degli eventi.
Nuovi servizi possono iscriversi senza modificare quelli esistenti.
Architettura event-driven
Compromessi nell'implementare EDA:
Progetta per la consistenza eventuale.
Implementa l'idempotenza.
La gestione dei guasti è più complessa.
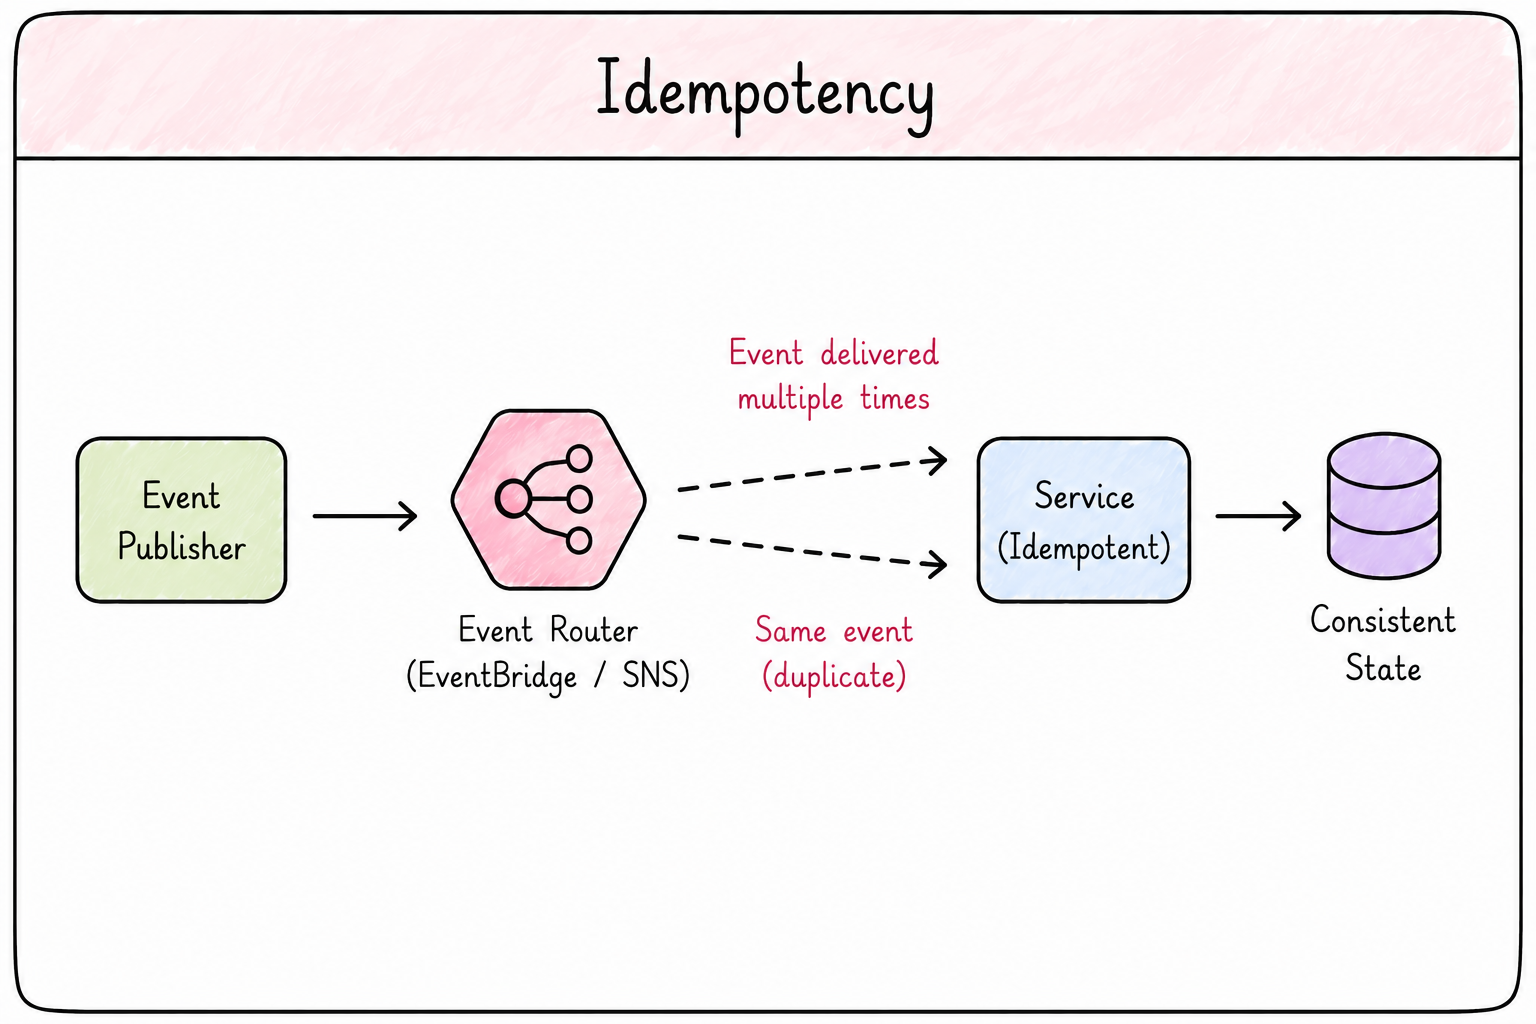
Idempotenza
La stessa operazione eseguita più volte produce lo stesso risultato.
Principio di design critico nei sistemi asincroni ed event-driven.
I sistemi distribuiti possono recapitare eventi duplicati (retry, errori di rete, rielaborazioni).
Preserva correttezza e affidabilità del sistema.
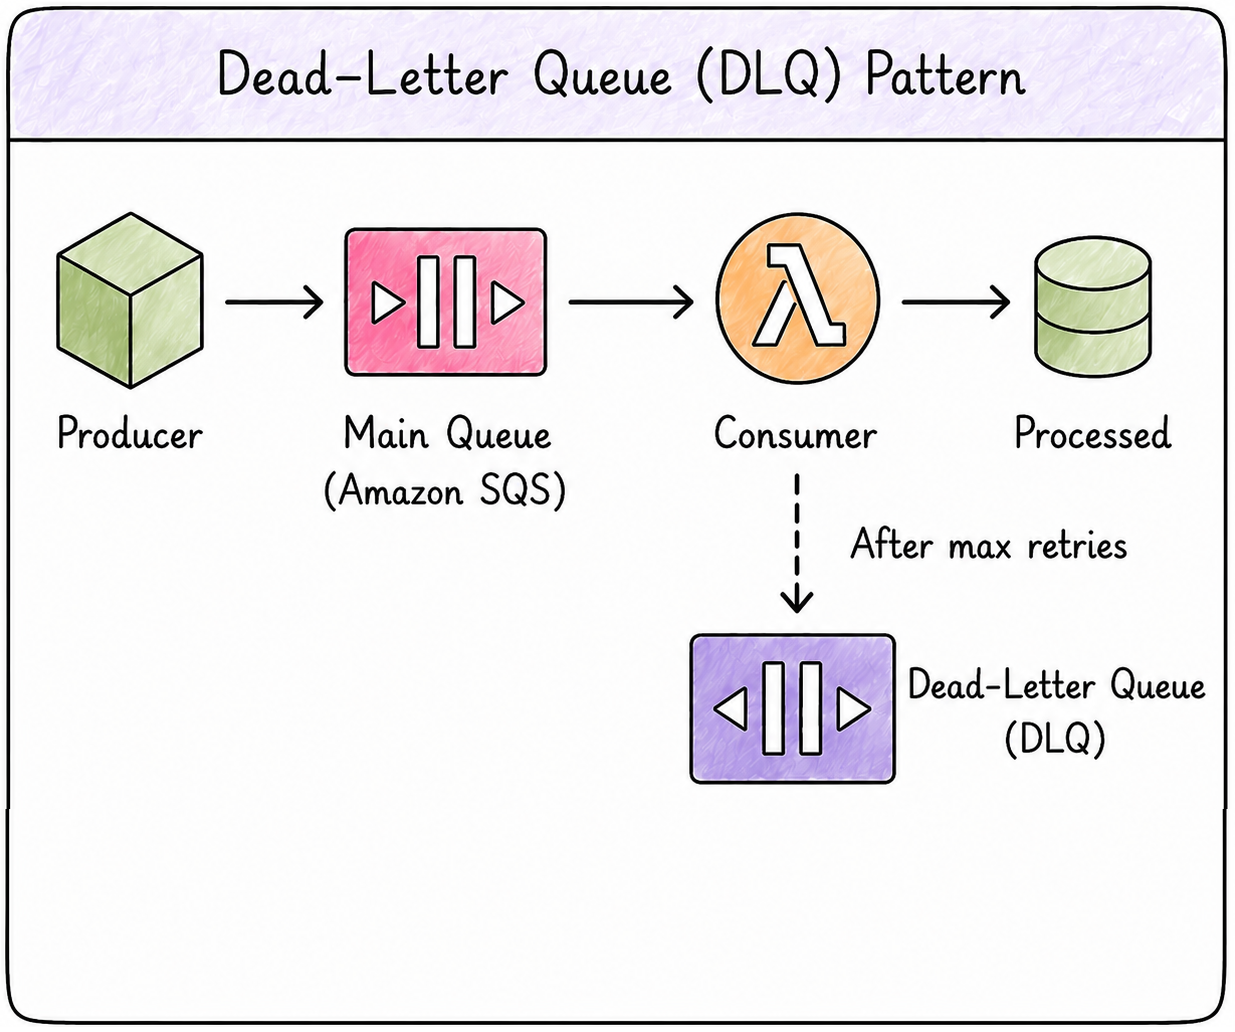
Dead letter queue
Gestisce i guasti nella comunicazione asincrona.
Isola i messaggi "velenosi" problematici.
Dopo ripetuti fallimenti di retry, il messaggio passa alla DLQ.
Il flusso principale continua a funzionare.
Dead letter queue
Usale quando l'ordine dei messaggi non è critico.
Evitale per sistemi non critici dove si accetta una perdita occasionale di dati.
Sconsigliate quando l'ordine dei messaggi va preservato.
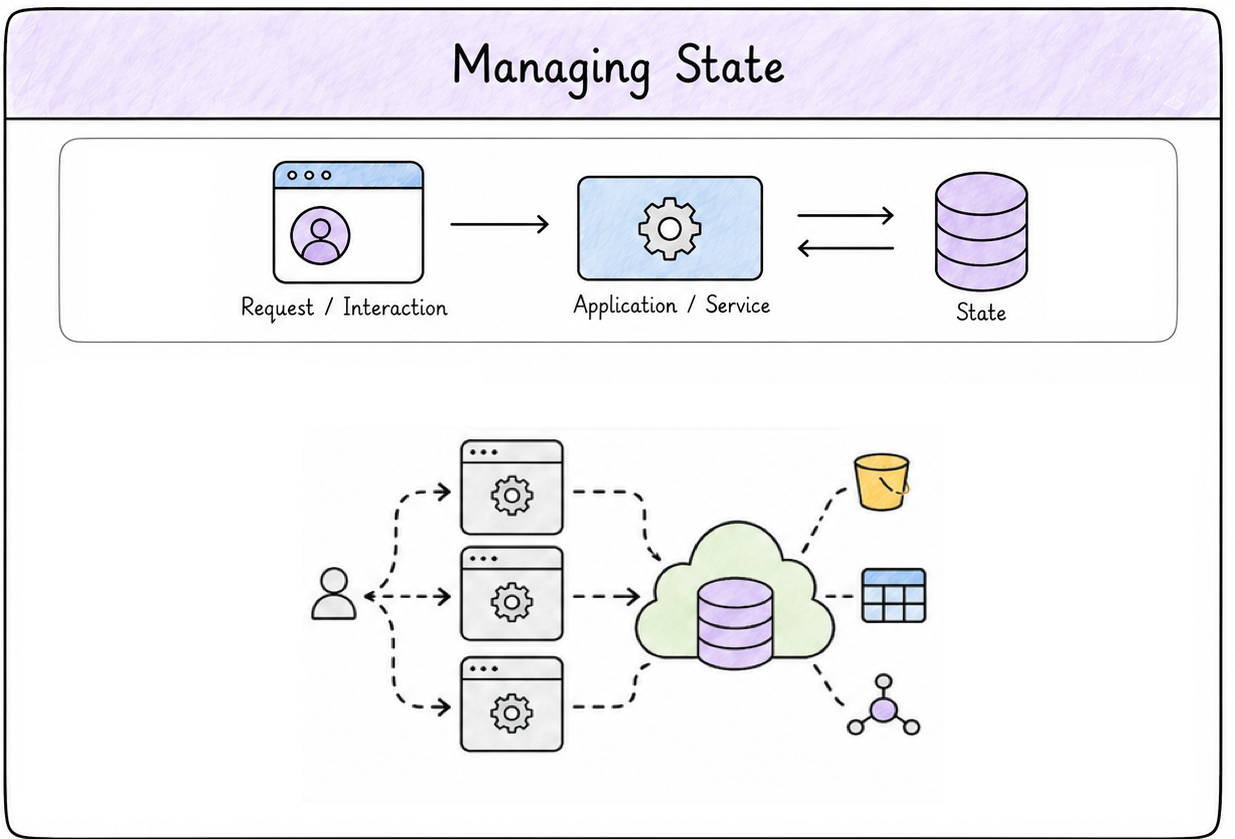
Gestione dello stato
Gestire lo stato è fondamentale per le app cloud native.
Lo stato è qualsiasi dato conservato tra interazioni.
Memorizzare lo stato localmente sul server limita scalabilità e resilienza.
Gestione dello stato
La gestione dello stato comporta compromessi in base a cosa stai costruendo.
Stato esterno migliora scalabilità e resilienza.
Costi: latenza e complessità aggiunte.
Da considerare: consistenza, caching e pattern di accesso ai dati.
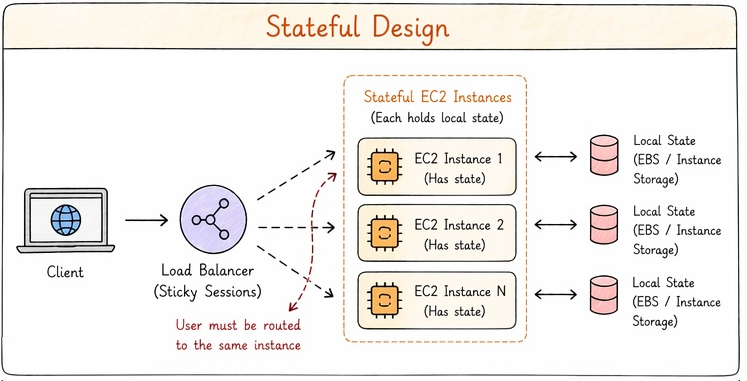
Stateful
I dati di sessione restano sul server.
Le richieste devono andare alla stessa istanza (sticky sessions).
Limita la flessibilità di scaling.
Se l'istanza fallisce, la sessione è persa.
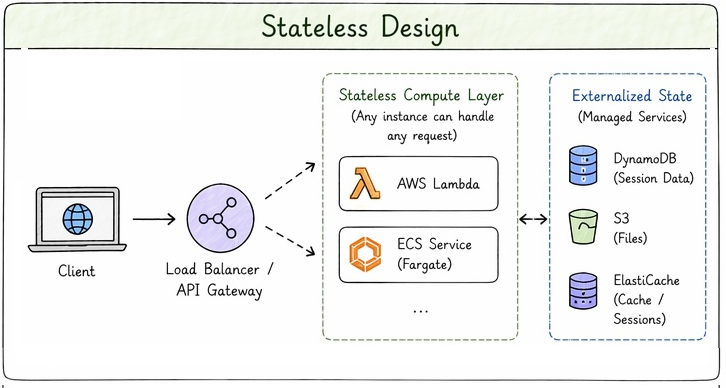
Stateless
Ogni richiesta è trattata in modo indipendente.
Nessuno stato archiviato sul server.
Lo stato vive in sistemi esterni.
Approccio preferito per app cloud native.
Qualsiasi istanza può gestire qualsiasi richiesta: scalabilità orizzontale semplice.
Esercitiamoci!
Sviluppare applicazioni su AWS
Preparing Video For Download...