Concevoir des applications tolérantes aux pannes et résilientes sur AWS
Développer des applications sur AWS
Ricardo Sueiras
Principal Technologist
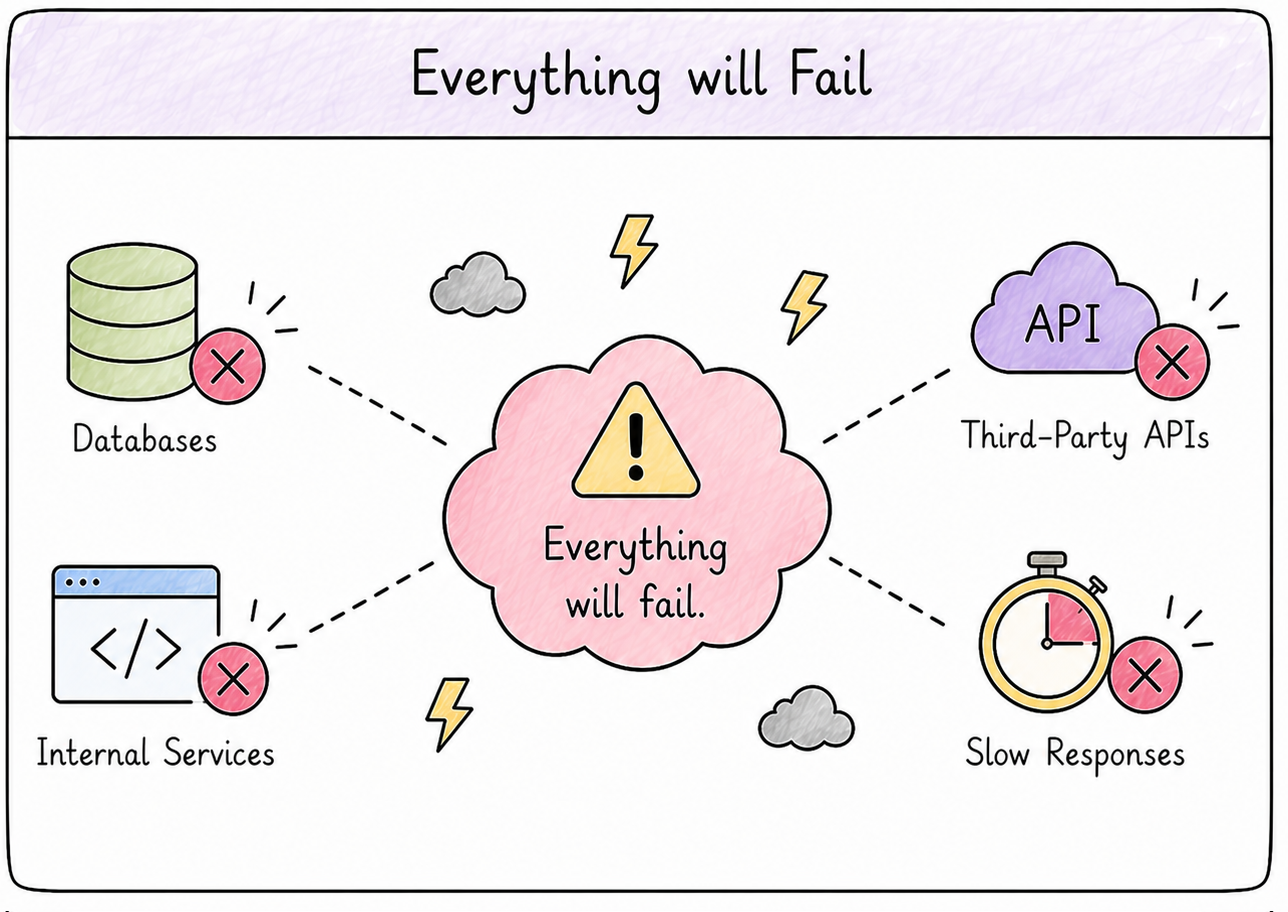
Concevoir pour la résilience
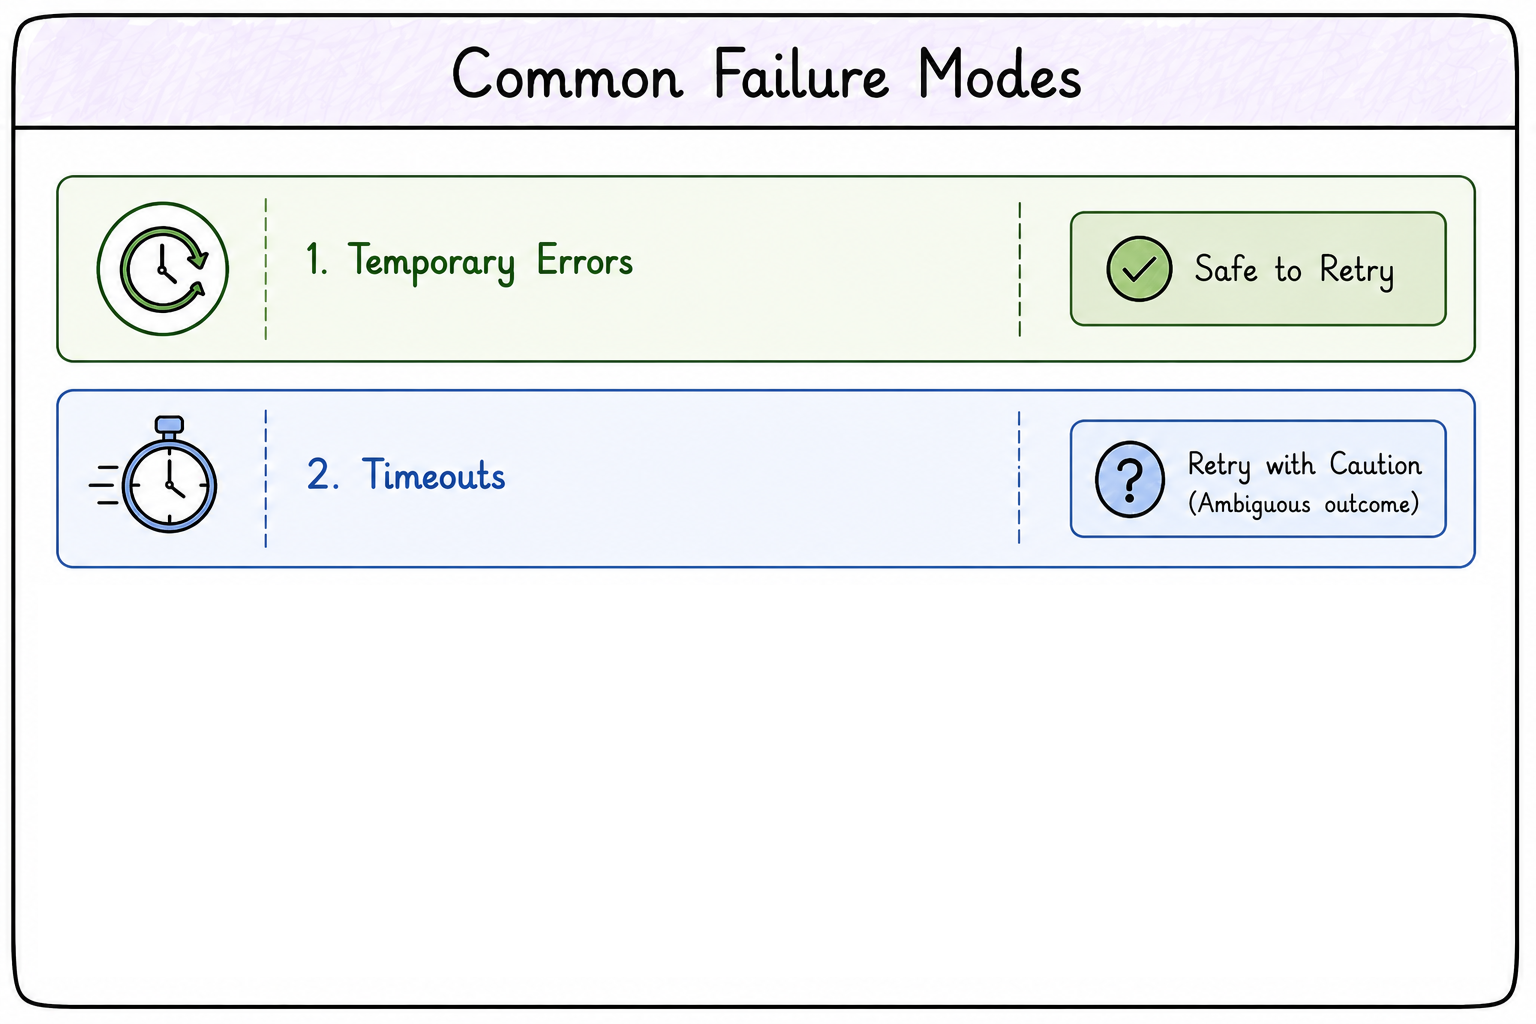
Pannes temporaires
Connaître les modes de panne courants :
Les erreurs temporaires disparaissent d'elles‑mêmes ; le réessai est généralement sûr.
Timeouts
Connaître les modes de panne courants :
Les erreurs temporaires disparaissent d'elles‑mêmes ; le réessai est généralement sûr.
Timeouts : le service externe met trop de temps à répondre.
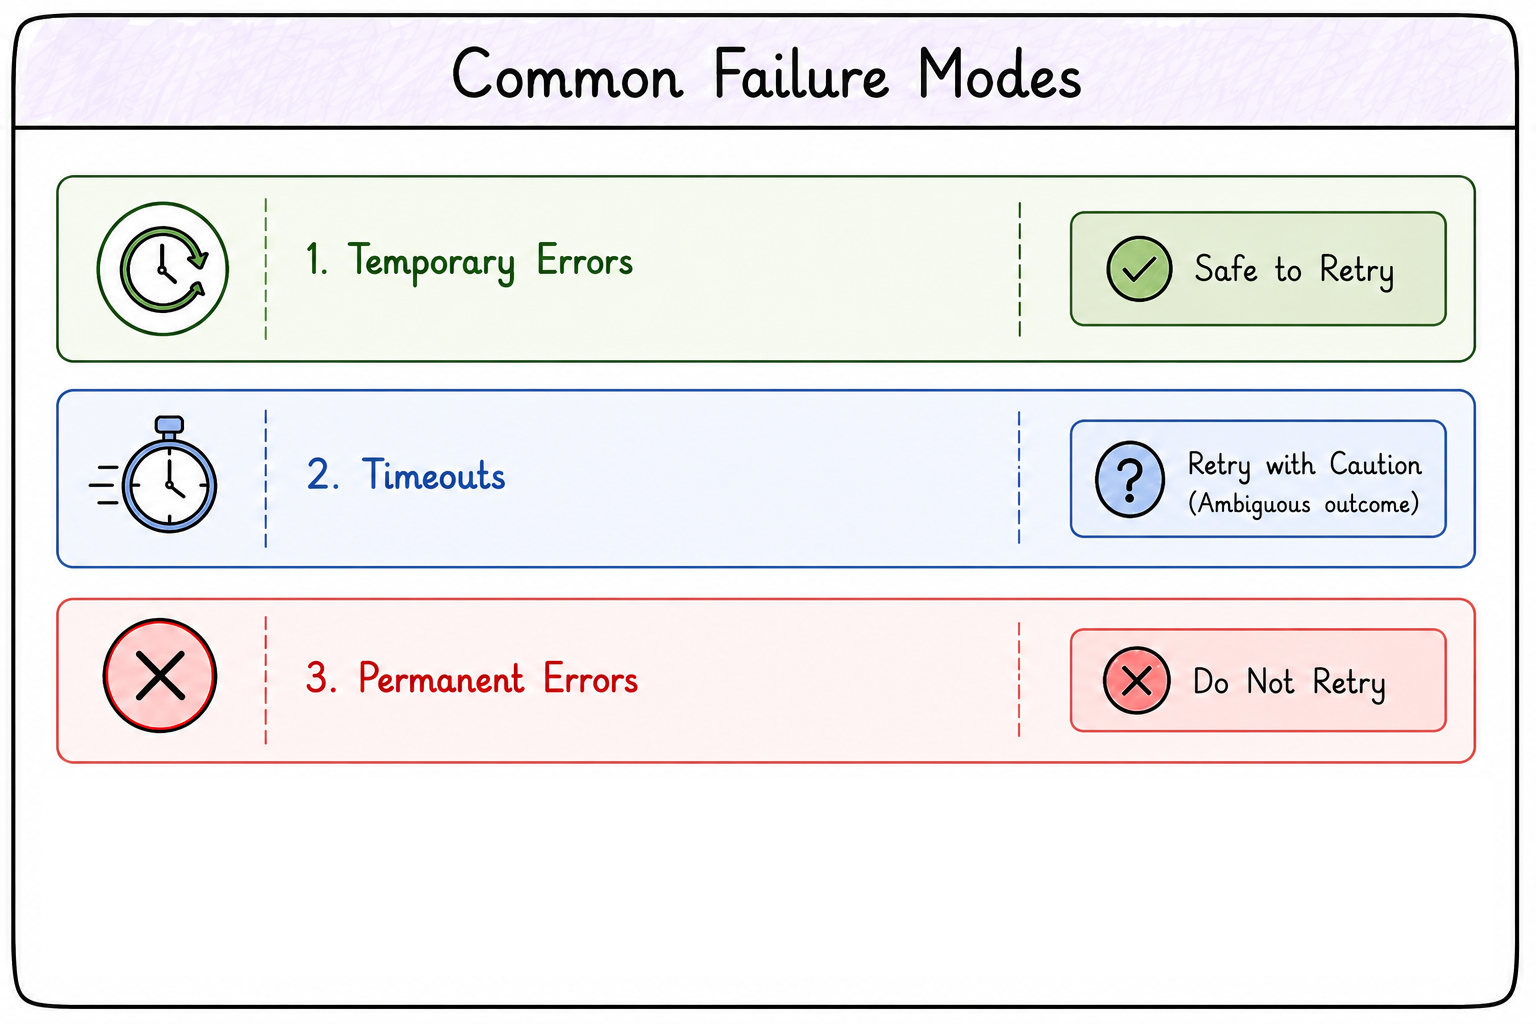
Erreurs permanentes
Connaître les modes de panne courants :
Les erreurs temporaires disparaissent d'elles‑mêmes ; le réessai est généralement sûr.
Timeouts : le service externe met trop de temps à répondre.
Erreurs permanentes : la requête est fondamentalement erronée, réessayer ne sert à rien.
Limites d'API
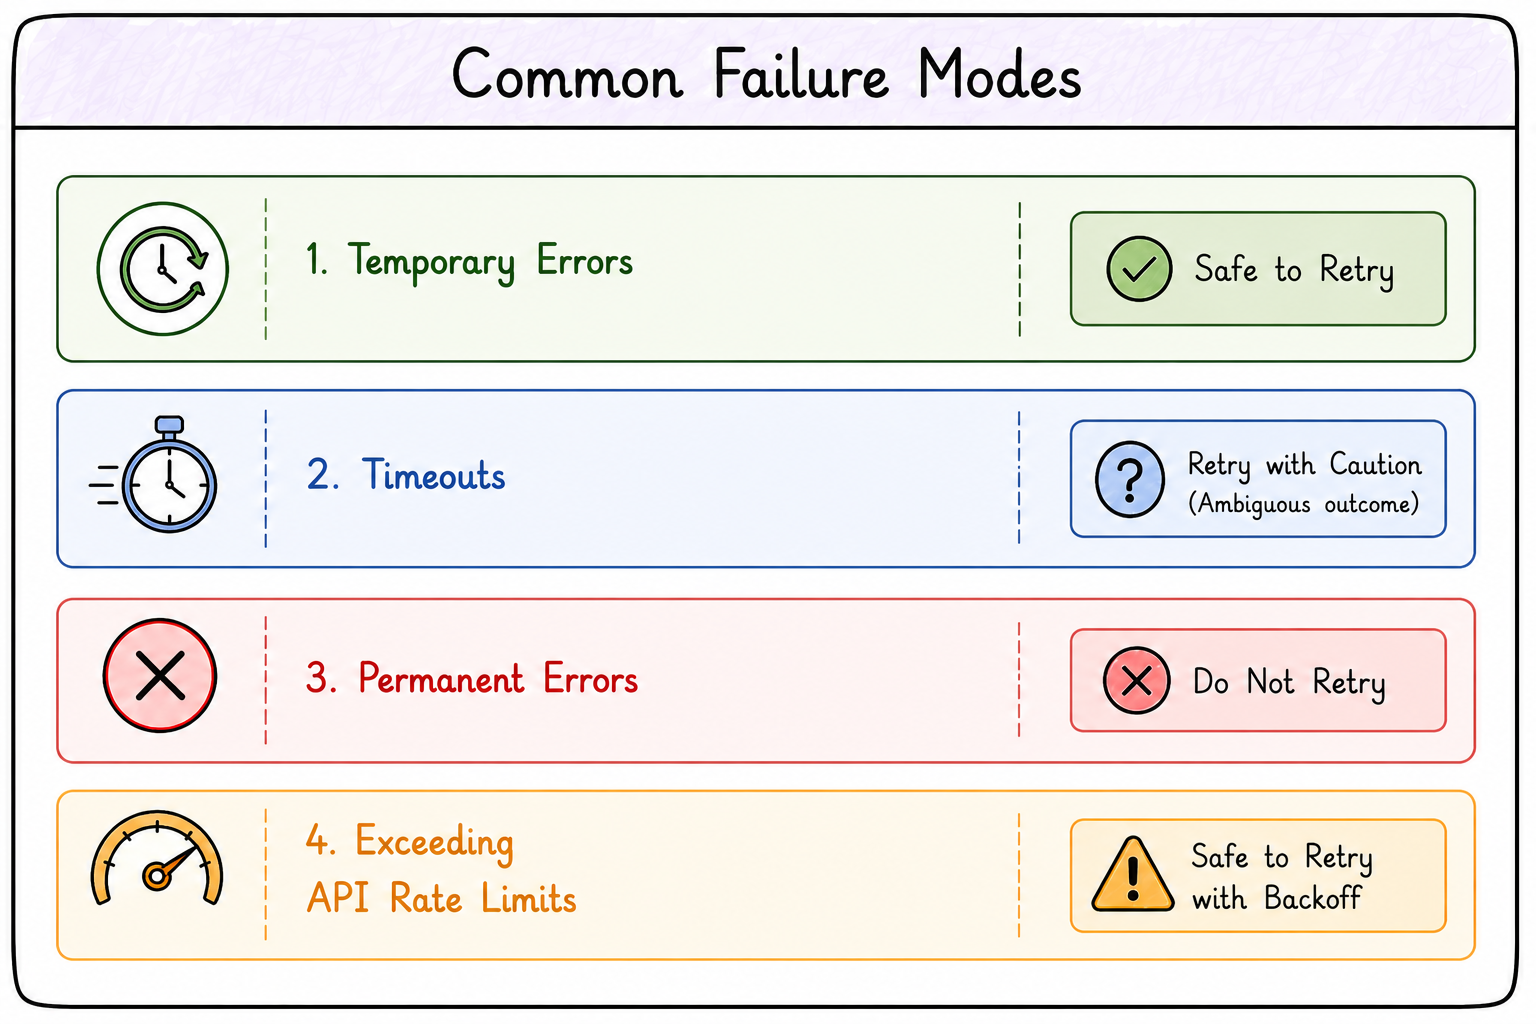
Connaître les modes de panne courants :
Les erreurs temporaires disparaissent d'elles‑mêmes ; le réessai est généralement sûr.
Timeouts : le service externe met trop de temps à répondre.
Erreurs permanentes : la requête est fondamentalement erronée, réessayer ne sert à rien.
Limites de débit d'API : trop de requêtes, attendre HTTP 429 Too Many Requests.
Stratégies de réessai
Dans les systèmes distribués, les pannes sont souvent temporaires.
Une requête réessayée aboutit souvent.
Ajoutez le réessai avec soin ; des réessais aveugles peuvent aggraver la situation.
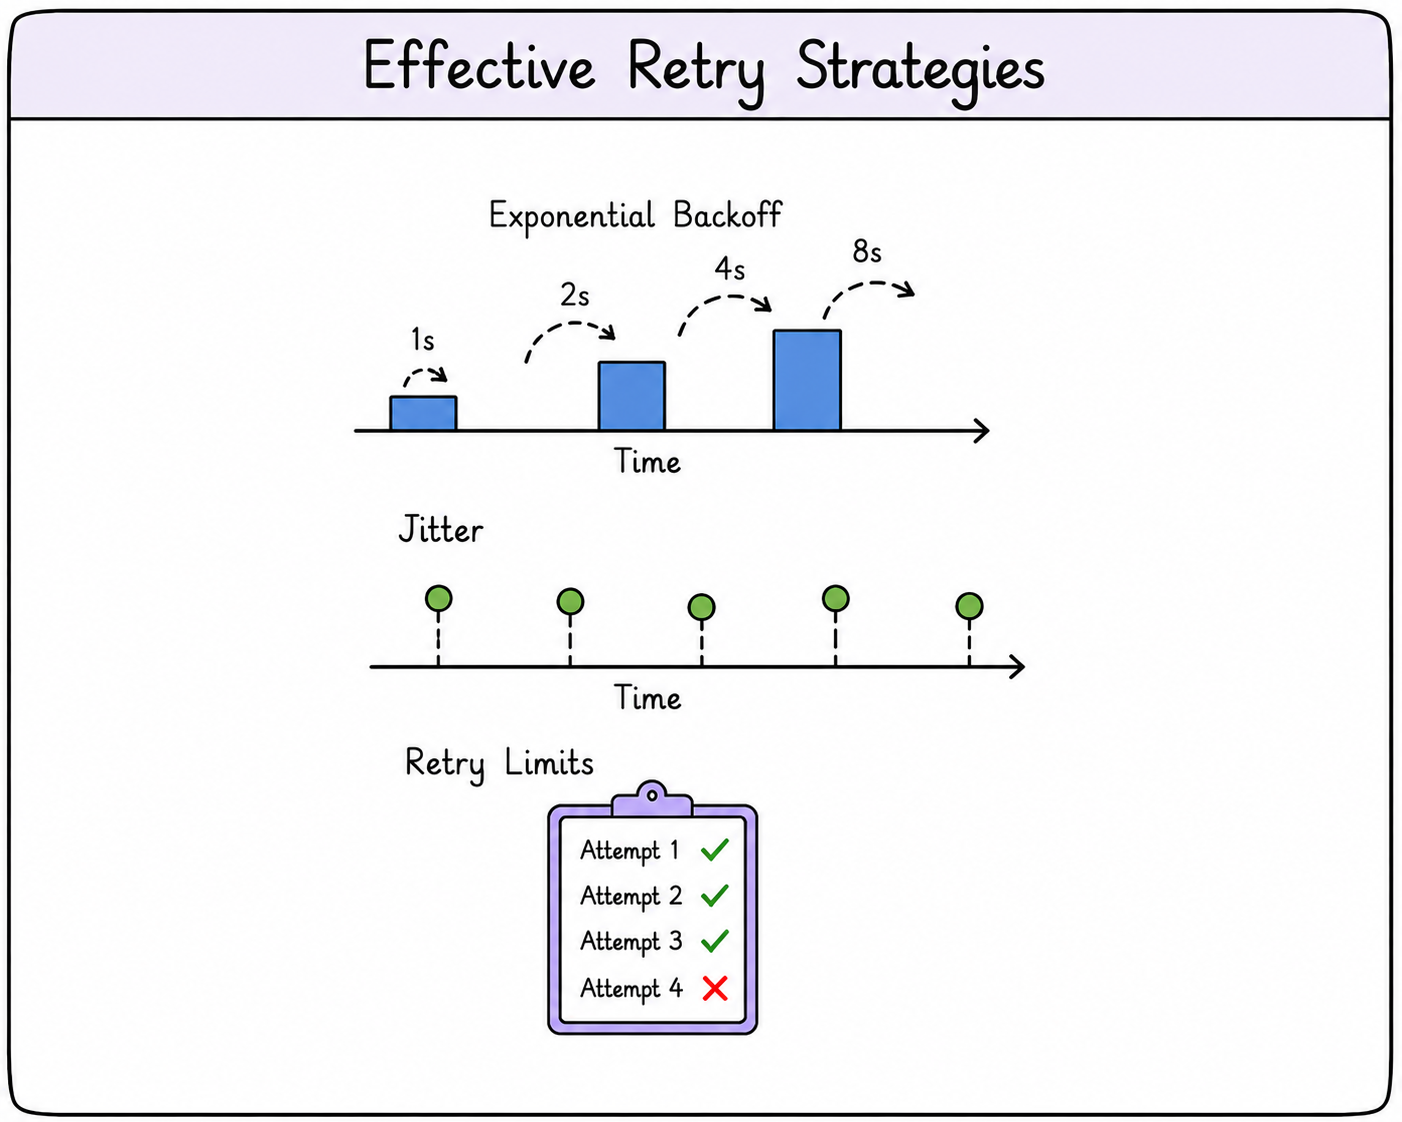
Backoff exponentiel : augmenter l'intervalle entre réessais.
Jitter : ajouter de l'aléatoire pour éviter les pics de réessai.
Limites de réessai : éviter les boucles infinies.
Capacités natives des SDK AWS
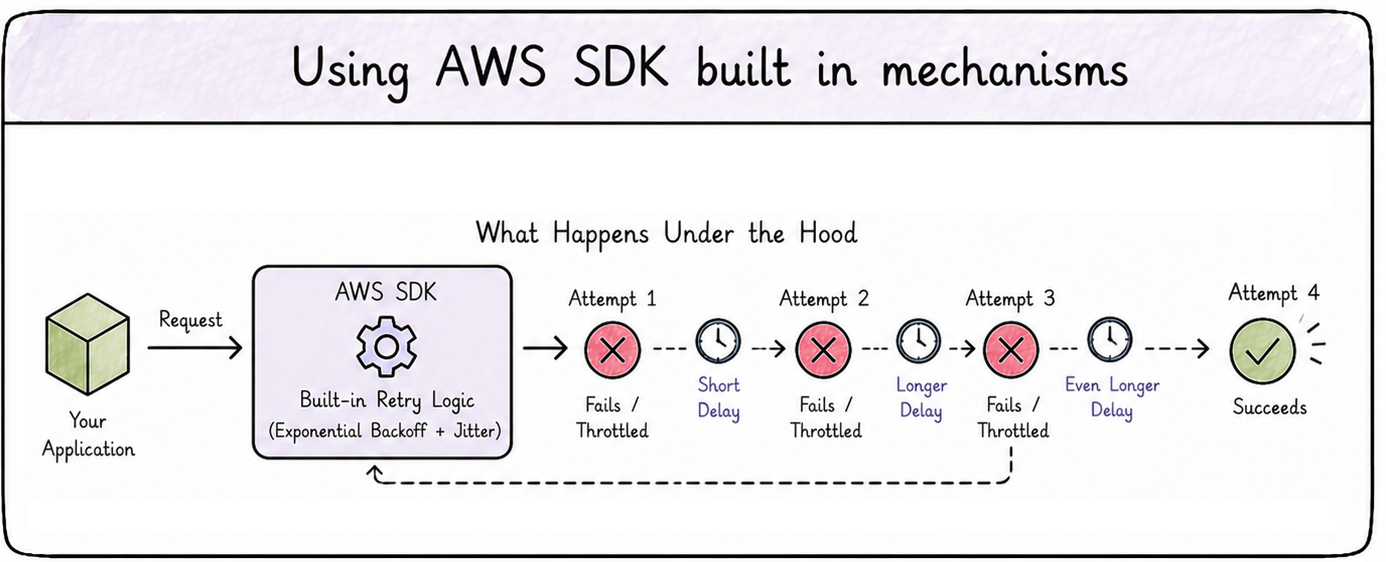
Les SDK AWS gèrent automatiquement les réessais.
Le réessai intégré inclut backoff exponentiel et jitter.
Les requêtes en échec ou limitées sont réessayées avec des délais croissants.
Réduit le code de gestion des erreurs à écrire.
Gérer la logique de réessai
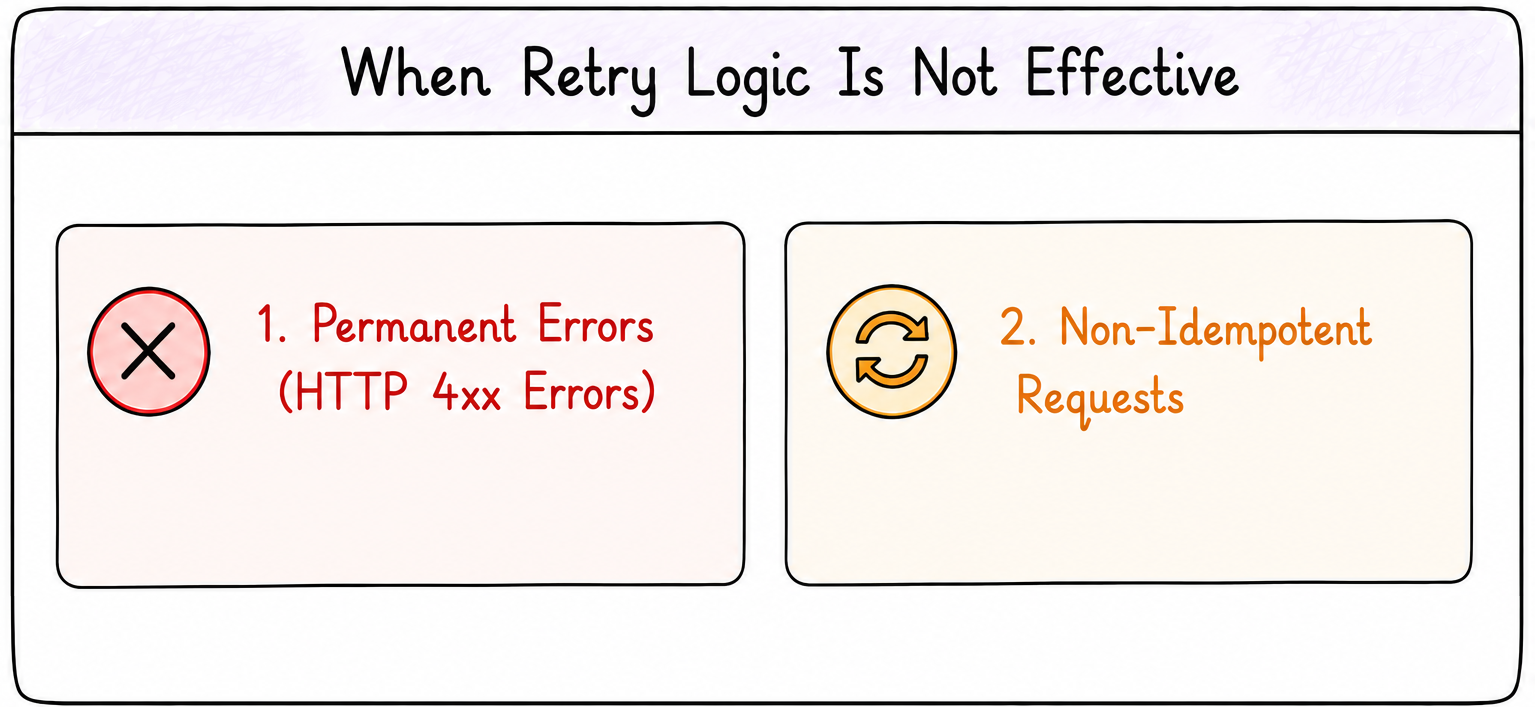
Le réessai n'est pas toujours la solution.
Erreurs HTTP 4xx : le serveur a compris puis rejeté la requête.
Requêtes non idempotentes : réessayer peut dupliquer ou incohérer des actions.
Gérer les timeouts
Réessayer sans limite peut amplifier les problèmes en charge.
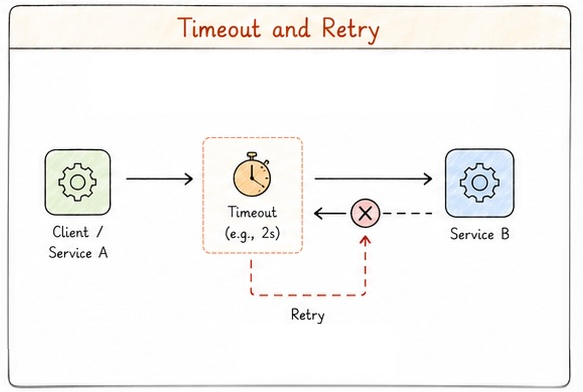
Combinez réessais et timeouts.
Un timeout fixe le temps d'attente maximal d'une réponse.
Chaque appel à un service externe doit avoir un timeout.
Circuit breakers
Si un service échoue sans cesse, les réessais ne suffisent pas.
Continuer à envoyer des requêtes surcharge le service en panne.
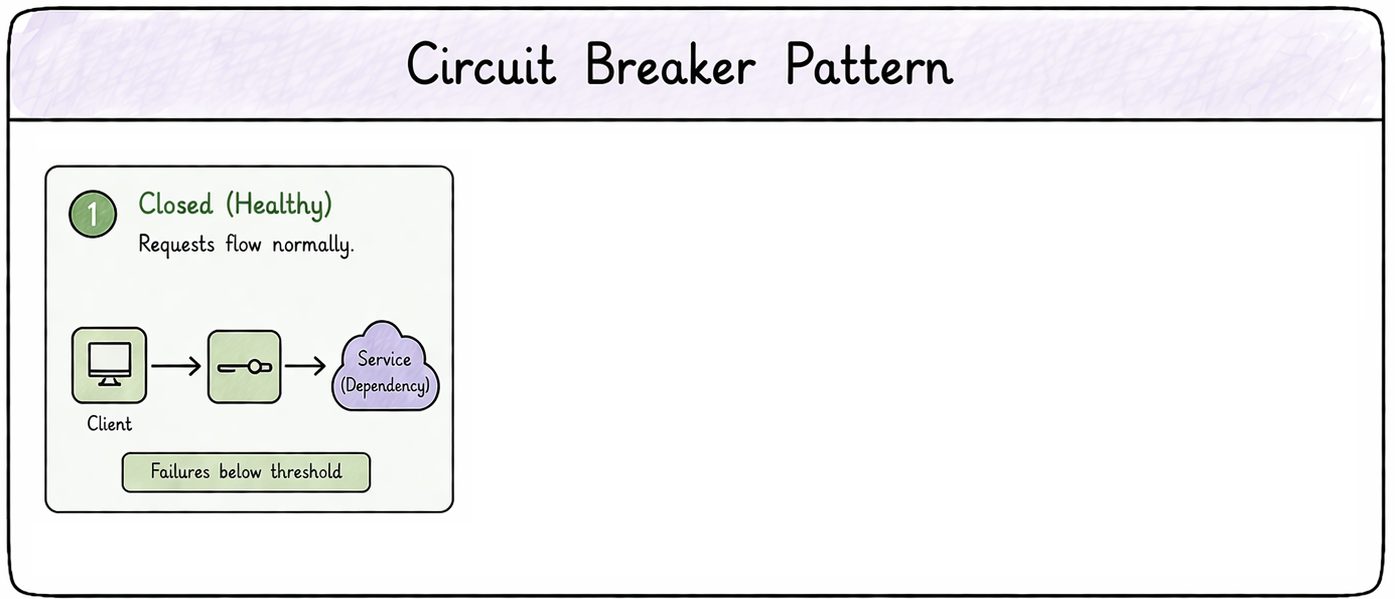
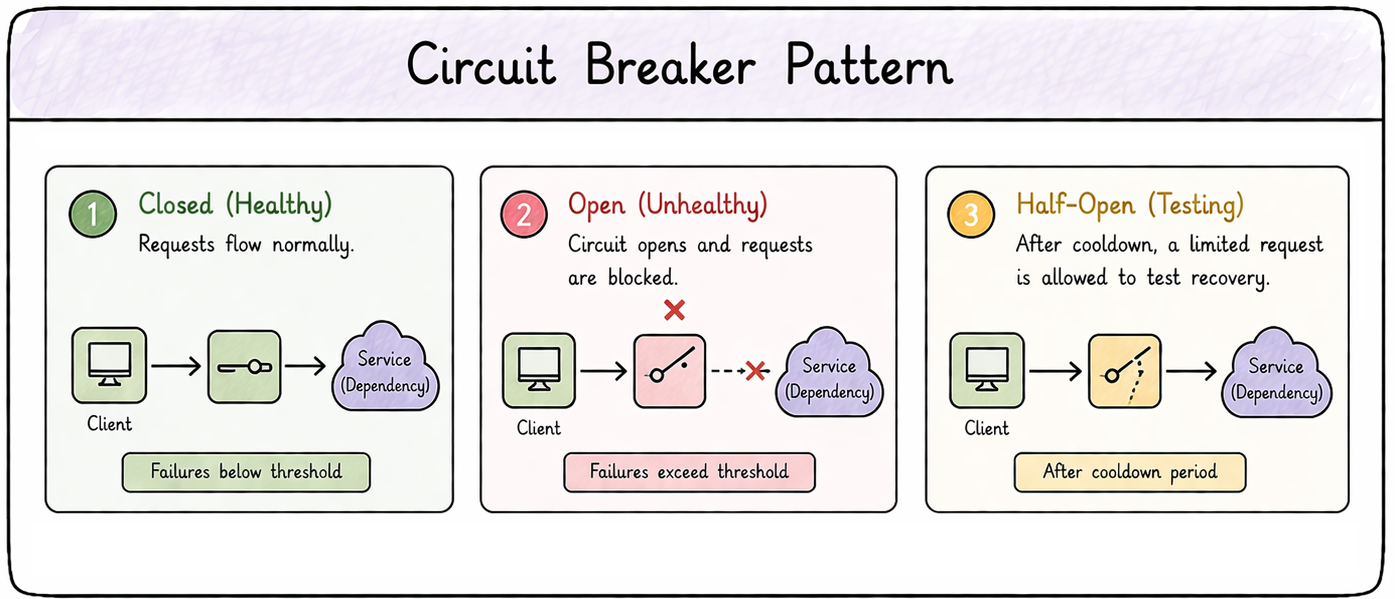
Le « circuit breaker » interrompt temporairement les appels vers une dépendance défaillante.
État fermé : les requêtes passent normalement.
Circuit breakers
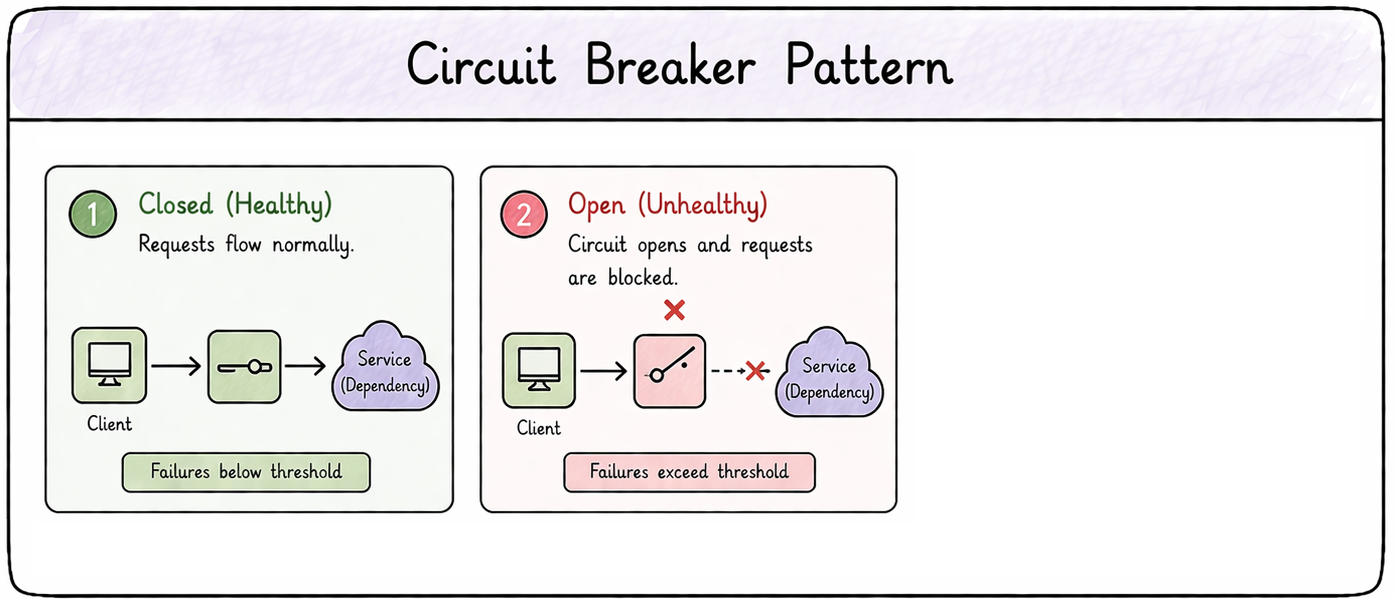
Quand les échecs dépassent un seuil, le circuit s'ouvre.
Les requêtes suivantes sont bloquées.
Circuit breakers
Après un délai, le circuit passe en état semi‑ouvert pour tester le rétablissement.
Réponse réussie : reprise du fonctionnement normal.
Encore en échec : le circuit reste ouvert.
Implémentez les circuit breakers au niveau applicatif.
Dead letter queues
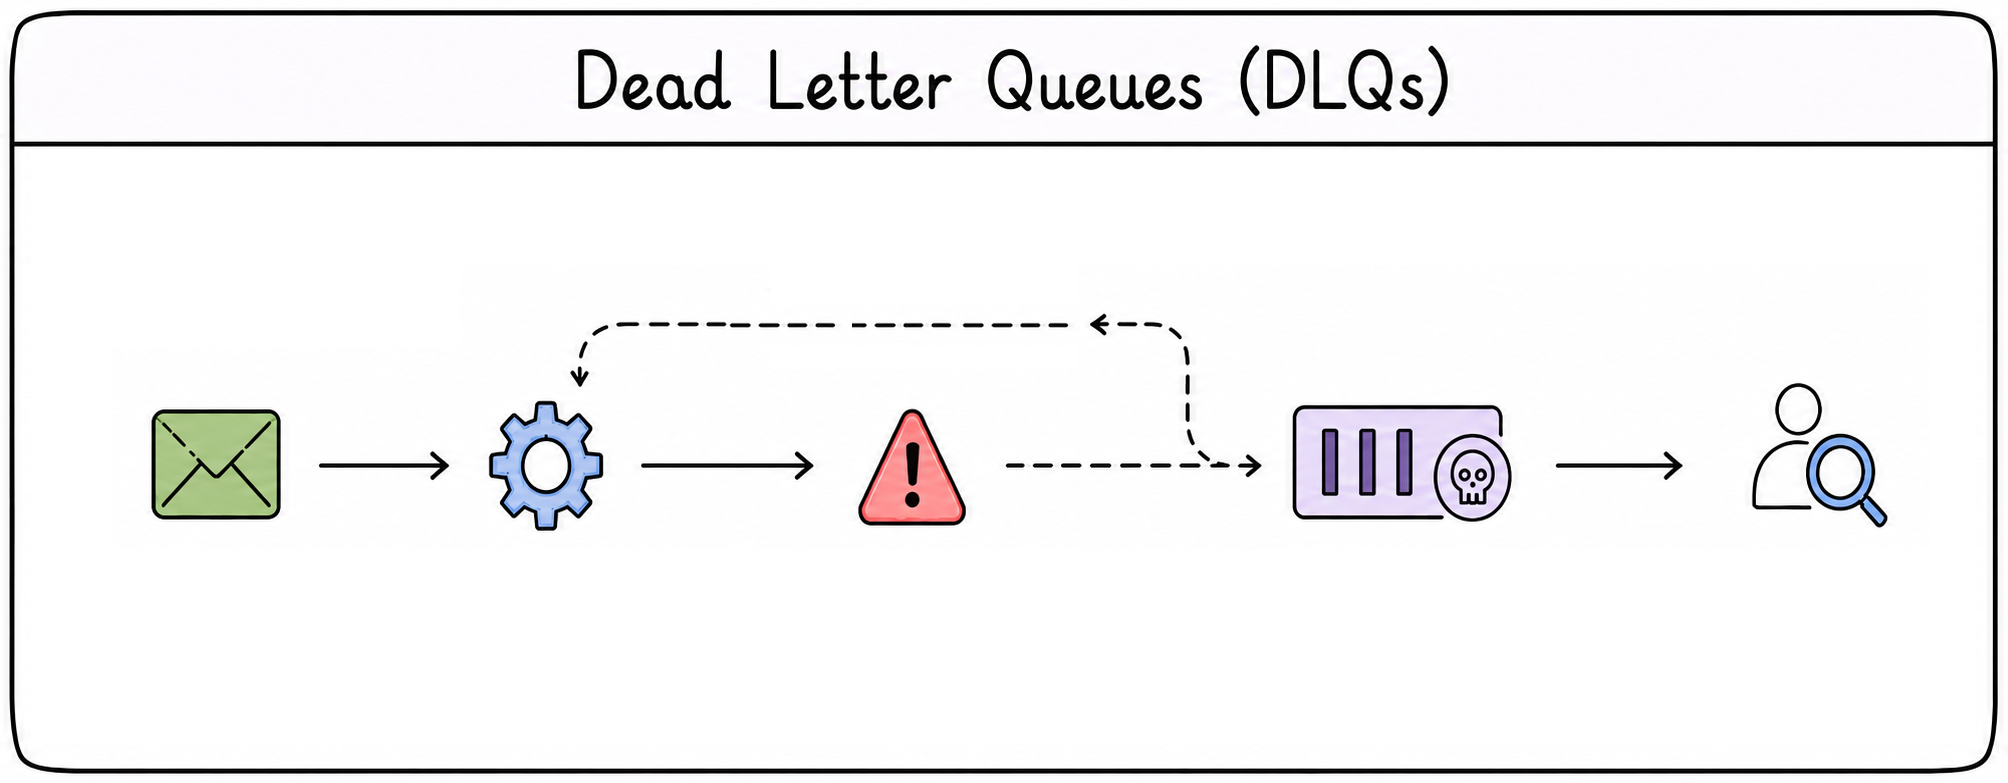
Des messages qui échouent en boucle peuvent bloquer le système.
Les extraire du flux principal.
Les messages en échec vont dans une Dead Letter Queue.
Élément clé de la résilience applicative.
Mais comprendre les compromis.
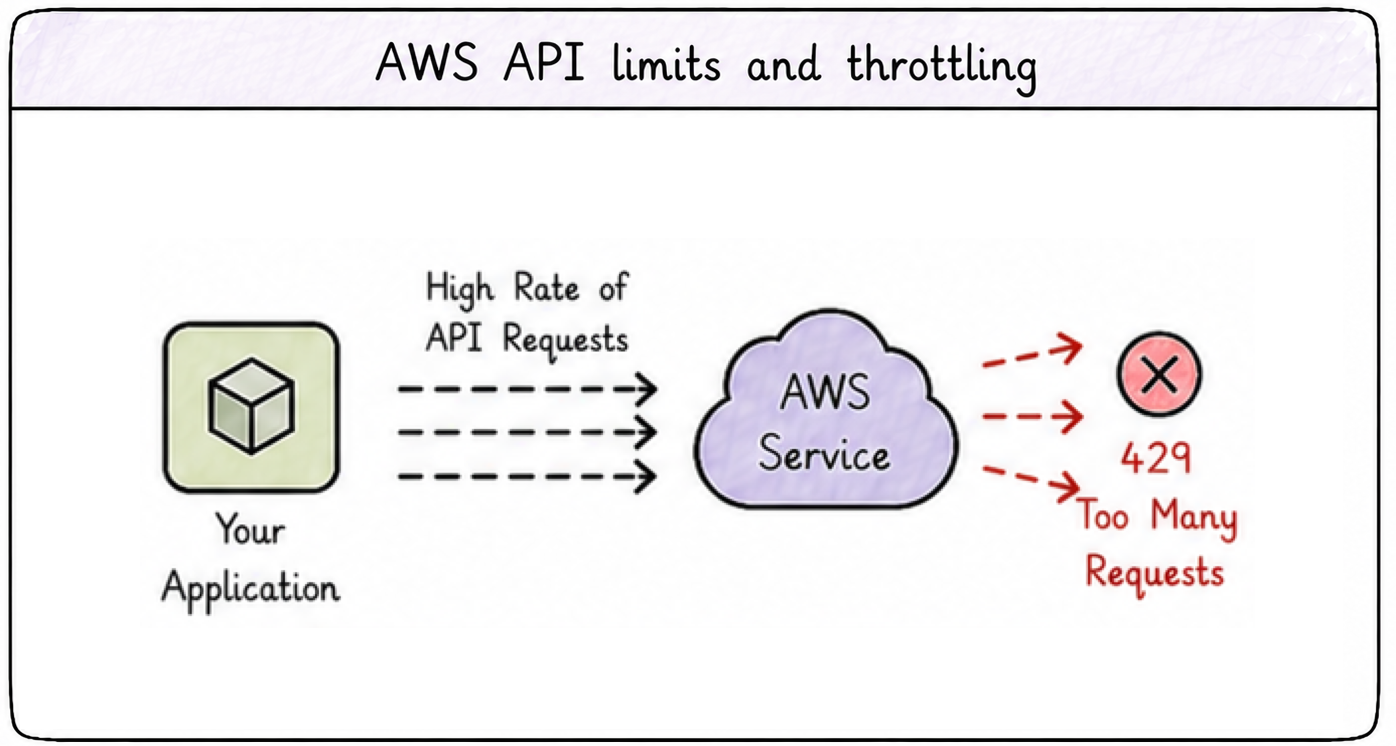
Limites des API AWS
Vous interagissez avec les services AWS via des API.
Chaque service définit ses propres limites de débit.
Dépasser ces limites déclenche le throttling (HTTP 429 Too Many Requests).
Concevez votre application pour gérer ce throttling proprement.
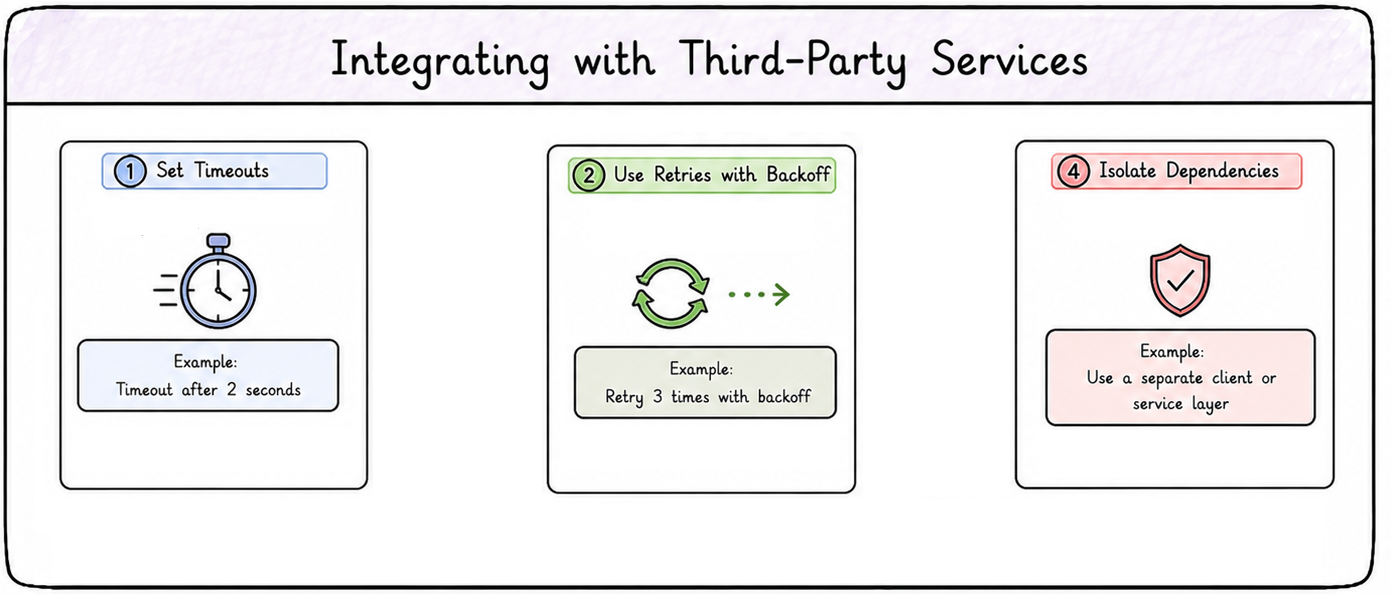
Intégrer des services tiers
Les services tiers ajoutent de l'incertitude.
Vous ne contrôlez ni leurs performances ni leur disponibilité.
Définissez des timeouts pour éviter les longues attentes.
Utilisez des réessais avec backoff pour les problèmes temporaires.
Isolez les dépendances pour limiter l'impact.
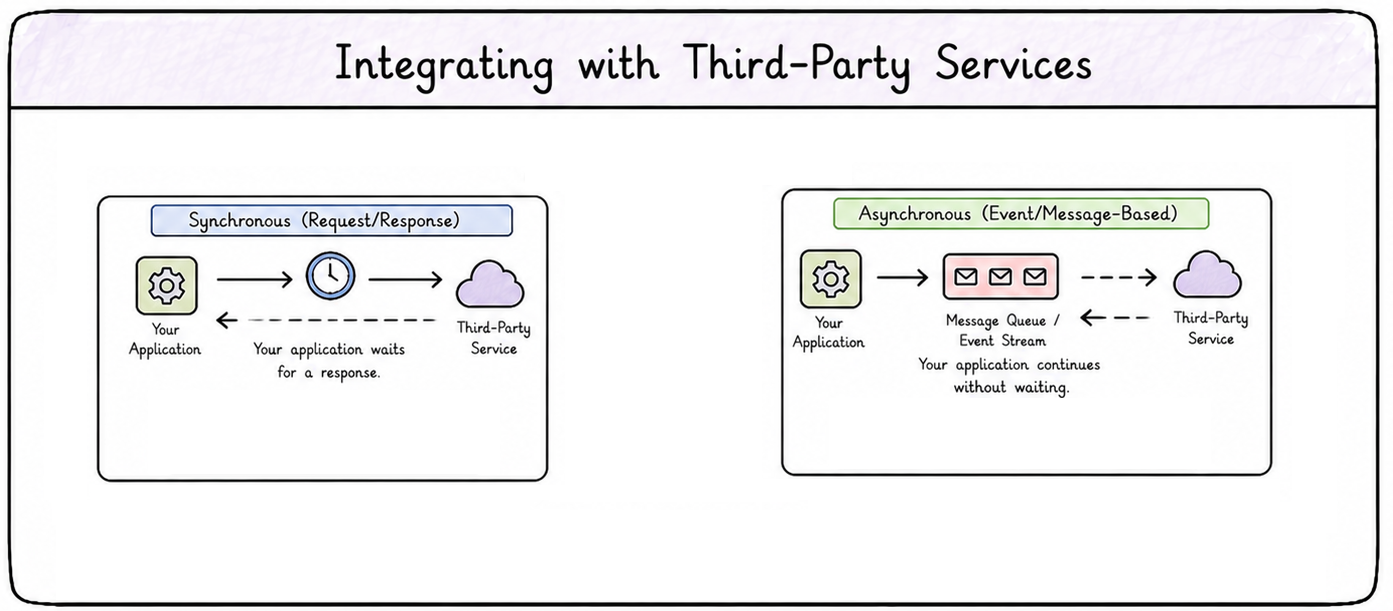
Intégration avec des tiers
Envisagez de passer du synchrone à l'asynchrone.
Votre système continue à traiter même si le service externe est lent.
Passons à la pratique !
Développer des applications sur AWS
Preparing Video For Download...