Coordonner les services et gérer l'état
Développer des applications sur AWS
Ricardo Sueiras
Principal Technologist
Coordination des services
Plusieurs services doivent collaborer pour exécuter un workflow.
Ils ont besoin d'une stratégie de coordination.
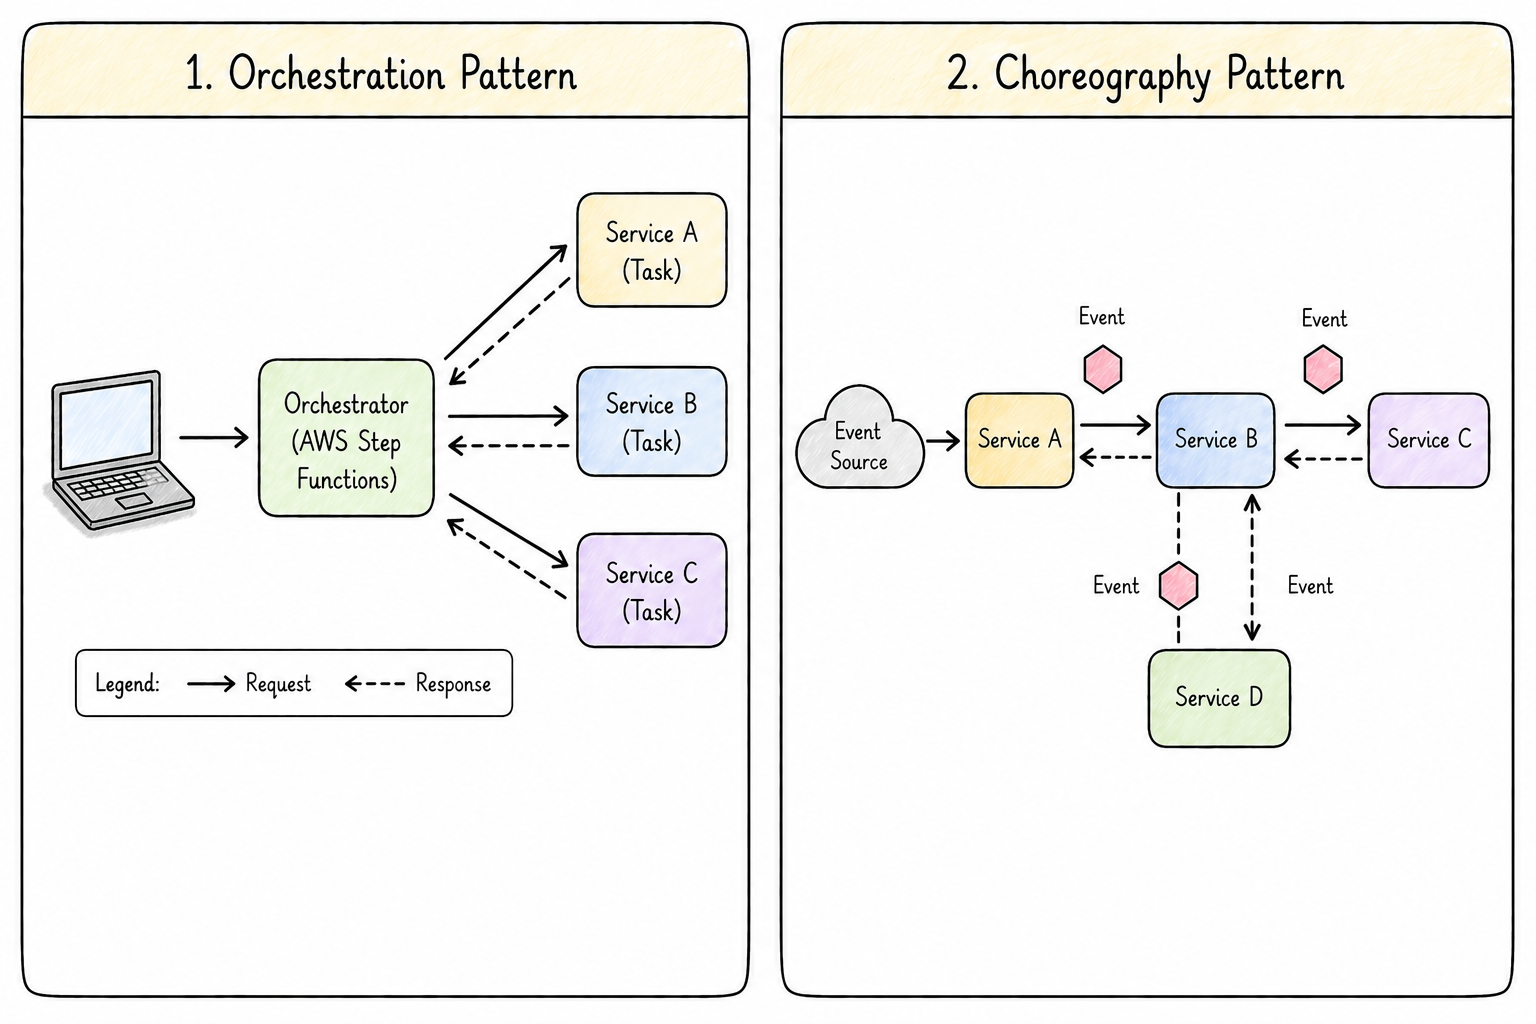
Deux approches : orchestration et chorégraphie.
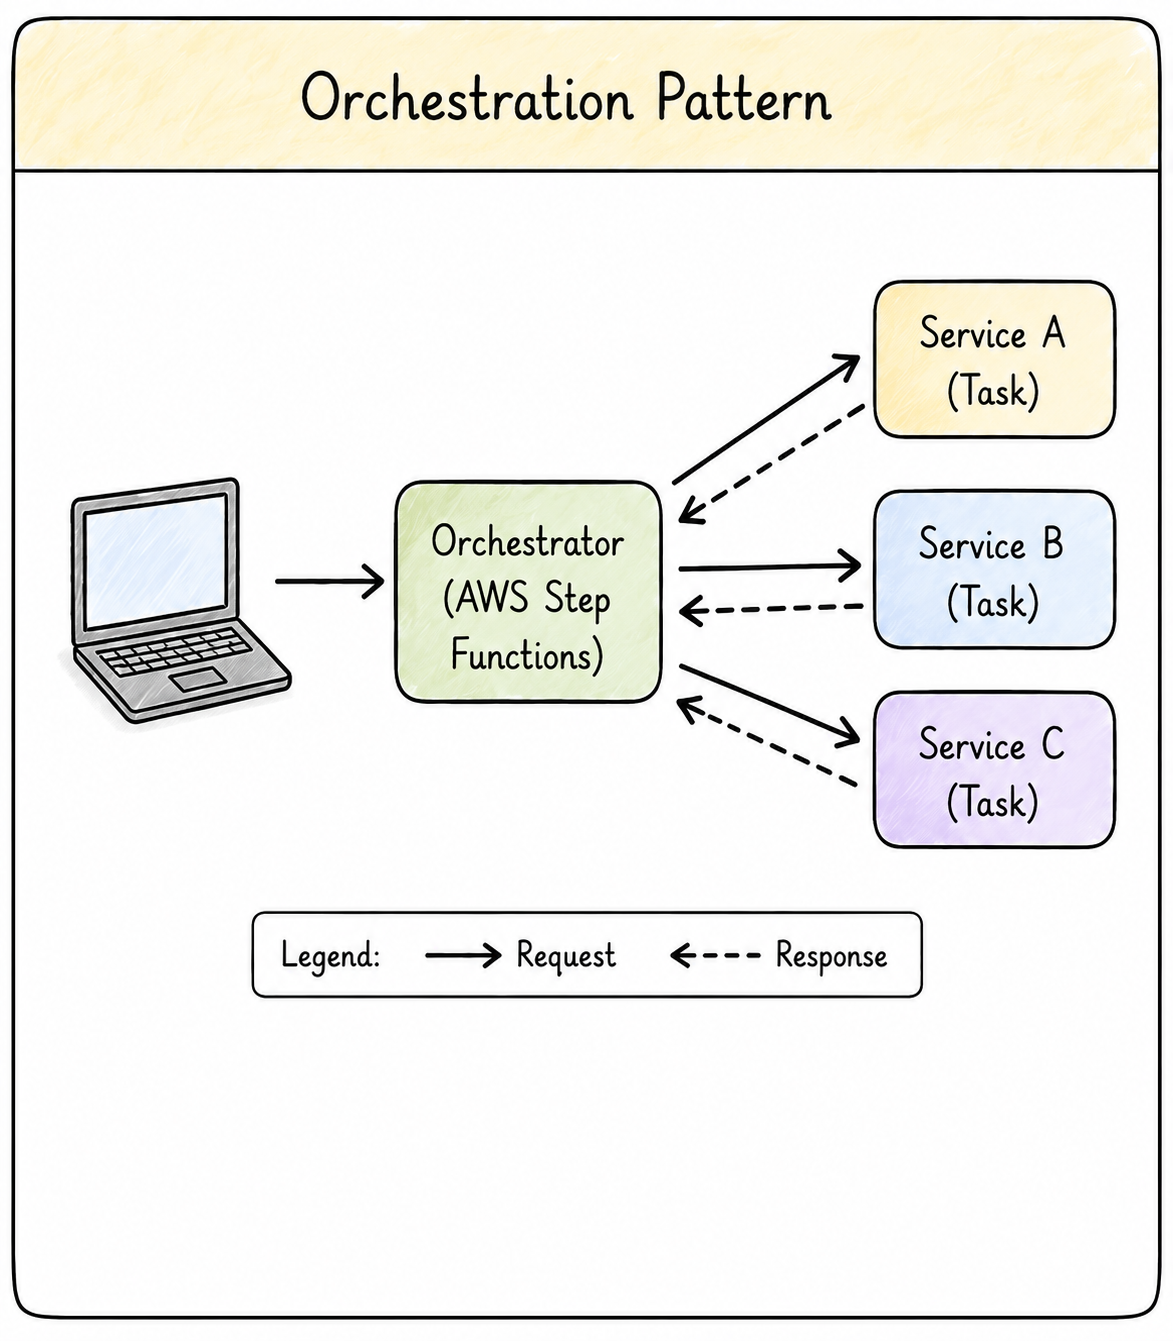
Orchestration
Un orchestrateur central coordonne le workflow.
Il contrôle la séquence et décide quel service s'exécute ensuite.
Utile pour les relances, la logique conditionnelle et la gestion des erreurs.
Sur AWS : implémenté avec Step Functions pour Lambda, ECS, DynamoDB.
Orchestration
La logique du workflow est centralisée : débogage et suivi facilités.
Compromis : dépendance centrale introduite.
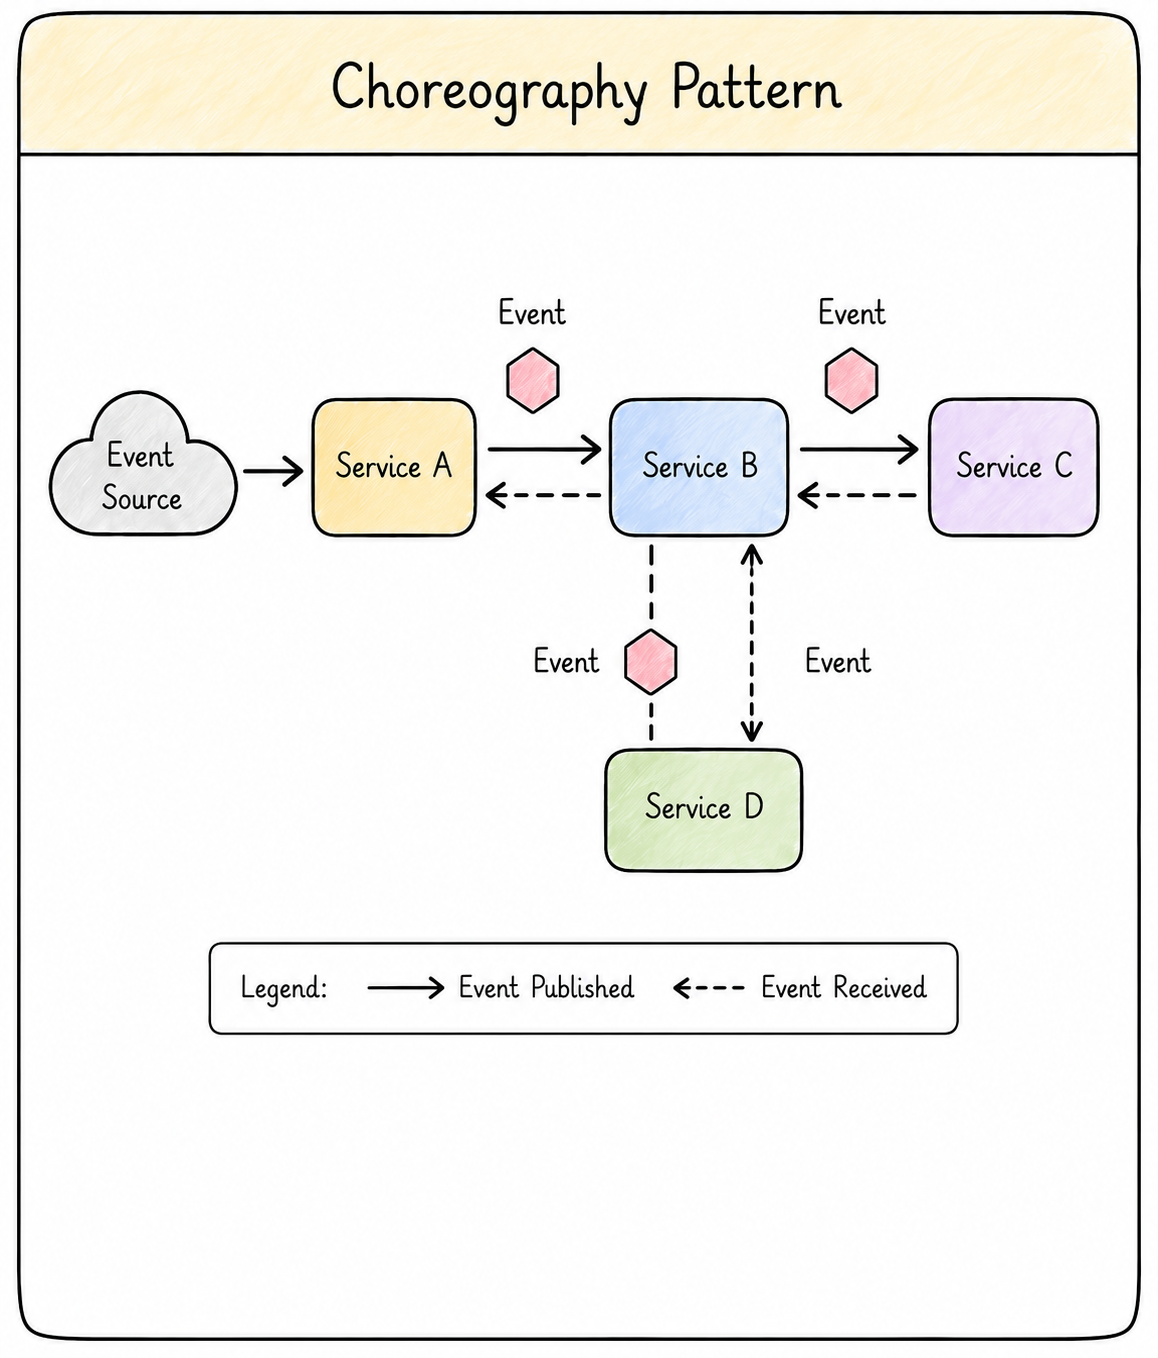
Chorégraphie
Pas de contrôleur central.
Les services réagissent aux événements de façon autonome.
Chaque service écoute les événements pertinents et exécute sa tâche.
Aucun service n'a besoin de connaître tout le workflow.
Améliore le couplage lâche et l'évolutivité.
Chorégraphie
Sur AWS : EventBridge, SNS, SQS.
Très scalable.
Compromis : plus difficile à comprendre et à déboguer à grande échelle.
Architecture pilotée par les événements
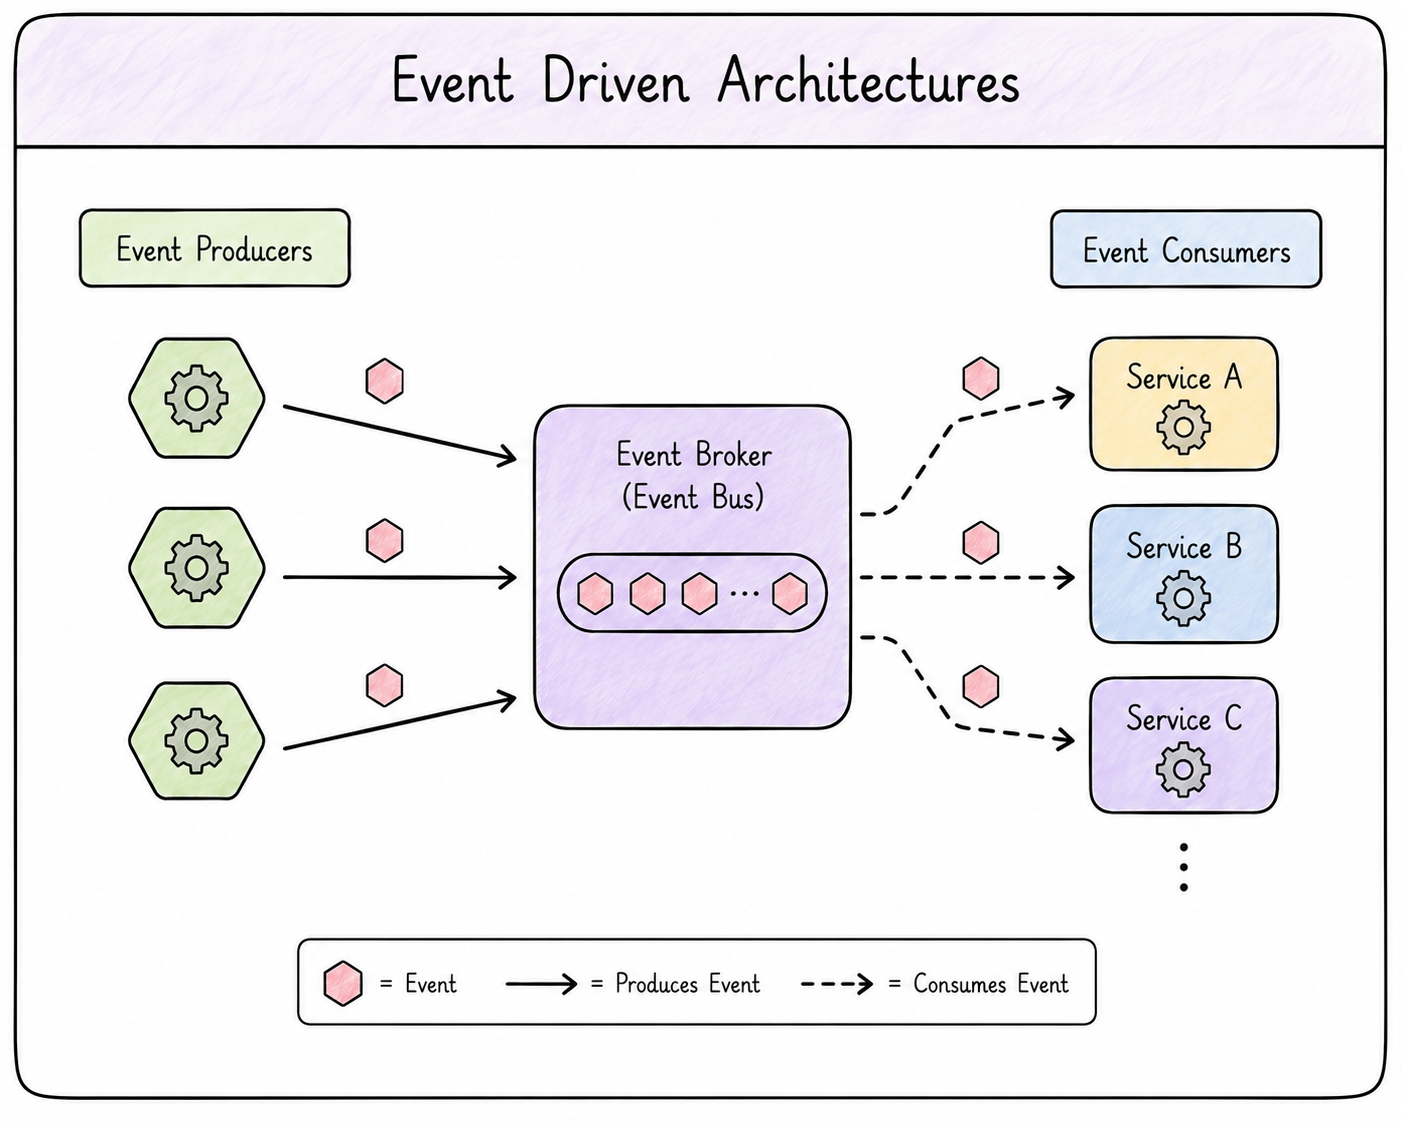
Les services communiquent en produisant et consommant des événements.
Favorise un couplage lâche entre services.
Favorise une forte évolutivité.
Permet le traitement parallèle des événements.
De nouveaux services peuvent s'abonner sans modifier l'existant.
Architecture pilotée par les événements
Compromis à prévoir avec l'EDA :
Concevoir pour la cohérence éventuelle.
Implémenter l'idempotence.
La gestion des échecs est plus complexe.
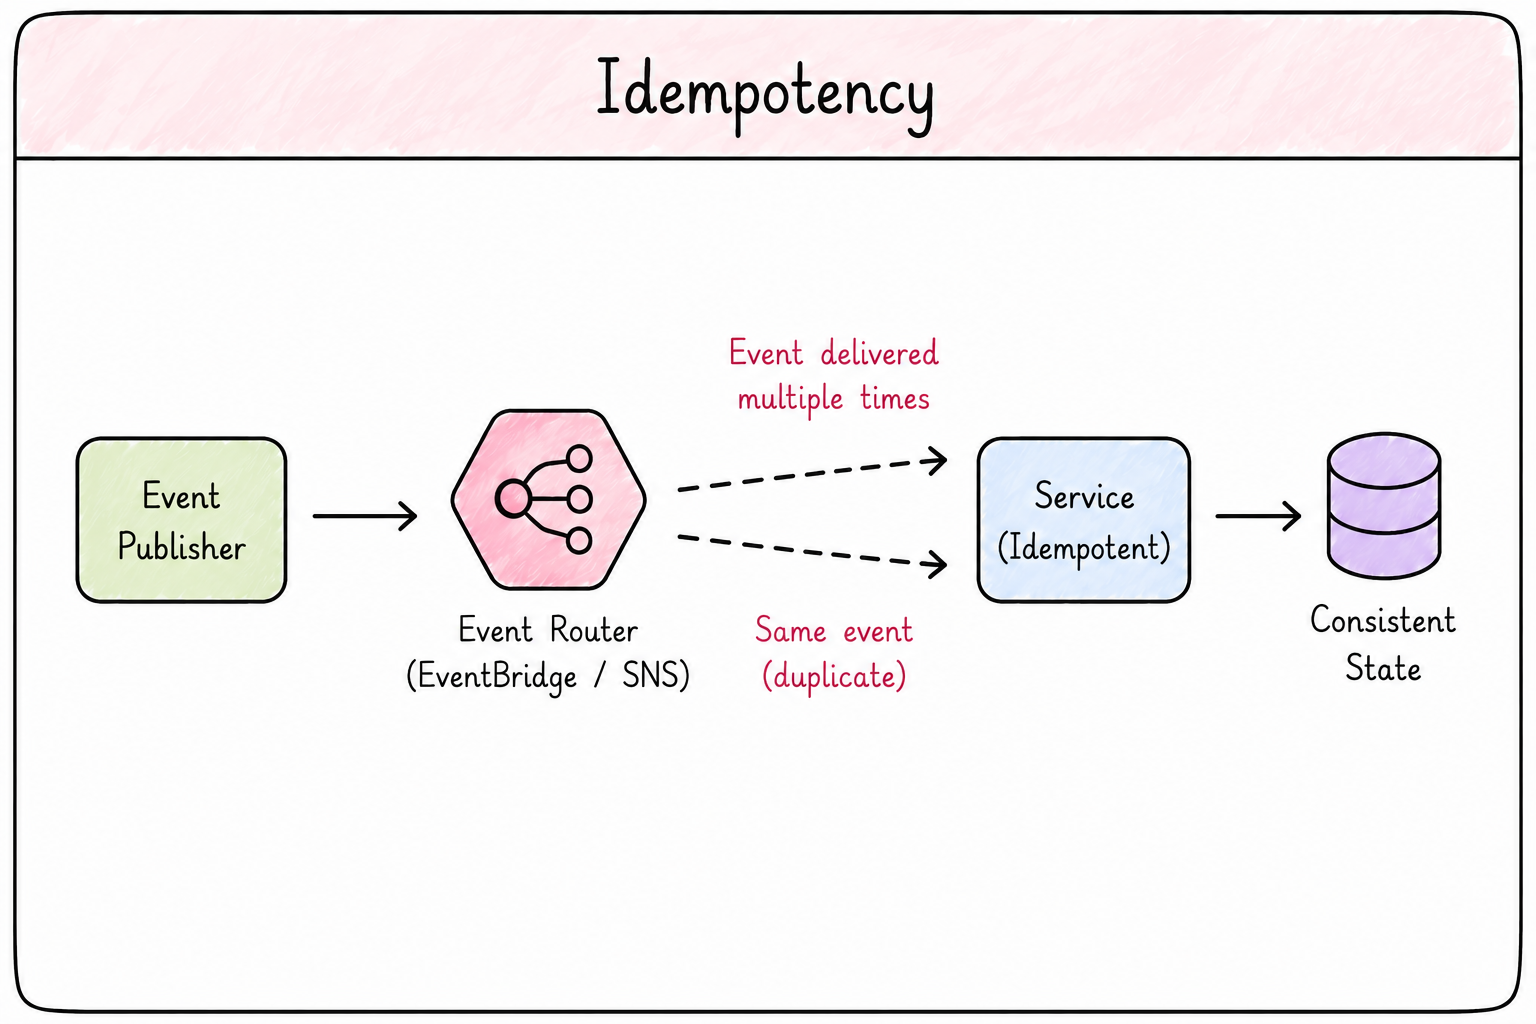
Idempotence
La même opération exécutée plusieurs fois produit le même résultat.
Principe clé de conception pour l'asynchrone et les systèmes pilotés par événements.
Les systèmes distribués peuvent livrer des doublons (relances, pannes réseau, retraitement).
Préserve la correction et la fiabilité du système.
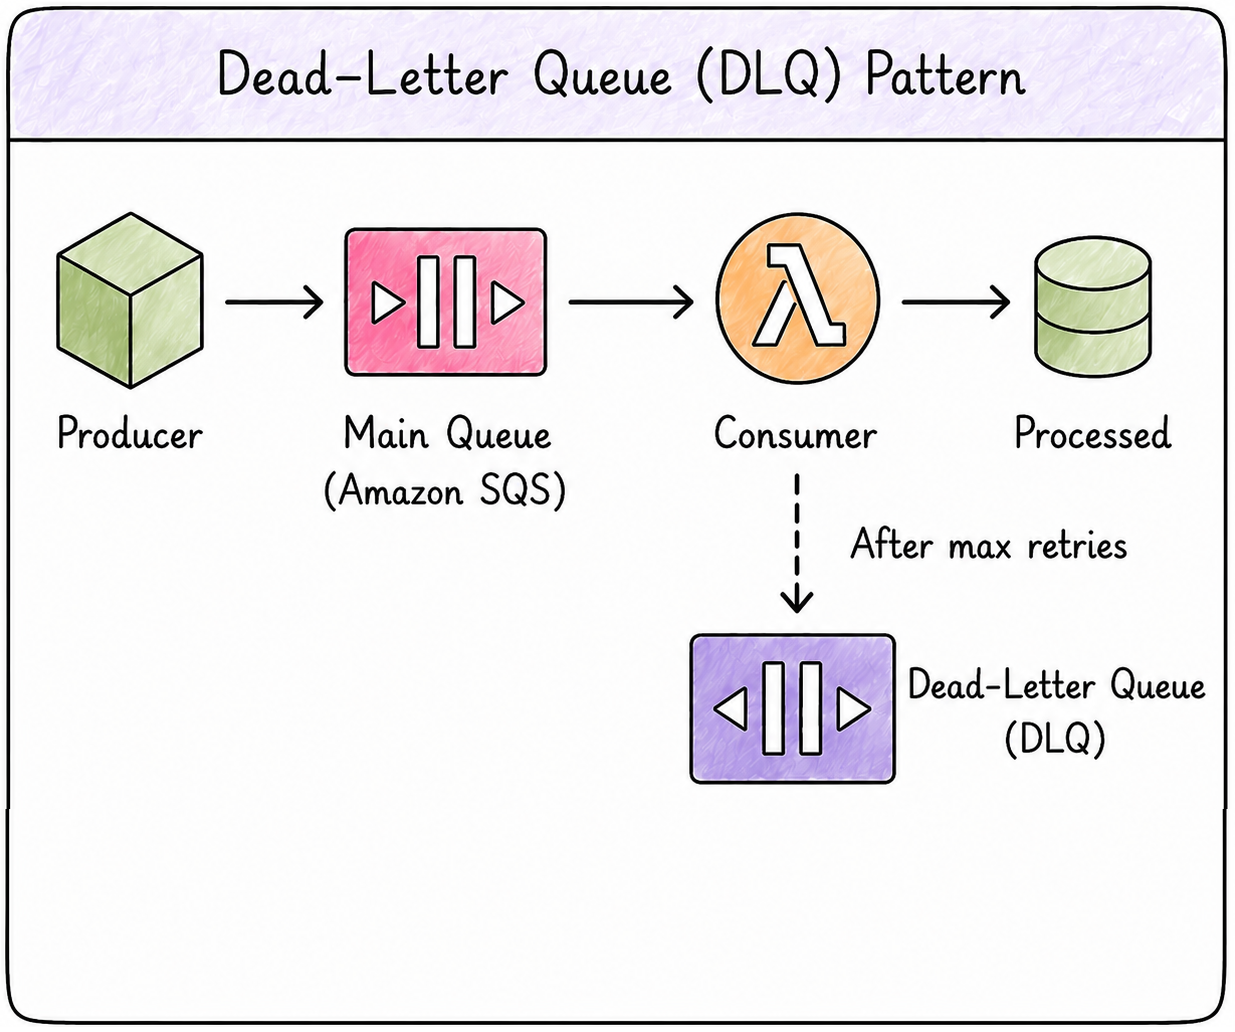
Dead letter queues
Gère les échecs en communication asynchrone.
Isole les messages « poison » problématiques.
Après plusieurs échecs de relance, le message va en DLQ.
Le flux principal continue de tourner.
Dead letter queues
À utiliser quand l'ordre des messages n'est pas critique.
À éviter pour les systèmes non critiques où une perte de données occasionnelle est tolérée.
À proscrire si l'ordre des messages doit être préservé.
Gestion de l'état
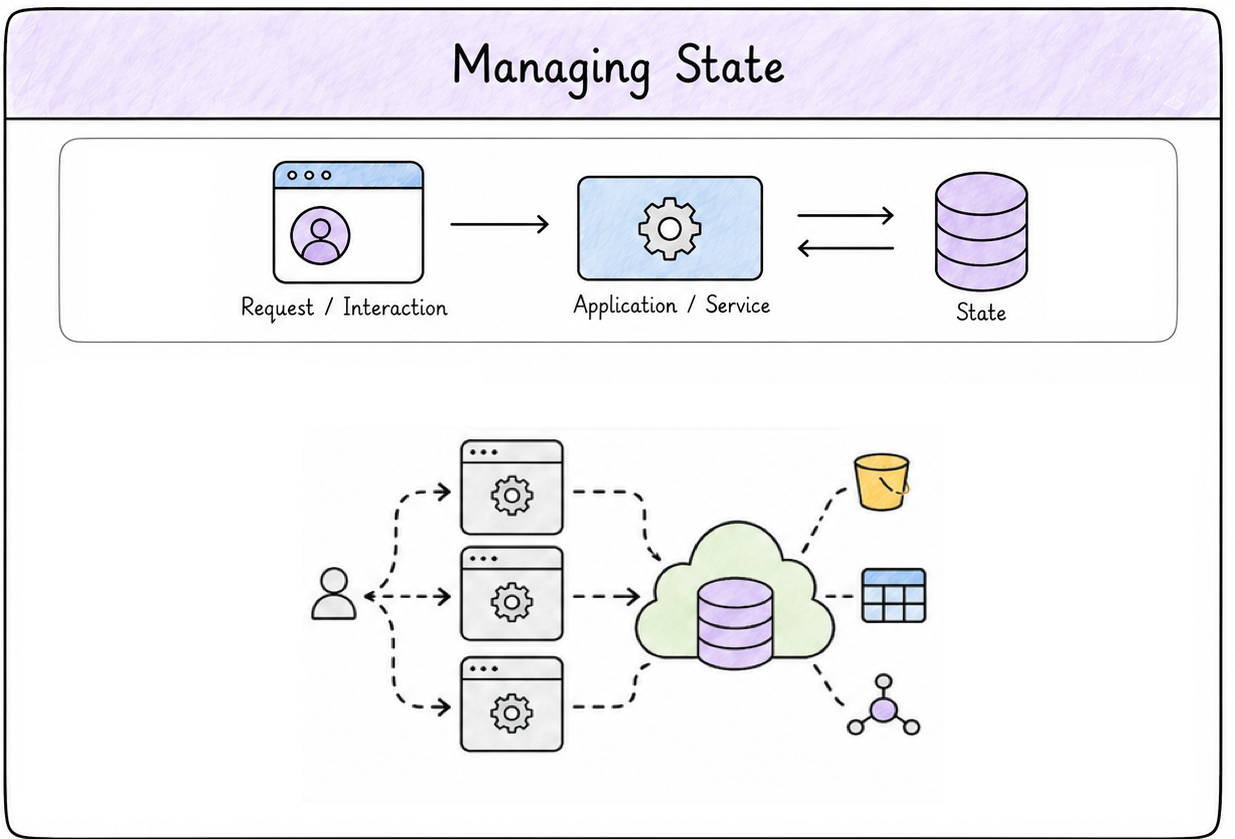
Gérer l'état est fondamental pour les apps cloud native.
L'état est toute donnée conservée entre interactions.
Stocker l'état localement sur le serveur limite l'évolutivité et la résilience.
Gestion de l'état
La gestion de l'état implique des compromis selon le besoin.
Un état externe améliore évolutivité et résilience.
Coûts : latence et complexité accrues.
À considérer : cohérence, mise en cache, modes d'accès aux données.
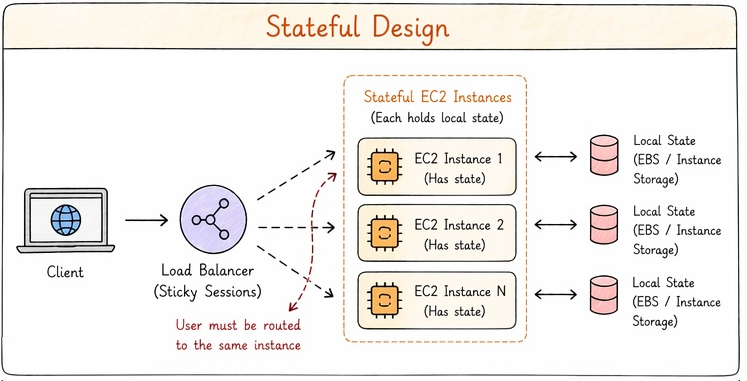
Avec état (stateful)
Les données de session restent sur le serveur.
Les requêtes doivent cibler la même instance (sessions persistantes).
Limite la flexibilité de mise à l'échelle.
Si l'instance tombe, la session est perdue.
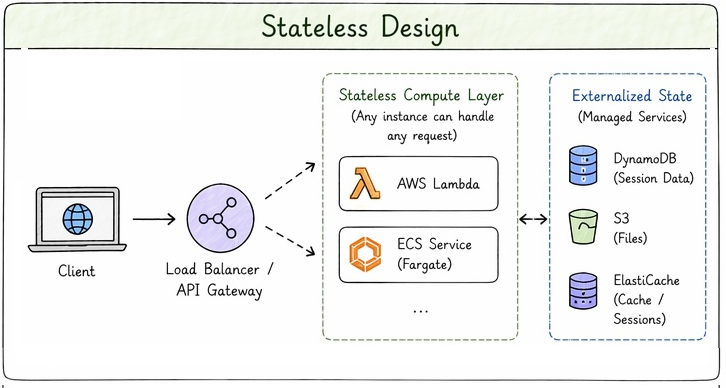
Sans état (stateless)
Chaque requête est traitée indépendamment.
Aucun état stocké sur le serveur.
L'état vit dans des systèmes externes.
Approche privilégiée pour les apps cloud native.
Toute instance peut traiter toute requête : l'échelle horizontale est simple.
Passons à la pratique !
Développer des applications sur AWS
Preparing Video For Download...