Fehlertolerante und resiliente Anwendungen auf AWS entwerfen
Anwendungen auf AWS entwickeln
Ricardo Sueiras
Principal Technologist
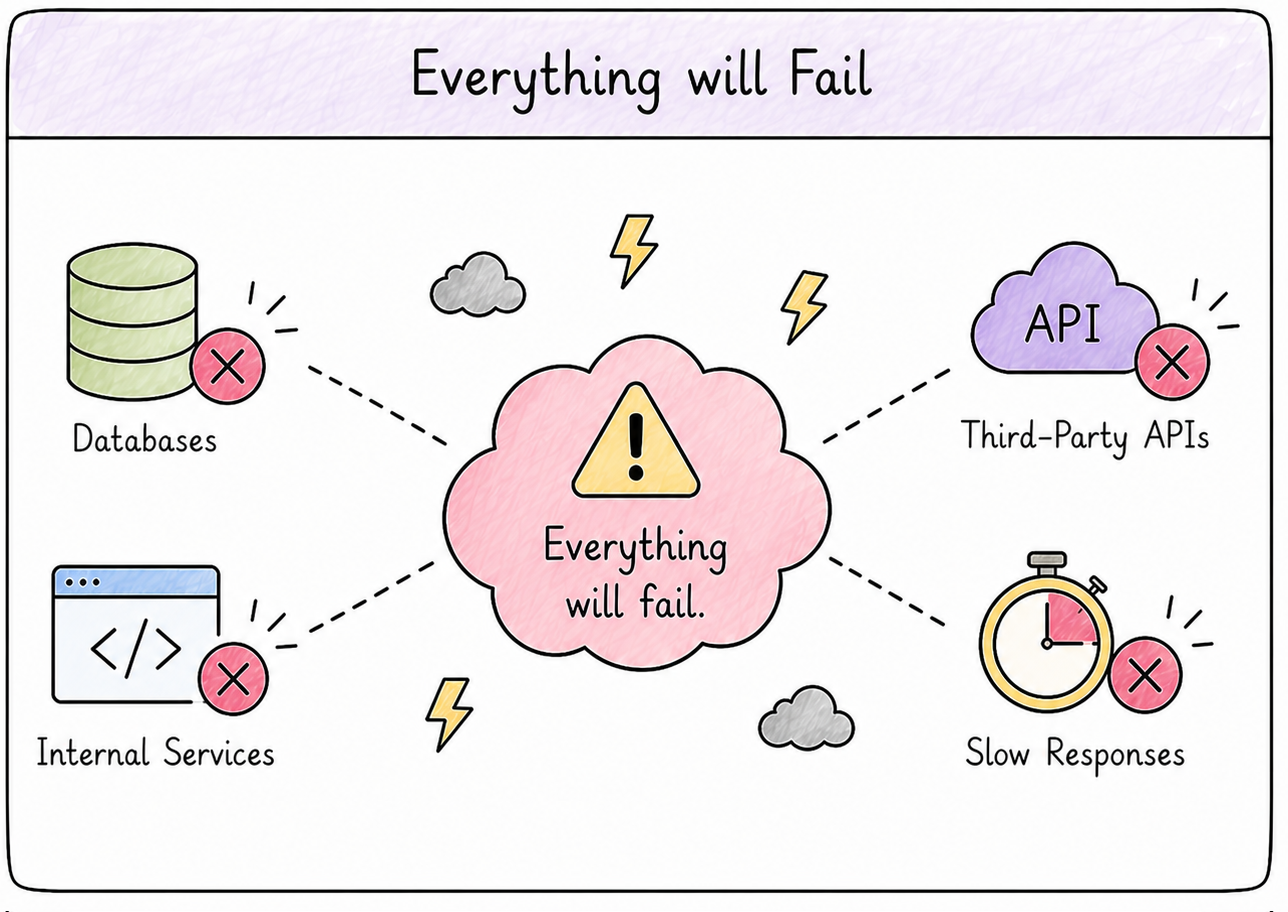
Für Resilienz bauen
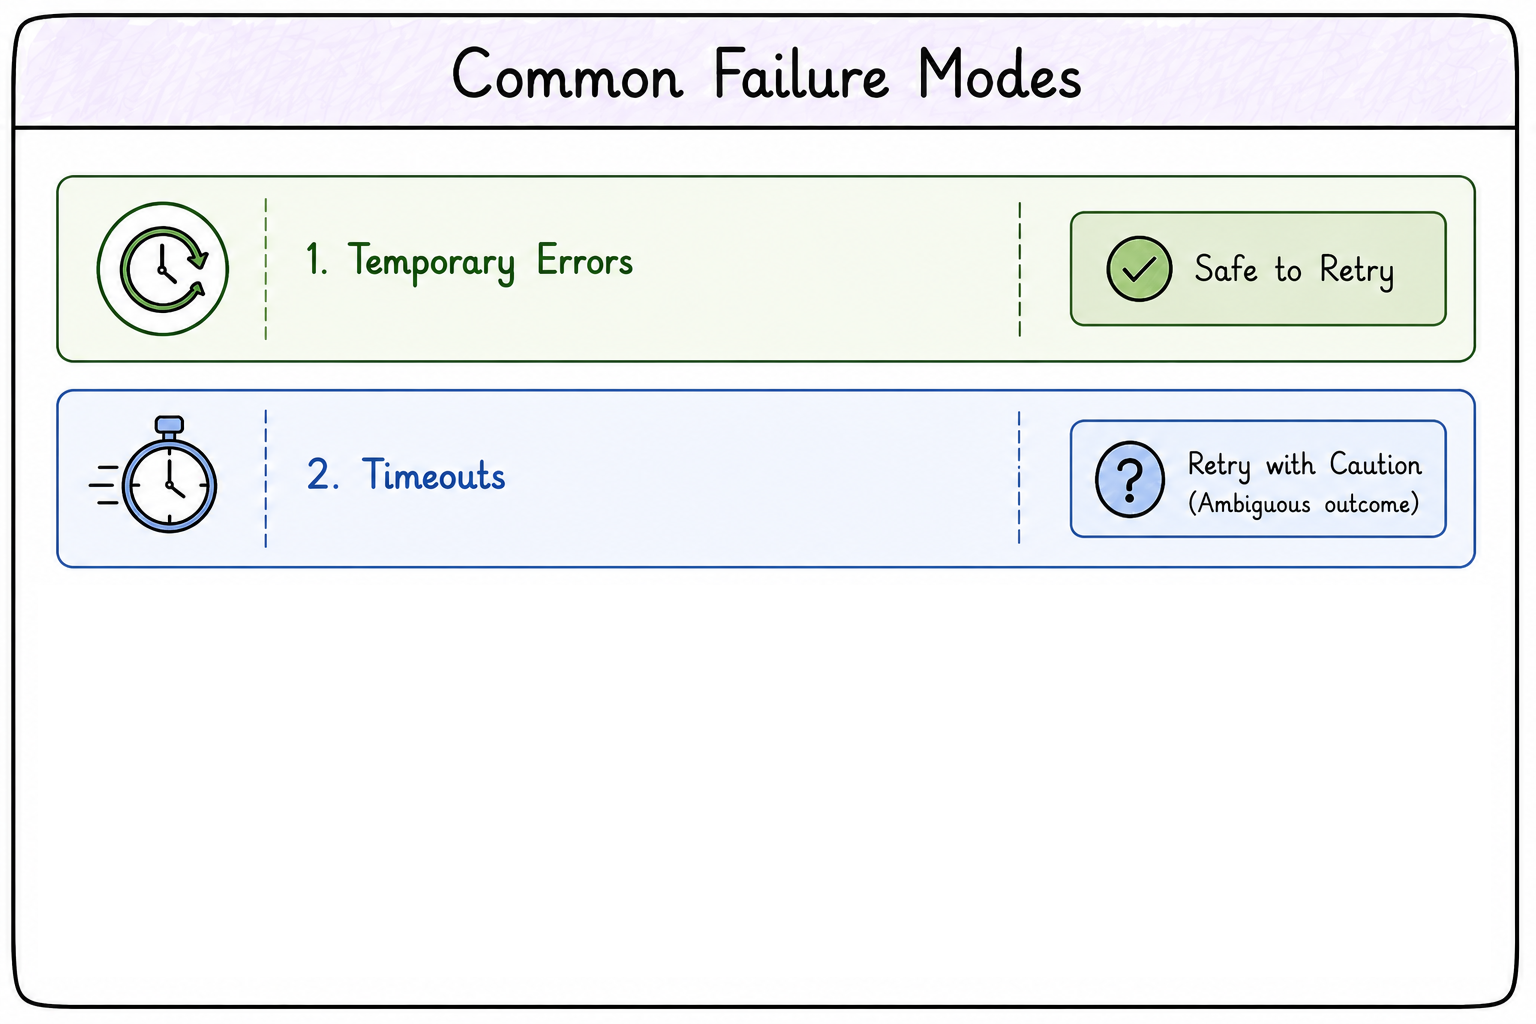
Temporäre Ausfälle
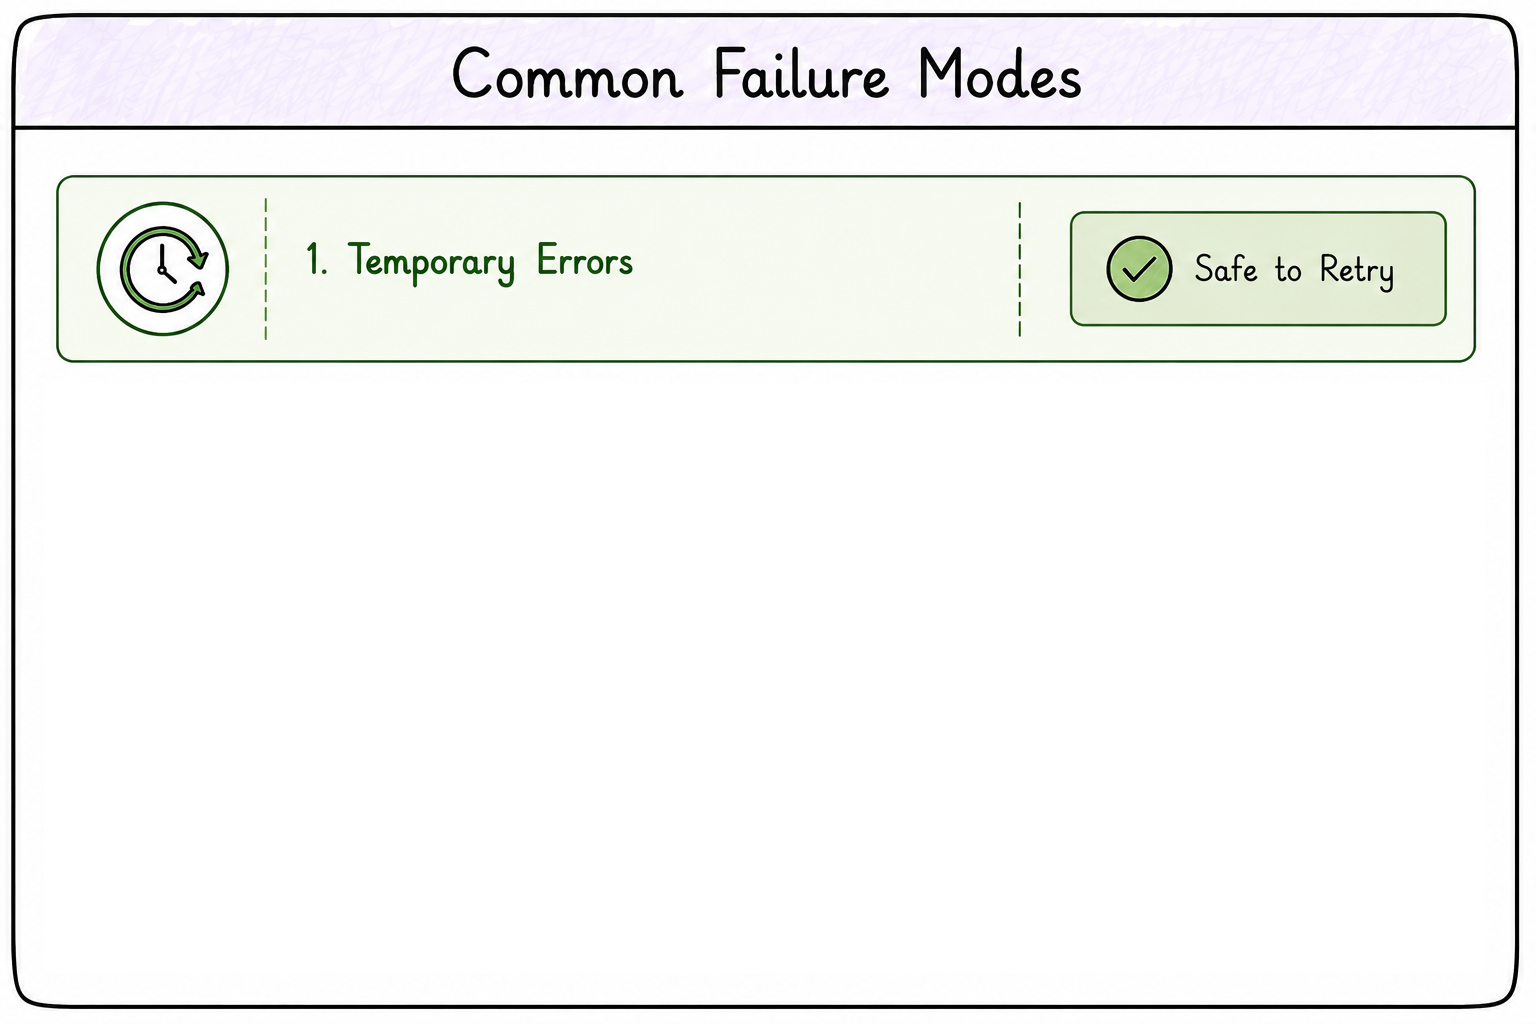
Verstehe die häufigen Fehlermodi:
Temporäre Fehler verschwinden von selbst, erneutes Versuchen ist meist sicher.
Timeouts
Verstehe die häufigen Fehlermodi:
Temporäre Fehler verschwinden von selbst, erneutes Versuchen ist meist sicher.
Timeouts: externer Dienst braucht zu lange für die Antwort.
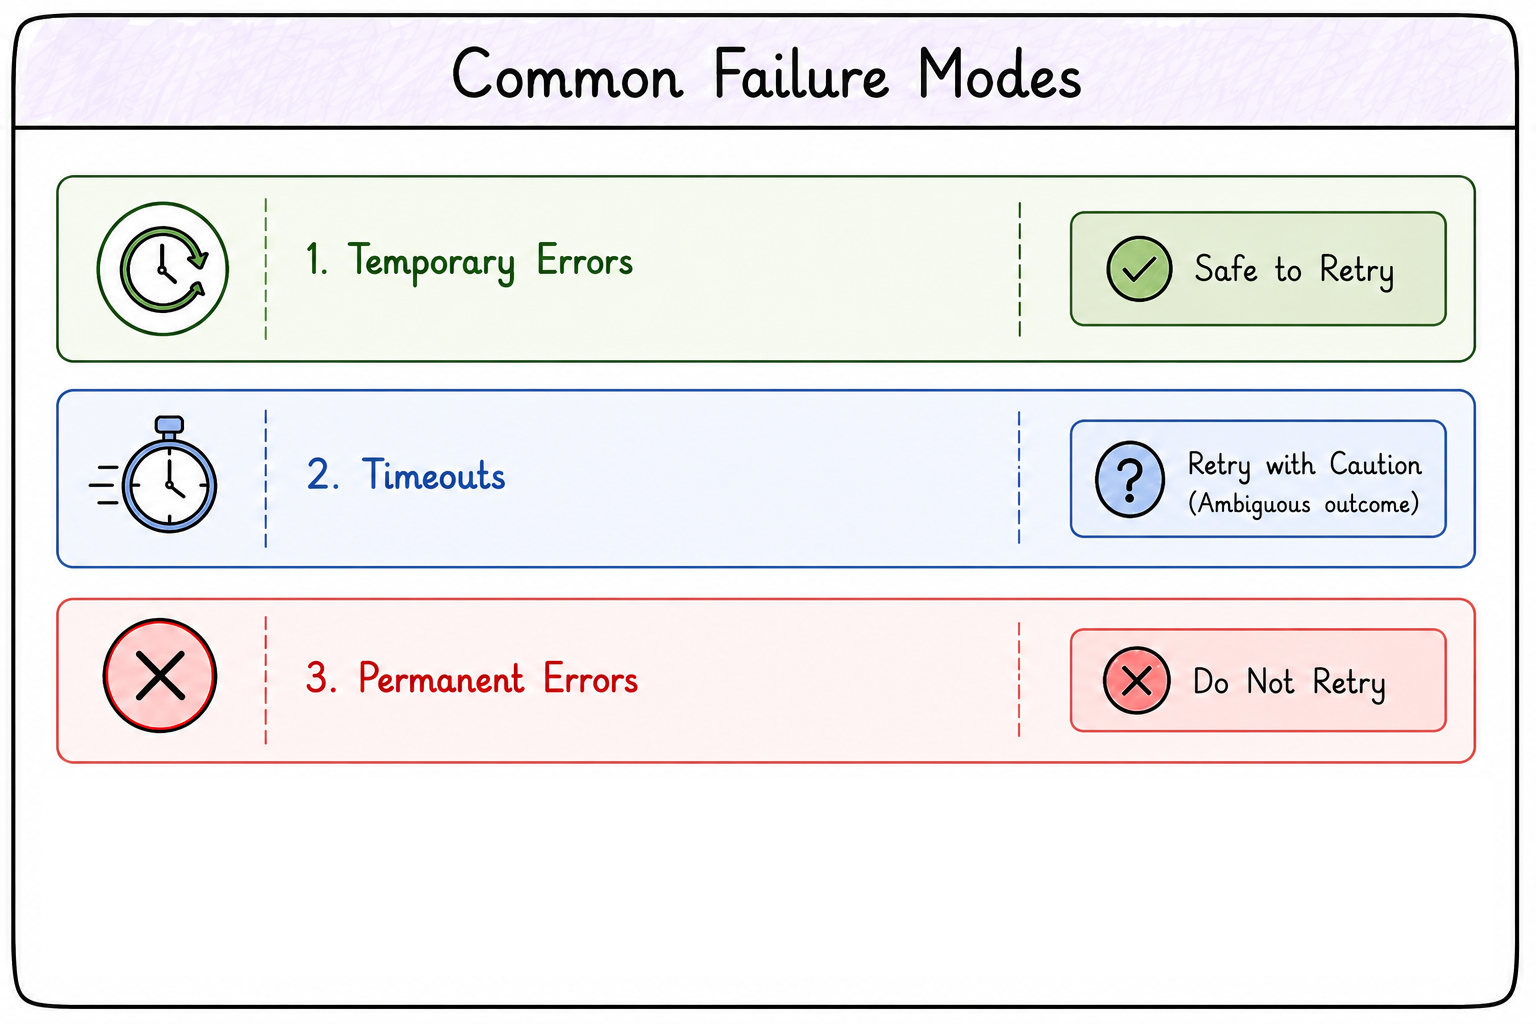
Permanente Fehler
Verstehe die häufigen Fehlermodi:
Temporäre Fehler verschwinden von selbst, erneutes Versuchen ist meist sicher.
Timeouts: externer Dienst braucht zu lange für die Antwort.
Permanente Fehler: Anfrage ist grundsätzlich fehlerhaft, erneutes Versuchen hilft nicht.
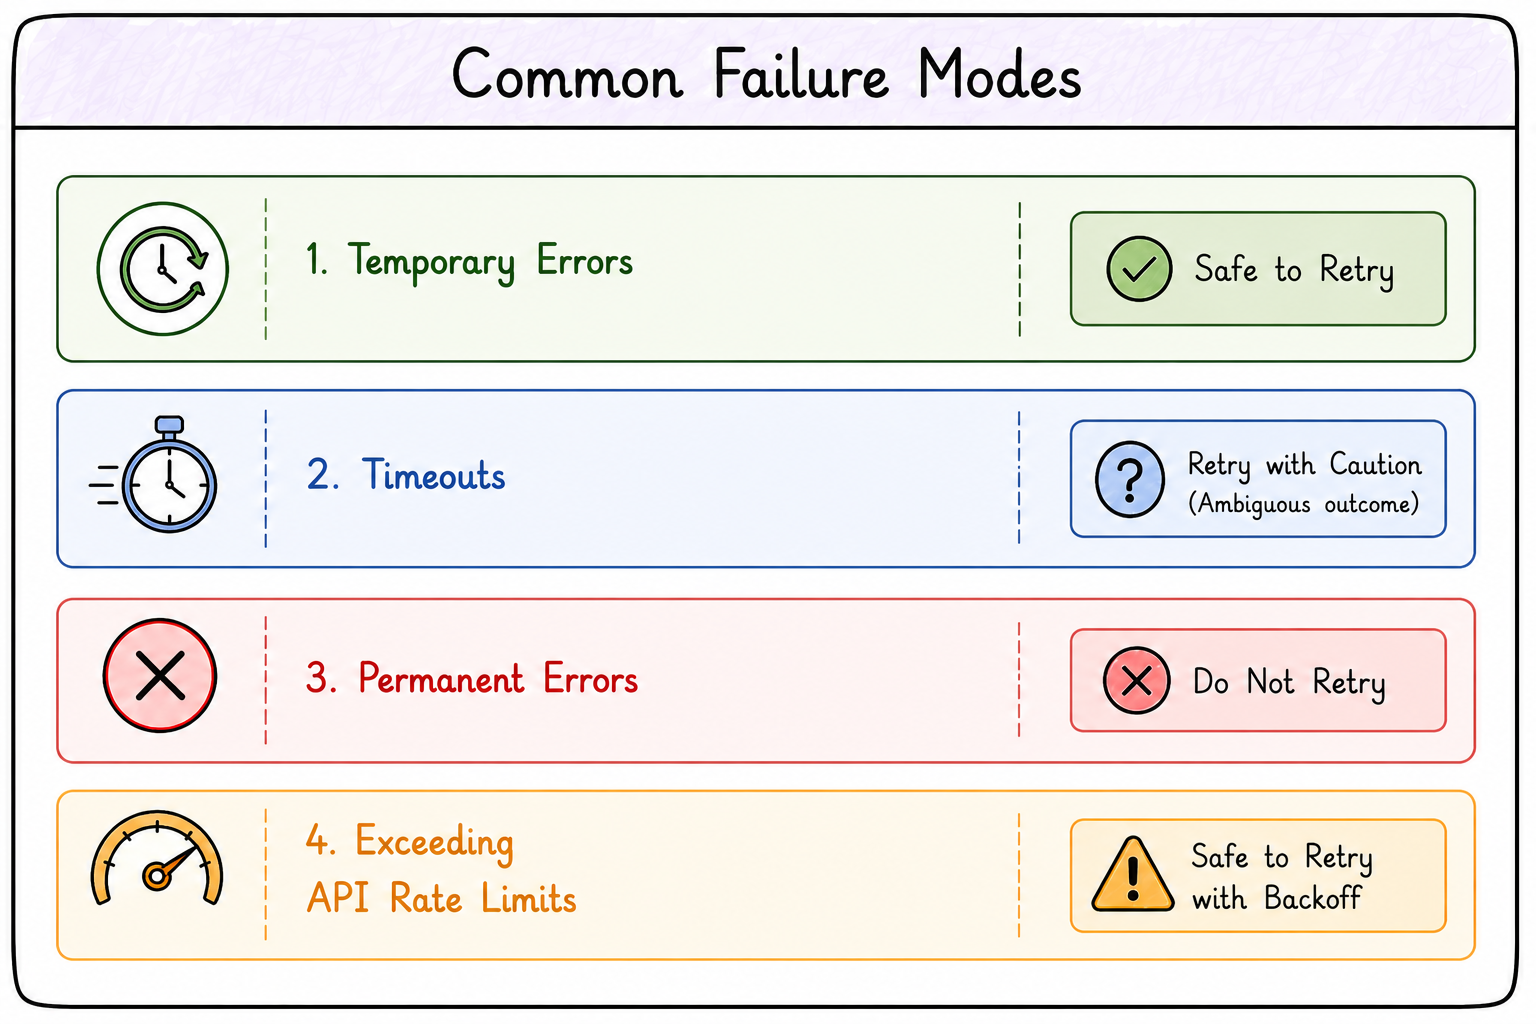
API-Limits
Verstehe die häufigen Fehlermodi:
Temporäre Fehler verschwinden von selbst, erneutes Versuchen ist meist sicher.
Timeouts: externer Dienst braucht zu lange für die Antwort.
Permanente Fehler: Anfrage ist grundsätzlich fehlerhaft, erneutes Versuchen hilft nicht.
API-Rate-Limits: zu viele Anfragen, erwarte HTTP 429 Too Many Requests.
Retry-Strategien
Ausfälle in verteilten Systemen sind oft temporär.
Eine wiederholte Anfrage klappt oft.
Füge Retry-Logik mit Bedacht hinzu, blinde Retries können es verschlimmern.
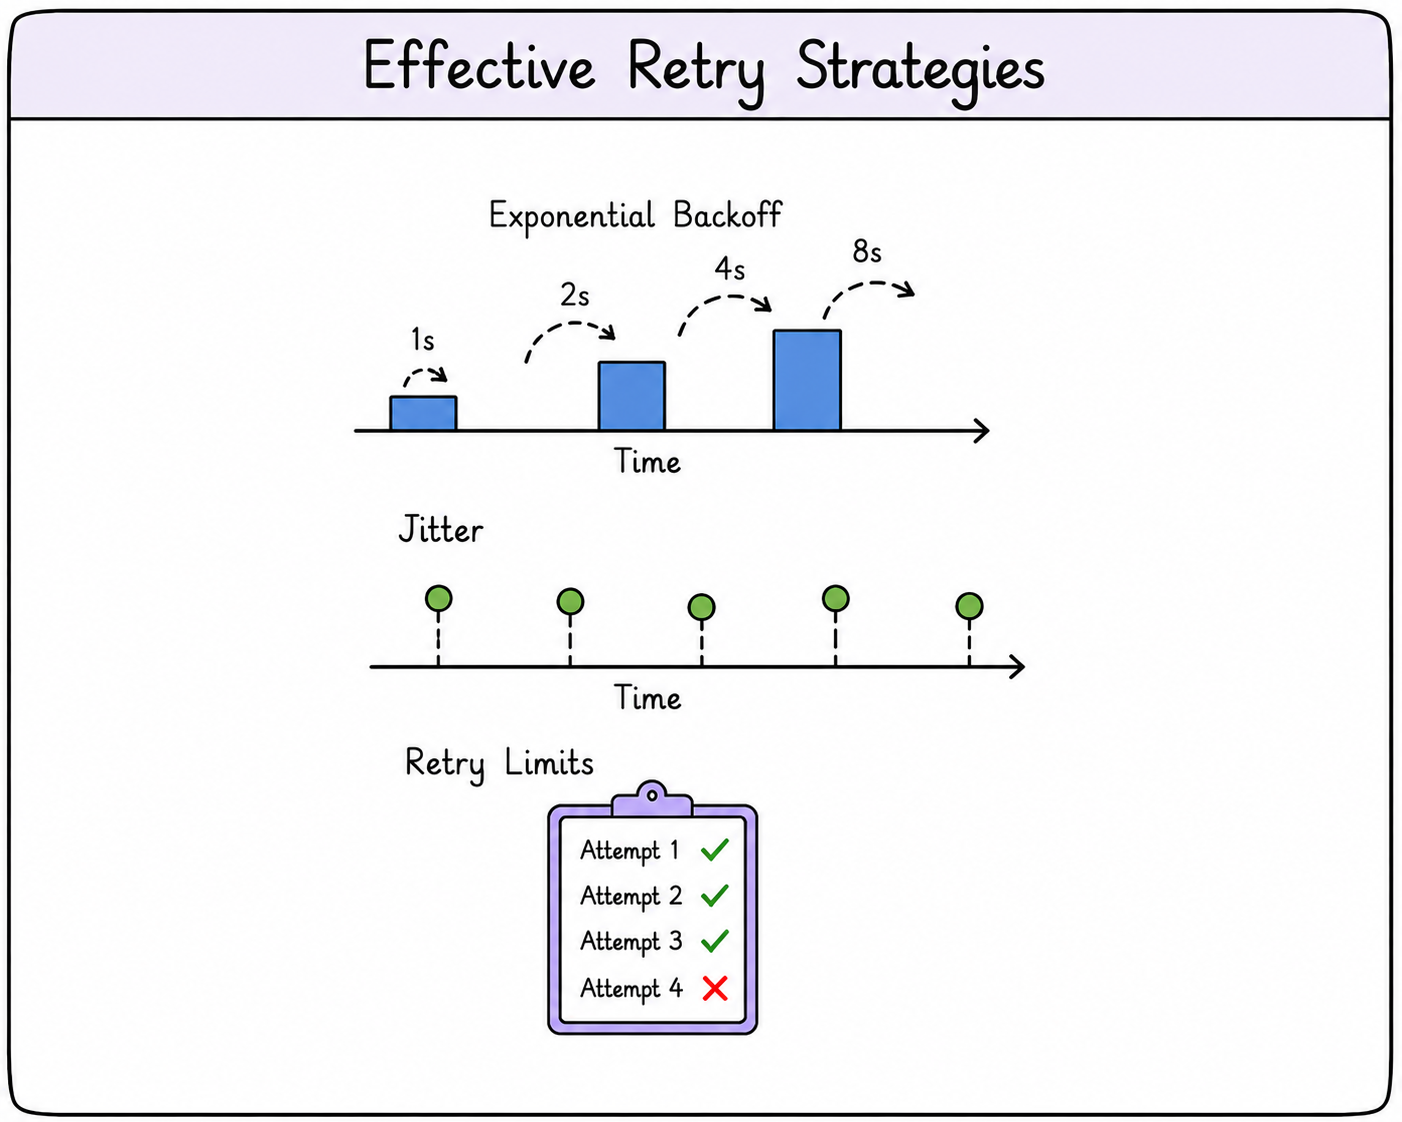
Exponentielles Backoff: Verzögerung zwischen Retries erhöhen.
Jitter: Zufall hinzufügen, um Retry-Spitzen zu vermeiden.
Retry-Limits: Endlosschleifen verhindern.
AWS SDK: native Funktionen
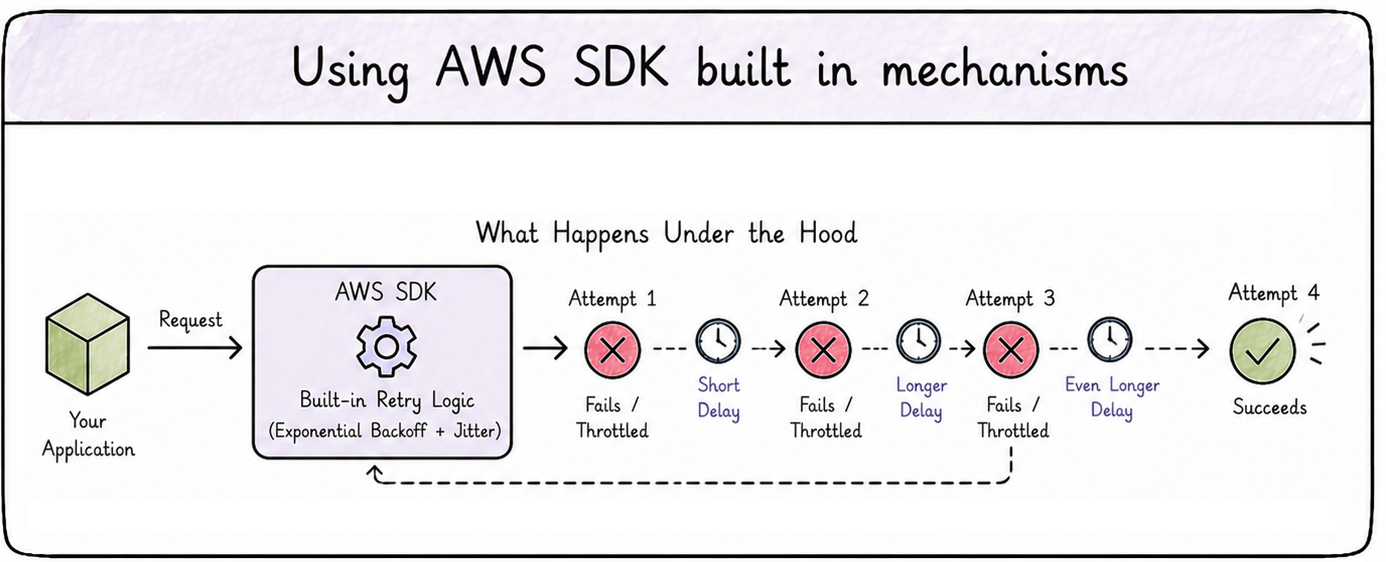
AWS SDKs übernehmen die Retry-Logik automatisch.
Eingebaute Retries enthalten exponentielles Backoff und Jitter.
Fehlgeschlagene oder gedrosselte Anfragen werden mit zunehmenden Pausen erneut gesendet.
Reduziert den Fehlerbehandlungscode, den du schreiben musst.
Retry-Logik steuern
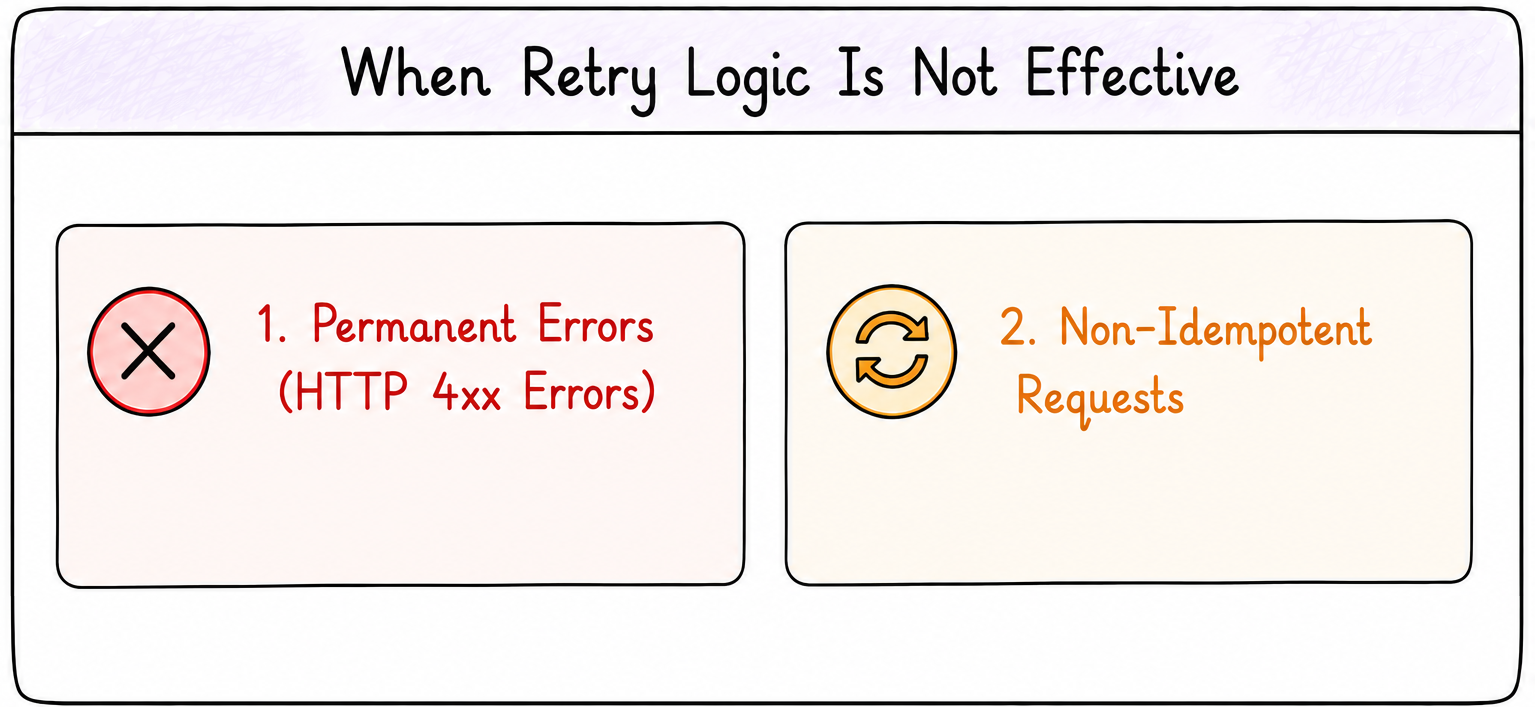
Retry-Logik ist nicht immer die Lösung.
HTTP-4xx-Fehler: Server hat verstanden und deine Anfrage abgelehnt.
Nicht idempotente Anfragen: erneutes Senden kann Duplikate oder Inkonsistenzen verursachen.
Timeouts verwalten
Unbegrenzte Retries können unter Last Probleme verstärken.
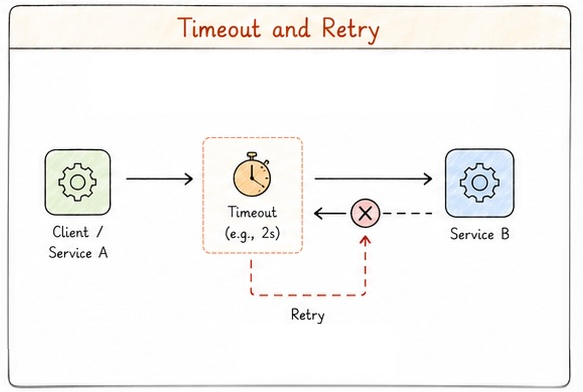
Kombiniere Retries mit Timeouts.
Ein Timeout setzt die maximale Wartezeit auf eine Antwort.
Jeder externe Service-Call sollte ein Timeout haben.
Circuit Breaker
Wenn ein Dienst ständig fehlschlägt, reichen Retries nicht.
Weiter Anfragen zu senden kann den fehlerhaften Dienst überlasten.
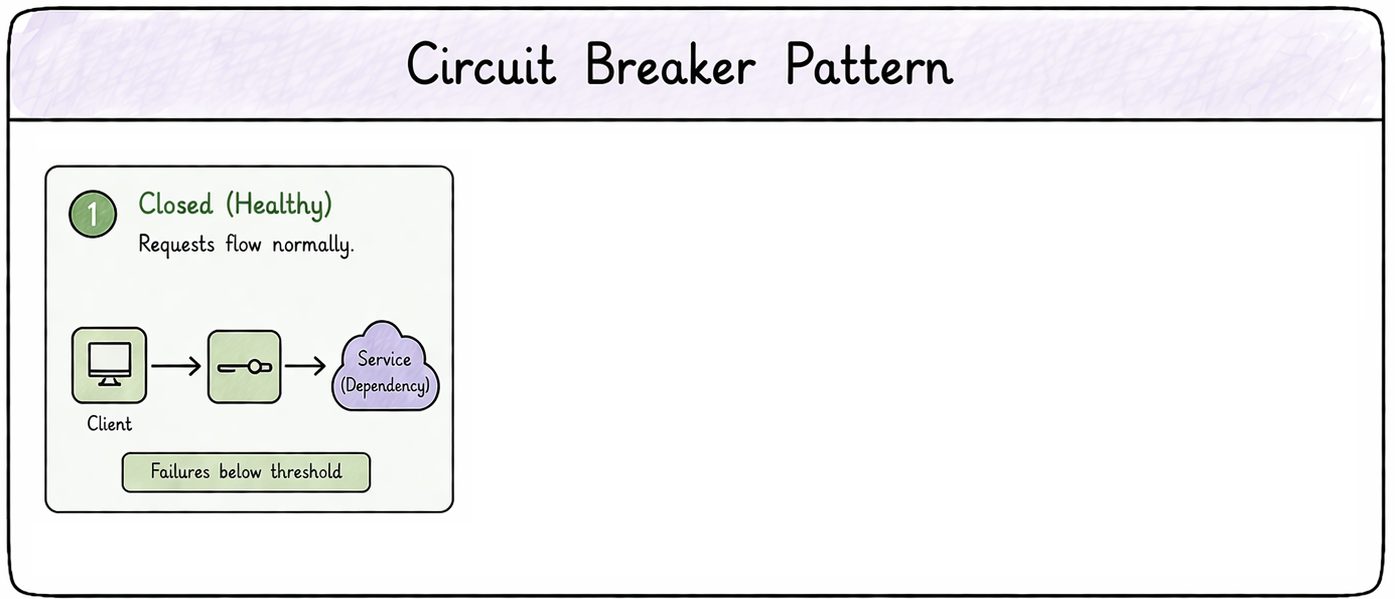
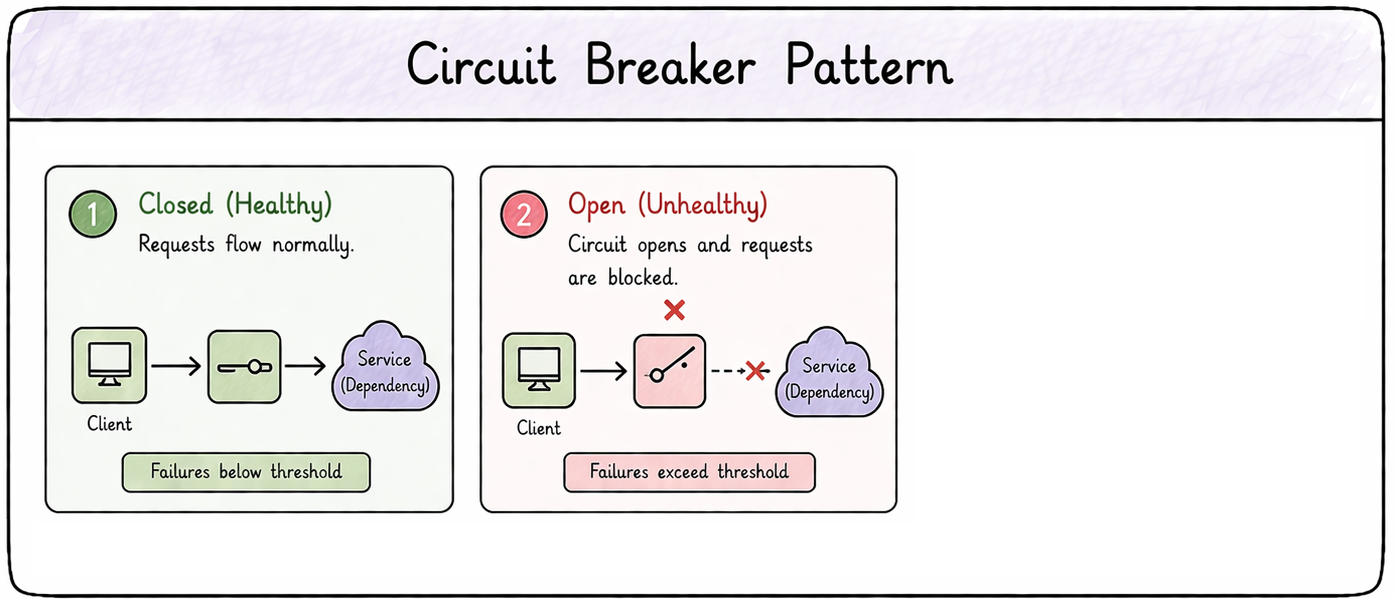
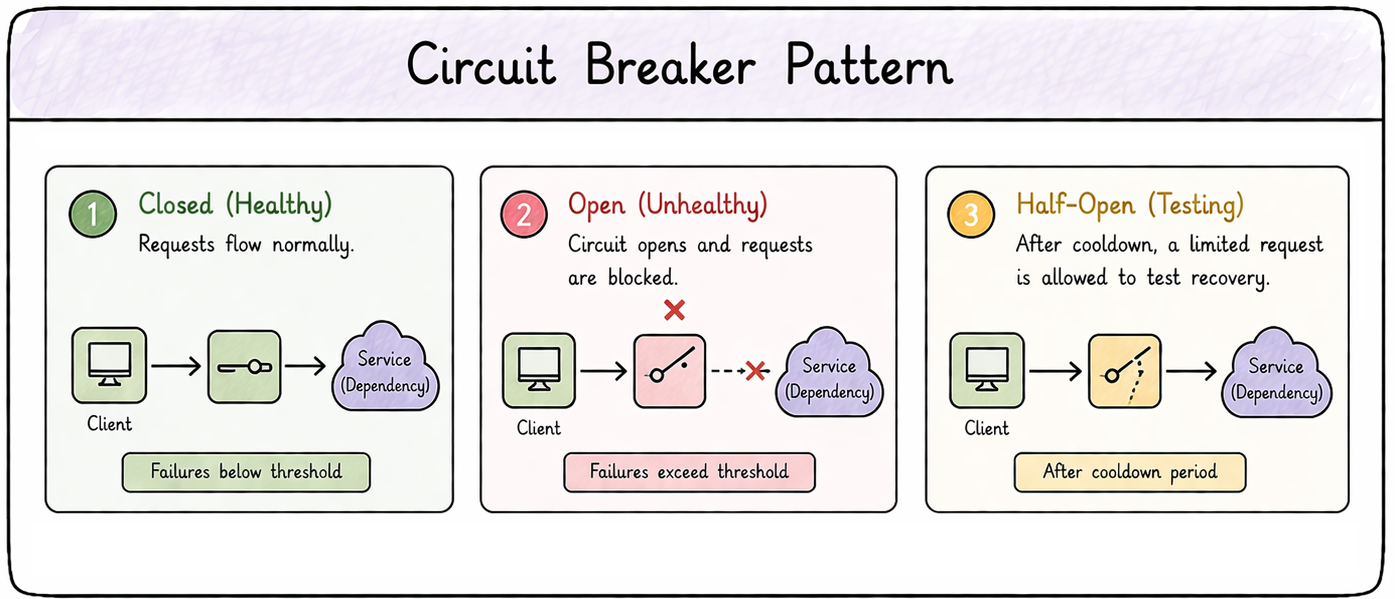
Das Circuit-Breaker-Muster stoppt Anfragen an eine ungesunde Abhängigkeit vorübergehend.
Geschlossener Zustand: Anfragen fließen normal.
Circuit Breaker
Überschreiten Ausfälle einen Schwellwert, öffnet der Circuit.
Nachfolgende Anfragen werden blockiert.
Circuit Breaker
Nach einer Abkühlphase geht der Circuit halb offen, um die Erholung zu testen.
Dienst antwortet erfolgreich: Normalbetrieb läuft weiter.
Weiterhin Fehler: Circuit bleibt offen.
Implementiere Circuit Breaker auf Anwendungsebene.
Dead Letter Queues
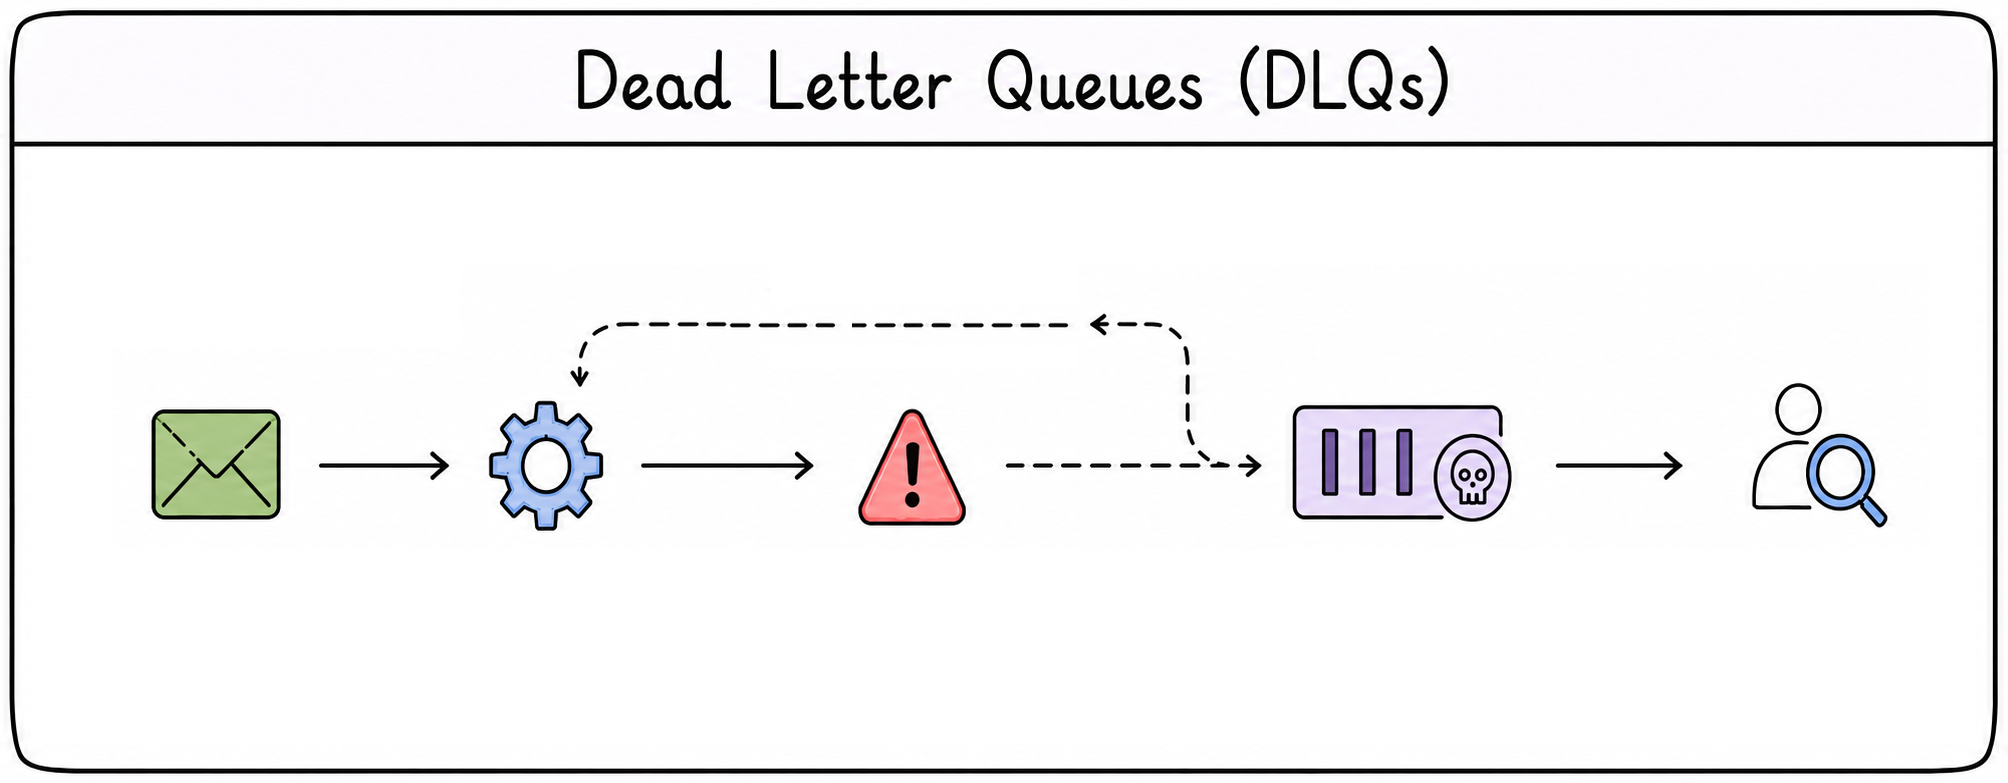
Nachrichten, die ständig fehlschlagen, können das System blockieren.
Verschiebe sie aus dem Hauptverarbeitungsfluss.
Fehlgeschlagene Nachrichten landen in einer Dead Letter Queue.
Wichtiger Baustein für resiliente Anwendungen.
Verstehe jedoch die Trade-offs
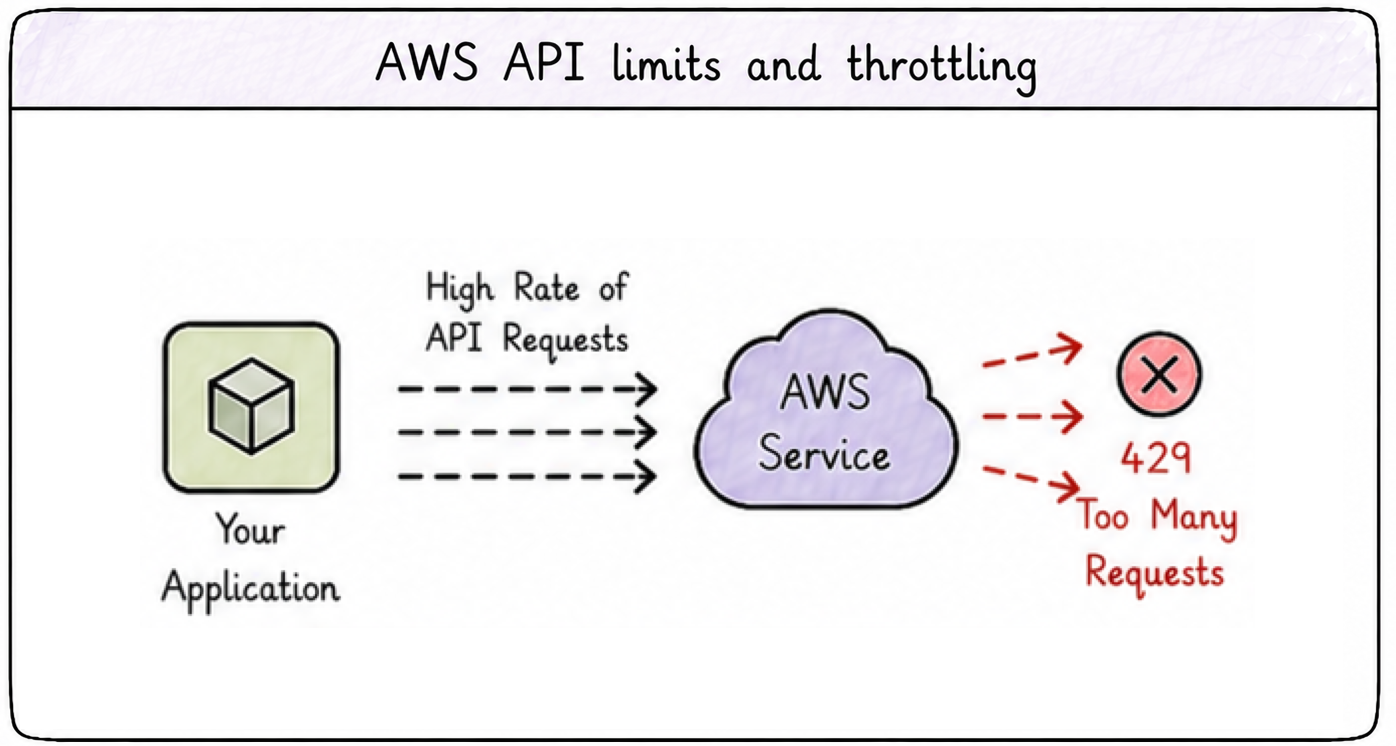
AWS API-Limits
Du interagierst über APIs mit AWS-Services.
Jeder Service definiert eigene API-Rate-Limits.
Überschreitungen führen zu Drosselung (HTTP 429 Too Many Requests).
Entwirf deine Anwendung so, dass sie Drosselung sauber verarbeitet.
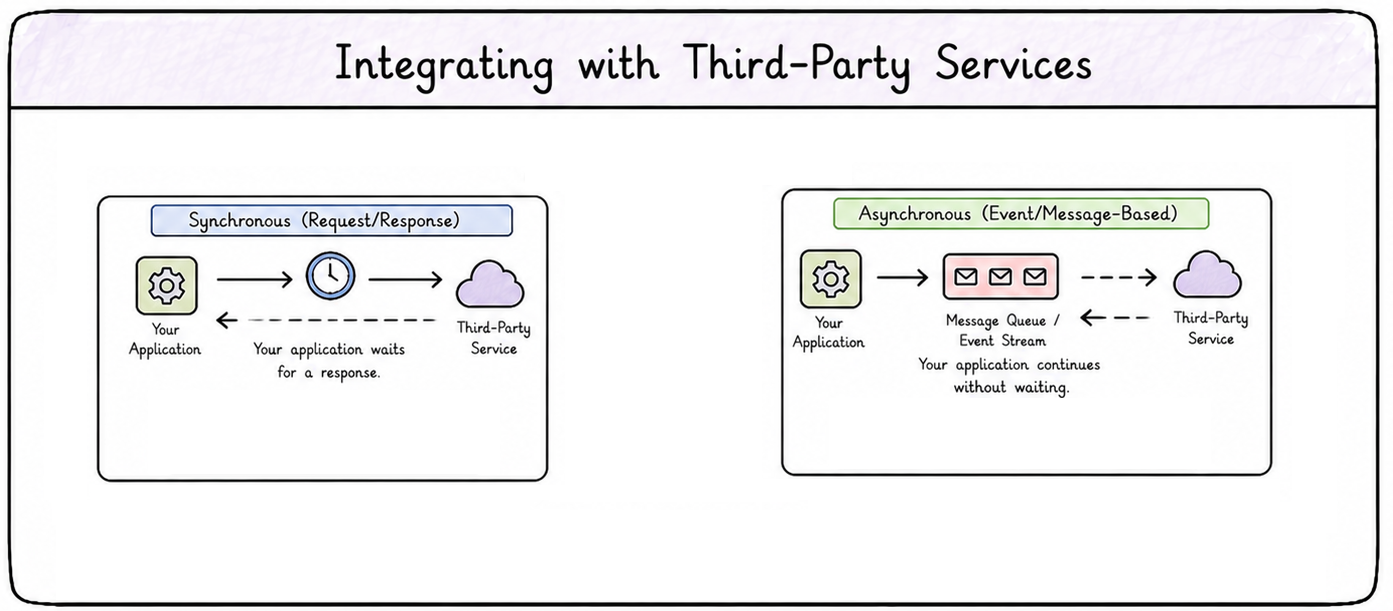
Integration mit Drittanbieter-Diensten
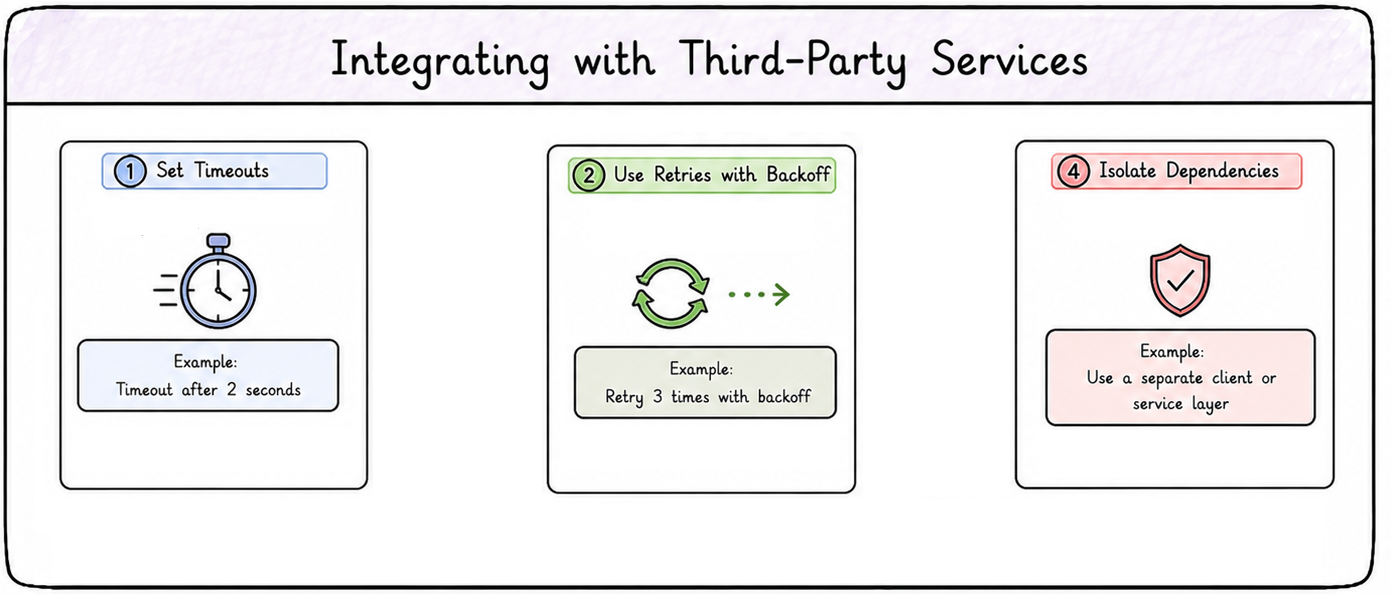
Drittanbieter-Dienste bringen Unsicherheit.
Du hast keine Kontrolle über deren Leistung oder Verfügbarkeit.
Setze Timeouts, um lange Wartezeiten zu vermeiden.
Nutze Retries mit Backoff bei temporären Problemen.
Isoliere Abhängigkeiten, um den Einschlagradius zu begrenzen.
Integration mit Drittanbietern
Denke über den Wechsel von synchroner zu asynchroner Kommunikation nach.
Dein System verarbeitet weiter, auch wenn der externe Dienst verzögert ist.
Lass uns üben!
Anwendungen auf AWS entwickeln
Preparing Video For Download...