Streaming-Daten

Anwendungen auf AWS entwickeln

Ricardo Sueiras

Principal Technologist

Grundlagen von Streaming-Daten
 

Streaming-Daten

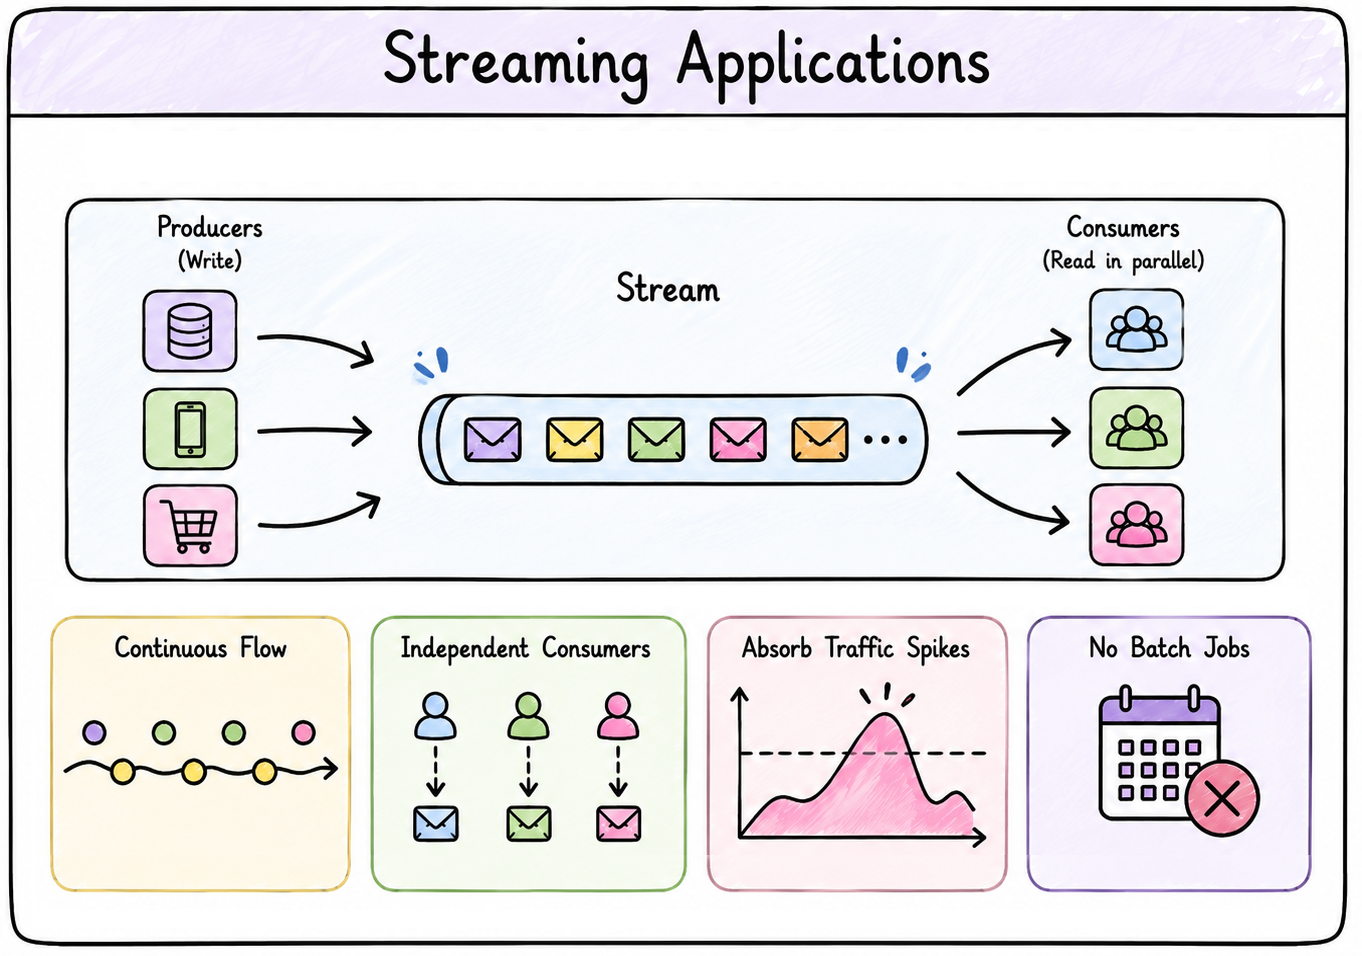
  • Datensätze werden bei Eingang kontinuierlich verarbeitet.
  • Producer schreiben in einen Stream.
  • Consumer lesen unabhängig und parallel.
  • Fängt Verkehrsspitzen ab, ohne auf Batch-Jobs zu warten.
Anwendungen auf AWS entwickeln

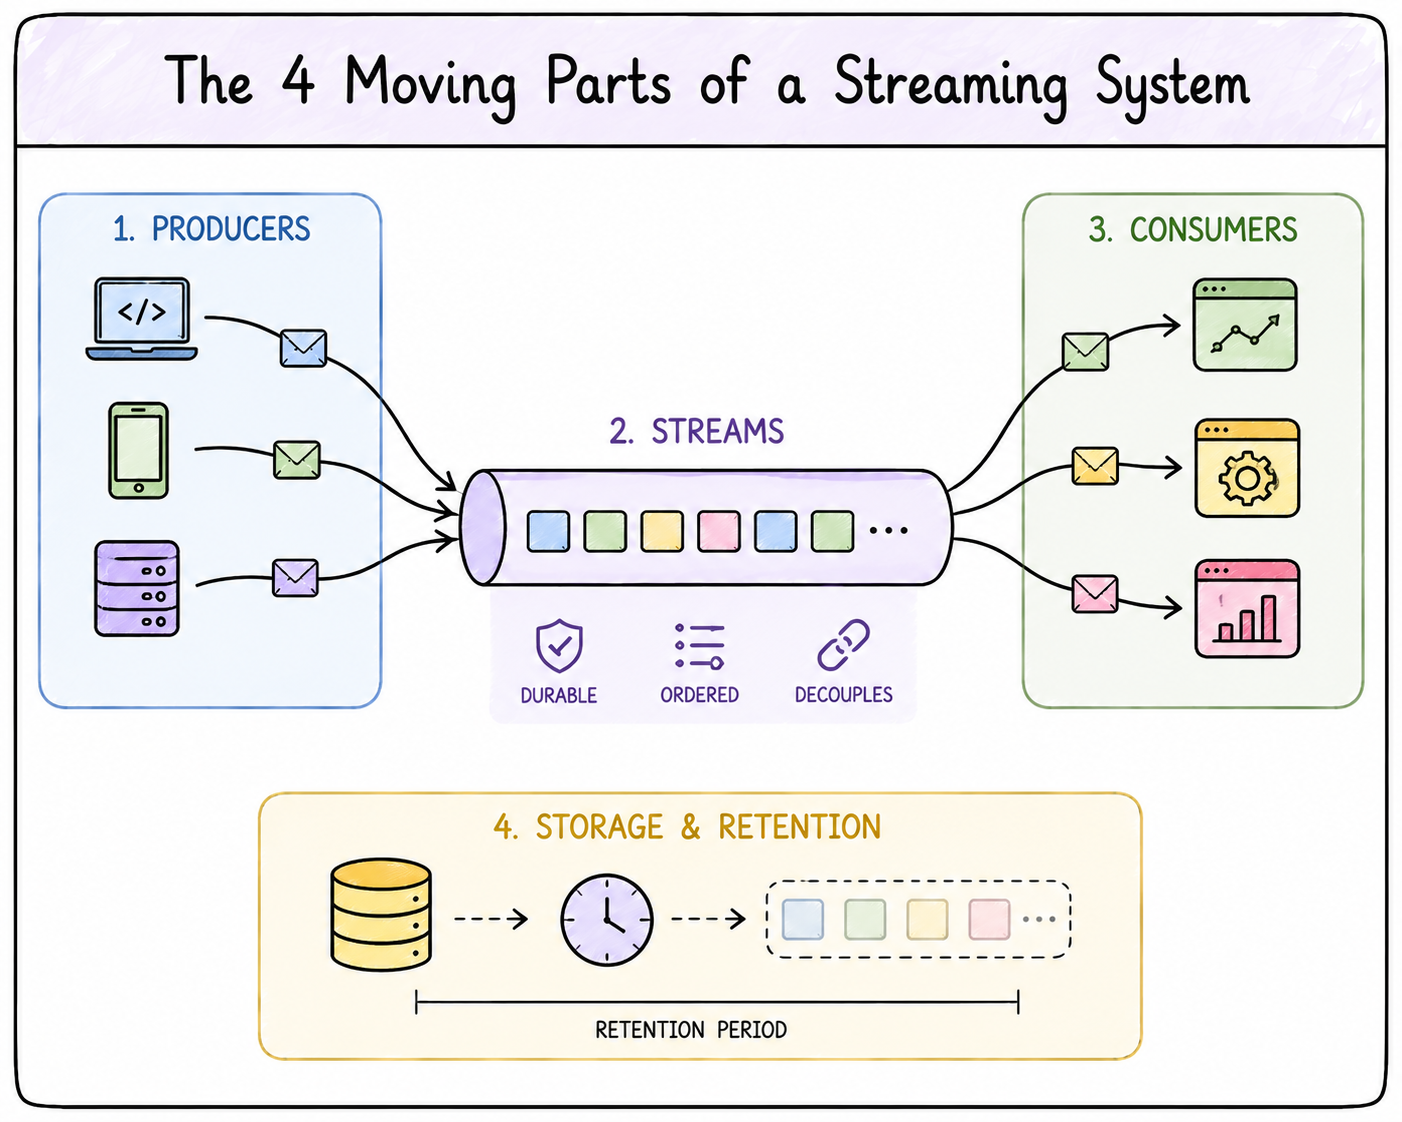
Woraus bestehen Streaming-Daten?


Komponenten eines Streaming-Systems

  • Producer: Anwendungen, die Datensätze erzeugen.
  • Streams: dauerhafte, geordnete Puffer, die Producer von Consumern entkoppeln.
  • Consumer: Anwendungen, die Datensätze lesen und verarbeiten.
  • Speicherung und Aufbewahrung: definiert, wie lange Datensätze zum Replay verfügbar sind.
Anwendungen auf AWS entwickeln

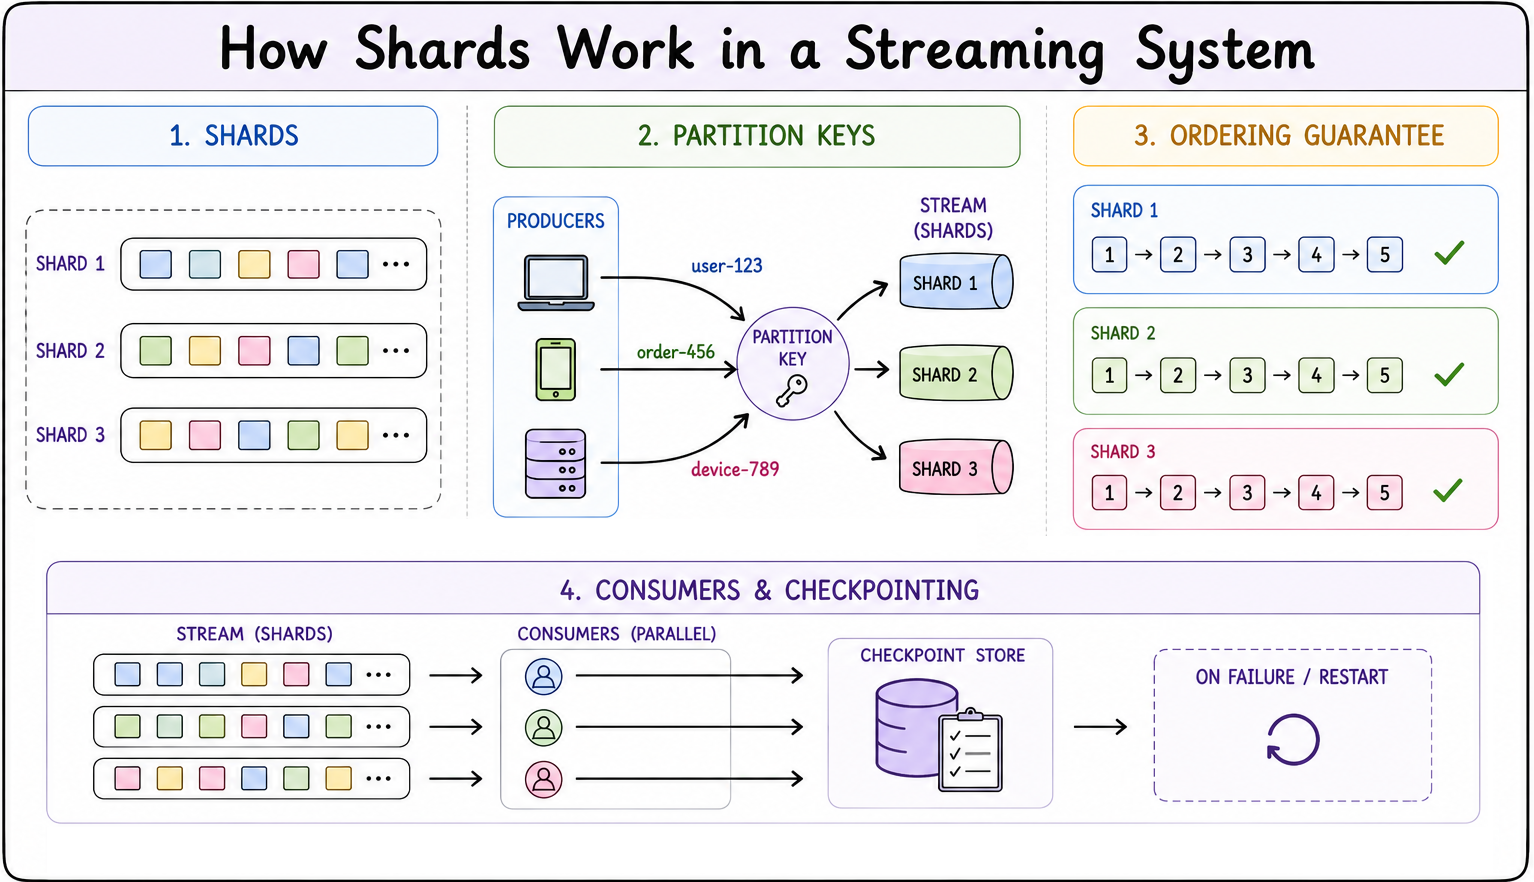
Shards


Shards


  • Shards sind Einheiten für Durchsatz und Parallelverarbeitung.
  • Partition Keys verteilen Datensätze auf Shards.
  • Ordnung ist nur innerhalb eines Shards garantiert.
  • Consumer nutzen Checkpointing, um Fortschritt zu verfolgen und Ausfälle zu beheben.
Anwendungen auf AWS entwickeln

Verwaltete AWS-Services für Streaming-Daten
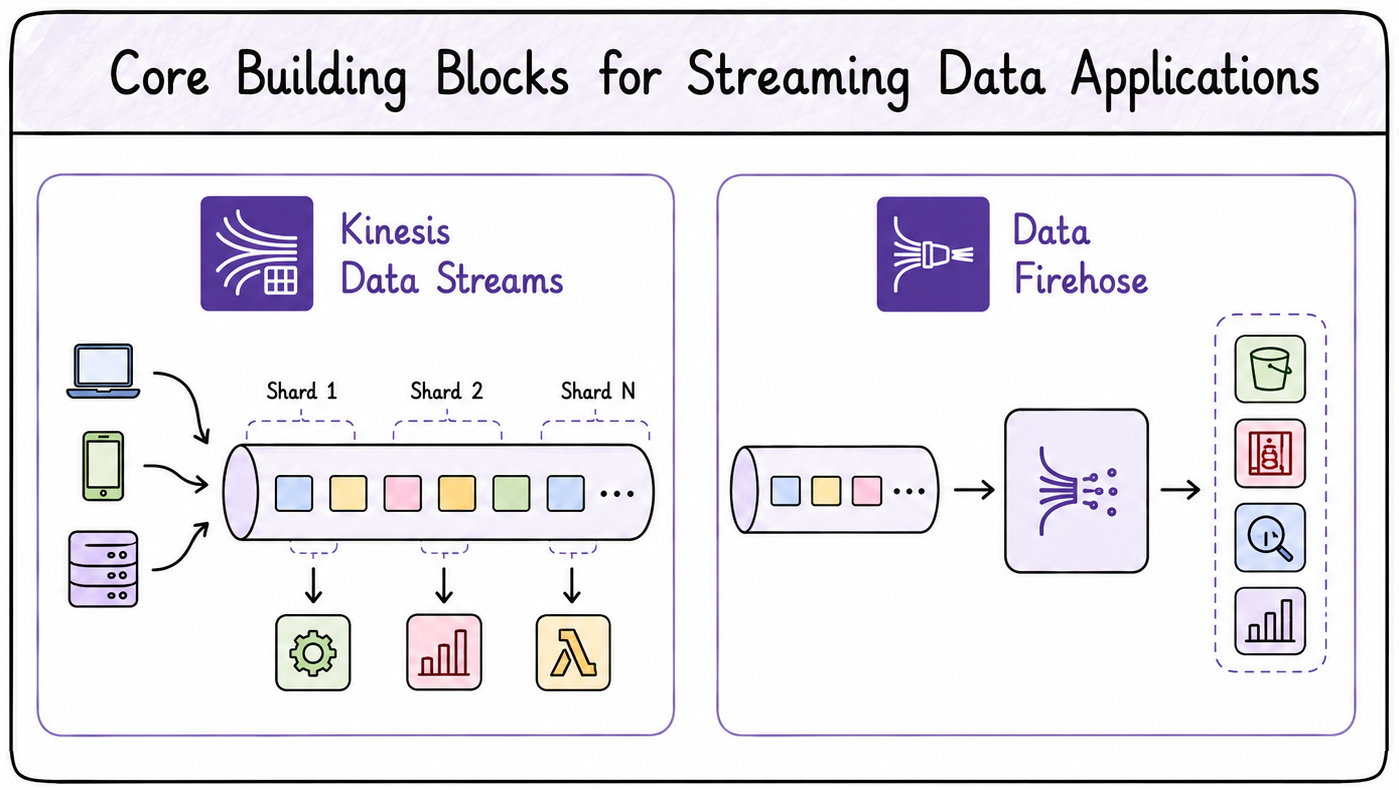
  • Amazon Kinesis Data Streams.
  • Amazon Data Firehose.
  • Zentrale Bausteine für Streaming-Datenanwendungen.


AWS-Services

Anwendungen auf AWS entwickeln

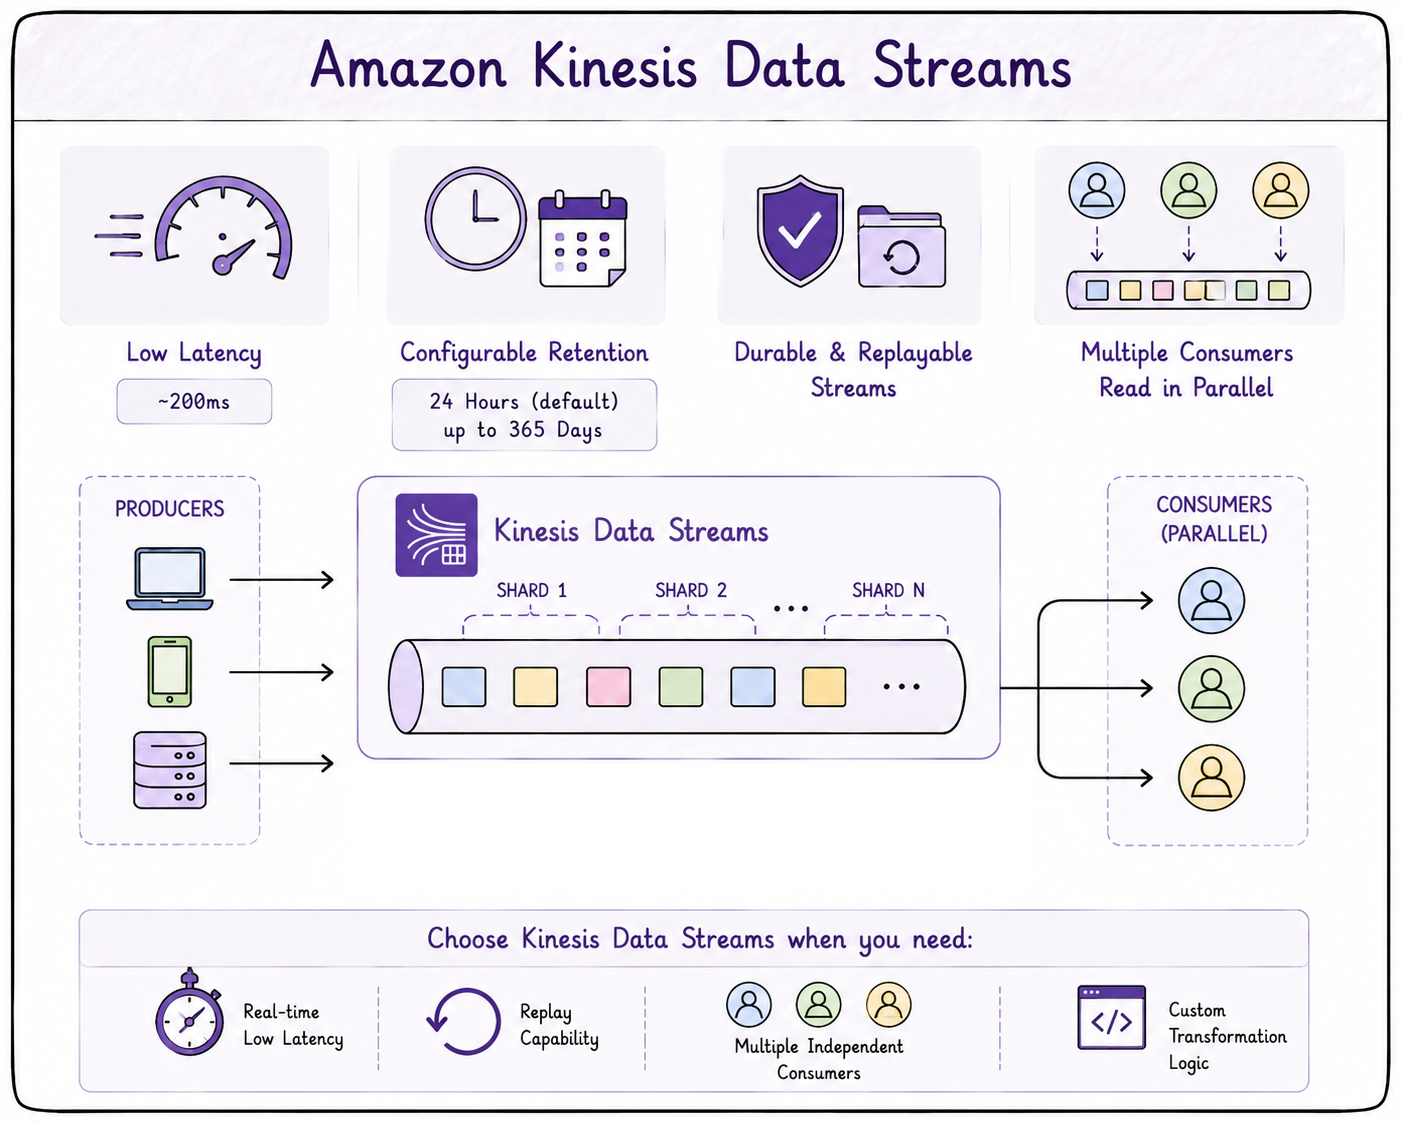
Kinesis Data Streams

  • Streaming mit niedriger Latenz.
  • Konfigurierbare Aufbewahrung: 24 Stunden (Standard) bis 365 Tage.
  • Dauerhafte, wiederholbare Streams.
  • Mehrere Consumer können parallel lesen.
  • Entwickler skalieren über Shards.


Kinesis Data Streams

Anwendungen auf AWS entwickeln

Wann Kinesis Data Streams verwenden

  • Wähle es bei Bedarf nach Echtzeit-Latenz.
  • Du brauchst Replays von Datensätzen.
  • Du hast mehrere unabhängige Consumer.
  • Du benötigst eigene Transformationslogik.


Kinesis Data Streams

Anwendungen auf AWS entwickeln

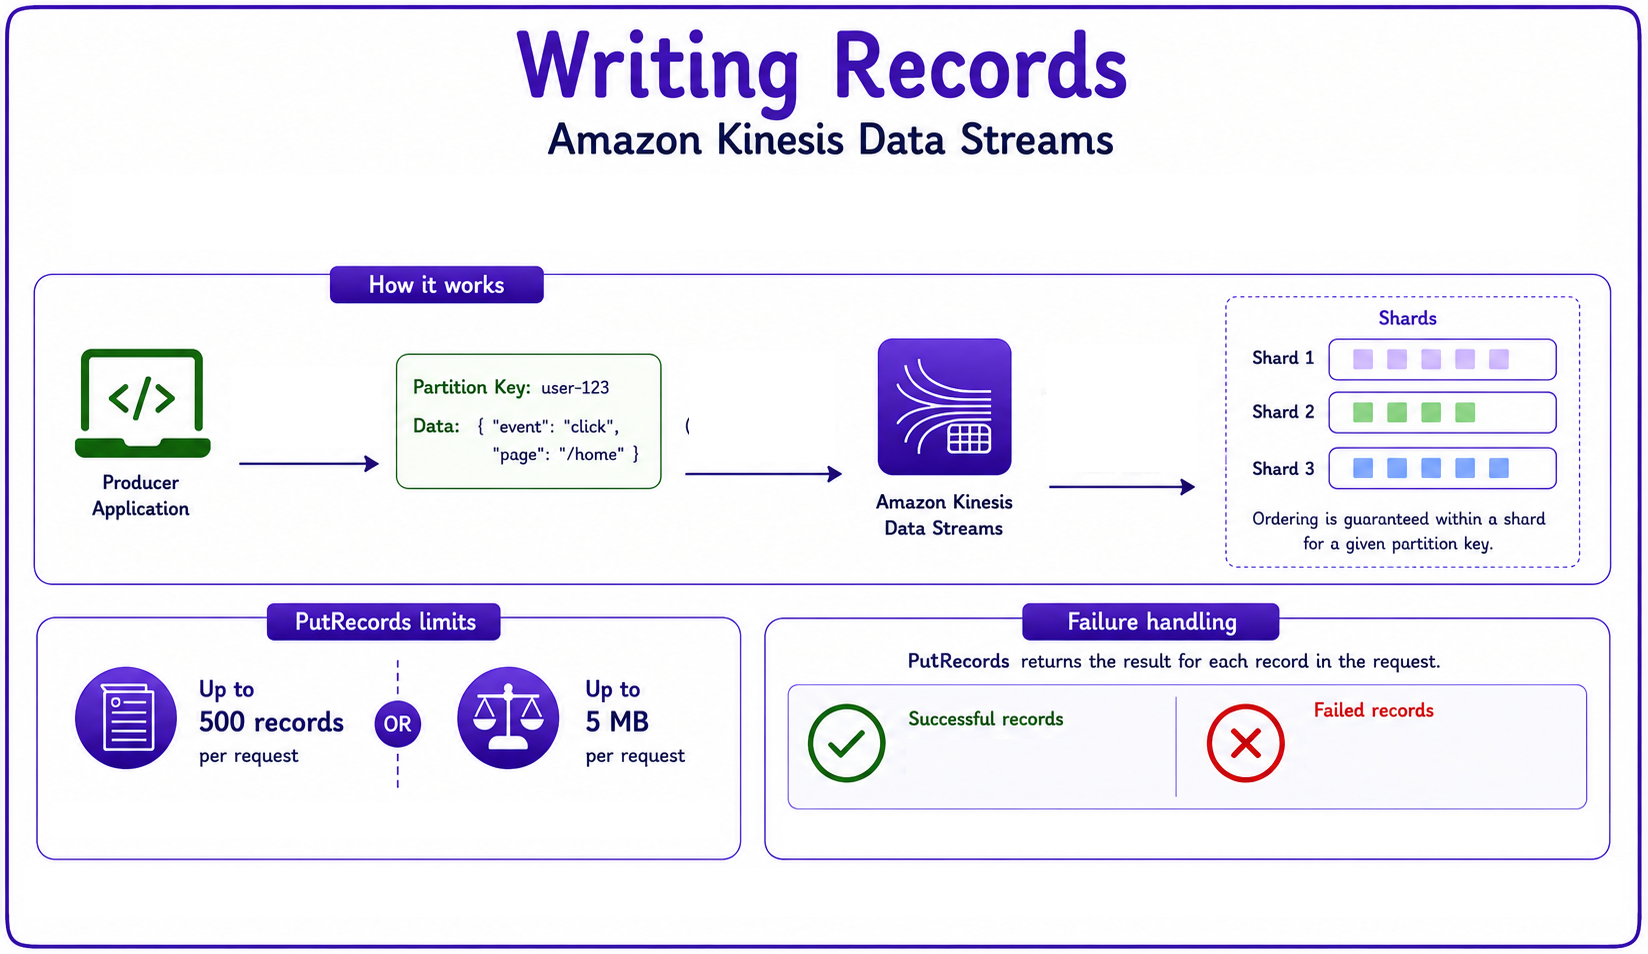
Datensätze schreiben


Client-Bibliotheken

  • Partition Keys steuern Shard-Zuordnung und Ordnung.
  • PutRecords bündelt bis zu 500 Datensätze oder 5 MB pro Request.
  • Fehler werden pro Datensatz gemeldet.
  • FailedRecordCount hilft, fehlerhafte Datensätze zu identifizieren.
Anwendungen auf AWS entwickeln

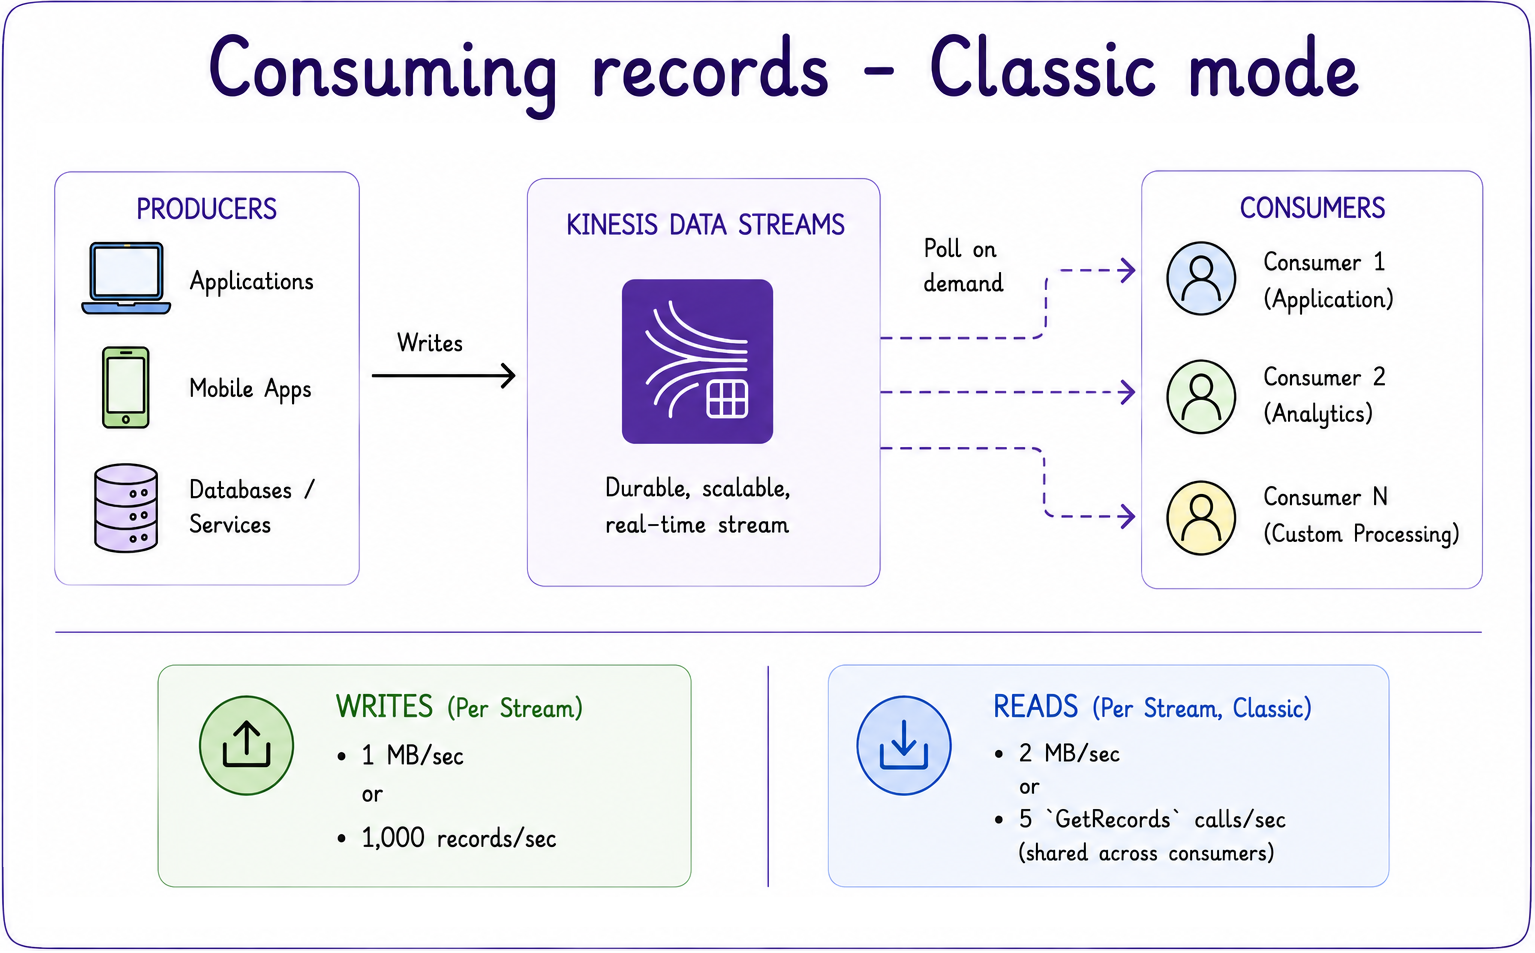
Datensätze konsumieren: Classic


classic


  • Consumer pollen bedarfsgesteuert über die Kinesis-API.
  • Schreiblimits: 1 MB/s oder 1.000 Datensätze/s.
  • Leselimits: 2 MB/s oder 5 GetRecords-Aufrufe/s.
Anwendungen auf AWS entwickeln

Datensätze konsumieren: Startpunkt im Stream
 

stream-start

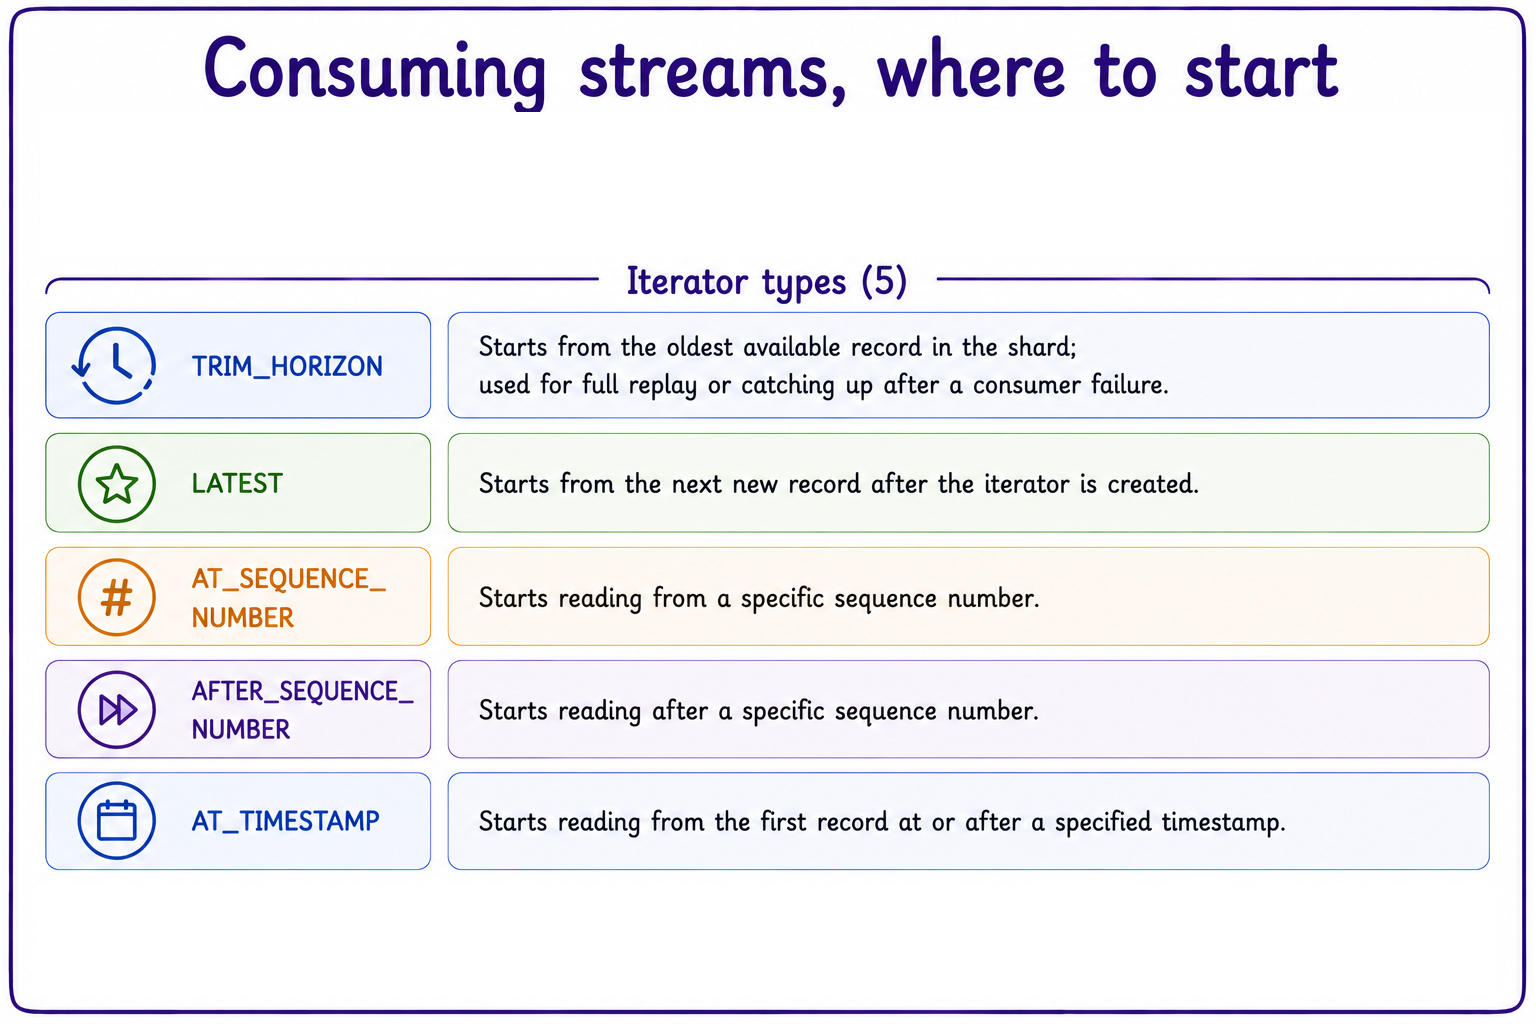
  • Consumer geben an, wo im Stream sie zu lesen beginnen.
  • TRIM_HORIZON: ältester verfügbarer Datensatz im Shard.
  • LATEST: der nächste neue Datensatz.
  • AT_SEQUENCE_NUMBER oder AFTER_SEQUENCE_NUMBER: ab einer bestimmten Sequenznummer.
  • AT_TIMESTAMP: ab einem angegebenen Zeitstempel.
Anwendungen auf AWS entwickeln

Datensätze konsumieren: Enhanced Fan-out
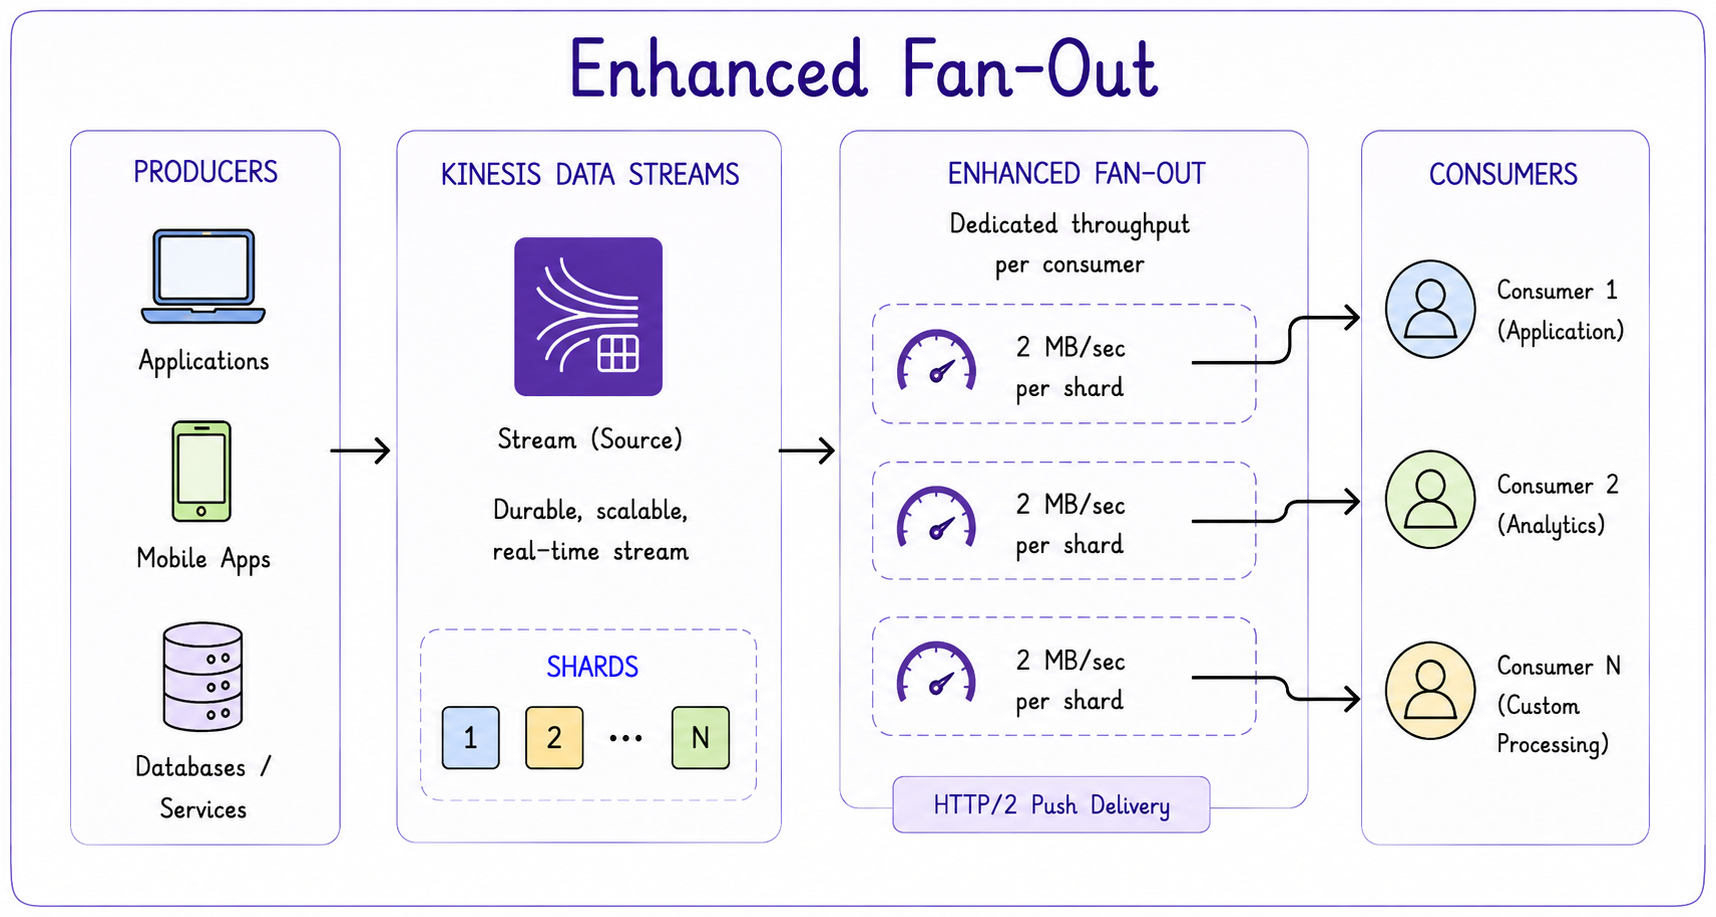
  • Jeder registrierte Consumer erhält dediziert 2 MB/s pro Shard.
  • Datensätze werden per HTTP/2-Push zugestellt.
  • Nutze es, wenn mehrere unabhängige Consumer niedrige Latenz brauchen.
  • Und hohen Durchsatz zum selben Stream.


Muster – Enhanced Fan-out

Anwendungen auf AWS entwickeln

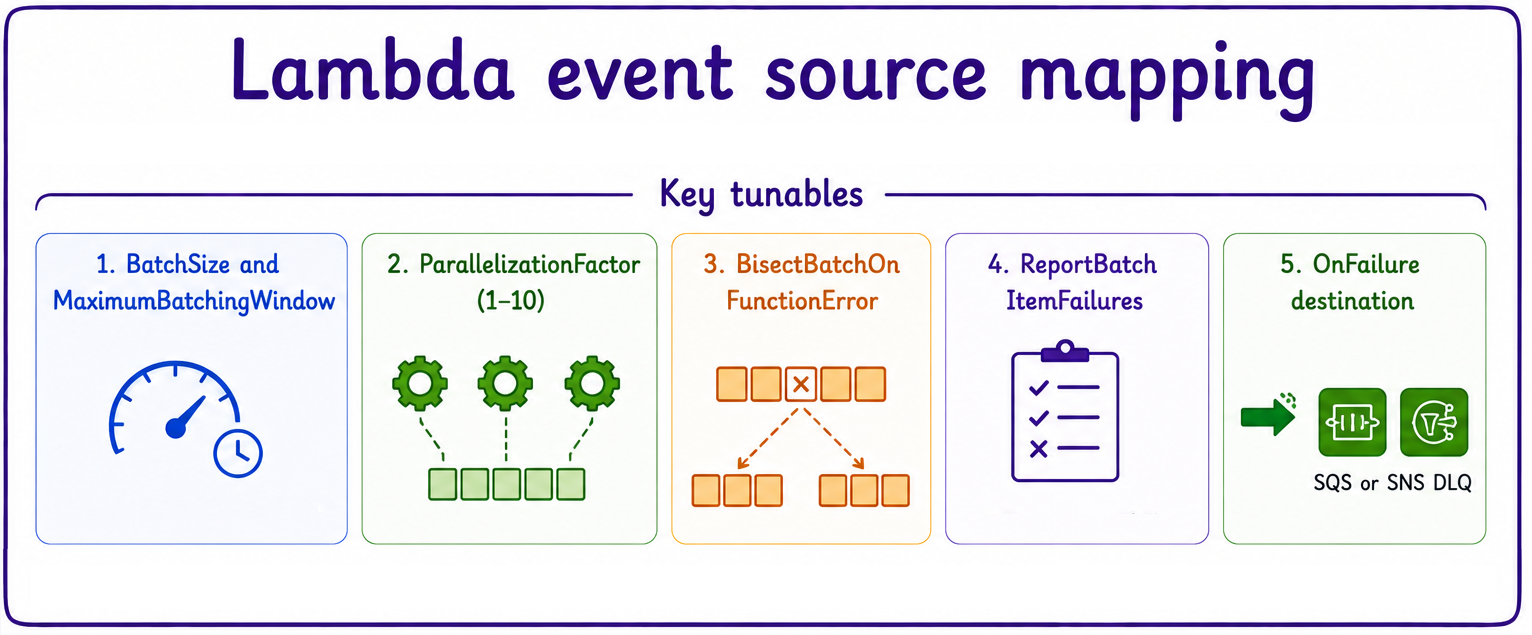
Lambda-Event-Source-Mapping

  • Lambda pollt Kinesis und ruft in Batches auf.
  • BatchSize und MaximumBatchingWindow steuern die Batch-Form.
  • ParallelizationFactor: gleichzeitige Aufrufe pro Shard.
  • BisectBatchOnFunctionError: teilt fehlerhafte Batches, um „Poison Pills" zu isolieren.
  • ReportBatchItemFailures: vermeidet erneutes Verarbeiten bereits erfolgreicher Datensätze.
  • OnFailure: sendet nicht verarbeitbare Batches an eine SQS- oder SNS-DLQ.


Lambda Event Sourcing

Anwendungen auf AWS entwickeln

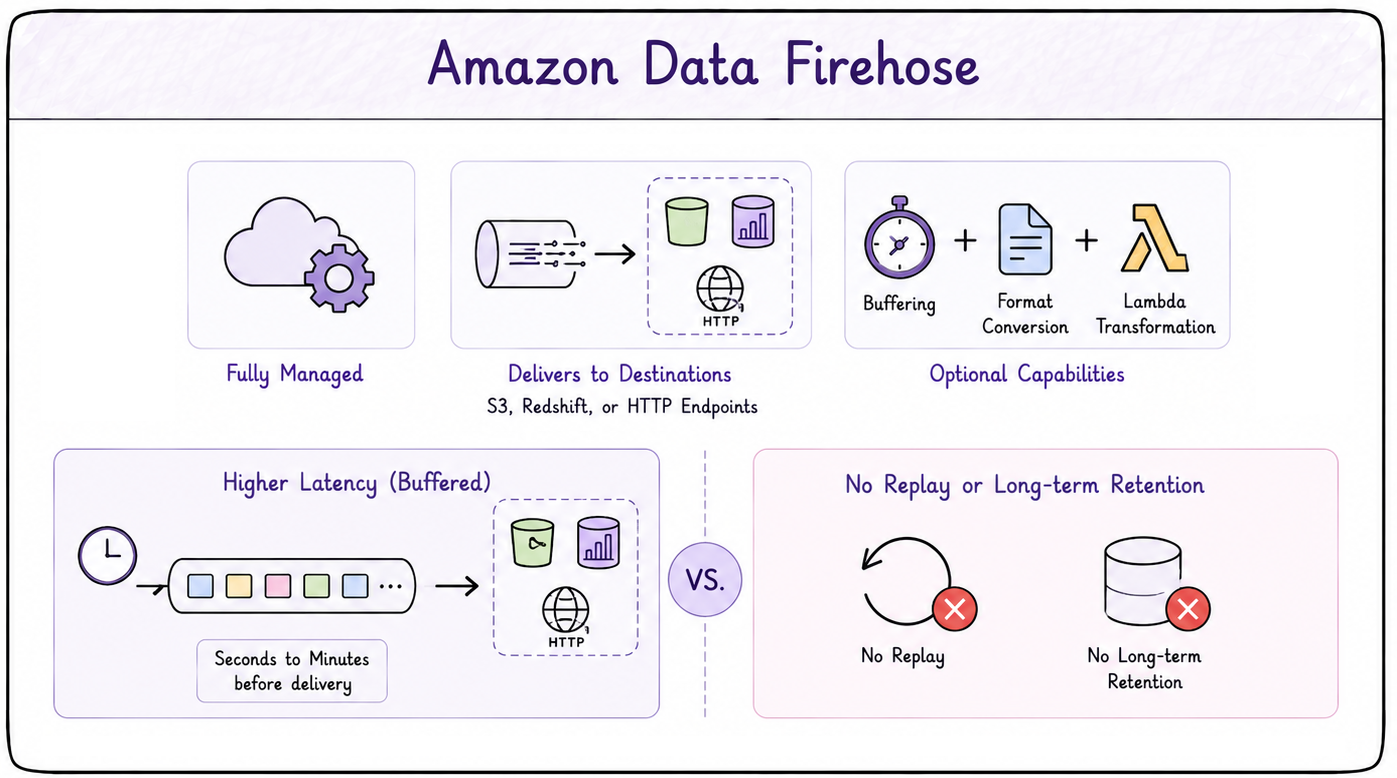
Data Firehose

  • Verwalteter Service, der Streaming-Daten an Ziele liefert.
  • Ziele umfassen Amazon S3, Redshift und HTTP-Endpunkte.
  • Unterstützt Pufferung, Formatkonvertierung und Lambda-Transformationen.
  • Höhere Latenz, gepuffert für Sekunden bis Minuten.
  • Kein Replay oder langfristige Aufbewahrung.
  • Ideal, um Daten einfach an ein Ziel zu bringen.


Data Firehose

Anwendungen auf AWS entwickeln

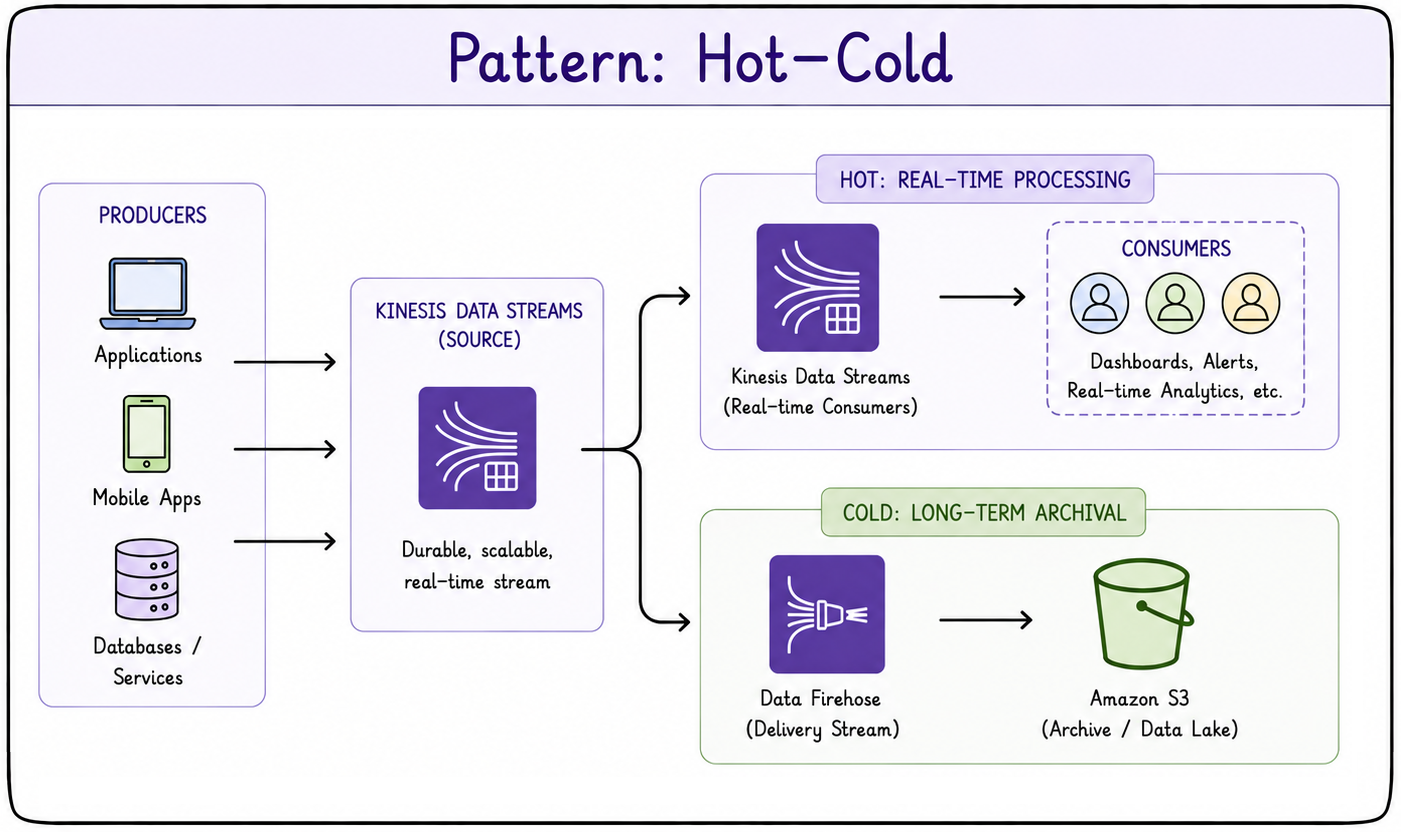
Muster: Hot-Cold


Muster – Hot/Cold


  • Hot-Cold-Muster kombiniert Data Streams und Data Firehose.
  • Data Streams ermöglicht Echtzeitverarbeitung für Producer.
  • Firehose archiviert Datensätze aus derselben Quelle in S3.
Anwendungen auf AWS entwickeln

Kinesis vs. SQS


sqs vs kinesis


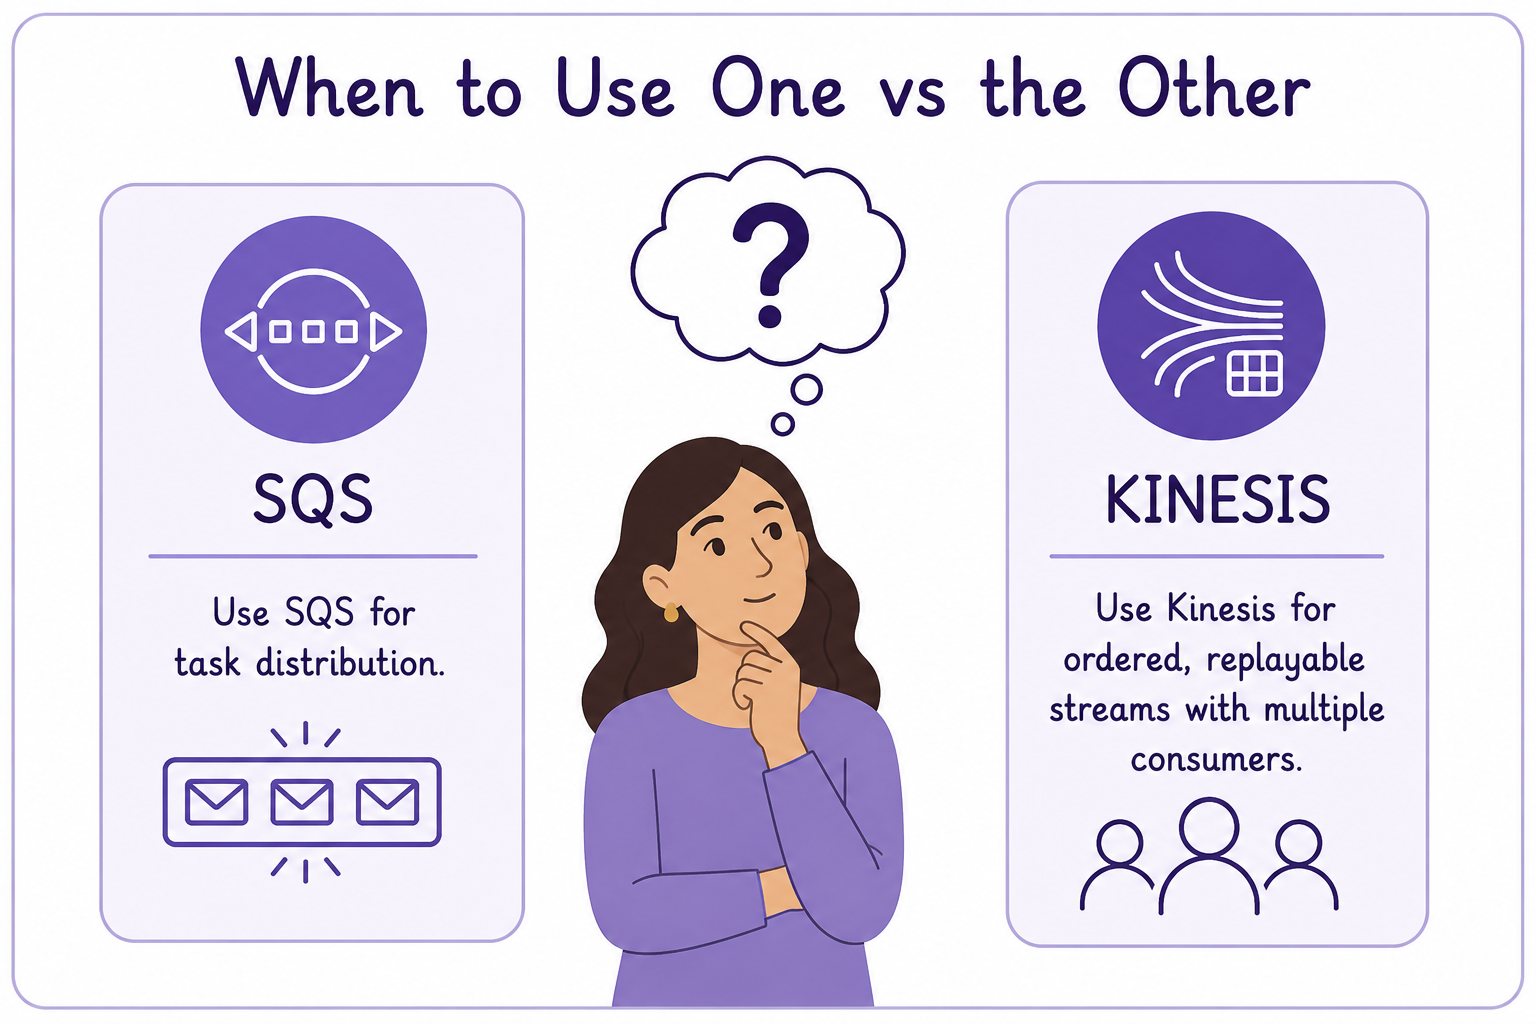
  • Nutze Kinesis für geordnete, wiederholbare Streams mit mehreren Consumern.
  • Kinesis eignet sich für Zeitreihen und geordnete Daten.
  • Nutze SQS für Aufgabenverteilung.
Anwendungen auf AWS entwickeln

Streaming-Daten skalieren


Skalierung

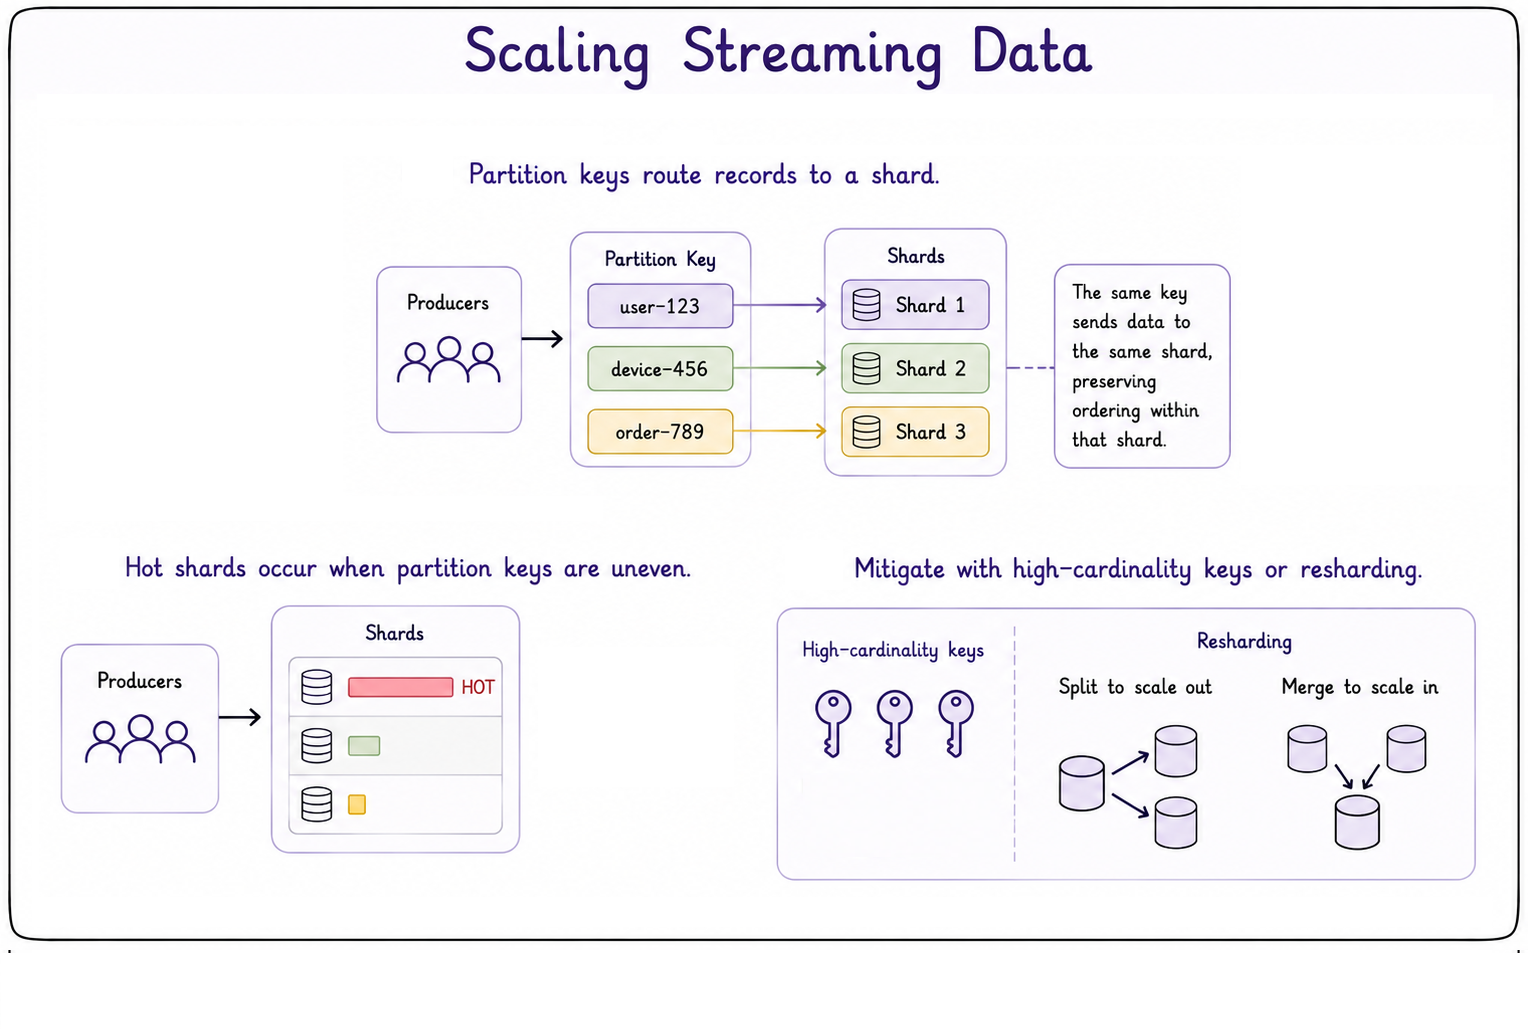
  • Data Streams werden in Shards unterteilt.
  • Partition Keys leiten Datensätze an einen bestimmten Shard.
  • Derselbe Key landet immer auf demselben Shard, Ordnung bleibt erhalten.
  • Ungleich verteilte Keys führen zu „hot shards".
  • Gegensteuern mit Keys hoher Kardinalität.
  • Durch Resharding nach oben oder unten skalieren.
Anwendungen auf AWS entwickeln

Kapazitätsmodi: Provisioned

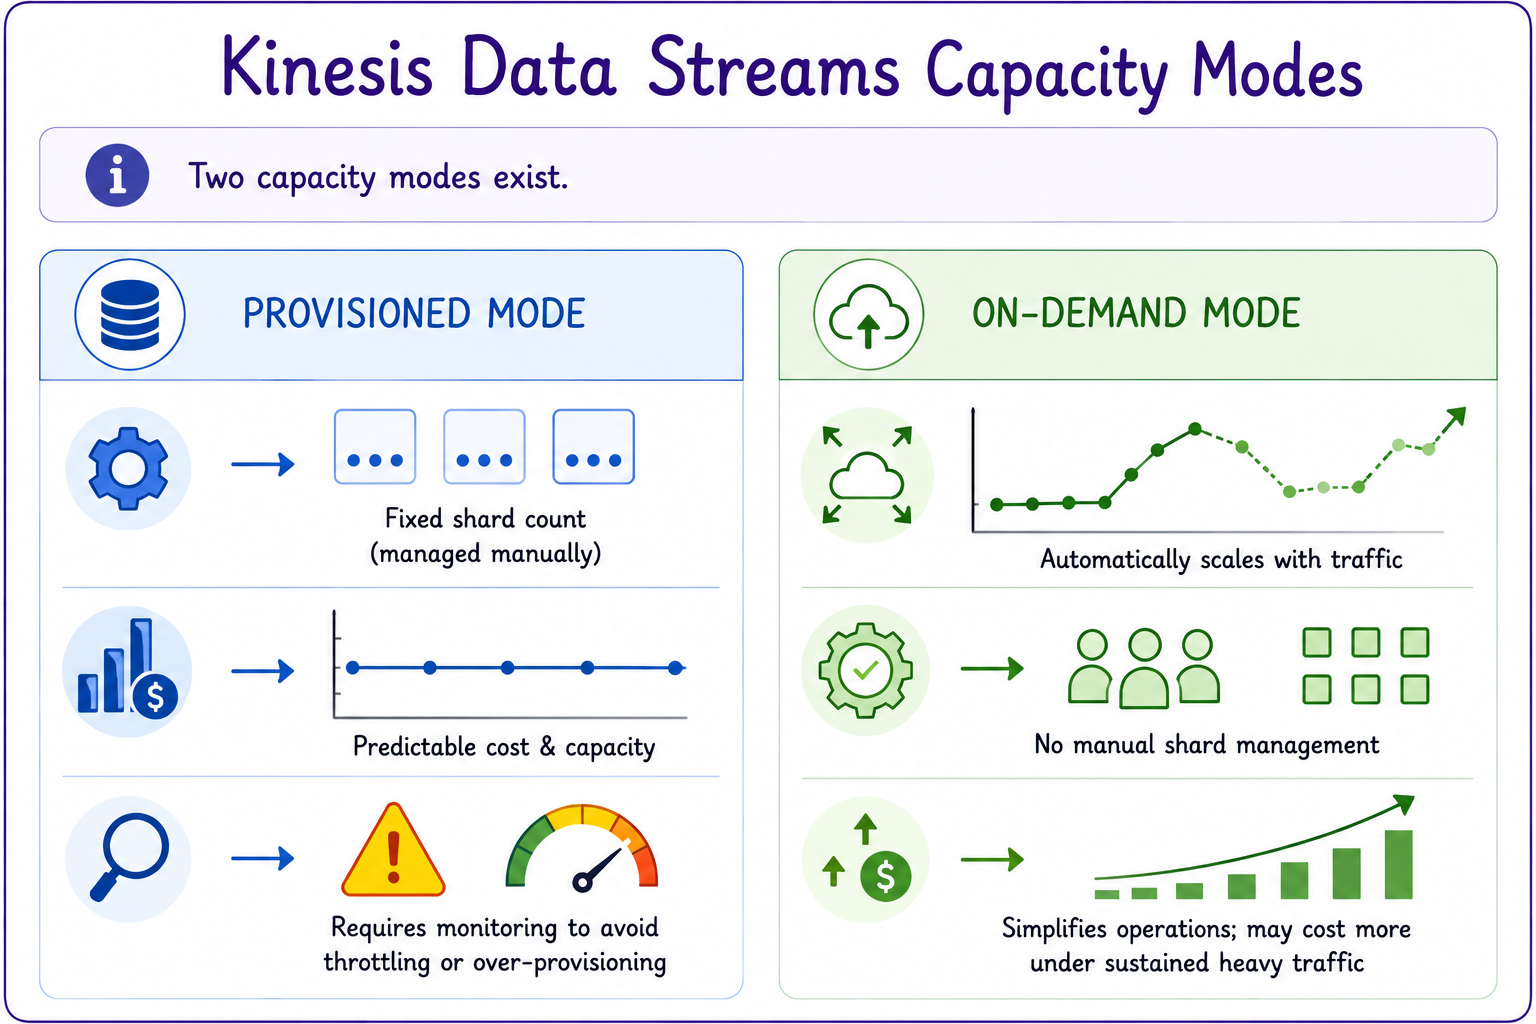
  • Es gibt zwei Kapazitätsmodi.
  • Provisioned-Modus nutzt eine feste Shard-Anzahl, manuell verwaltet.
  • Bietet kalkulierbare Kosten und Kapazität.
  • Erfordert Monitoring, um Throttling und Überprovisionierung zu vermeiden.


Kapazitätsmodi

Anwendungen auf AWS entwickeln

Kapazitätsmodi: On-Demand

  • On-Demand-Modus skaliert automatisch nach Traffic.
  • Keine manuelle Shard-Verwaltung.
  • Vereinfacht Betrieb bei unvorhersehbarer Last.
  • Höhere Kosten bei anhaltend hoher Auslastung.


Kapazitätsmodi

Anwendungen auf AWS entwickeln

Kinesis Producer Library (KPL)

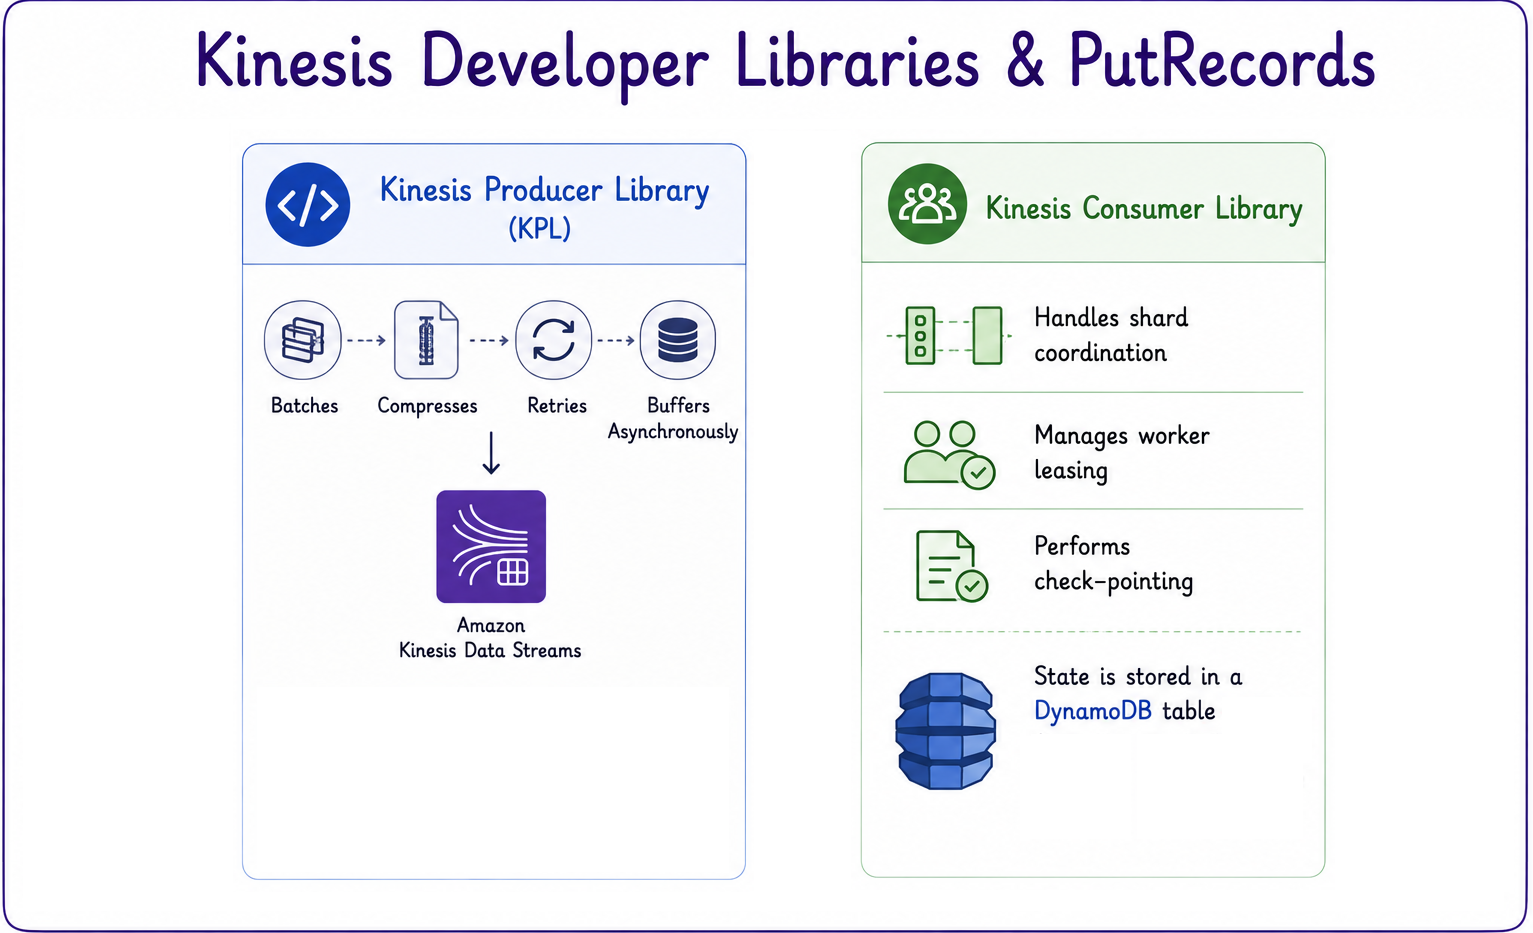
  • AWS-Bibliotheken vereinfachen skalierbare Producer und Consumer.
  • Die Kinesis Producer Library (KPL) bündelt und aggregiert Datensätze.
  • Sie komprimiert auch Datensätze und wiederholt bei Fehlern.
  • Puffert asynchron, um Producer-Durchsatz zu maximieren.


Client-Bibliotheken

Anwendungen auf AWS entwickeln

Kinesis Consumer Library (KCL)


Client-Bibliotheken


  • Die Kinesis Consumer Library (KCL) übernimmt Shard-Koordination.
  • Sie verwaltet Worker-Leasing und Checkpointing.
  • Zustand wird in einer DynamoDB-Tabelle gespeichert.
  • Consumer nutzen diesen Zustand, um die Fortsetzung zu finden.
Anwendungen auf AWS entwickeln

Fehlerbehandlung: Idempotenz


Fehlerbehandlung


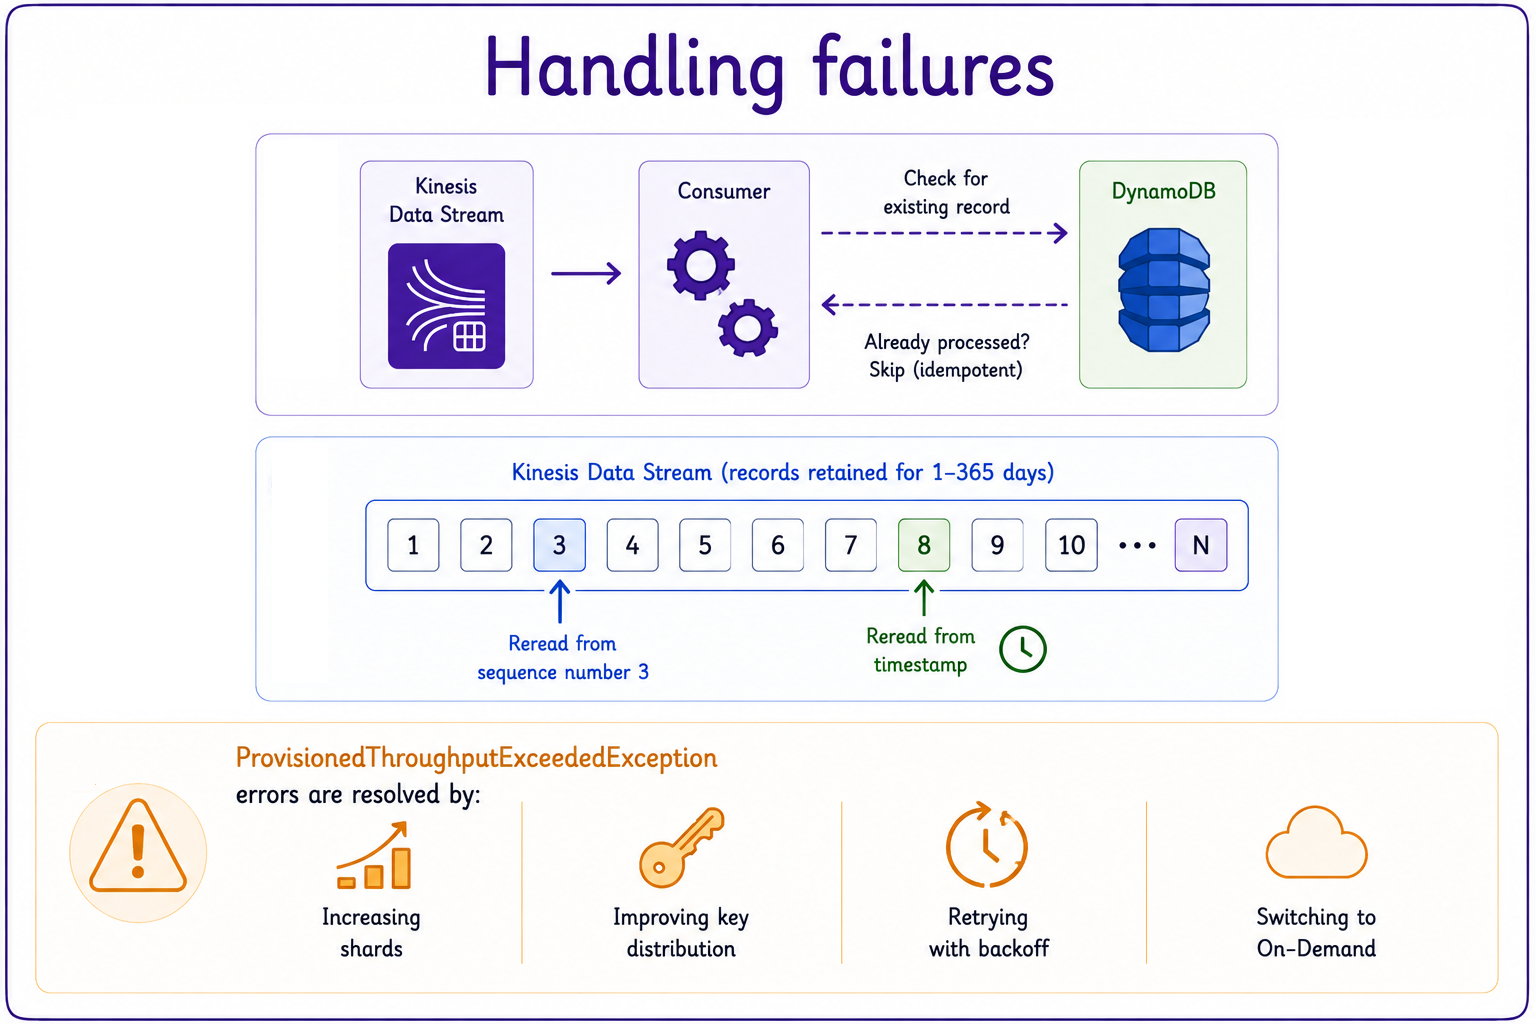
  • Kinesis liefert mindestens einmal, daher sind Duplikate möglich.
  • Designe Consumer idempotent.
  • Dedupliziere per Sequenznummer oder Business Key in DynamoDB.
  • Consumer können aufbewahrte Datensätze ab Sequenznummer oder Zeitstempel erneut lesen.
Anwendungen auf AWS entwickeln

Fehlerbehandlung: Durchsatzfehler


Fehlerbehandlung


  • ProvisionedThroughputExceededException signalisiert Throttling.
  • Behebe es durch Erhöhen der Shard-Anzahl.
  • Verbessere die Verteilung der Partition Keys.
  • Mit Backoff erneut versuchen.
  • Kapazitätsmodus wechseln.
Anwendungen auf AWS entwickeln
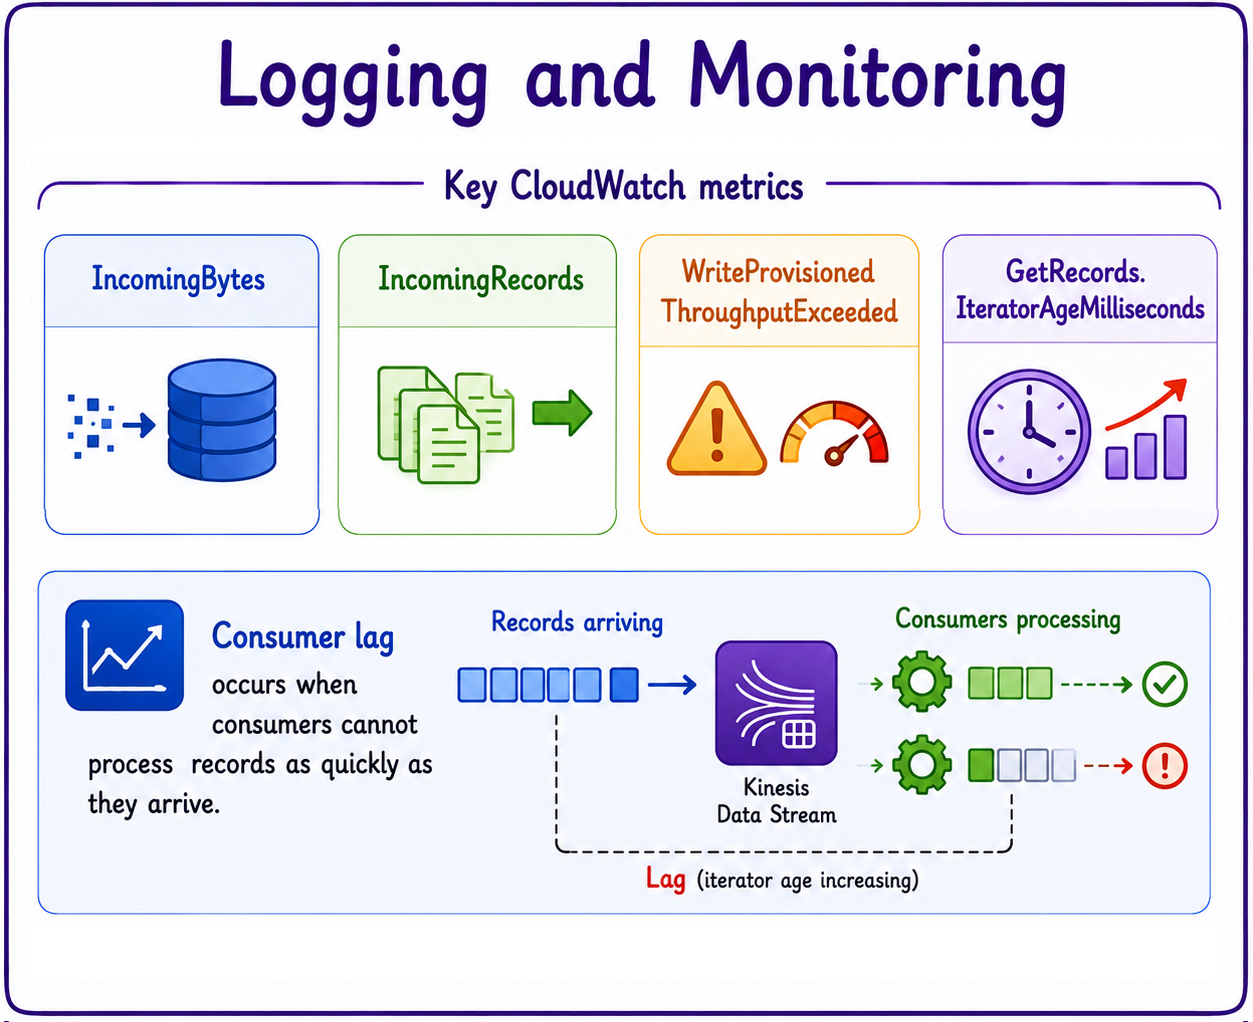
  • IncomingBytes und IncomingRecords in CloudWatch verfolgen.
  • WriteProvisionedThroughputExceeded auf Throttling beobachten.
  • Consumer-Lag tritt auf, wenn langsamer konsumiert als produziert wird.
  • GetRecords.IteratorAgeMilliseconds verfolgen: hohe Werte bedeuten Lag.


Logging und Monitoring

Anwendungen auf AWS entwickeln

Sicherheit

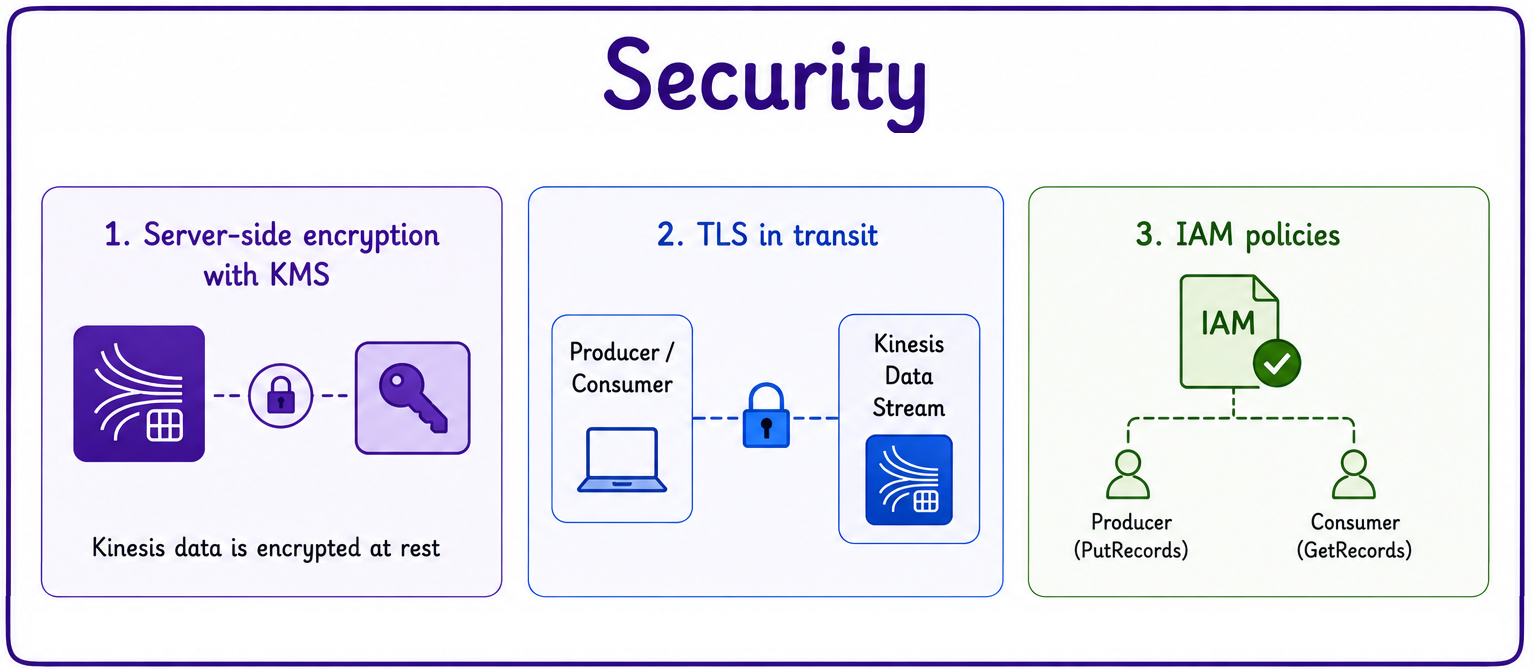
  • Serverseitige Verschlüsselung at rest mit AWS KMS.
  • Verschlüsselung in Transit mit TLS.
  • IAM-Richtlinien steuern den Zugriff.


Sicherheit

Anwendungen auf AWS entwickeln

Lass uns üben!

Anwendungen auf AWS entwickeln

Preparing Video For Download...