Dienste koordinieren und Zustand verwalten
Anwendungen auf AWS entwickeln
Ricardo Sueiras
Principal Technologist
Service-Koordination
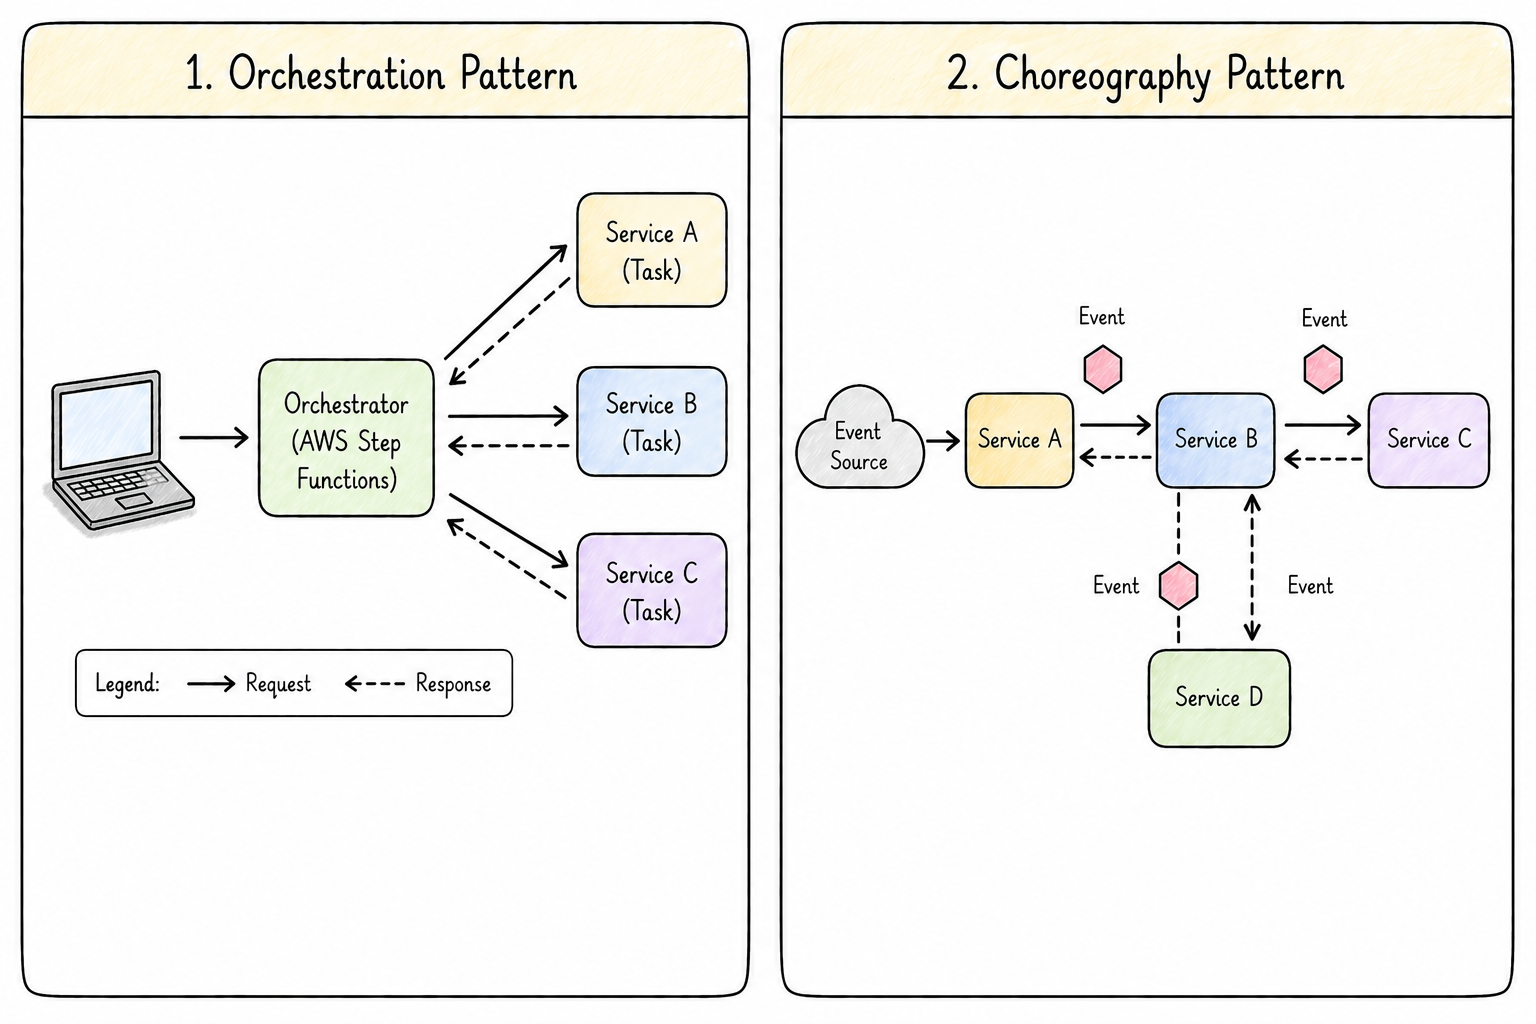
Mehrere Dienste arbeiten zusammen, um einen Workflow abzuschließen.
Sie brauchen eine Kooperationsstrategie.
Zwei Ansätze: Orchestrierung und Choreographie.
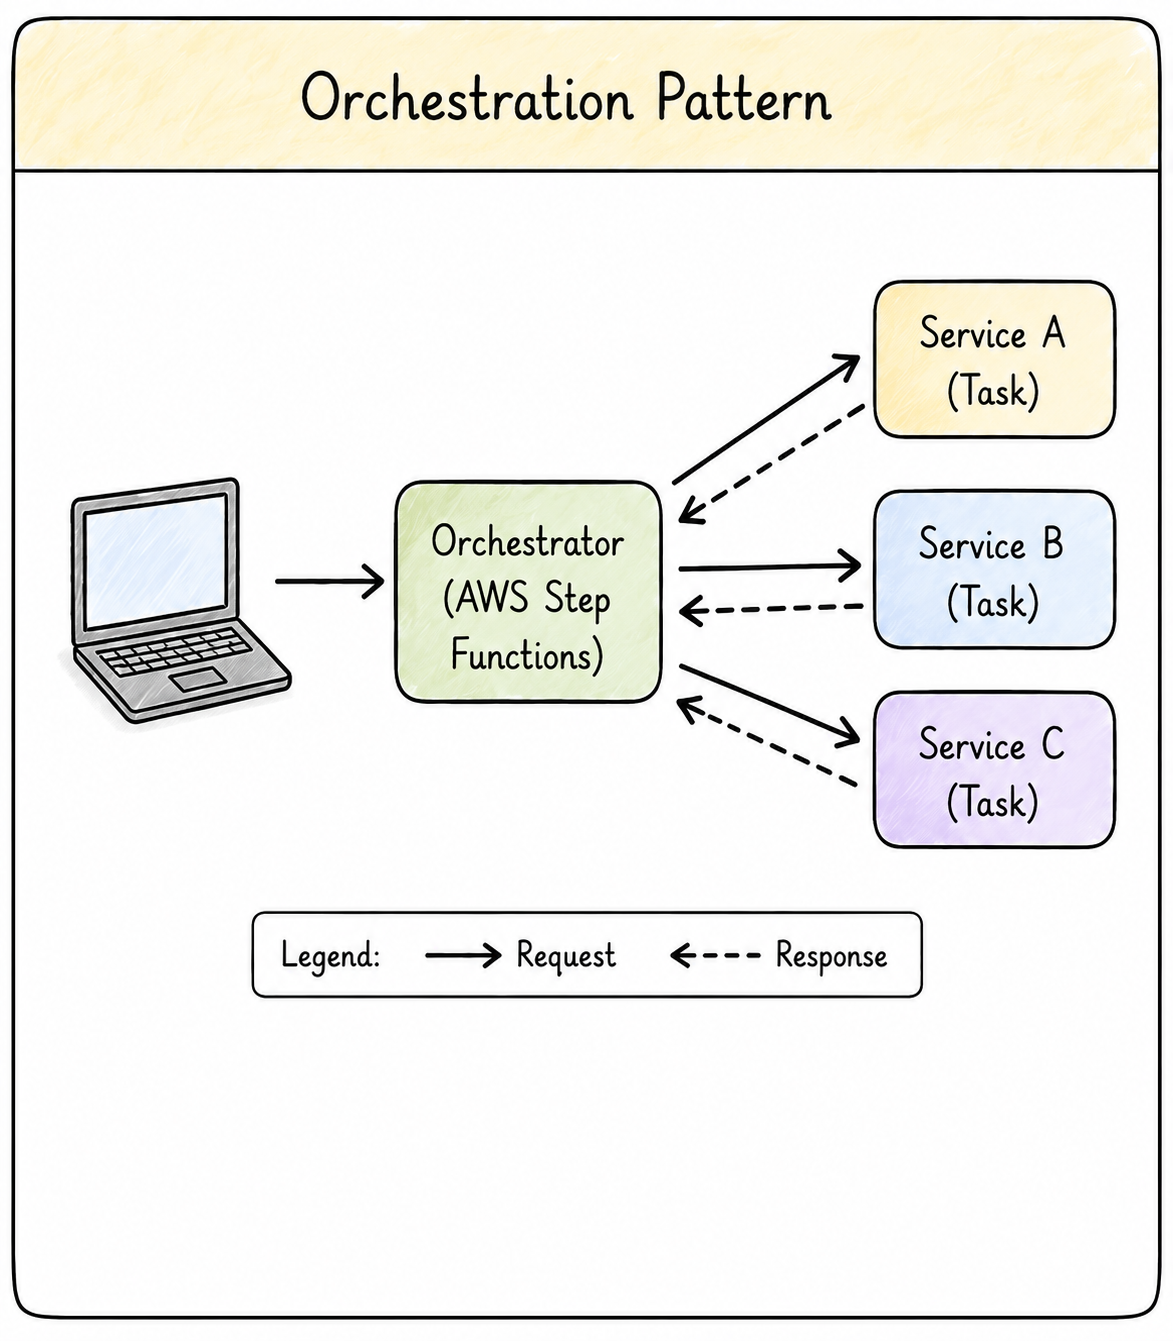
Orchestrierung
Ein zentraler Orchestrator koordiniert den Workflow.
Er steuert die Reihenfolge und entscheidet, welcher Dienst als Nächstes läuft.
Nützlich für Retries, Bedingungen und Fehlerbehandlung.
Auf AWS: mit Step Functions über Lambda, ECS, DynamoDB.
Orchestrierung
Logik des Workflows an einem Ort – Debugging und Monitoring sind einfacher.
Trade-off: führt eine zentrale Abhängigkeit ein.
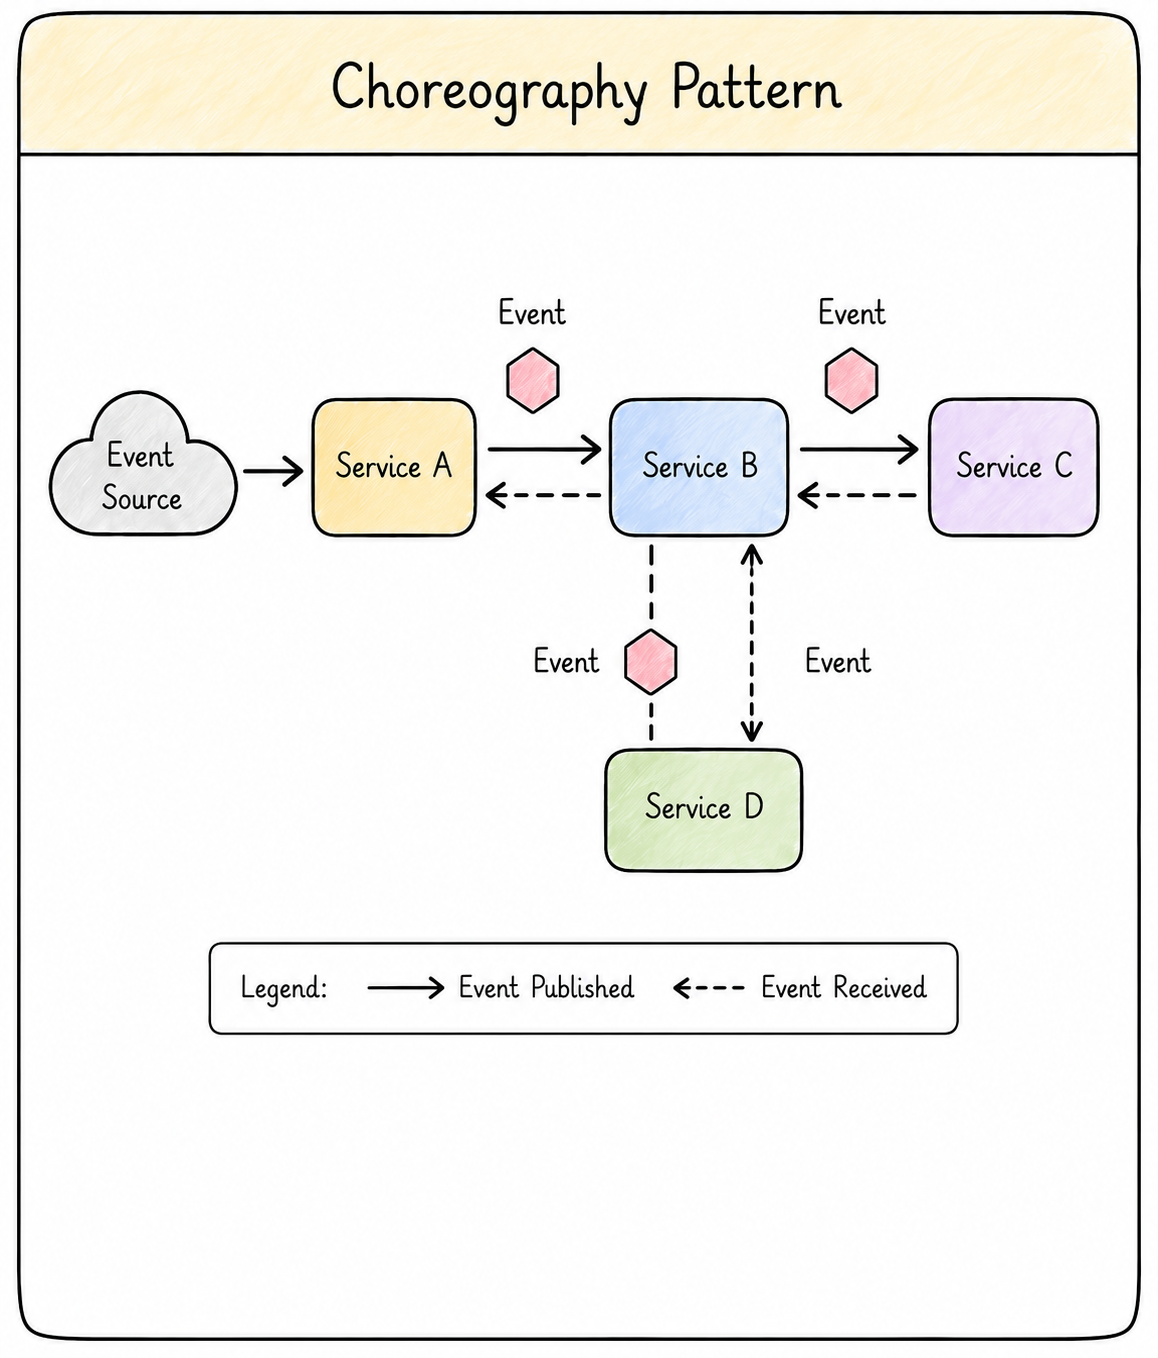
Choreographie
Kein zentraler Controller.
Dienste reagieren unabhängig auf Ereignisse.
Jeder Dienst hört auf relevante Events und erledigt seine Aufgabe.
Kein Dienst muss den gesamten Workflow kennen.
Verbessert lose Kopplung und Skalierbarkeit.
Choreographie
Auf AWS: EventBridge, SNS, SQS.
Hoch skalierbar.
Trade-off: wird mit wachsendem Workflow schwerer zu verstehen und zu debuggen.
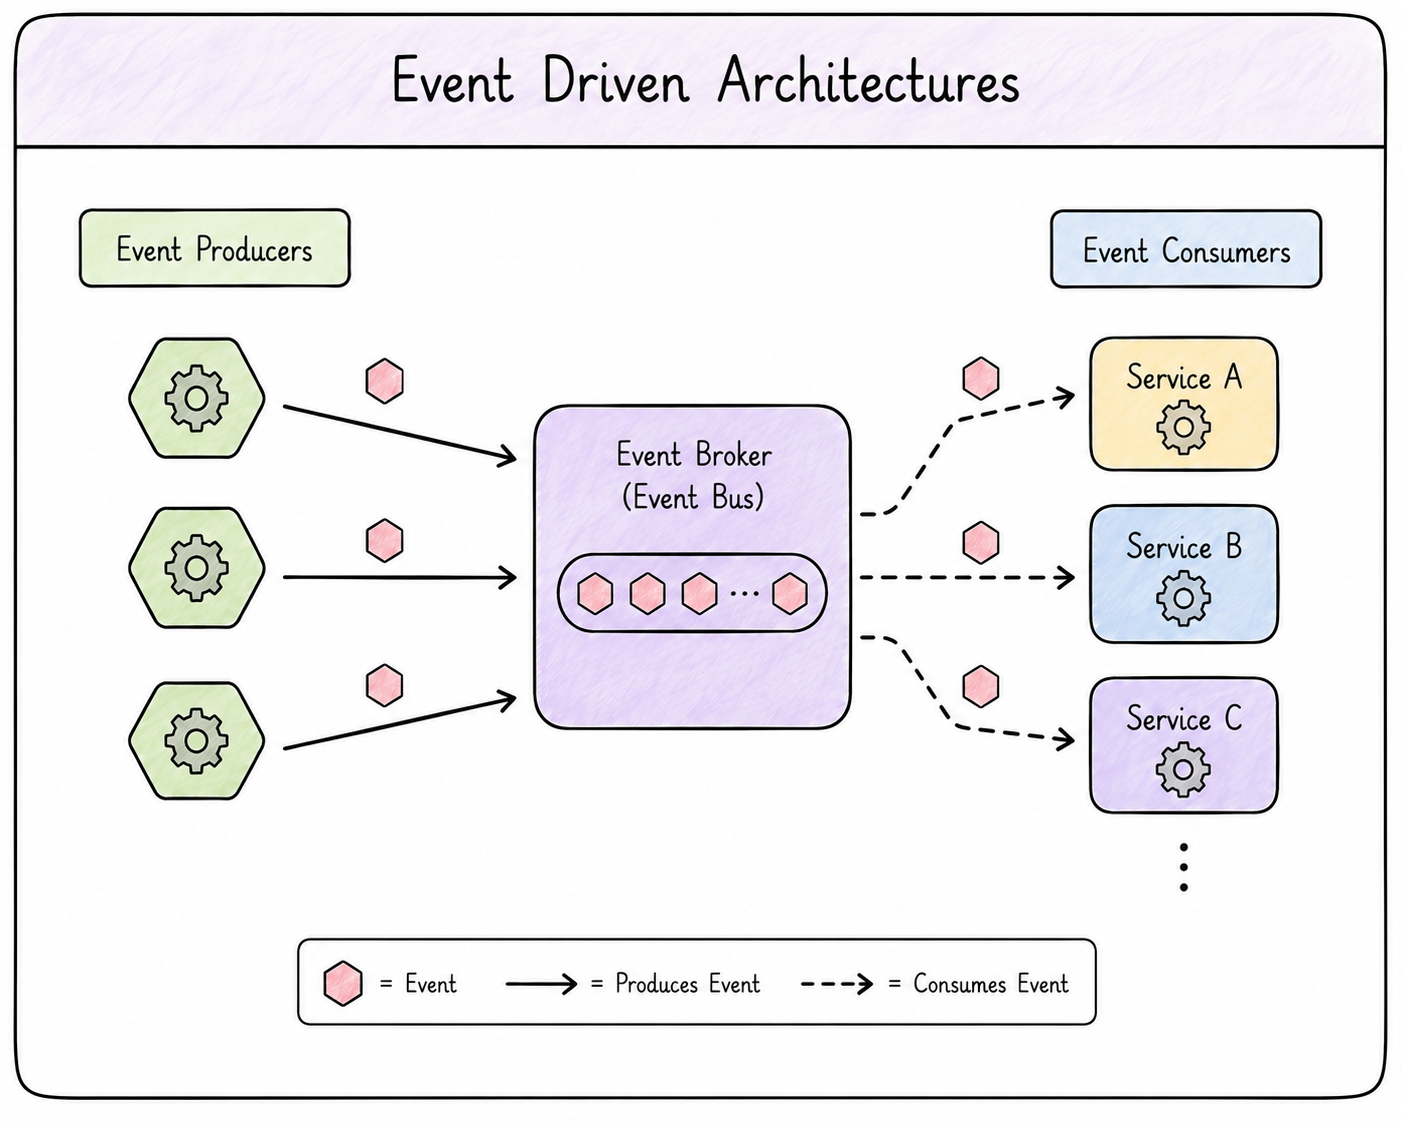
Ereignisgesteuerte Architektur
Dienste kommunizieren durch Erzeugen und Konsumieren von Events.
Fördert lose Kopplung zwischen Diensten.
Fördert hohe Skalierbarkeit.
Ermöglicht parallele Verarbeitung von Events.
Neue Dienste können abonnieren, ohne bestehende zu ändern.
Ereignisgesteuerte Architektur
Trade-offs bei EDA:
Für Eventual Consistency auslegen.
Idempotenz umsetzen.
Fehlerbehandlung ist komplexer.
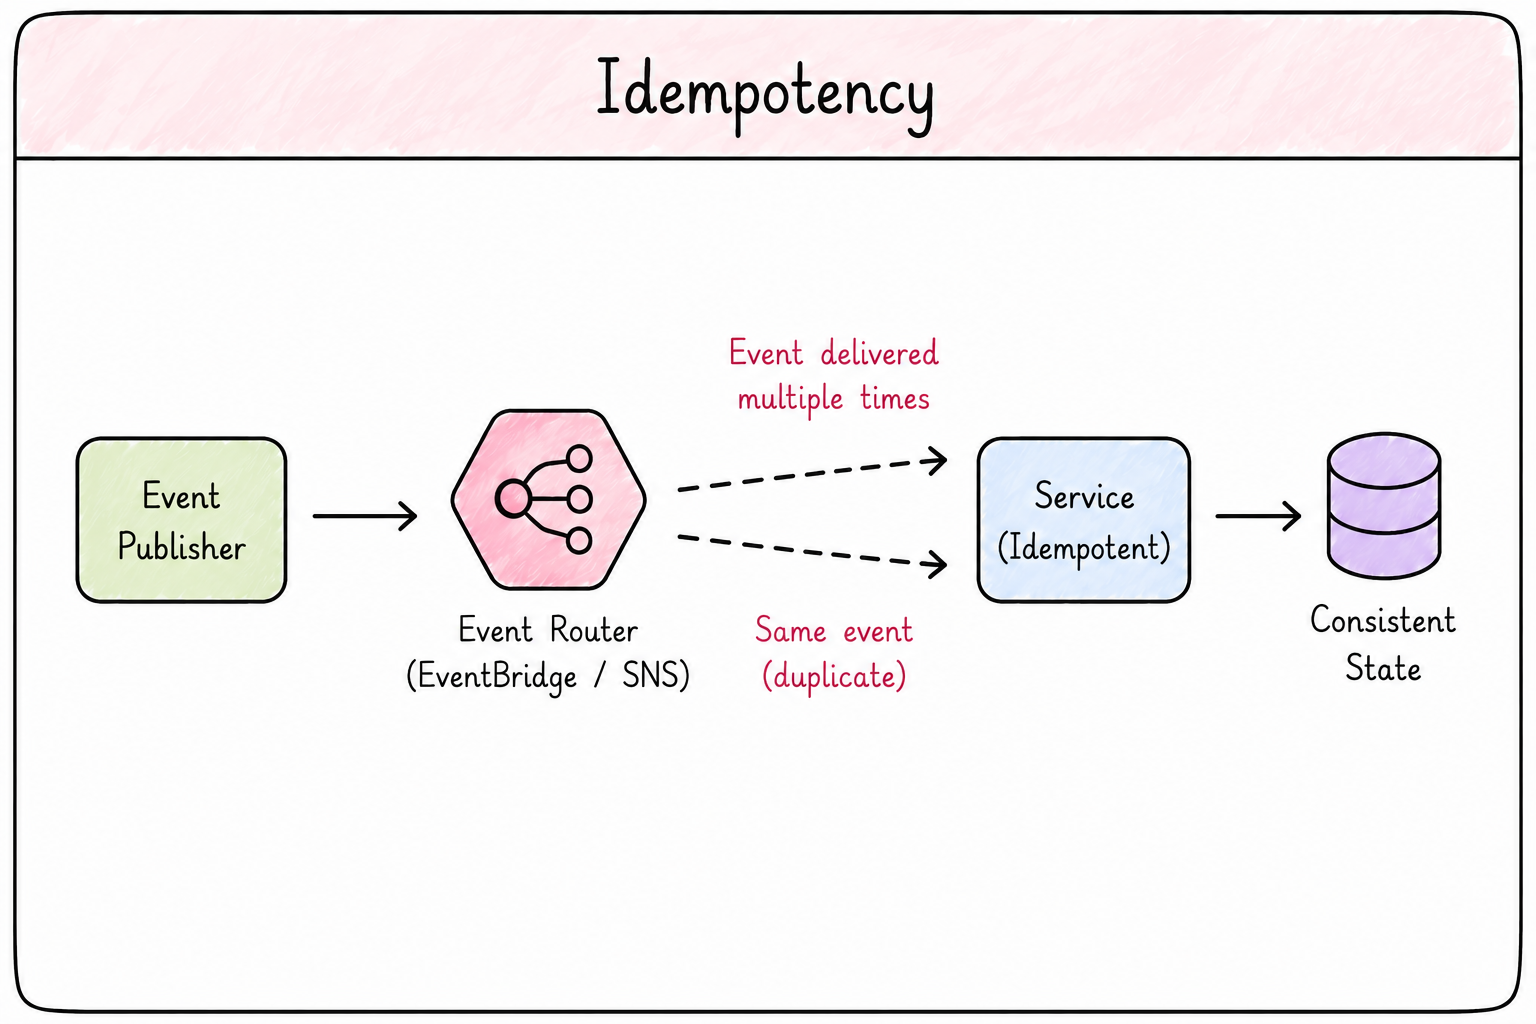
Idempotenz
Dieselbe Operation liefert bei mehrfacher Ausführung dasselbe Ergebnis.
Zentrales Designprinzip in asynchronen und ereignisgesteuerten Systemen.
Verteilte Systeme können doppelte Events liefern (Retries, Netzwerkausfälle, Reprocessing).
Erhält Korrektheit und Zuverlässigkeit des Systems.
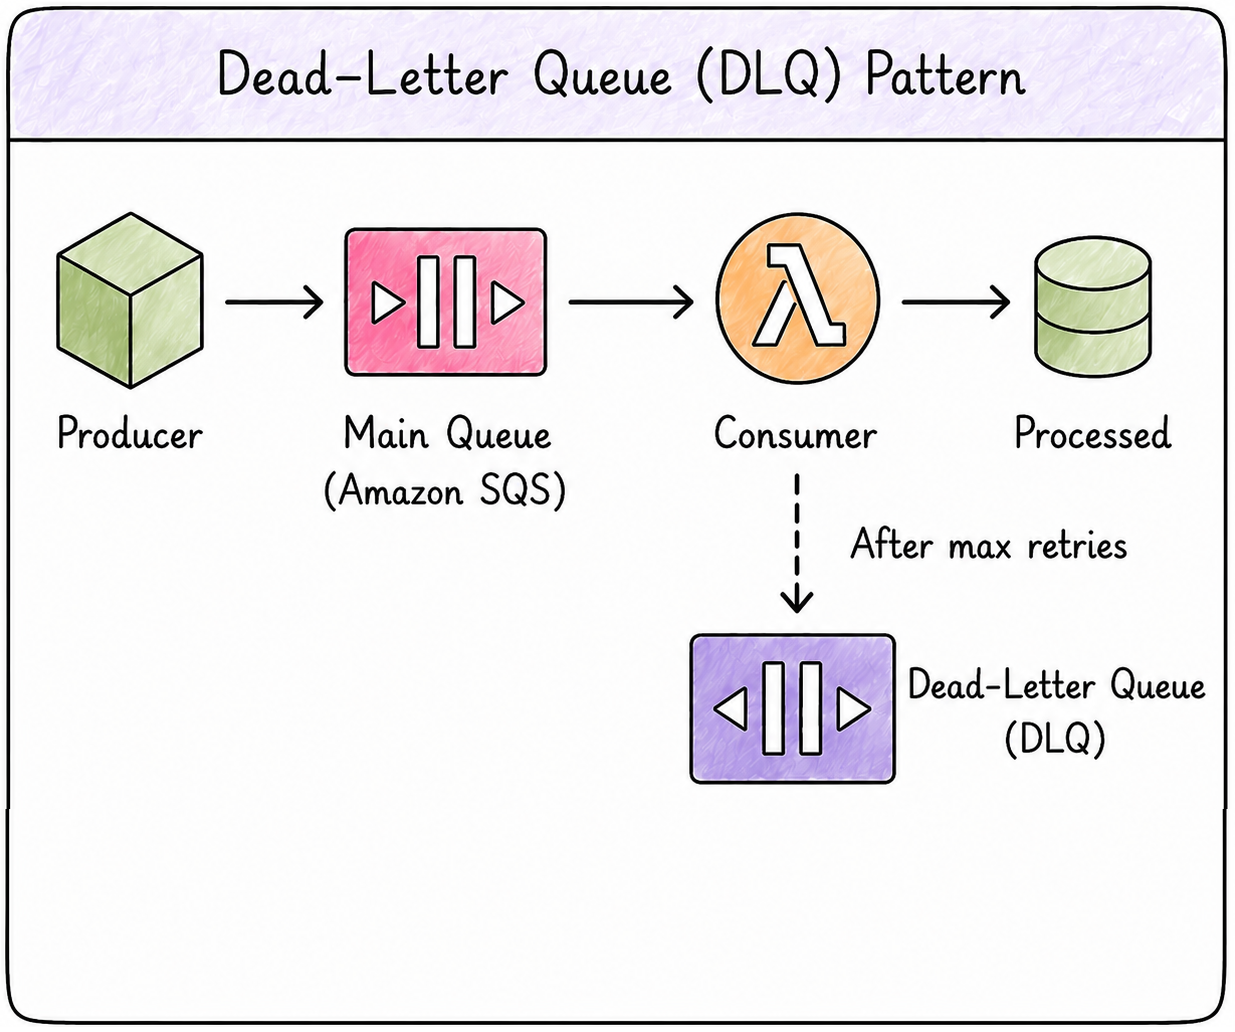
Dead-Letter-Queues
Handhabt Fehler in asynchroner Kommunikation.
Isoliert problematische „Gift"-Nachrichten.
Nach wiederholten fehlgeschlagenen Retries wandert die Nachricht in die DLQ.
Der Hauptfluss läuft weiter.
Dead-Letter-Queues
Nutzen, wenn die Nachrichtenreihenfolge nicht kritisch ist.
Überspringen für unkritische Systeme, bei denen gelegentlicher Datenverlust akzeptabel ist.
Vermeiden, wenn die Reihenfolge erhalten bleiben muss.
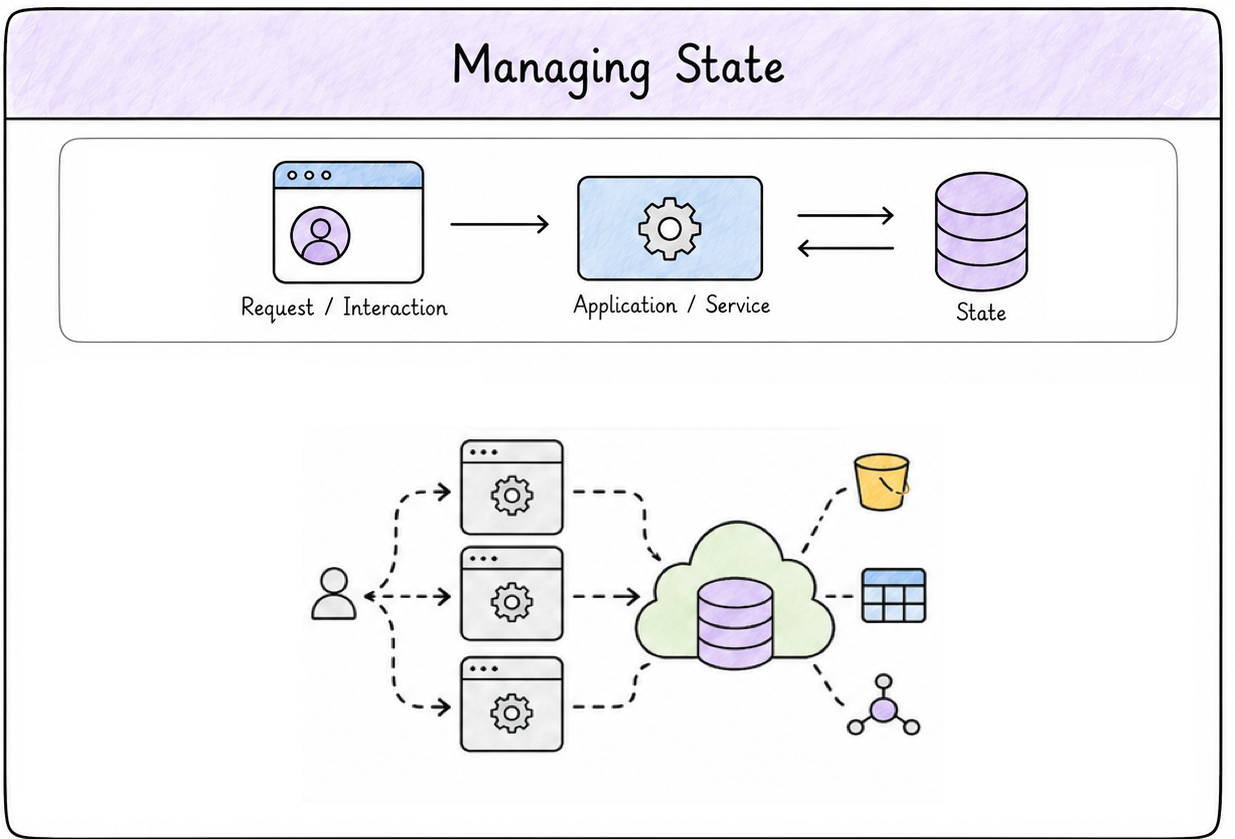
Zustand verwalten
Zustandsverwaltung ist grundlegend für Cloud-native Apps.
Zustand ist jede zwischen Interaktionen erhaltene Daten.
Lokales Speichern auf dem Server begrenzt Skalierung und Resilienz.
Zustand verwalten
Zustandsverwaltung hat je nach Anwendungsfall Trade-offs.
Externer Zustand erhöht Skalierbarkeit und Resilienz.
Kosten: zusätzliche Latenz und Komplexität.
Wichtige Punkte: Konsistenz, Caching und Datenzugriffsmuster.
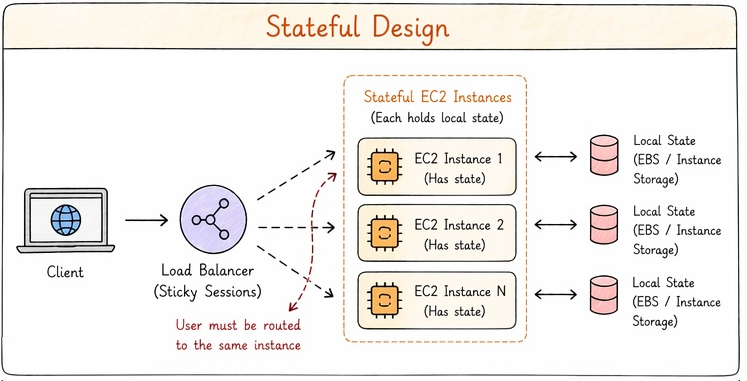
Stateful
Sitzungsdaten verbleiben auf dem Server.
Anfragen müssen zur selben Instanz gehen (Sticky Sessions).
Begrenzt die Skalierungsflexibilität.
Fällt die Instanz aus, ist die Sitzung weg.
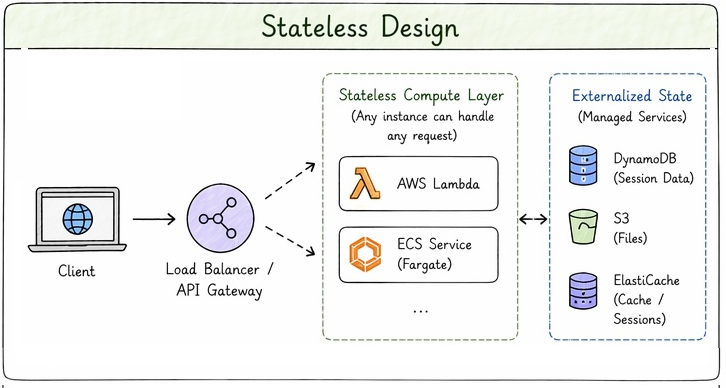
Stateless
Jede Anfrage wird unabhängig behandelt.
Kein Zustand auf dem Server gespeichert.
Zustand liegt in externen Systemen.
Bevorzugter Ansatz für Cloud-native Apps.
Jede Instanz kann jede Anfrage bedienen – horizontale Skalierung ist einfach.
Lass uns üben!
Anwendungen auf AWS entwickeln
Preparing Video For Download...