Streaming-Daten mit DynamoDB

Anwendungen auf AWS entwickeln

Ricardo Sueiras

Principal Technologist

DynamoDB Streams: Grundlagen
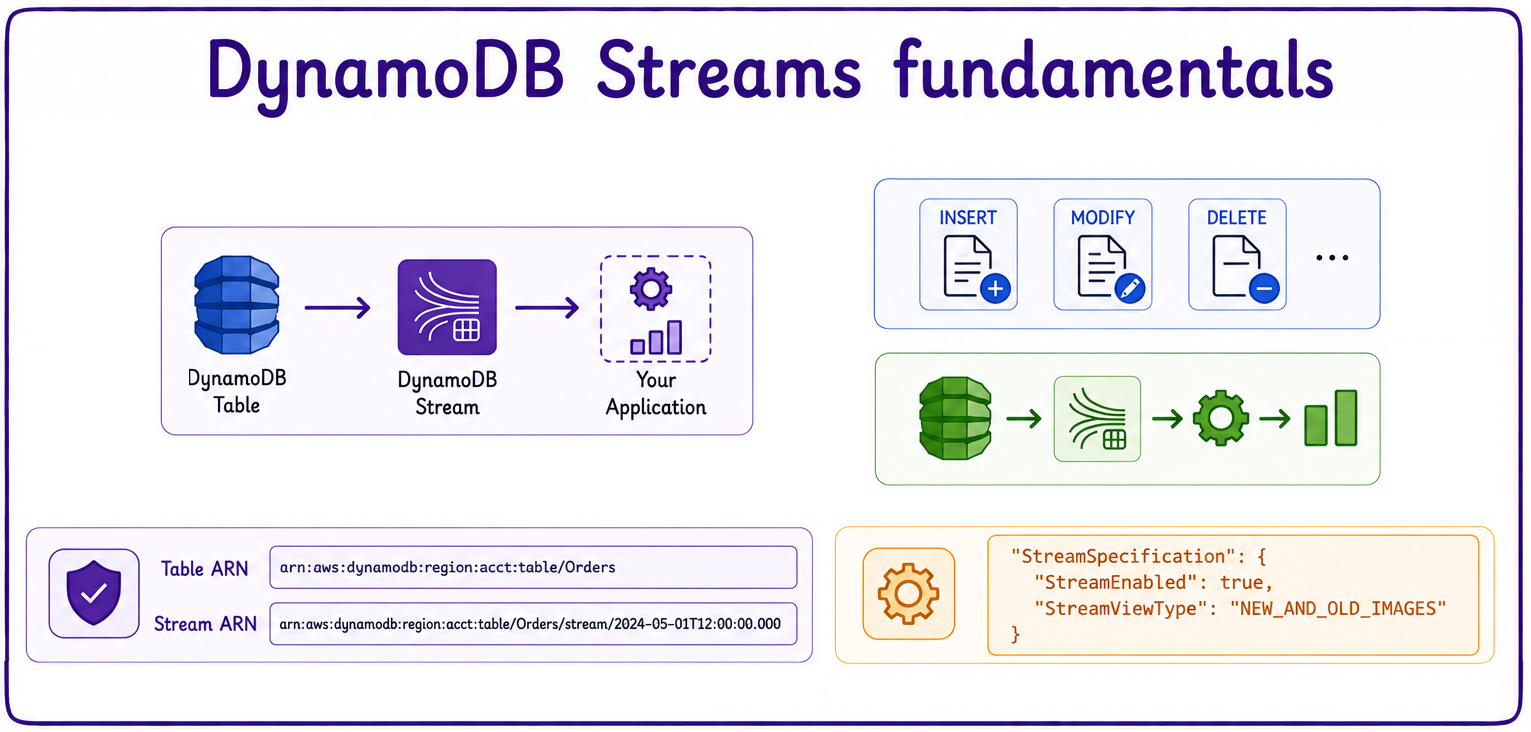
 

grundlagen

  • Reagiere fast in Echtzeit auf Datenbankänderungen.
  • Basiert auf ereignisgetriebenen Mustern.
  • Jeder Insert, jedes Update oder Delete erzeugt einen Stream-Datensatz.
  • Baue reaktive Apps ohne Table-Polling.
  • Standardmäßig aus: aktiviere mit StreamSpecification.
  • Jeder Stream hat eine eigene ARN, getrennt von der Tabellen-ARN.
Anwendungen auf AWS entwickeln

Aufbewahrungszeitraum


aufbewahrung

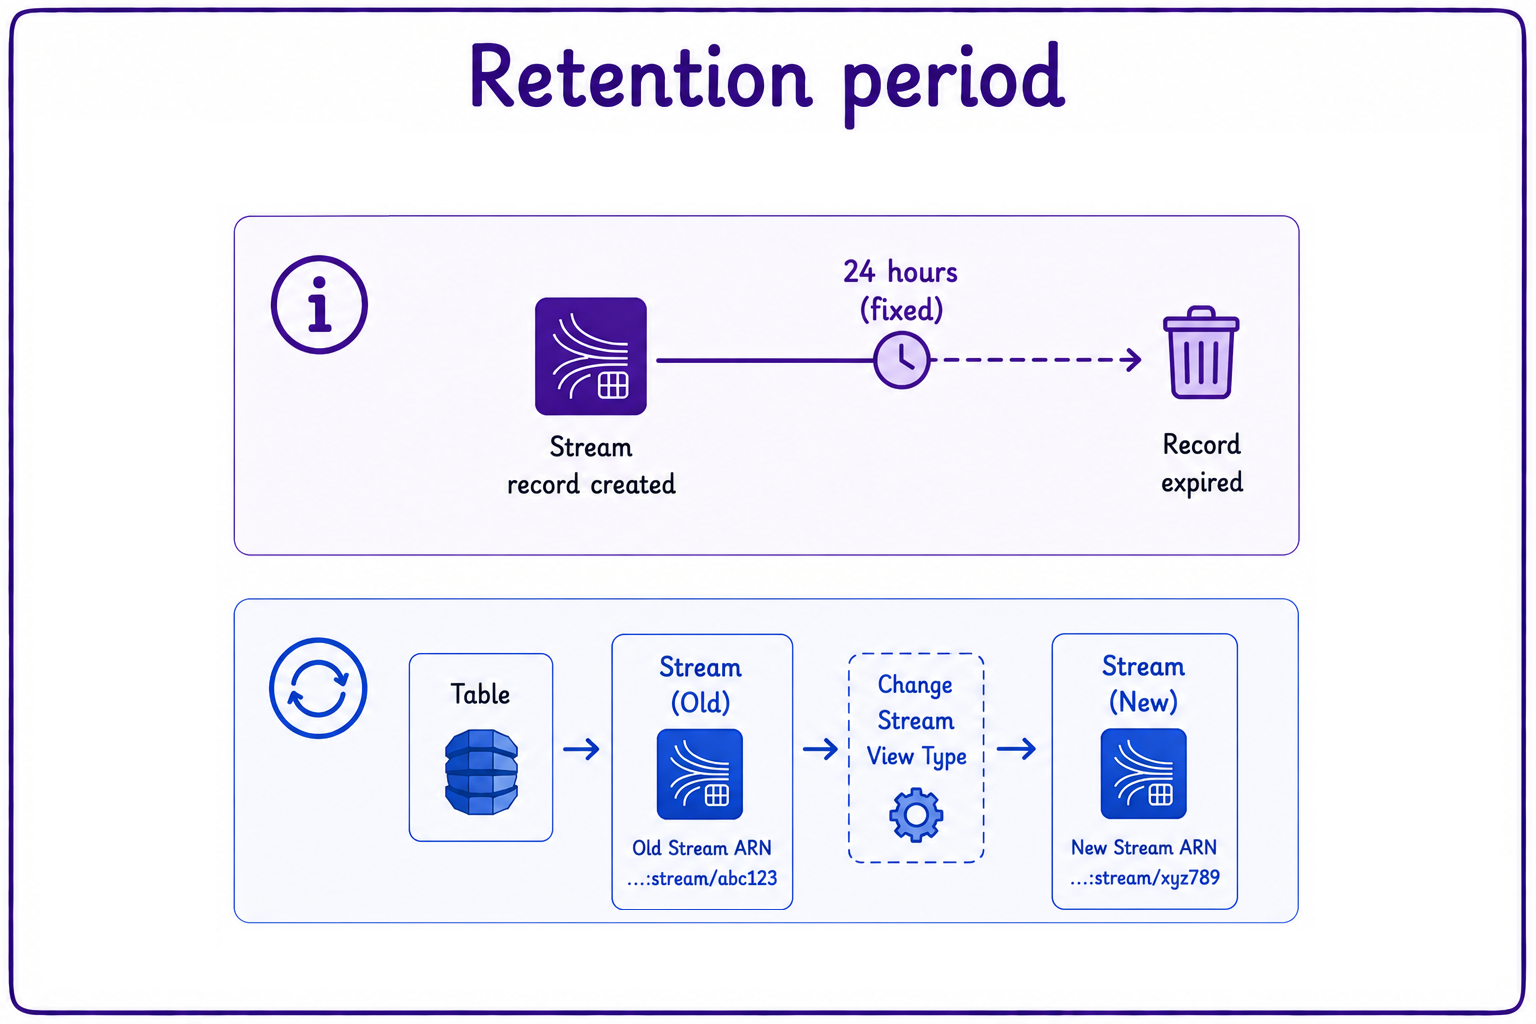
  • Stream-Datensätze werden 24 Stunden aufbewahrt.
    • Die Aufbewahrung ist fest und nicht konfigurierbar.
  • Ändern des View-Typs erfordert das Neuerstellen des Streams.
    • Ein neuer Stream erzeugt eine neue Stream-ARN.
Anwendungen auf AWS entwickeln

Streams und DynamoDB Read Capacity Units
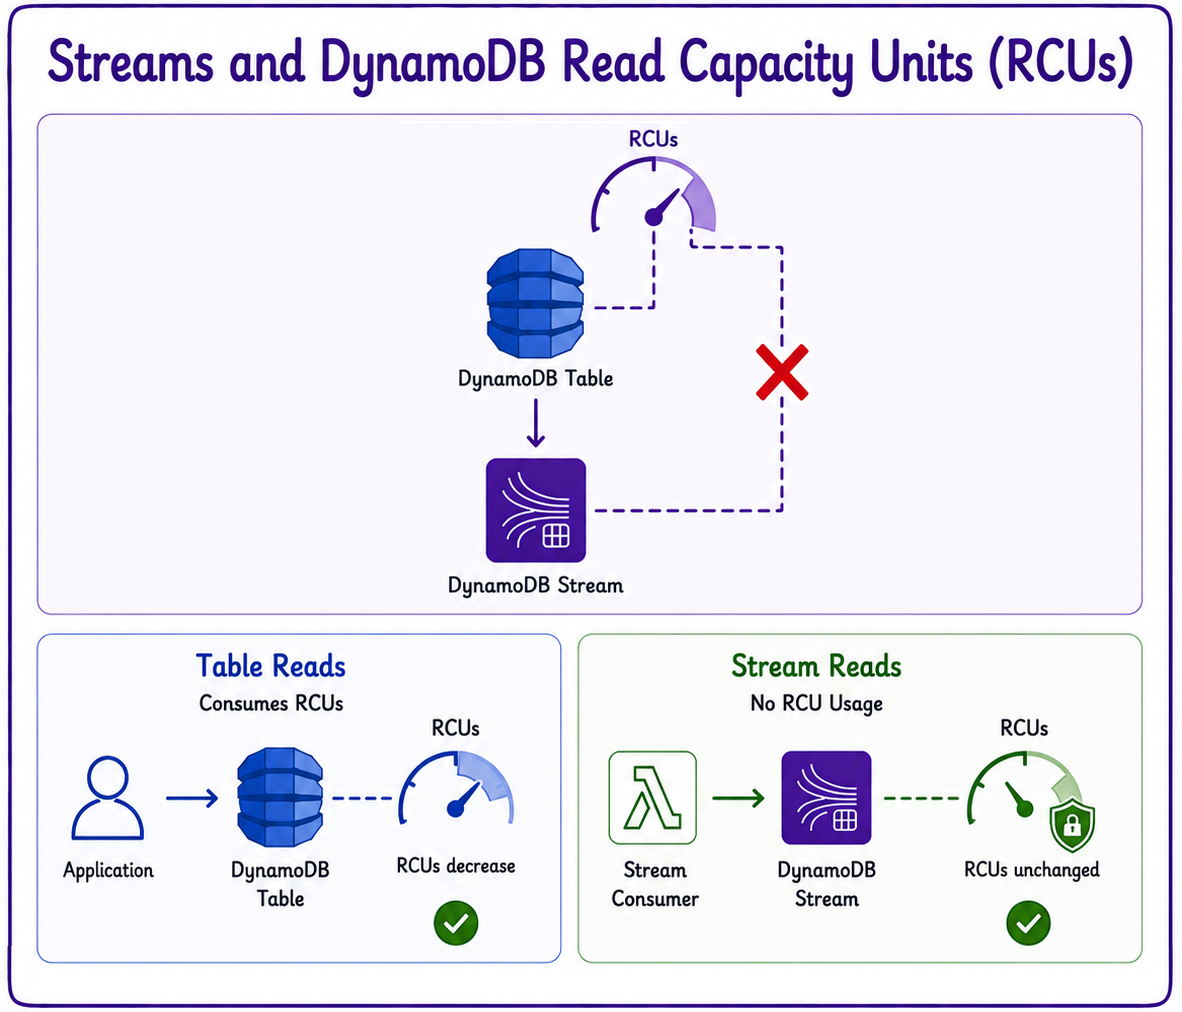
 

rcu

  • Stream-Reads verbrauchen KEINE Read Capacity Units (RCUs).
  • Streams aktivieren beeinflusst den bereitgestellten Durchsatz nicht.
Anwendungen auf AWS entwickeln

Stream-Datensätze

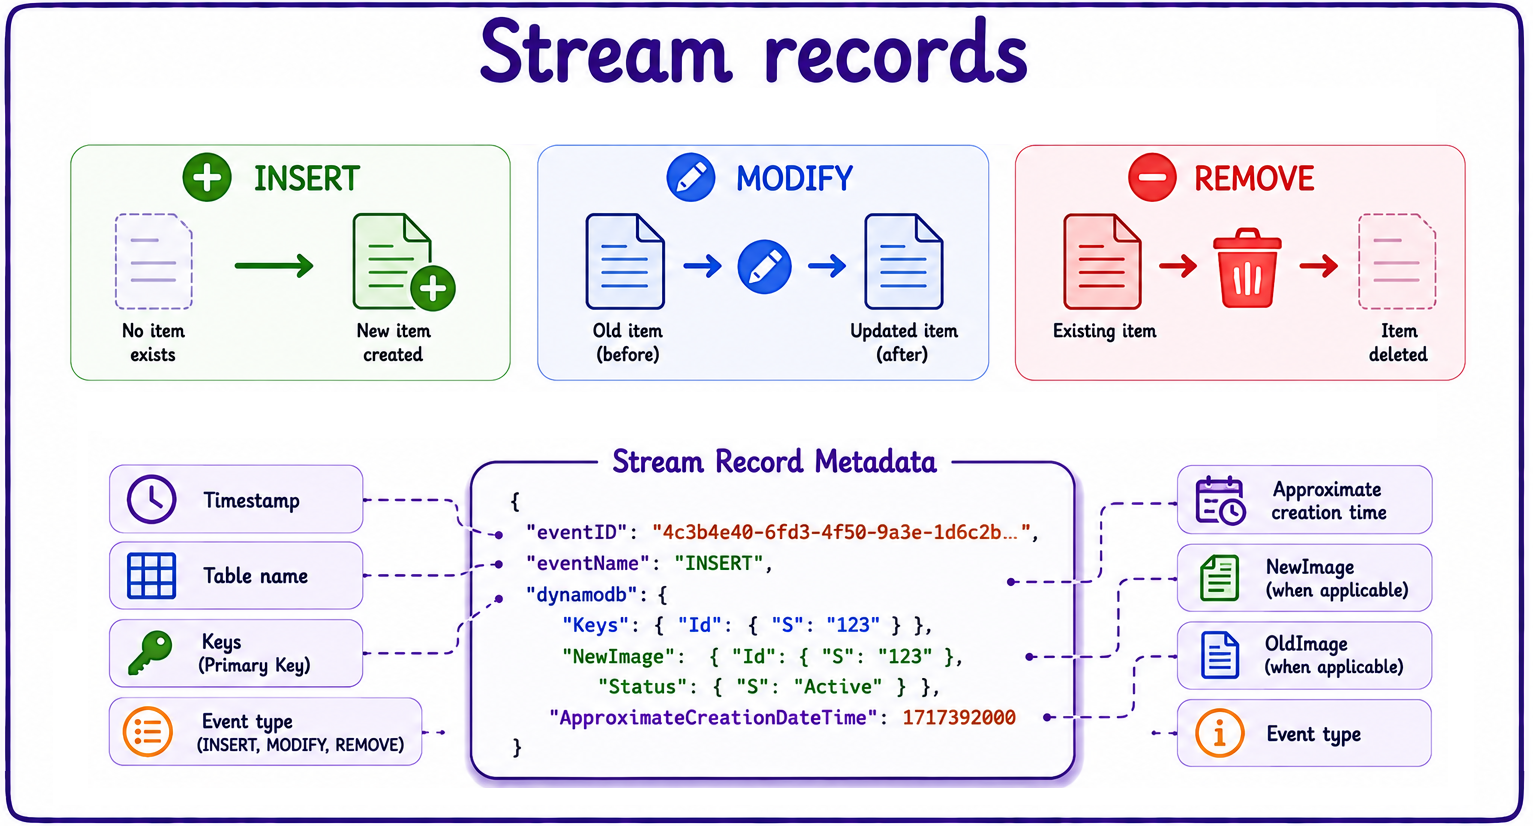
  • Jeder Stream-Datensatz enthält Metadaten zur Änderung.
  • Streams erfassen drei Ereignistypen:
    • INSERT
    • MODIFY
    • REMOVE


stream-datensätze

Anwendungen auf AWS entwickeln
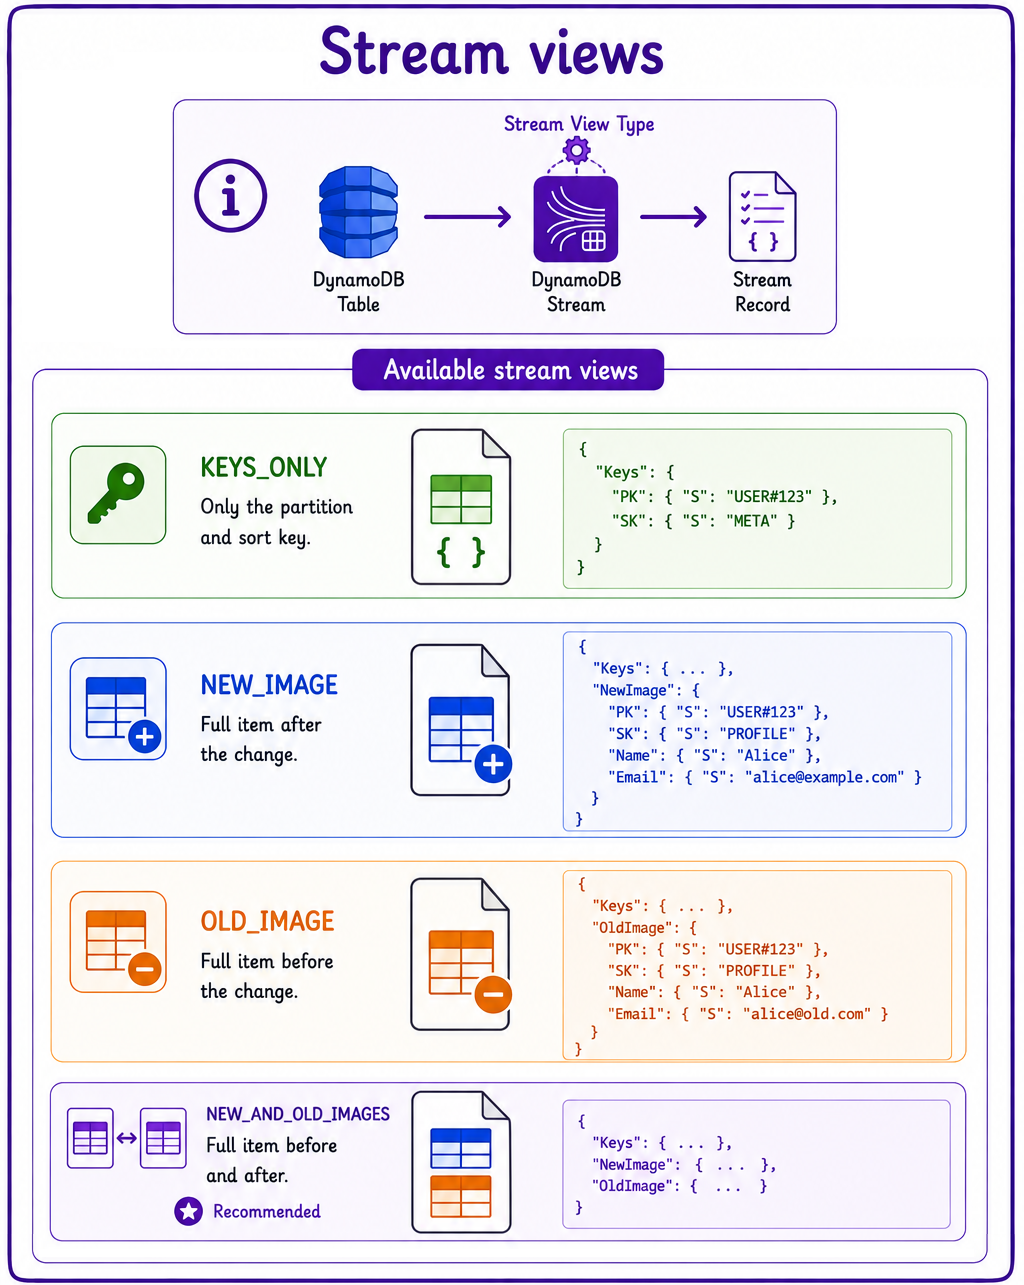
  • View-Typen steuern, welche Daten im Datensatz landen.
    • KEYS_ONLY: nur Partition- und Sortierschlüssel.
    • NEW_IMAGE: komplettes Item nach der Änderung.
    • OLD_IMAGE: komplettes Item vor der Änderung.
    • NEW_AND_OLD_IMAGES: Item davor und danach.
  • NEW_AND_OLD_IMAGES ist Standard fürs Auditing.
  • Erforderlich für DynamoDB Global Tables.

stream-ansichten

Anwendungen auf AWS entwickeln
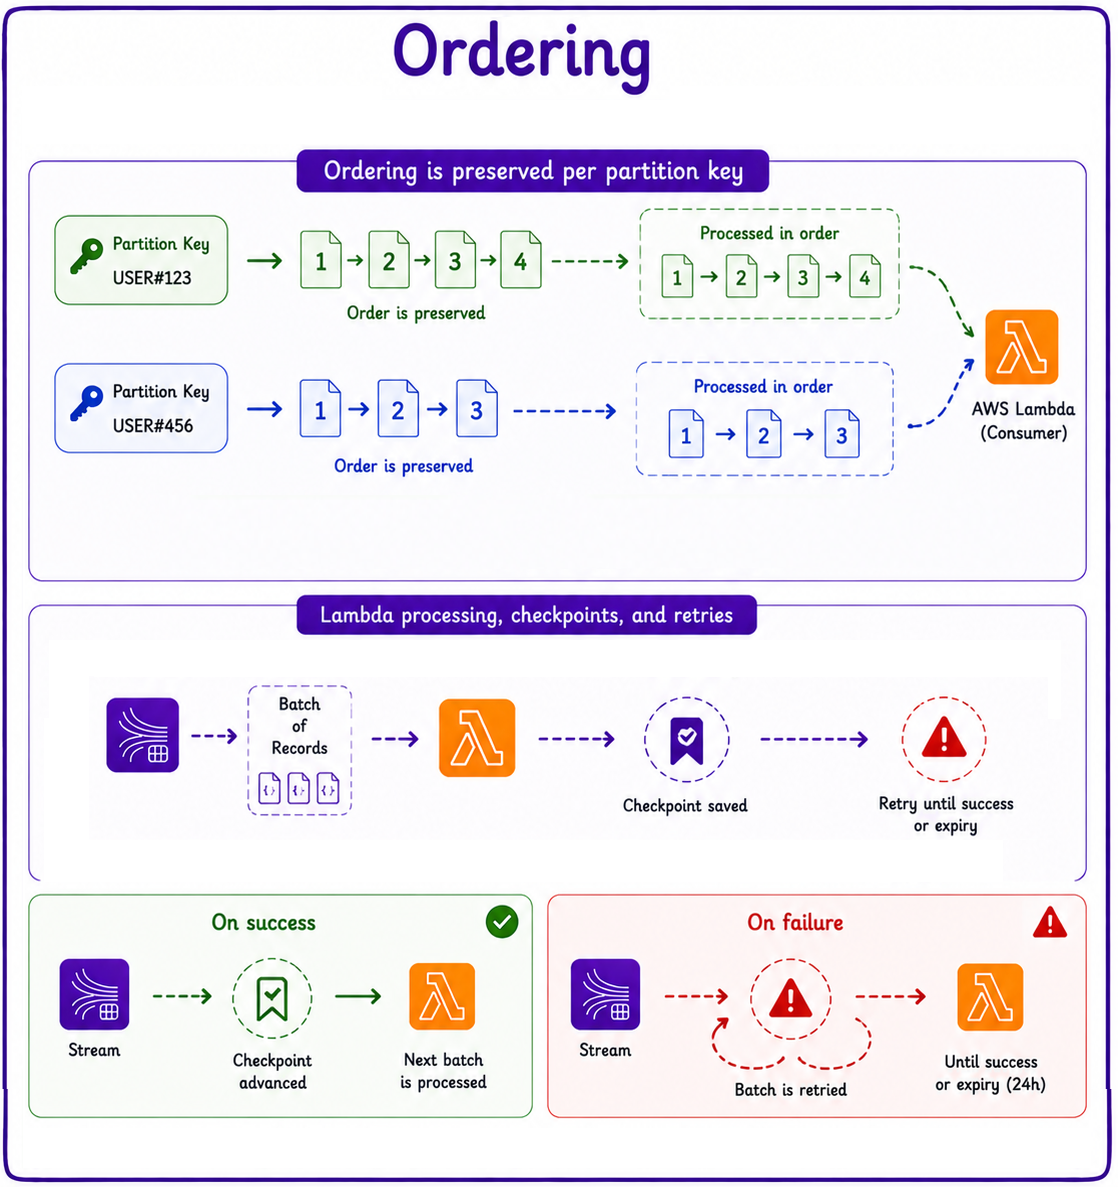
  • Streams bewahren die Reihenfolge pro Partitionsschlüssel.
  • Lambda verarbeitet Datensätze in Batches.
    • Checkpoints nach jedem erfolgreichen Batch.
    • Fehlgeschlagene Batches werden erneut versucht.
    • Wiederholungen laufen bis Erfolg oder Ablauf.


reihenfolge

Anwendungen auf AWS entwickeln


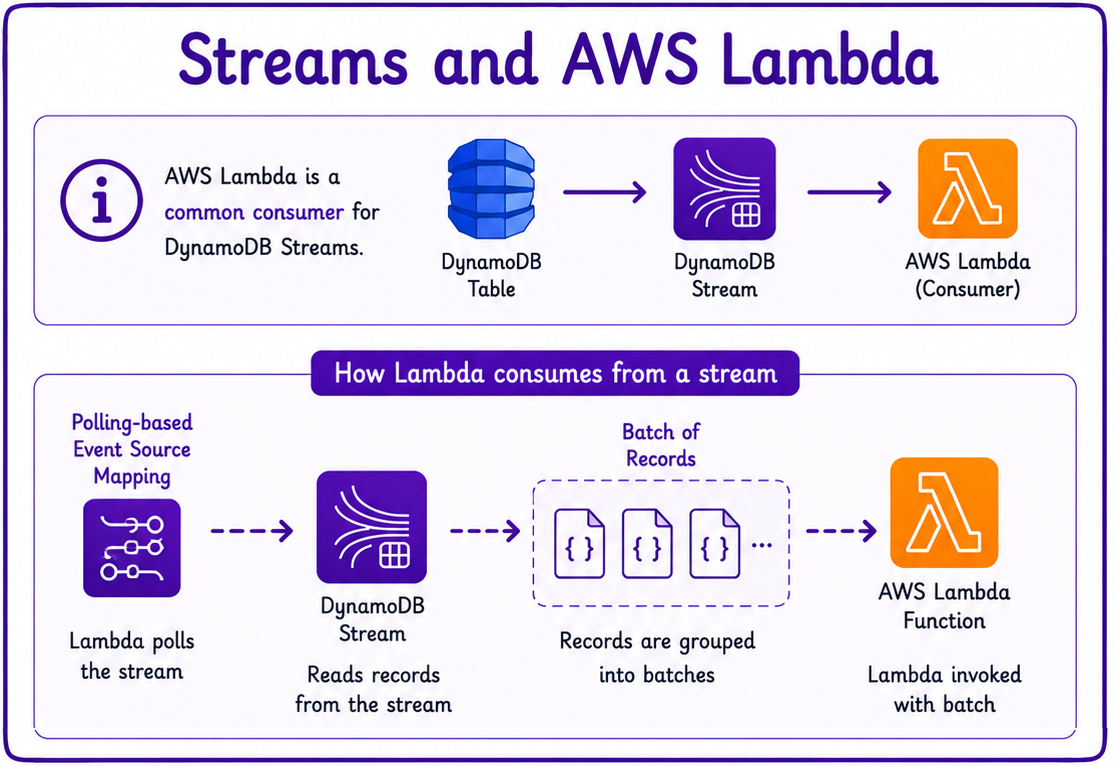
streams und aws lambda

  • Lambda ist der häufigste Stream-Consumer.
  • Nutzt ein Polling-basiertes Event-Source-Mapping.
  • Liest Datensätze aus dem Stream.
  • Ruft deine Funktion mit Batches von Datensätzen auf.
Anwendungen auf AWS entwickeln

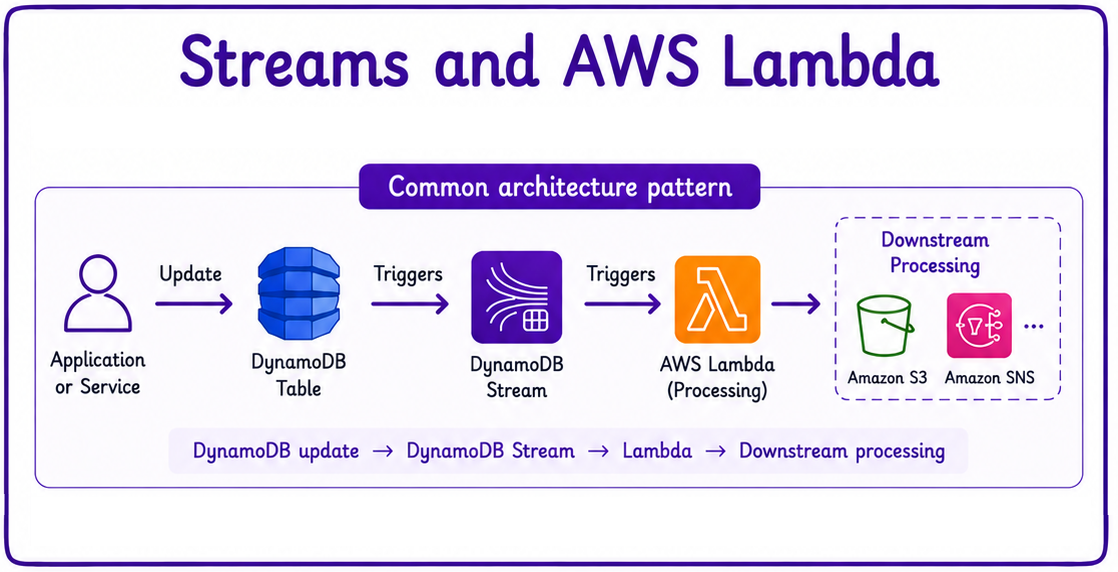
Architekturmuster


architektur-muster

  • Ein gängiges End-to-End-Muster:
    • Ein Item-Update landet in DynamoDB.
    • Die Änderung erzeugt einen Stream-Datensatz.
    • Der Datensatz triggert Lambda zur Verarbeitung.
Anwendungen auf AWS entwickeln

Skalierung


skalierung

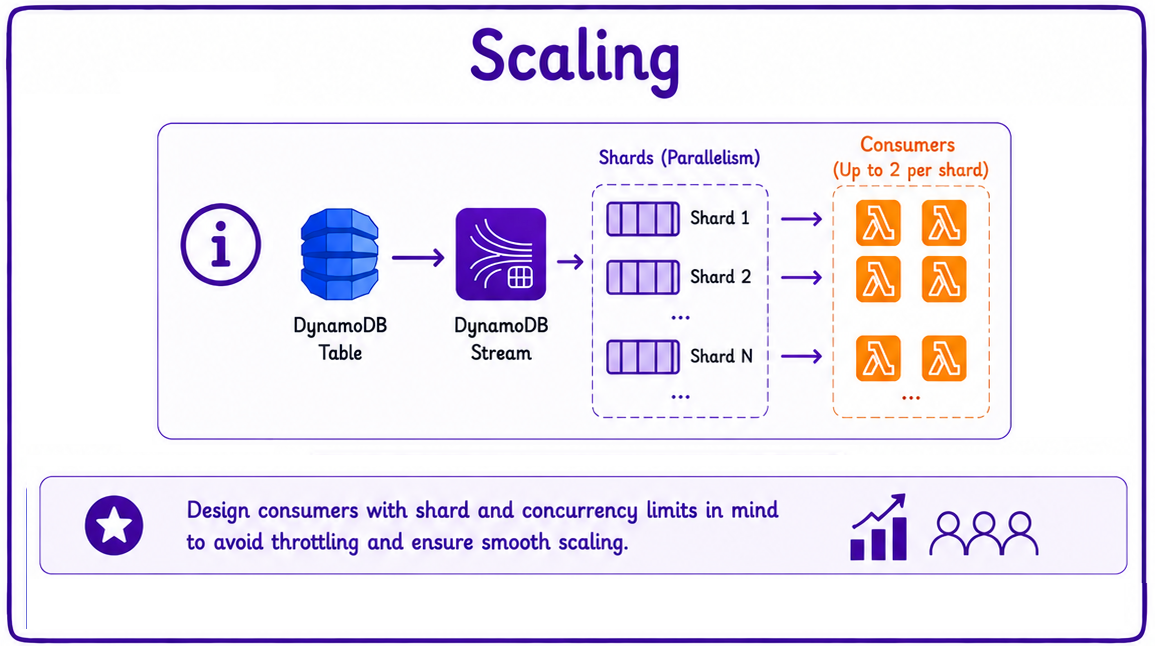
  • Streams sind intern in Shards aufgeteilt.
    • Ähnlich wie Kinesis Data Streams.
  • Pro Shard sind bis zu zwei gleichzeitige Consumer erlaubt.
    • Überschreitungen führen oft zu Read-Throttling.
Anwendungen auf AWS entwickeln
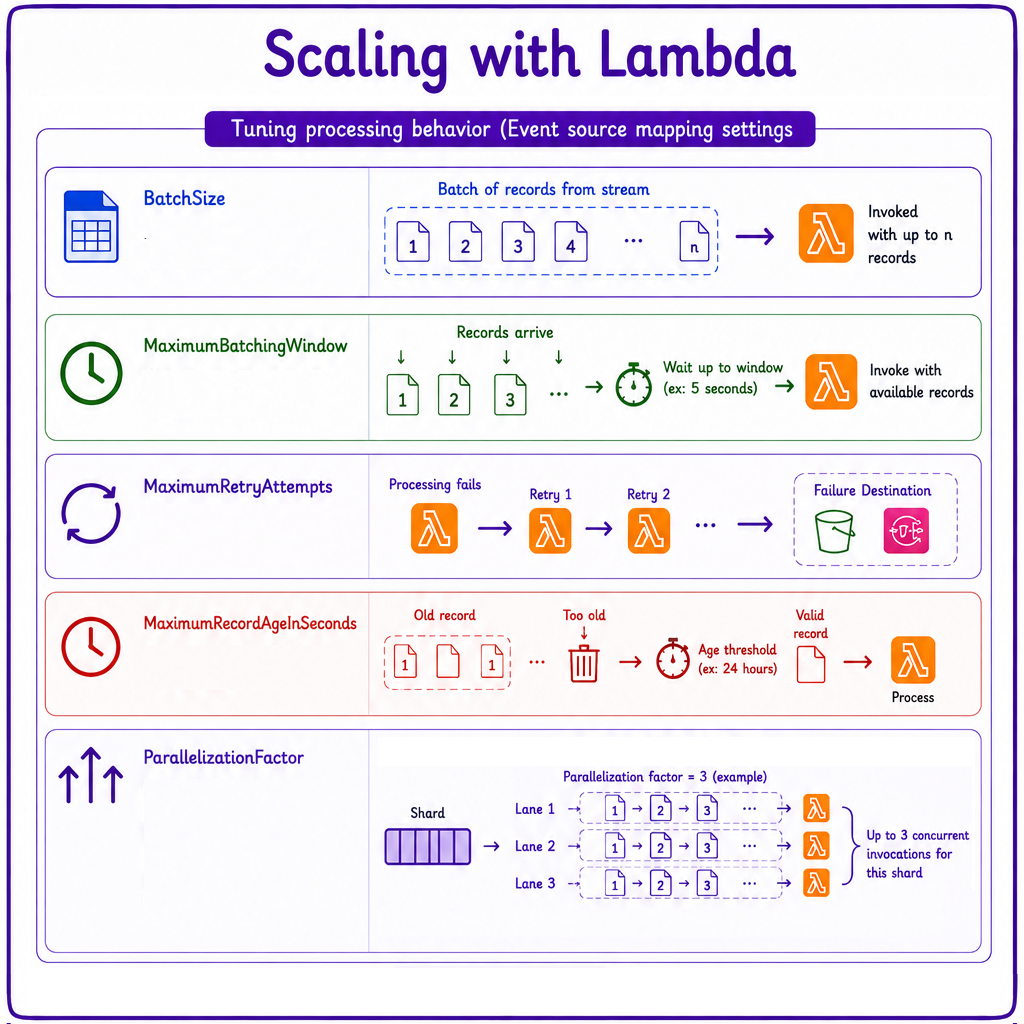
  • Lambda-Concurrency skaliert mit der Shard-Anzahl.
  • Feintuning der Verarbeitung mit:
    • BatchSize: max. Datensätze pro Aufruf.
    • MaximumBatchingWindow: Wartezeit vor Teilbatch.
    • MaximumRetryAttempts: Wiederholungen bis Failure Destination.
    • MaximumRecordAgeInSeconds: verwerfe zu alte Datensätze.
    • ParallelizationFactor: parallele Verarbeitung pro Shard (max. 10).

skalierung mit lambda

Anwendungen auf AWS entwickeln

Filtering und Tumbling Windows

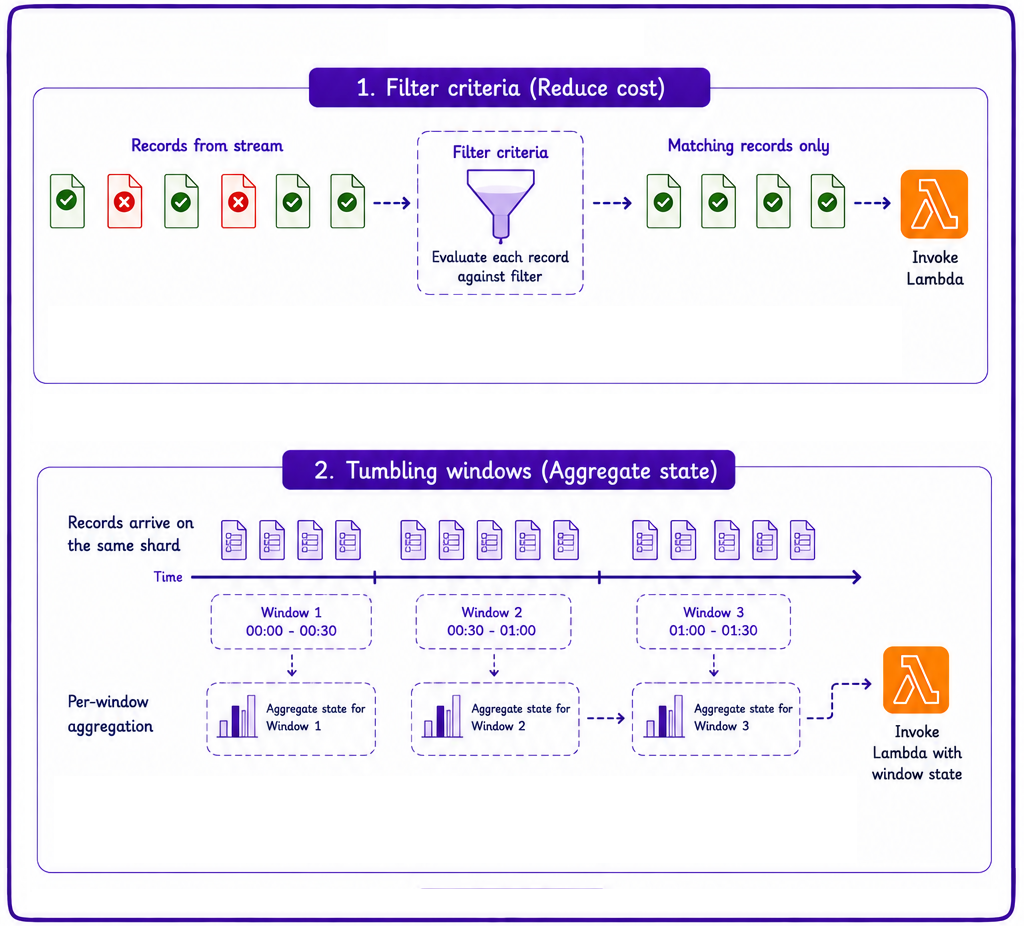
  • Lambda unterstützt Filterkriterien.
    • Verwirf Datensätze vor dem Funktionsaufruf.
    • Reduziert unnötige Aufrufe und Kosten.
  • Lambda unterstützt Tumbling Windows.
    • Aggregiere Zustand über Batches in einem Shard.


filter und tumbling windows

Anwendungen auf AWS entwickeln

Doppelte Datensätze verwalten

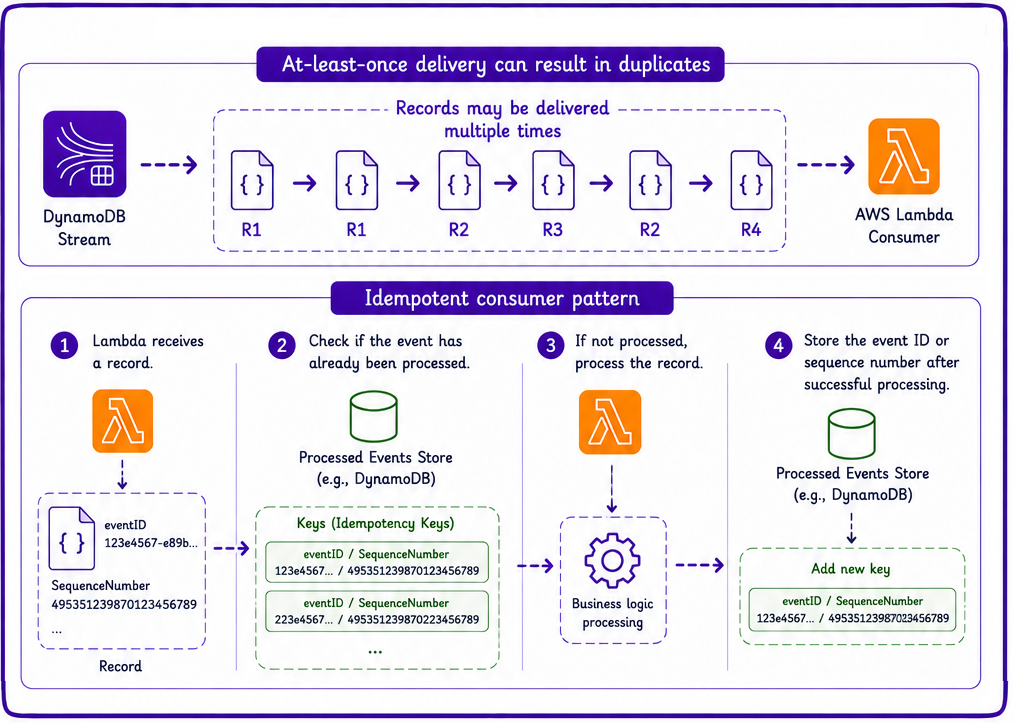
  • Streams erfassen jede Änderung genau einmal.
  • Lambda verarbeitet Datensätze mit At-least-once-Semantik.
    • Retries können denselben Datensatz erneut verarbeiten.
  • Designe Consumer idempotent.
  • Gängiges Muster: verarbeitetes eventID oder SequenceNumber speichern.
    • Überspringe bereits bearbeitete Datensätze.
    • Beide bleiben über Retries stabil.
    • Zuverlässige Idempotency-Keys.


doppelte datensätze verwalten

Anwendungen auf AWS entwickeln

Fehler behandeln


fehlerbehandlung

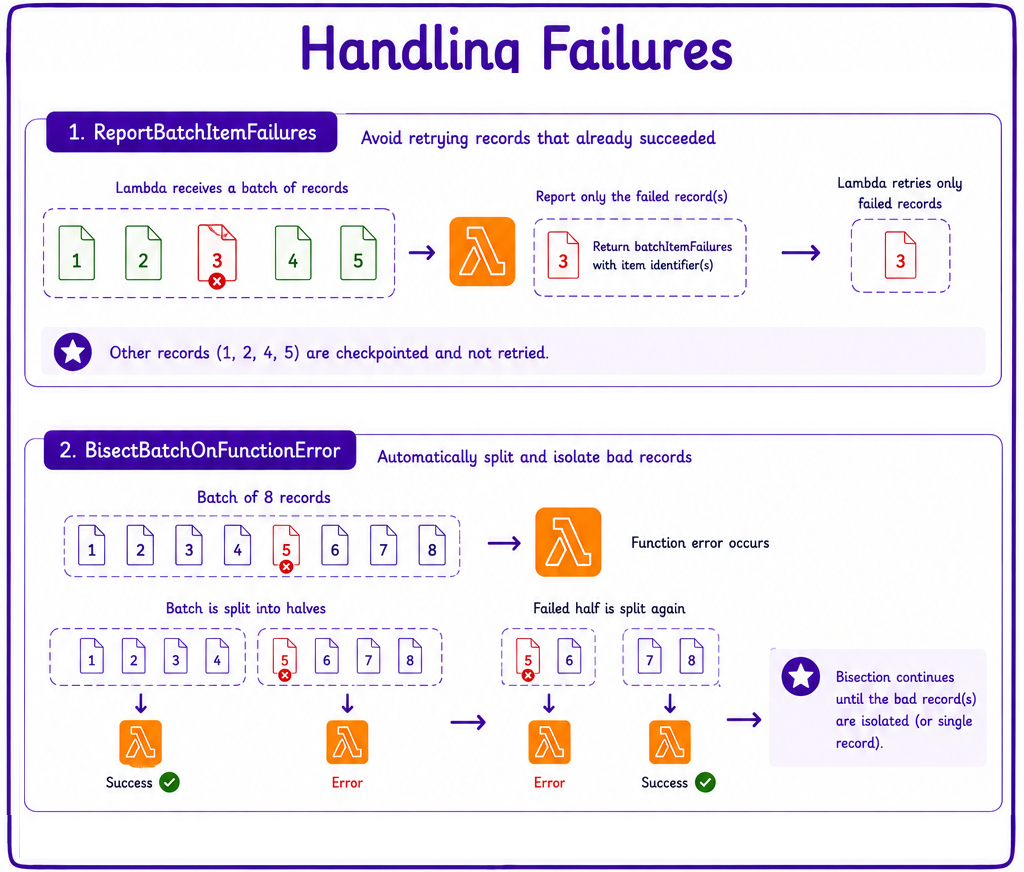
  • ReportBatchItemFailures wiederholt nur fehlgeschlagene Datensätze.
  • Behandle Lambda-Fehler mit:
    • BisectBatchOnFunctionError für Batch-Halbierung.
    • Retry-Steuerung.
    • Failure Destinations für Poison Batches nach erschöpften Retries.
Anwendungen auf AWS entwickeln

Integration: DynamoDB zu Kinesis


integration

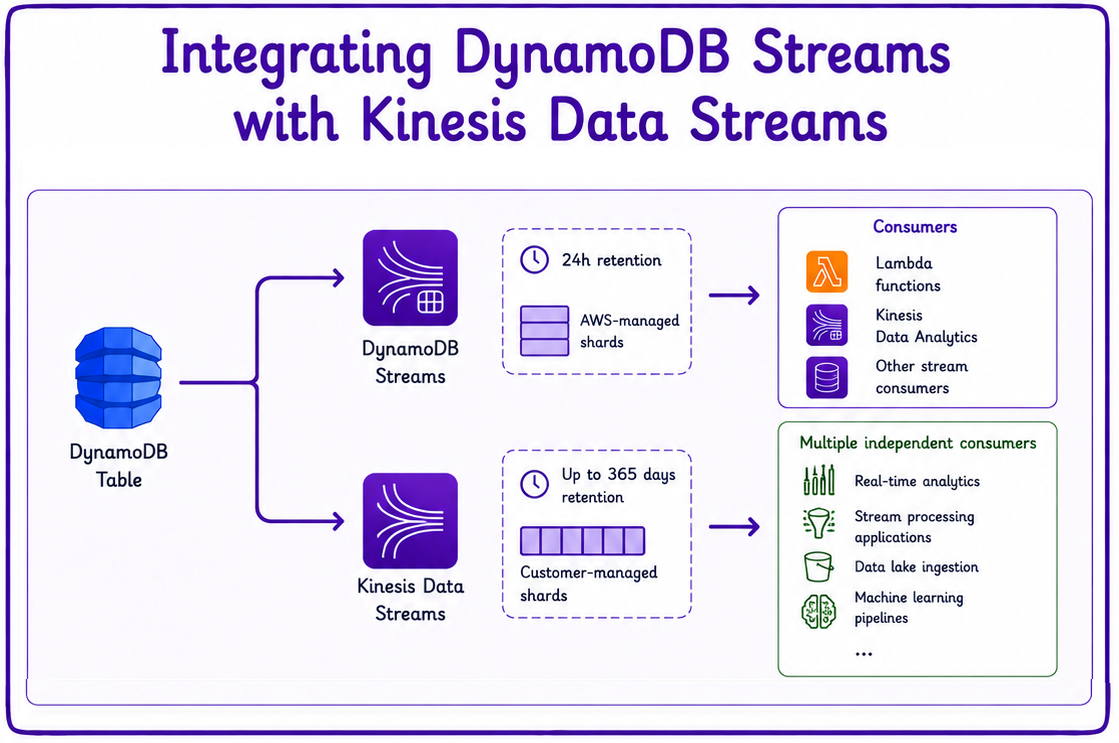
  • Tabellen können Änderungen direkt an Kinesis Data Streams senden.
    • Über das Feature „Kinesis Data Streams for DynamoDB".
    • Eine separate, parallele Fähigkeit, keine Verkettung.
    • Events fließen NICHT durch DynamoDB Streams.
  • Beides kann gleichzeitig auf derselben Tabelle laufen.
    • Arbeiten unabhängig voneinander.
    • Versorgt breitere Streaming- und Analytics-Architekturen.
Anwendungen auf AWS entwickeln

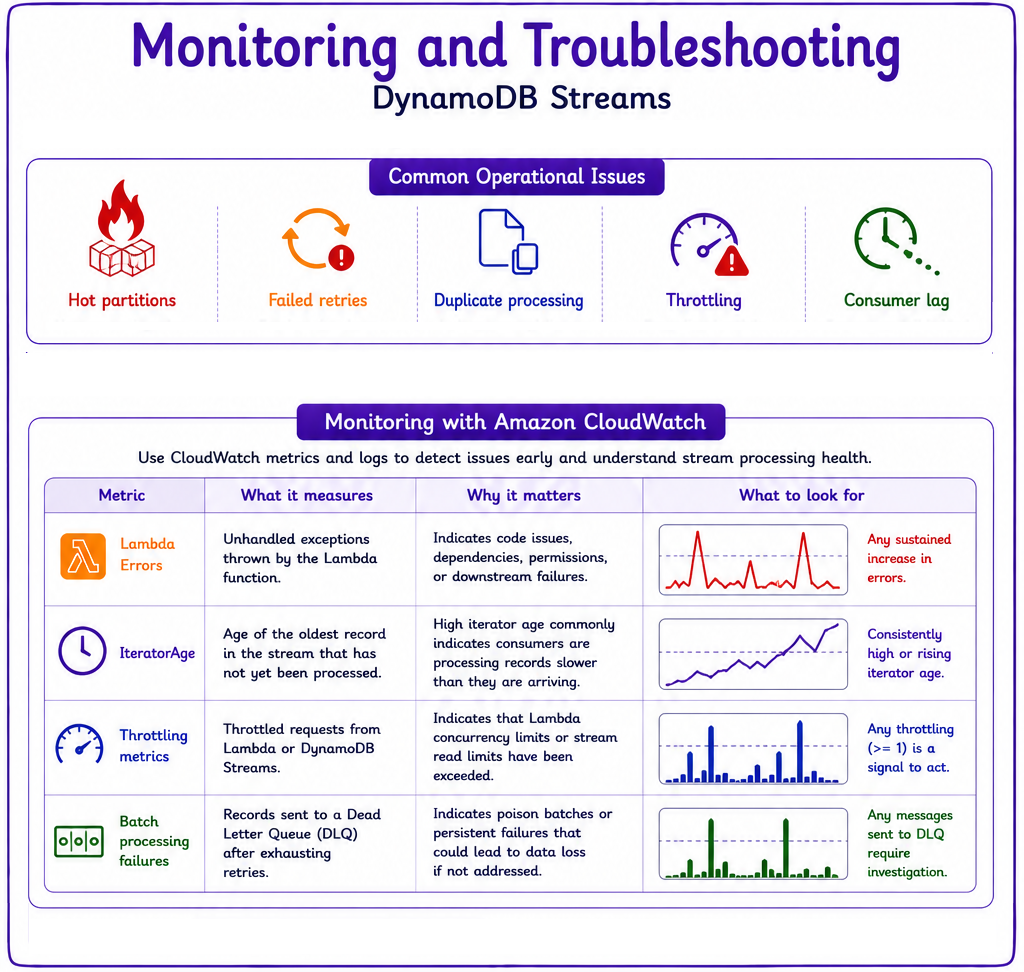
Monitoring: häufige Probleme


monitoring

  • Häufige Betriebsprobleme:
    • Heiße Partitionen.
    • Fehlgeschlagene Retries.
    • Doppelte Verarbeitung.
    • Throttling und Consumer-Lag.
Anwendungen auf AWS entwickeln

Monitoring: CloudWatch-Metriken

  • Wichtige CloudWatch-Metriken:
    • Lambda Errors: zeigt Code- oder Downstream-Probleme.
    • IteratorAge: hohe Werte = langsame Consumer.
    • Throttling-Metriken: überschrittene Read-Limits.
    • Batch-Verarbeitungsfehler: Datensätze in einer DLQ.


monitoring

Anwendungen auf AWS entwickeln

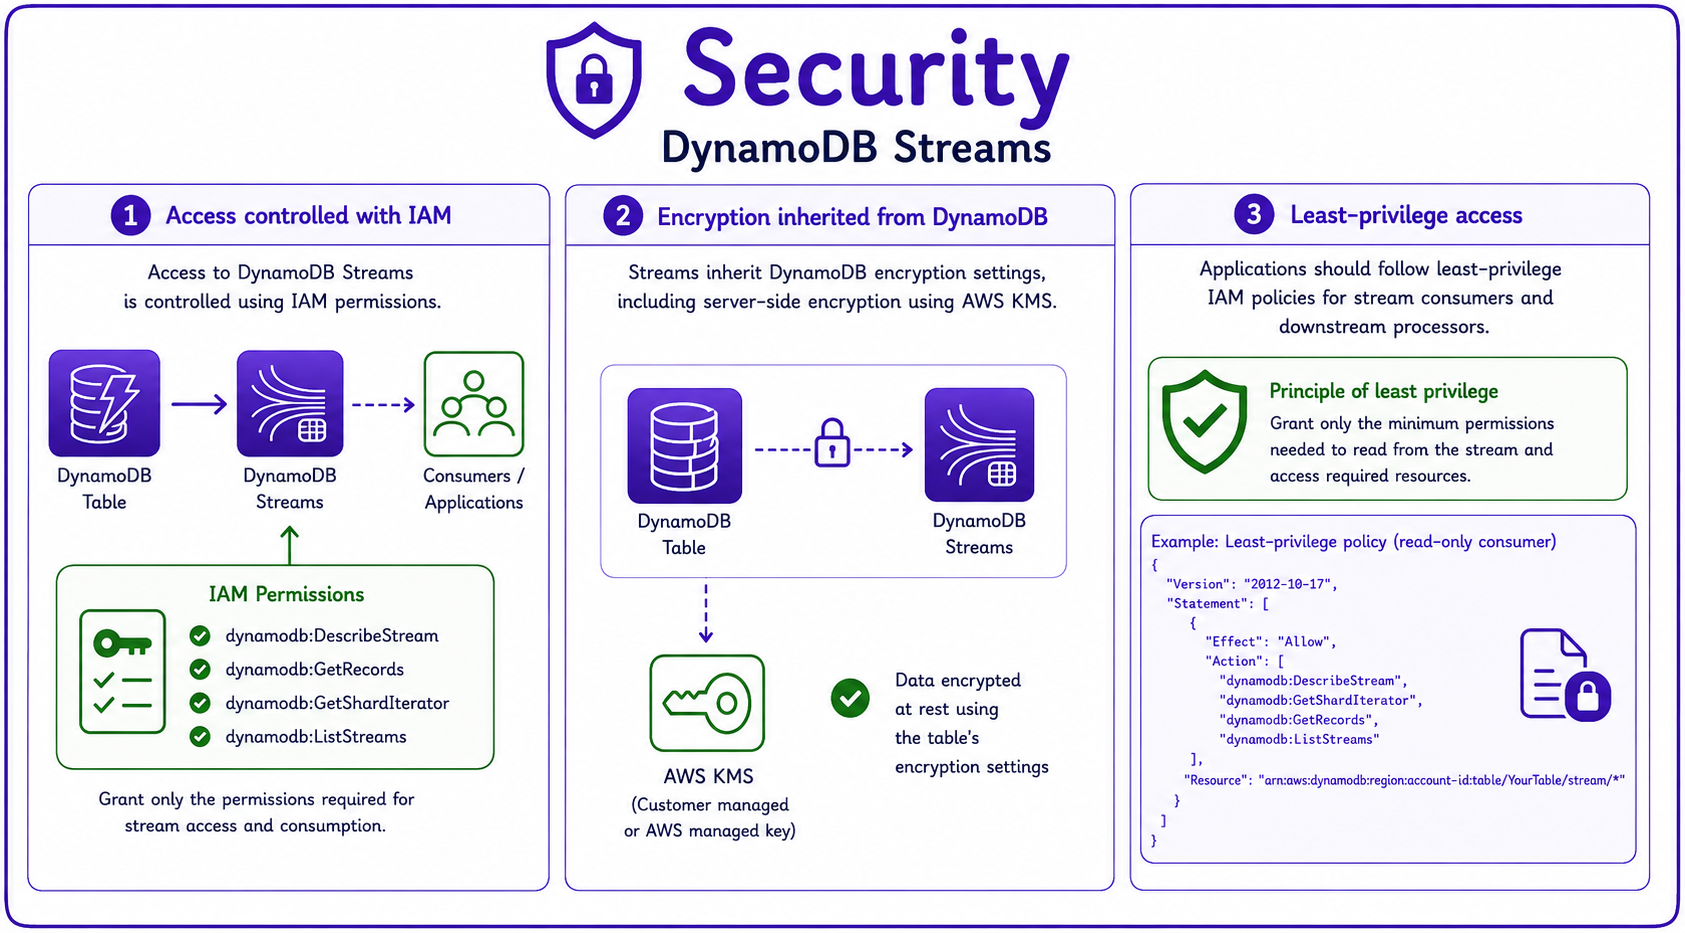
Sicherheit

  • Zugriff auf Streams wird über IAM-Berechtigungen gesteuert.
  • Streams erben die Verschlüsselungseinstellungen der Tabelle.
    • Einschließlich serverseitiger Verschlüsselung at rest mit KMS.
  • Wende Least-Privilege-Policies auf Consumer und Downstream-Prozessoren an.


sicherheit

Anwendungen auf AWS entwickeln

Lass uns üben!

Anwendungen auf AWS entwickeln

Preparing Video For Download...