Coordonner les services et gérer l'état
Développer des applications sur AWS
Ricardo Sueiras
Principal Technologist
Coordination des services
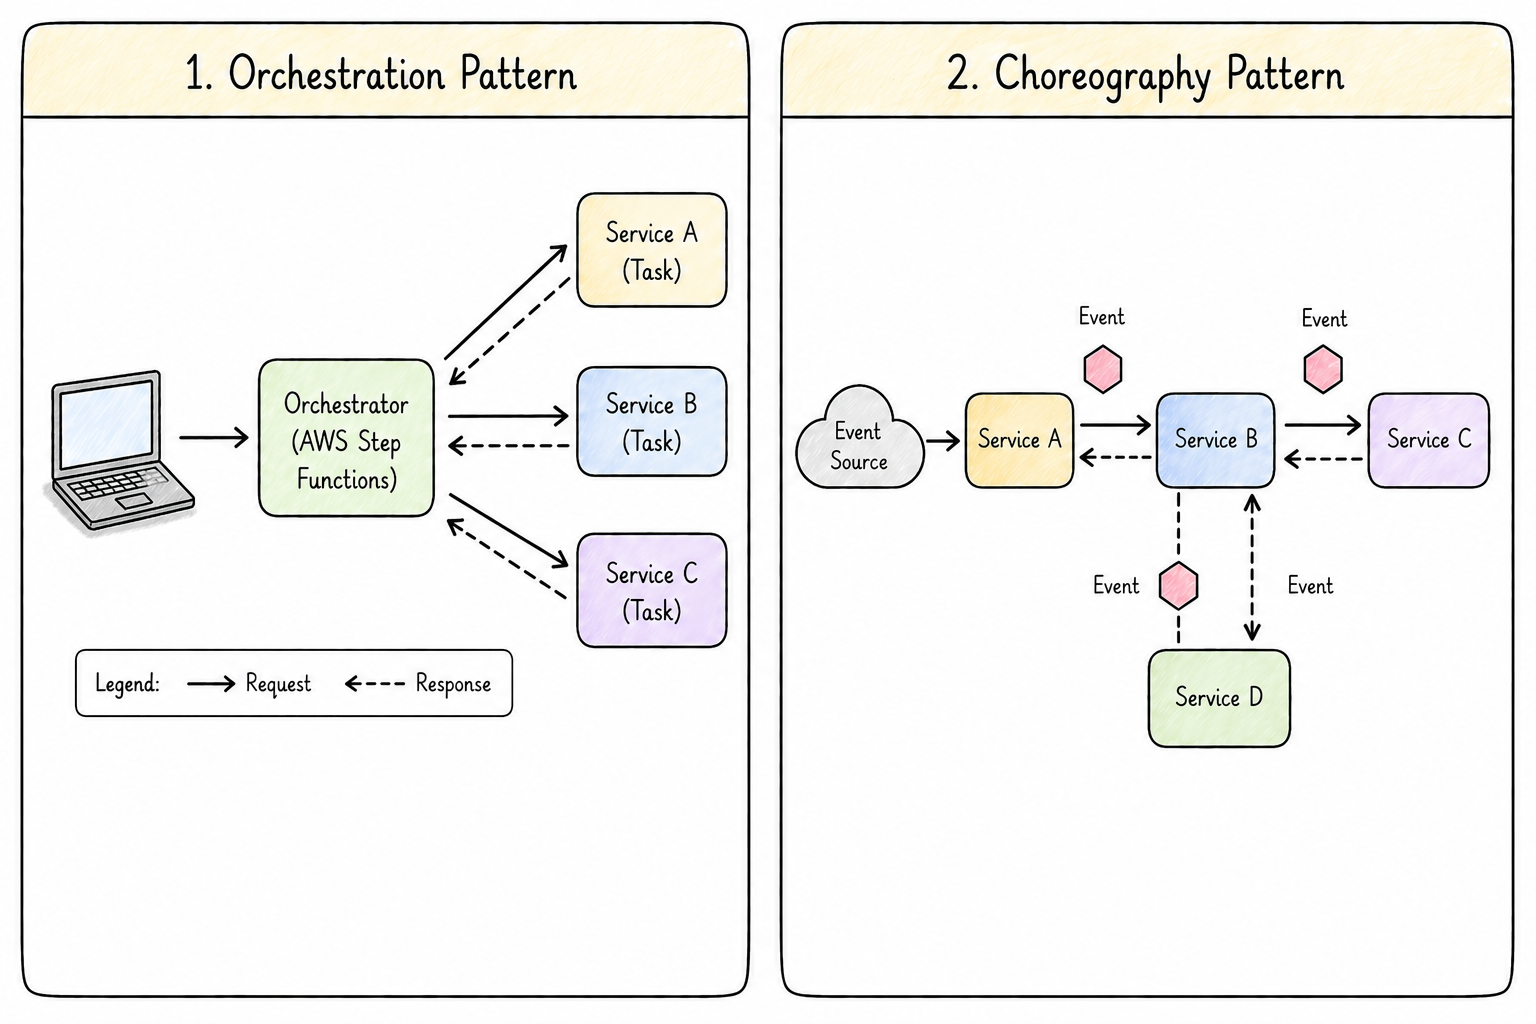
Plusieurs services doivent collaborer pour exécuter un enchaînement.
Ils ont besoin d'une stratégie de coordination.
Deux approches : orchestration et chorégraphie.
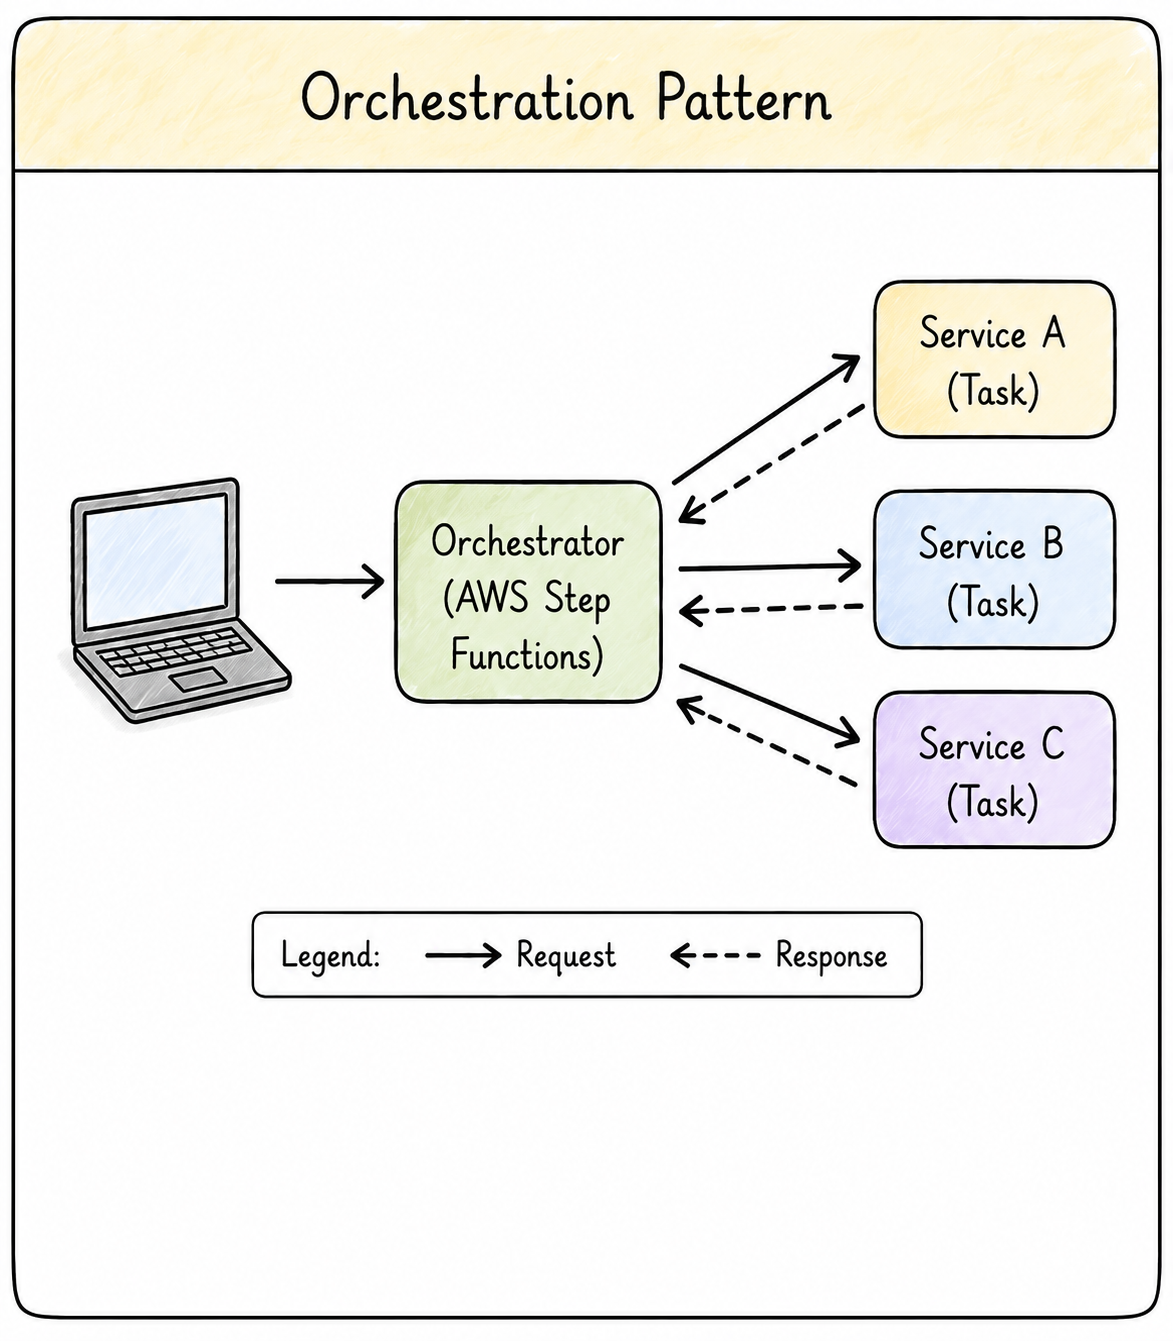
Orchestration
Un orchestrateur central coordonne l'enchaînement.
Il contrôle la séquence et choisit le service à exécuter ensuite.
Utile pour les reprises, la logique conditionnelle et la gestion des erreurs.
Sur AWS : mis en œuvre avec Step Functions, Lambda, ECS, DynamoDB.
Orchestration
La logique d'enchaînement est centralisée : débogage et suivi facilités.
Compromis : crée une dépendance centrale.
Chorégraphie
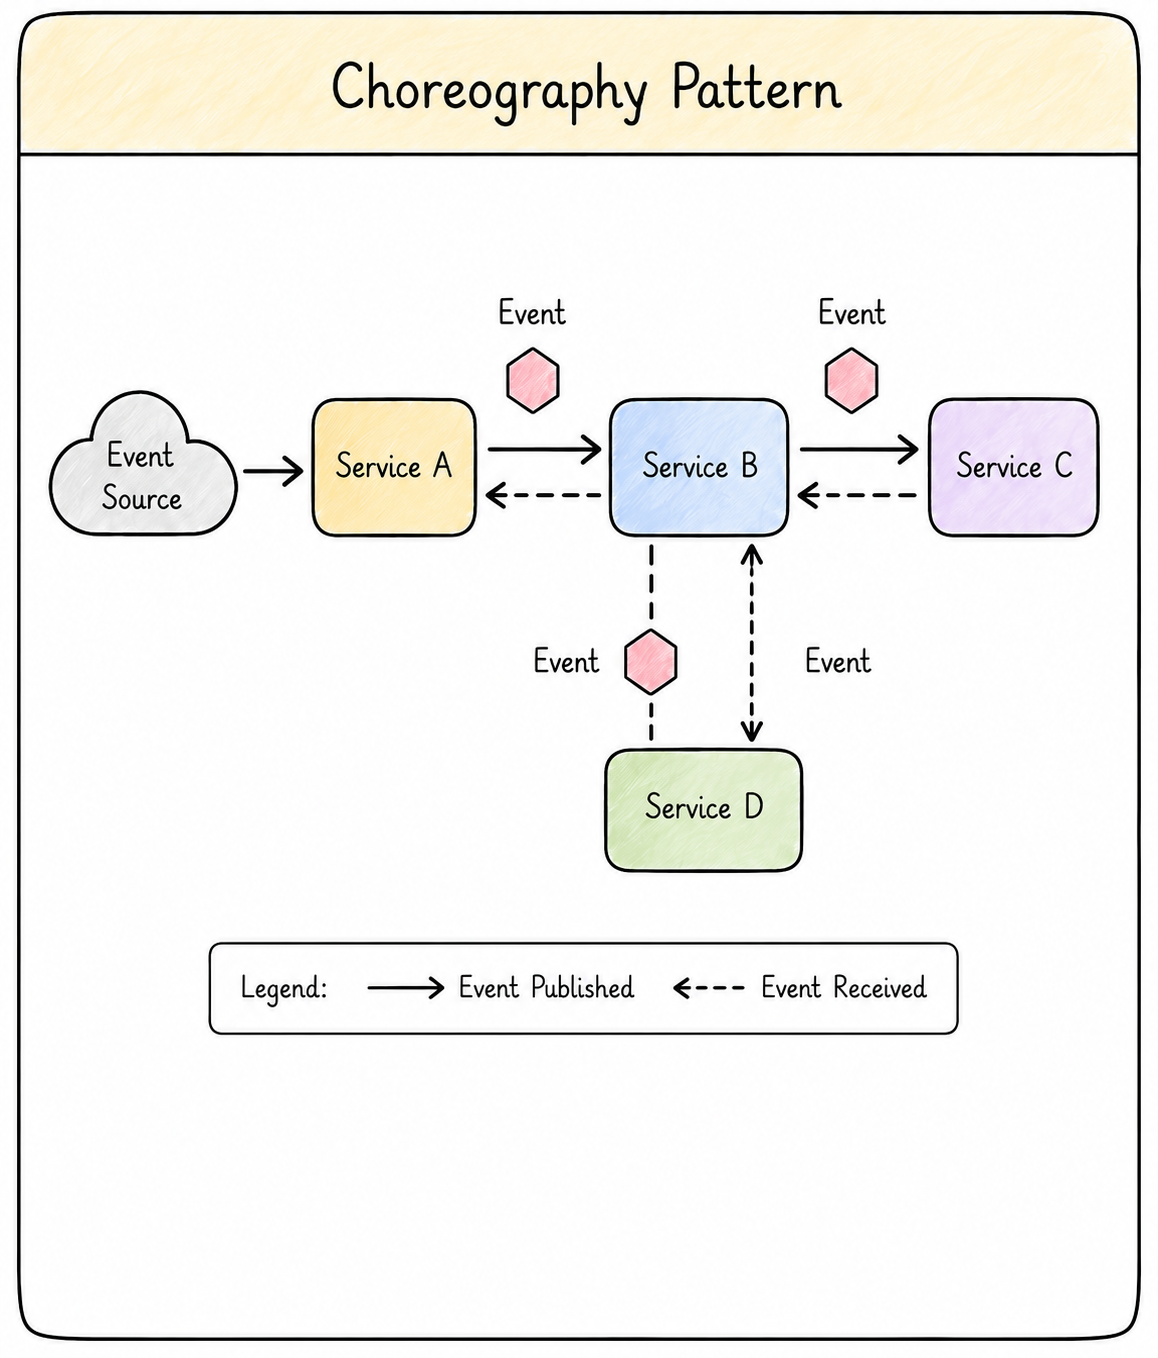
Aucun contrôleur central.
Les services réagissent aux événements de façon autonome.
Chaque service écoute les événements pertinents et fait son travail.
Aucun service n'a besoin de connaître tout l'enchaînement.
Améliore le couplage faible et l'évolutivité.
Chorégraphie
Sur AWS : EventBridge, SNS, SQS.
Très évolutive.
Compromis : plus difficile à comprendre et à déboguer à grande échelle.
Architecture axée sur les événements
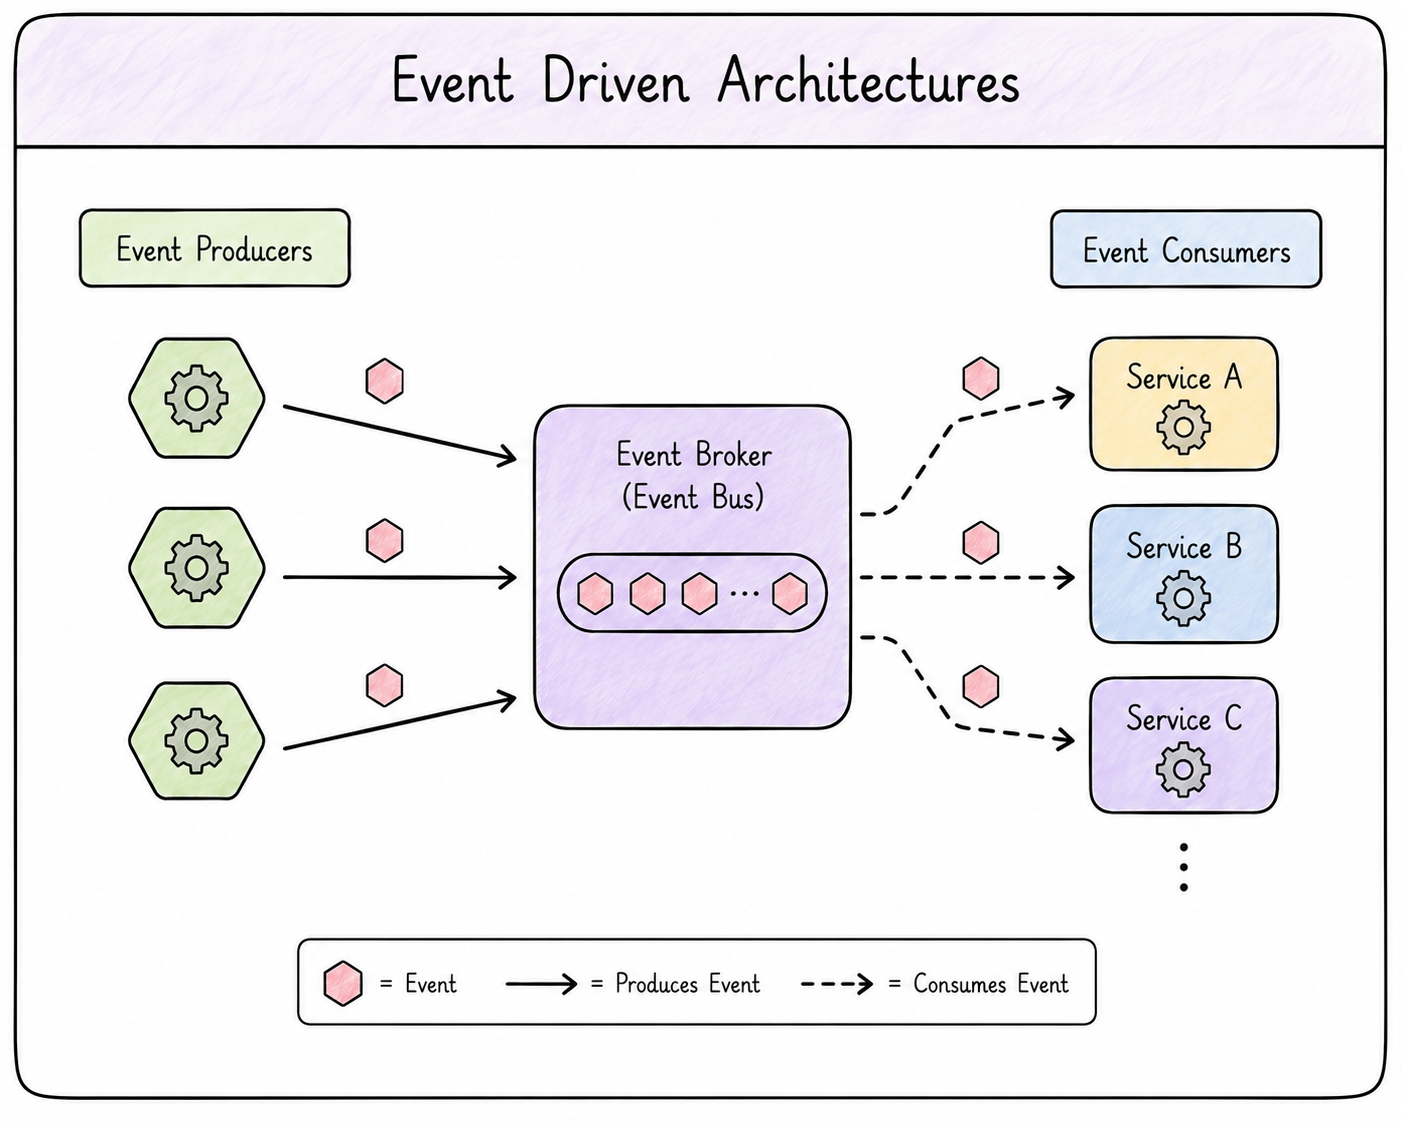
Les services communiquent en produisant et consommant des événements.
Favorise un couplage faible entre services.
Favorise une grande évolutivité.
Permet le traitement parallèle des événements.
De nouveaux services peuvent s'abonner sans modifier l'existant.
Architecture axée sur les événements
Compromis à prévoir avec l'EDA :
Concevoir pour une cohérence éventuelle.
Mettre en œuvre l'idempotence.
La gestion des défaillances est plus complexe.
Idempotence
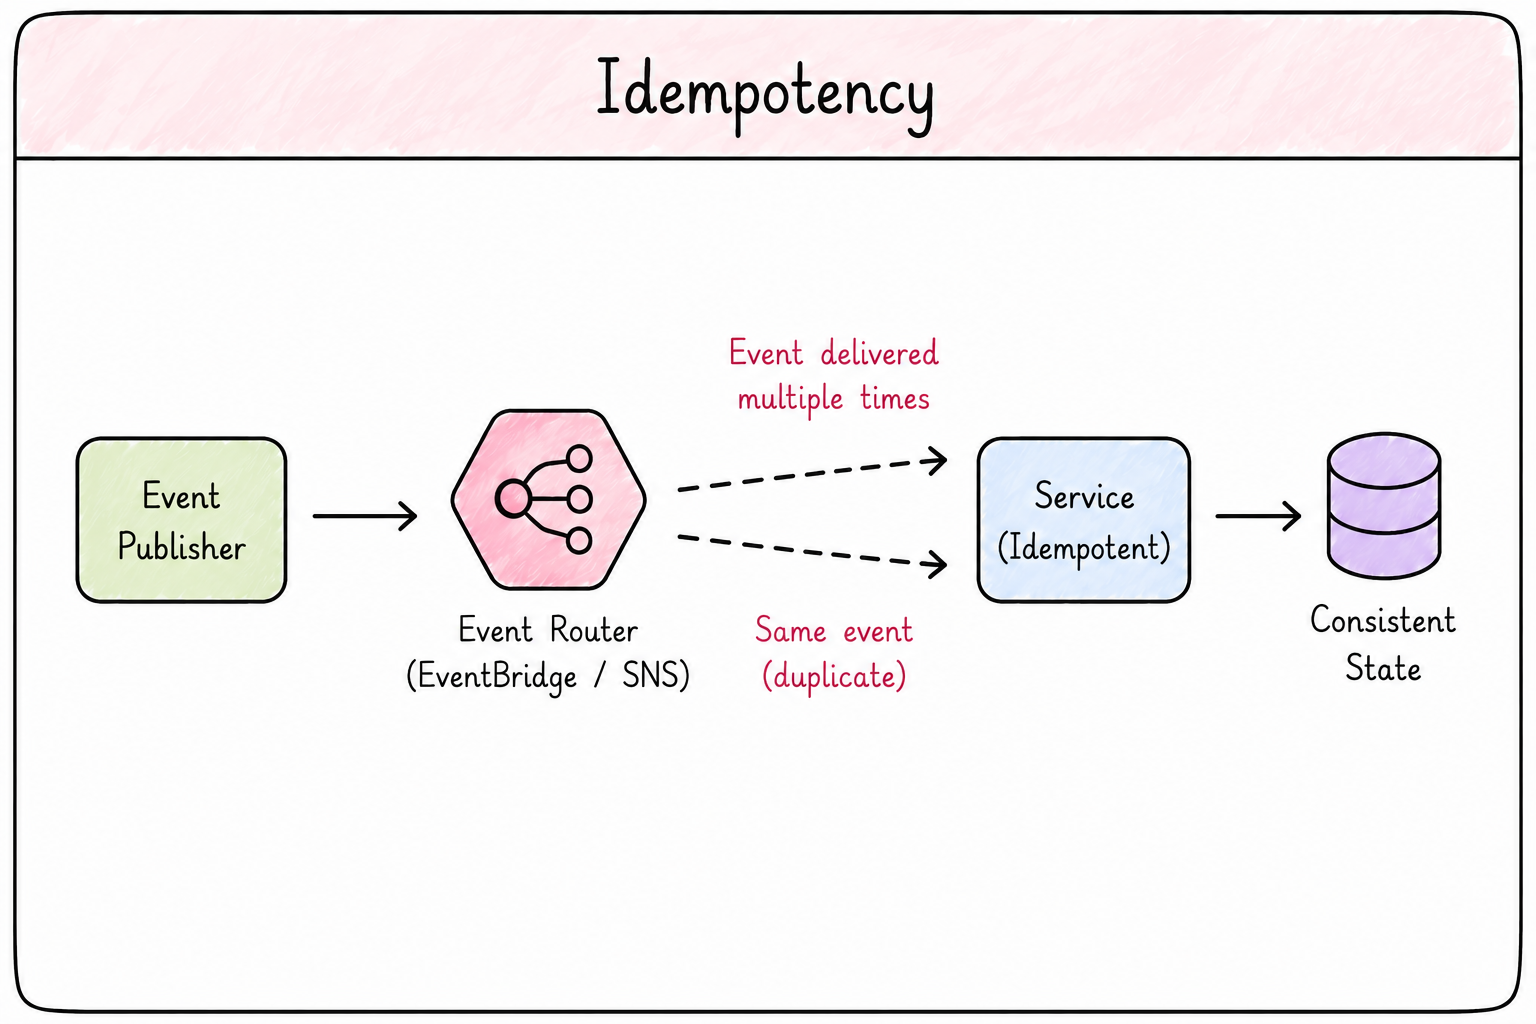
La même opération exécutée plusieurs fois donne le même résultat.
Principe clé en conception asynchrone et axée événements.
Les systèmes distribués peuvent livrer des doublons (reprises, pannes réseau, retraitement).
Préserve la justesse et la fiabilité du système.
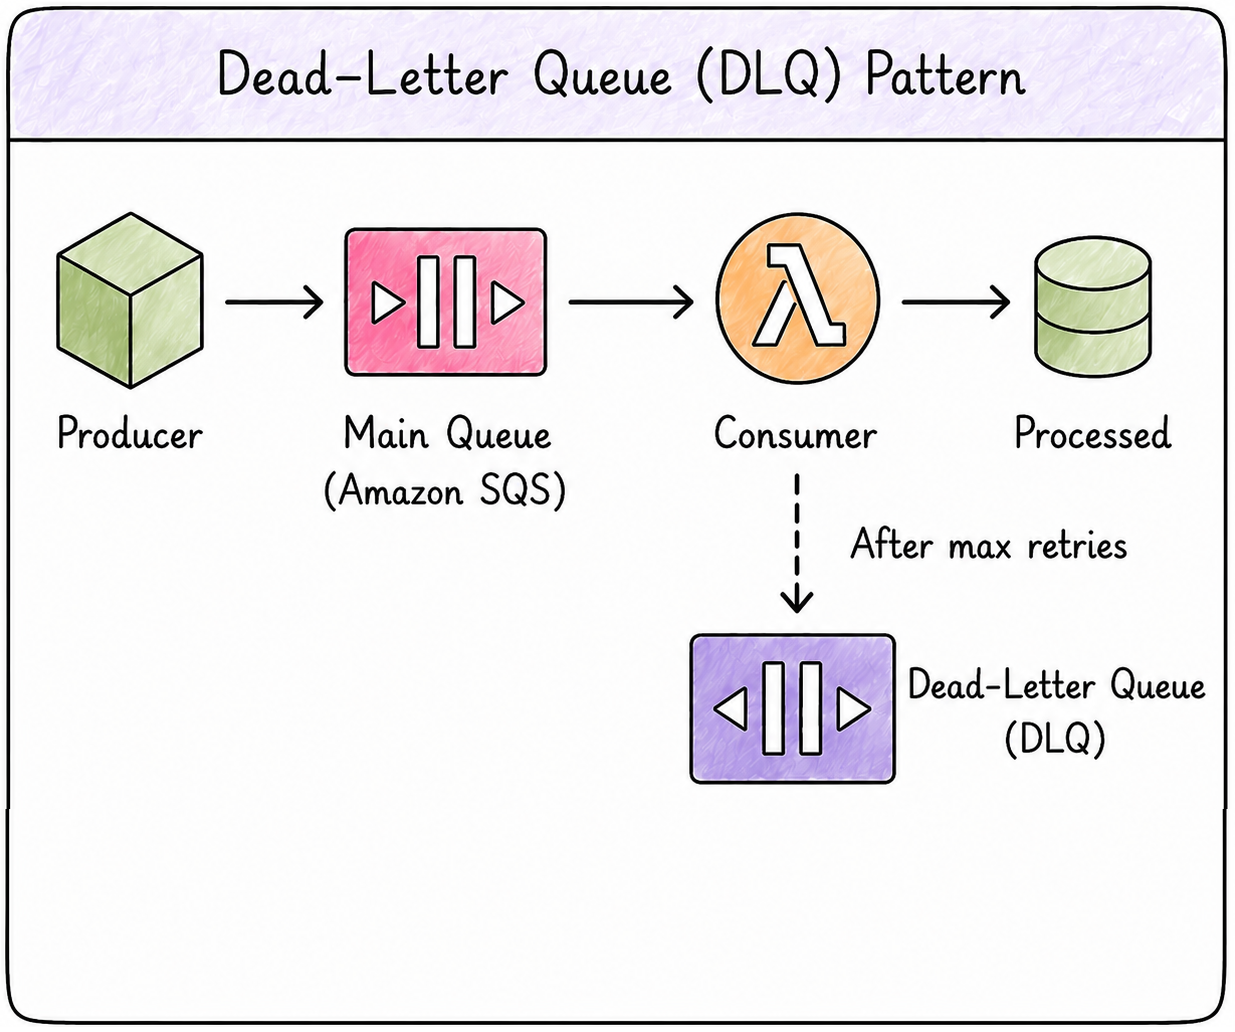
Dead letter queues
Gère les échecs en communication asynchrone.
Isole les messages problématiques « poison ».
Après plusieurs échecs de reprise, le message passe à la DLQ.
Le flux principal continue de fonctionner.
Dead letter queues
À utiliser quand l'ordre des messages n'est pas critique.
À éviter pour les systèmes non critiques où une perte ponctuelle est acceptable.
À éviter quand l'ordre des messages doit être préservé.
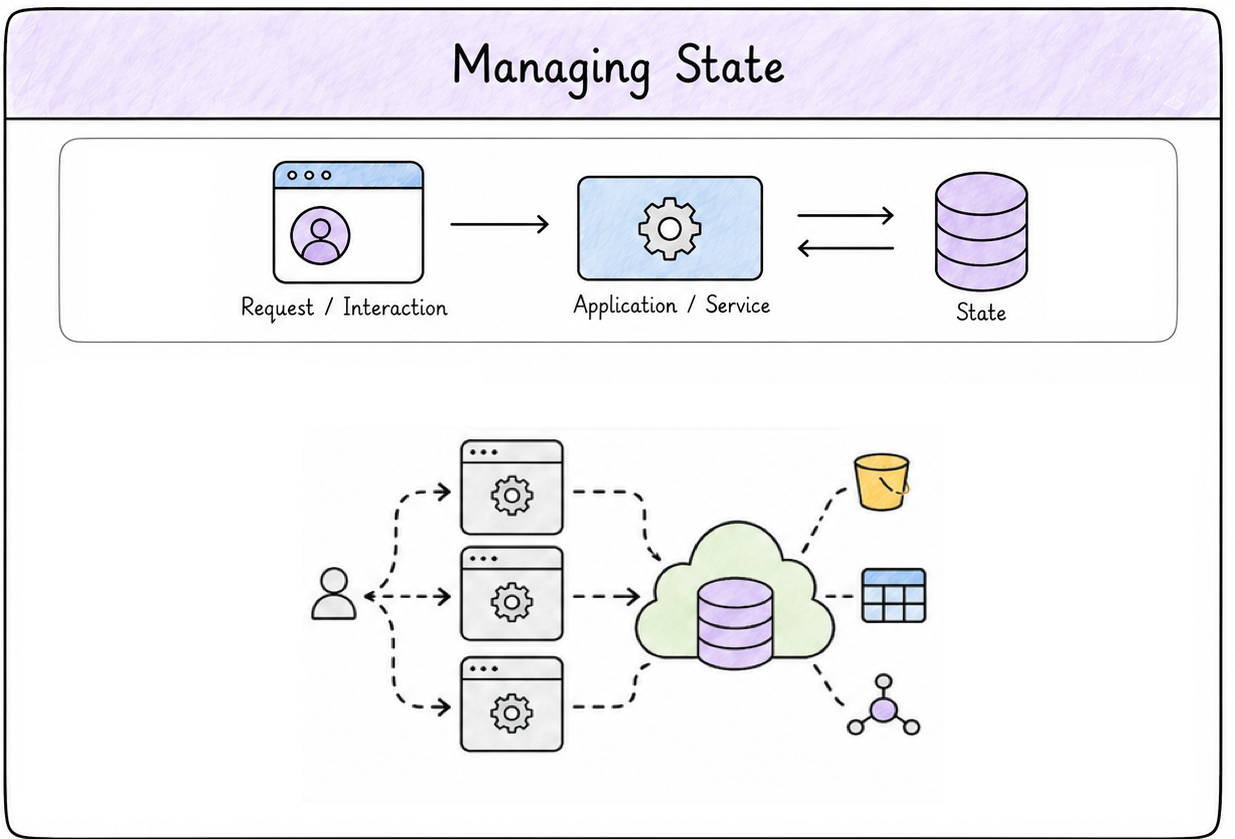
Gestion de l'état
La gestion de l'état est essentielle aux applis infonuagiques natives.
L'état : toute donnée conservée entre interactions.
Stocker l'état localement limite l'évolutivité et la résilience.
Gestion de l'état
La gestion de l'état implique des compromis selon le produit.
Un état externe améliore l'évolutivité et la résilience.
Coûts : latence et complexité accrues.
À considérer : cohérence, cache et modes d'accès aux données.
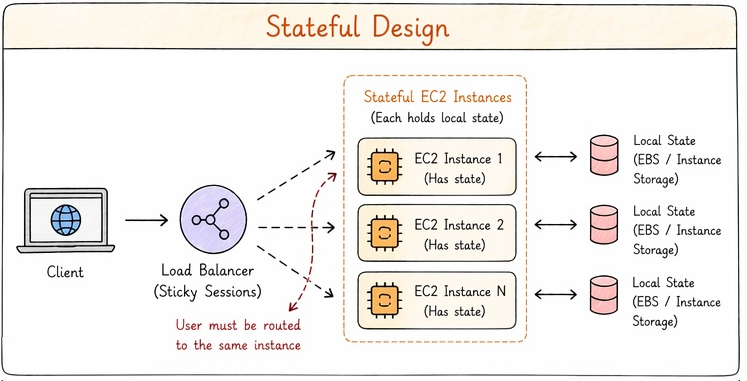
Avec état (stateful)
Les données de session restent sur le serveur.
Les requêtes doivent aller à la même instance (sessions persistantes).
Limite la flexibilité de mise à l'échelle.
Si l'instance tombe, la session disparaît.
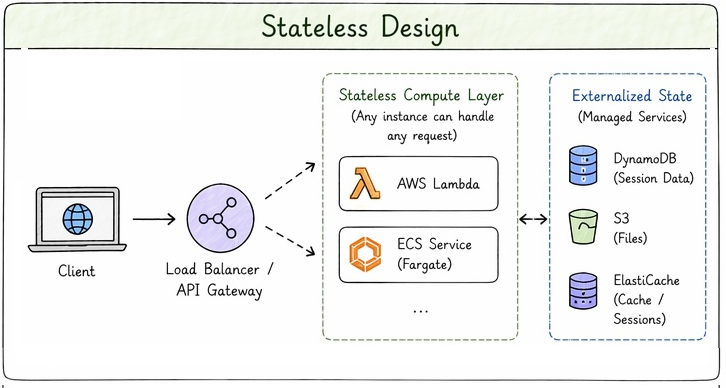
Sans état (stateless)
Chaque requête est traitée indépendamment.
Aucun état n'est stocké sur le serveur.
L'état vit dans des systèmes externes.
Approche privilégiée pour les applis infonuagiques natives.
Toute instance peut traiter toute requête : la mise à l'échelle horizontale est simple.
Passons à la pratique !
Développer des applications sur AWS
Preparing Video For Download...