使用 DynamoDB 进行数据流处理
在 AWS 上开发应用

Ricardo Sueiras
Principal Technologist
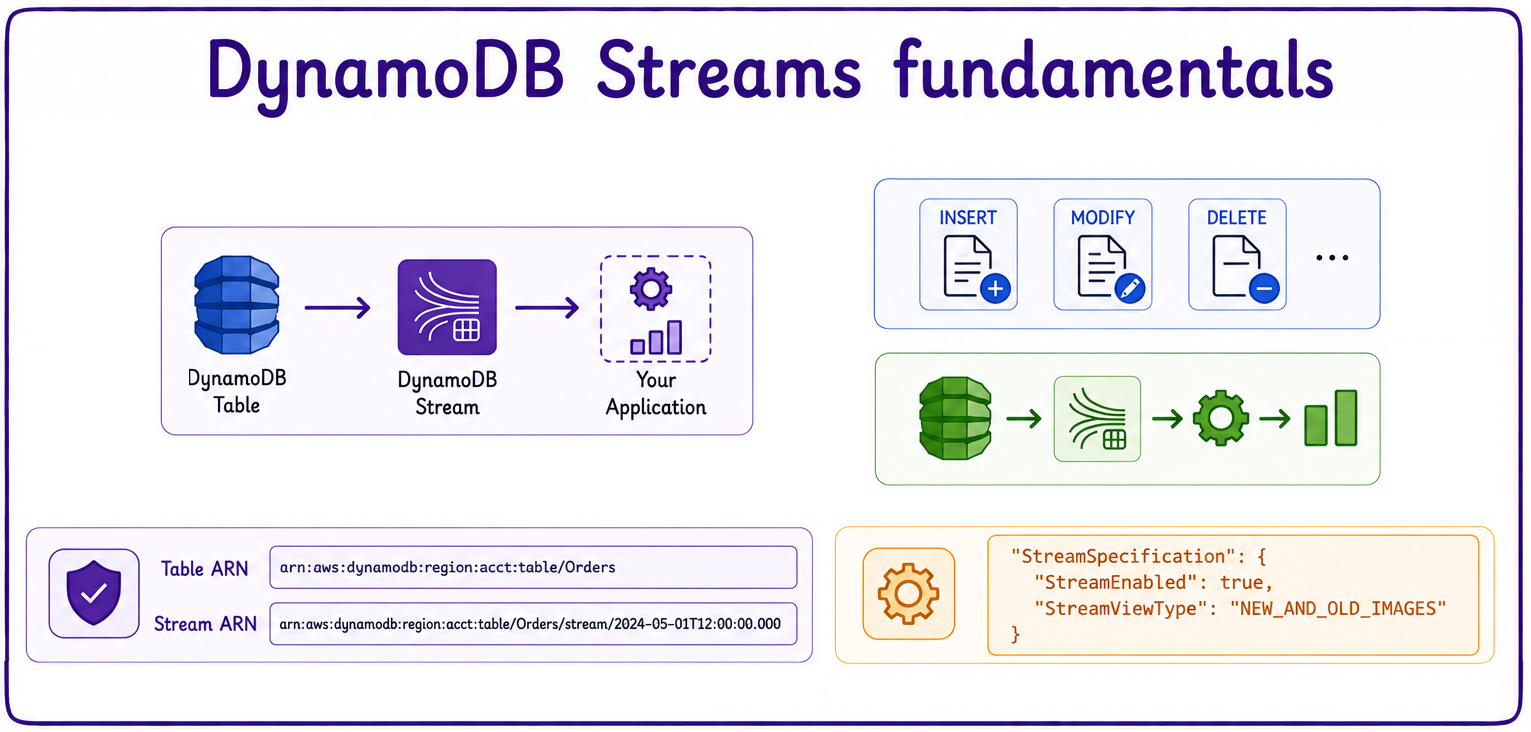
DynamoDB Streams 基础
- 近实时响应数据库变更。
- 基于事件驱动模式。
- 每次插入、修改、删除都会生成流记录。
- 构建无需轮询的数据驱动应用。
- 默认关闭:用
StreamSpecification 启用。
- 每个流都有自己的 ARN,与表的 ARN 不同。
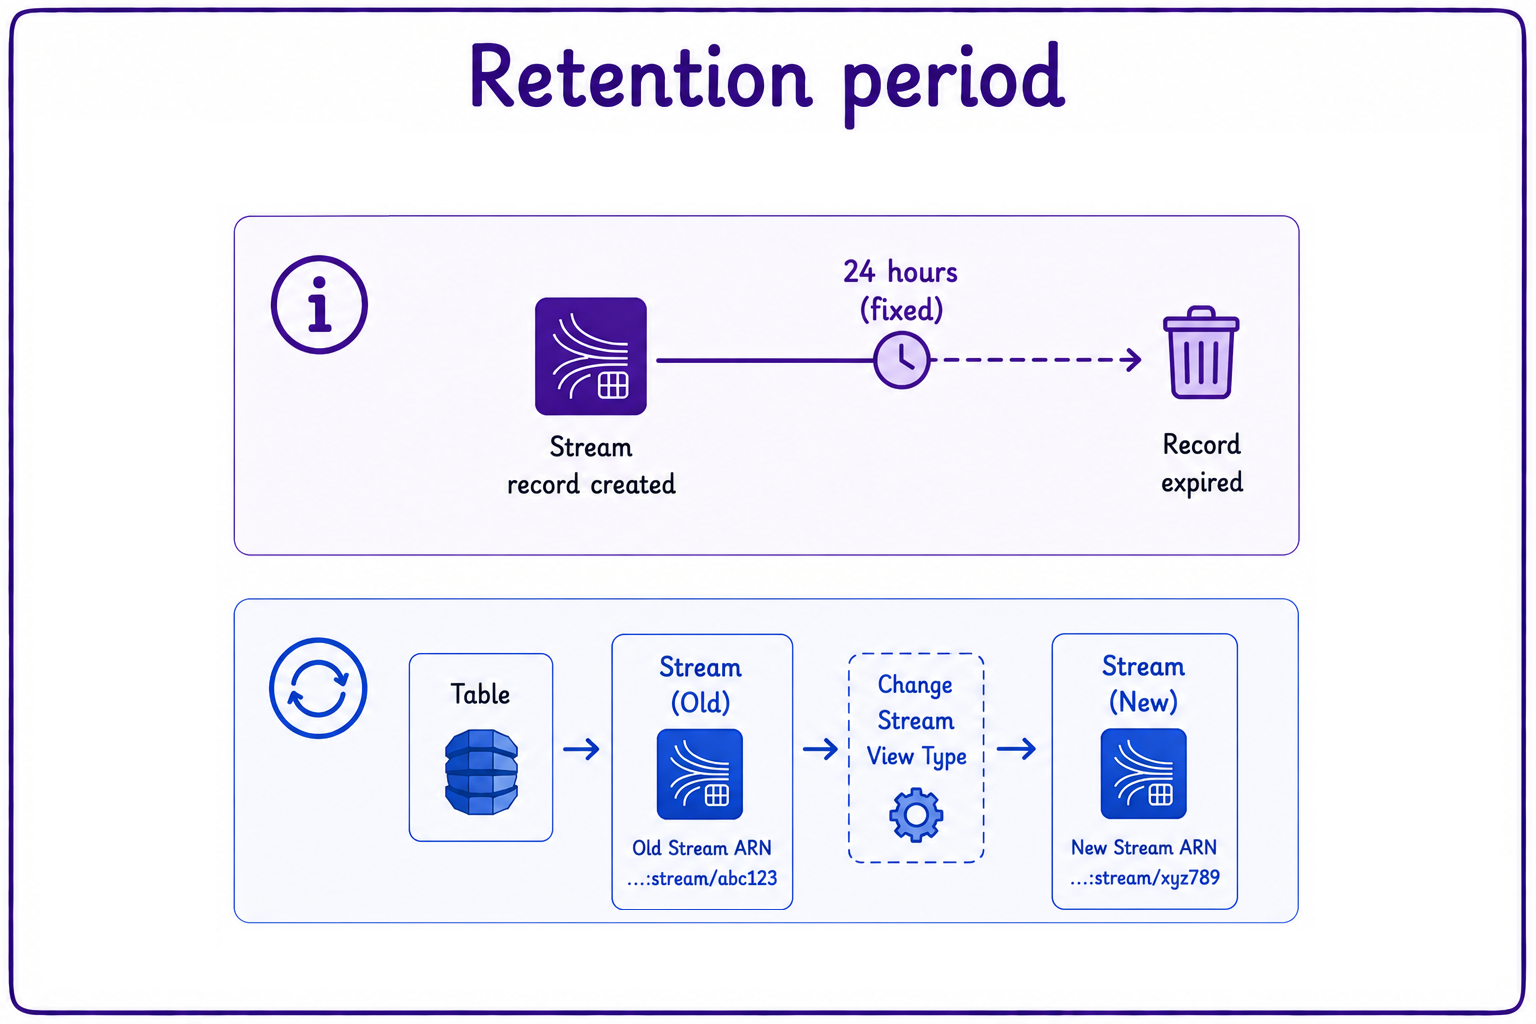
保留期
- 流记录保留 24 小时。
- 更改视图类型需要重新创建流。
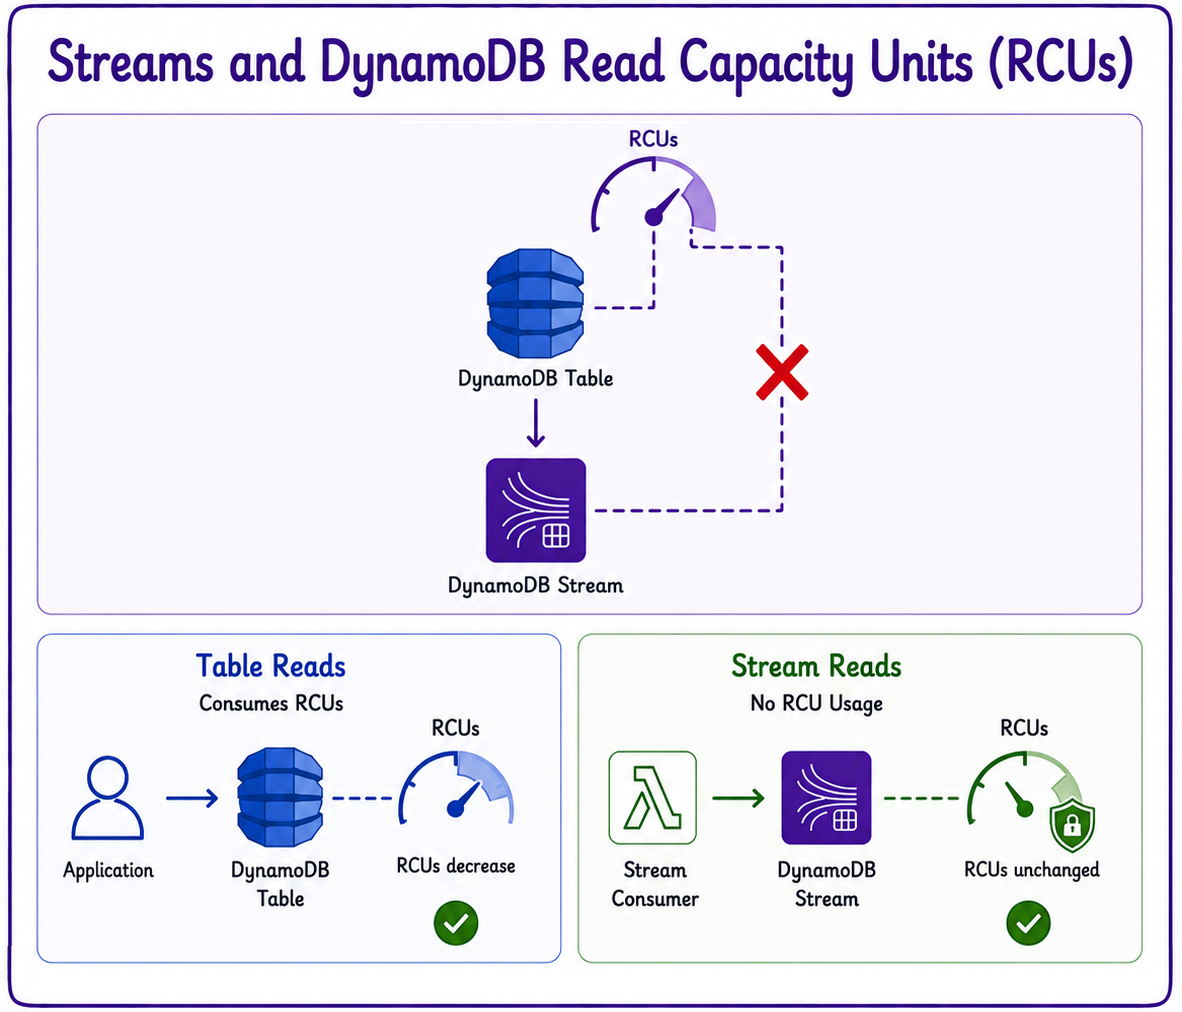
Streams 与 DynamoDB 读取容量单位
- 读取流不会消耗您的读取容量单位(RCU)。
- 启用流不会影响预置吞吐量。
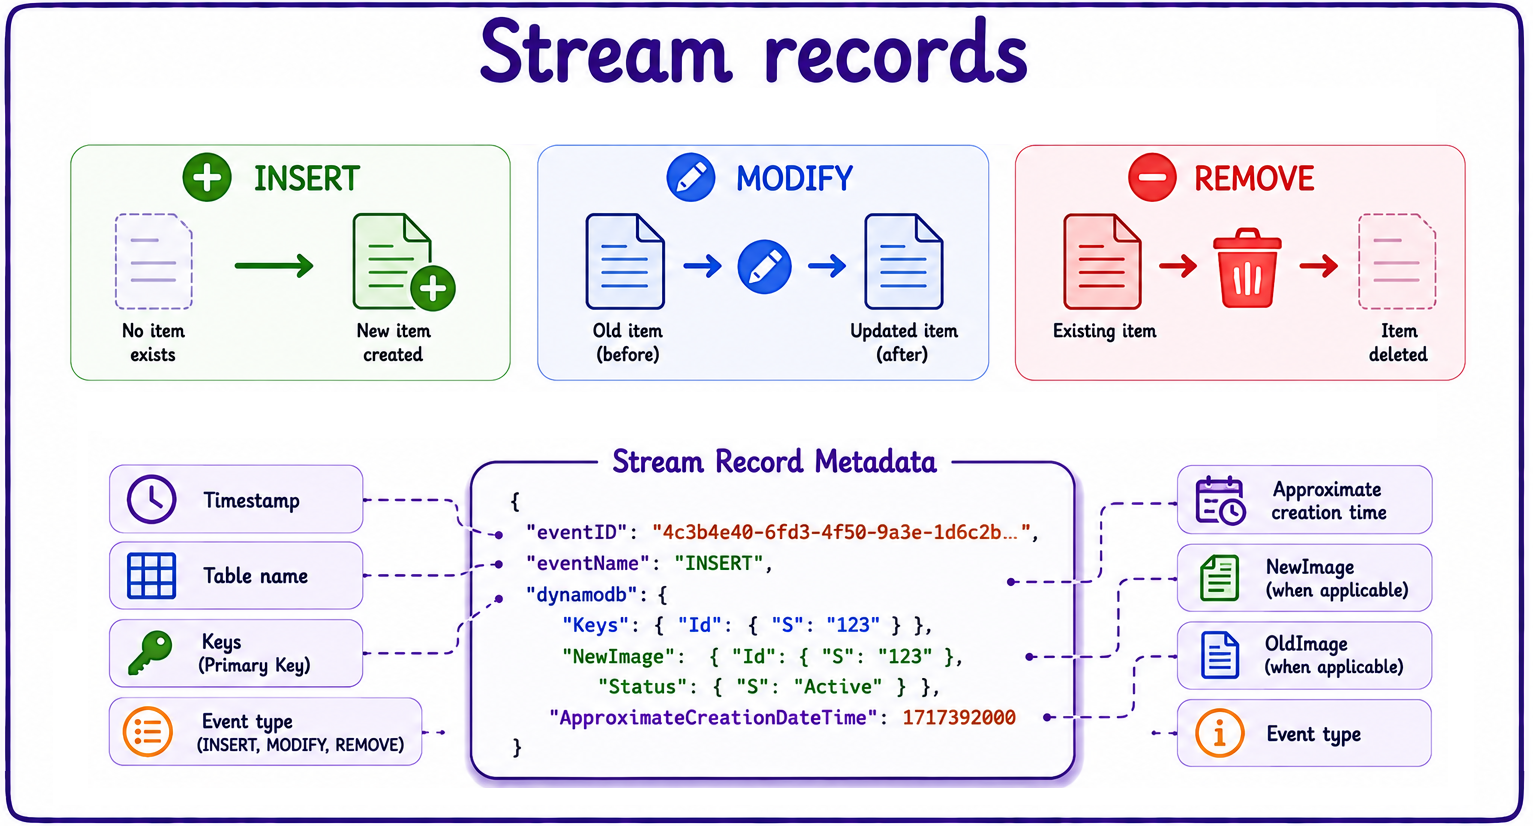
流记录
- 每条流记录都包含描述变更的元数据。
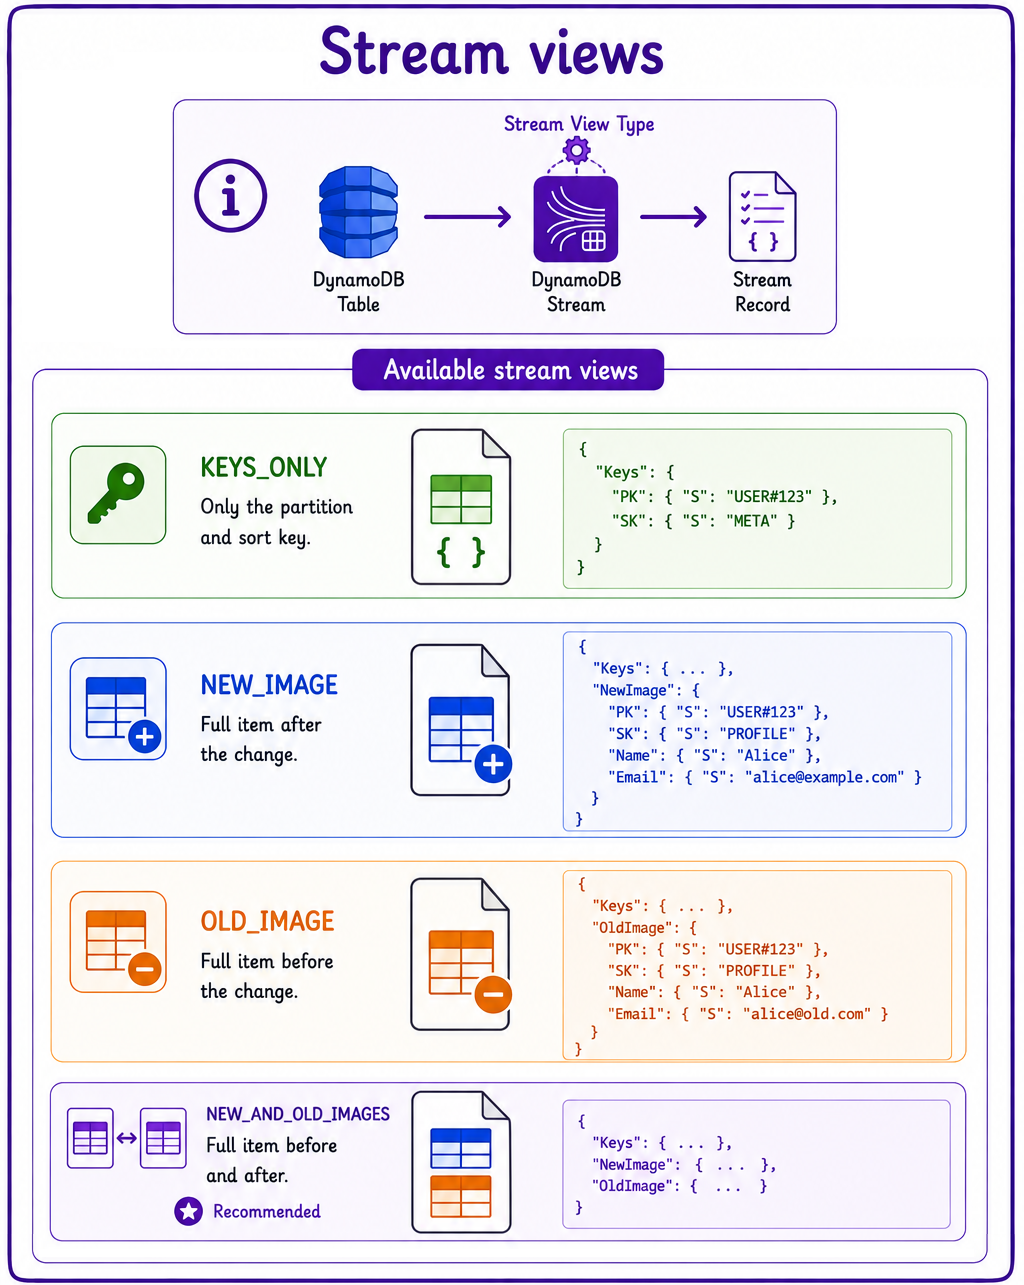
- 流捕获三种事件类型:
- 视图类型决定每条记录包含哪些数据。
KEYS_ONLY:仅分区键和排序键。NEW_IMAGE:变更后的完整项。OLD_IMAGE:变更前的完整项。NEW_AND_OLD_IMAGES:变更前后两版。
- 审计首选
NEW_AND_OLD_IMAGES。
- DynamoDB 全局表必需。
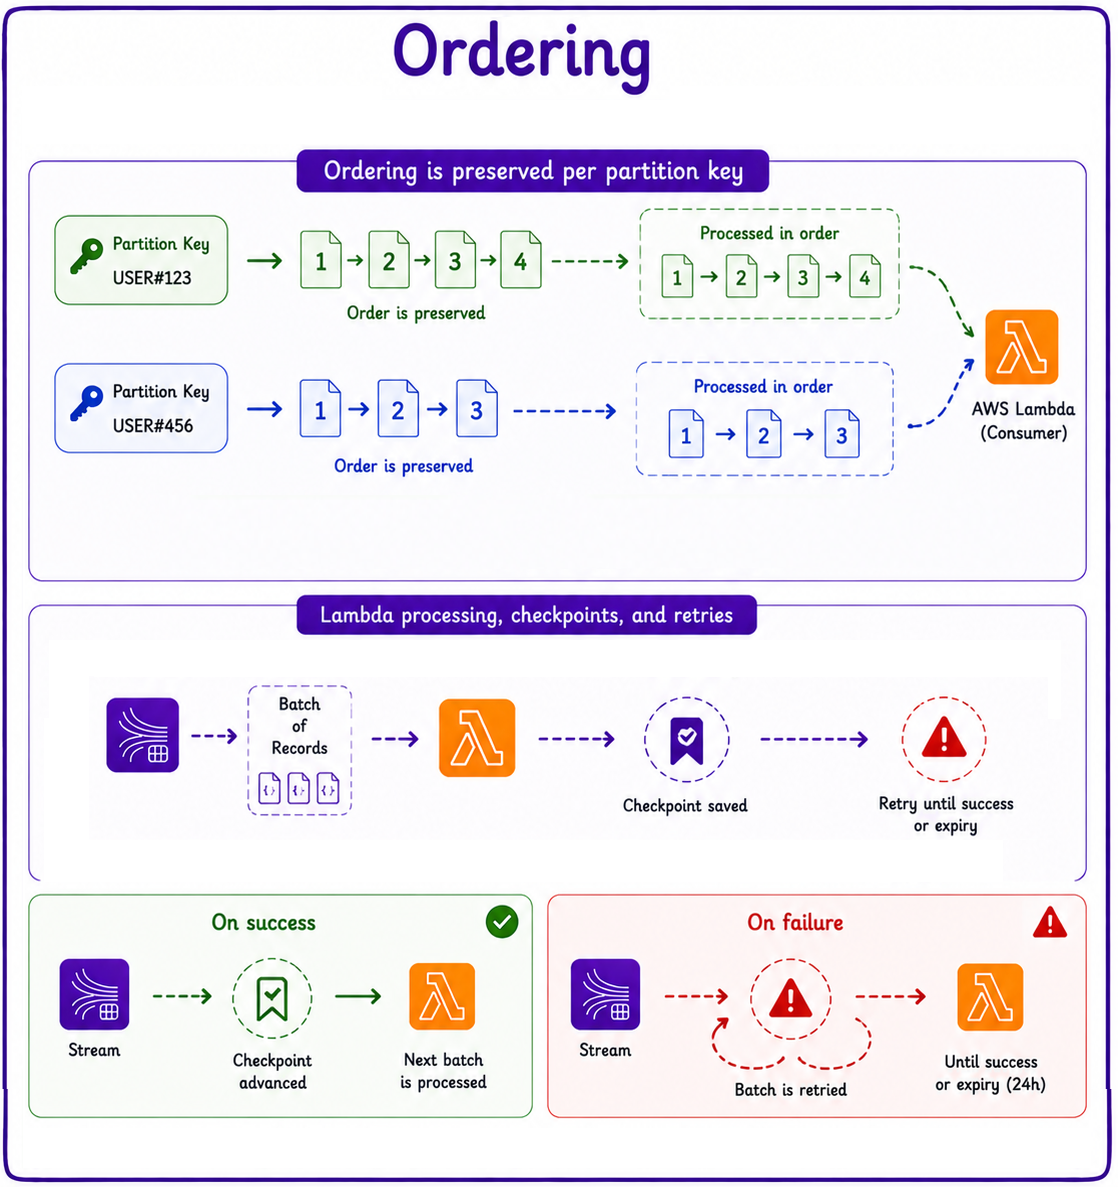
- 按分区键保证顺序。
- Lambda 批量处理记录。
- 每个成功批次后做检查点。
- 失败的批次会重试。
- 直到成功或记录过期为止。
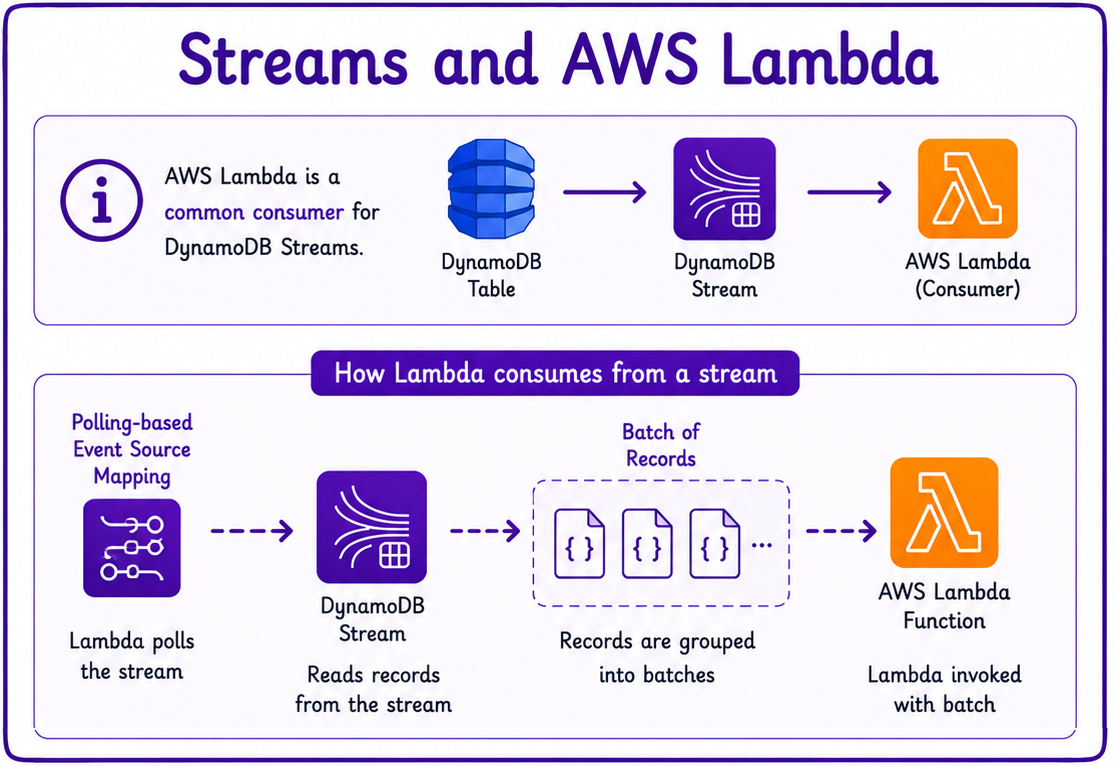
- Lambda 是最常见的流消费者。
- 使用基于轮询的事件源映射。
- 从流中读取记录。
- 批量触发您的函数。
架构模式
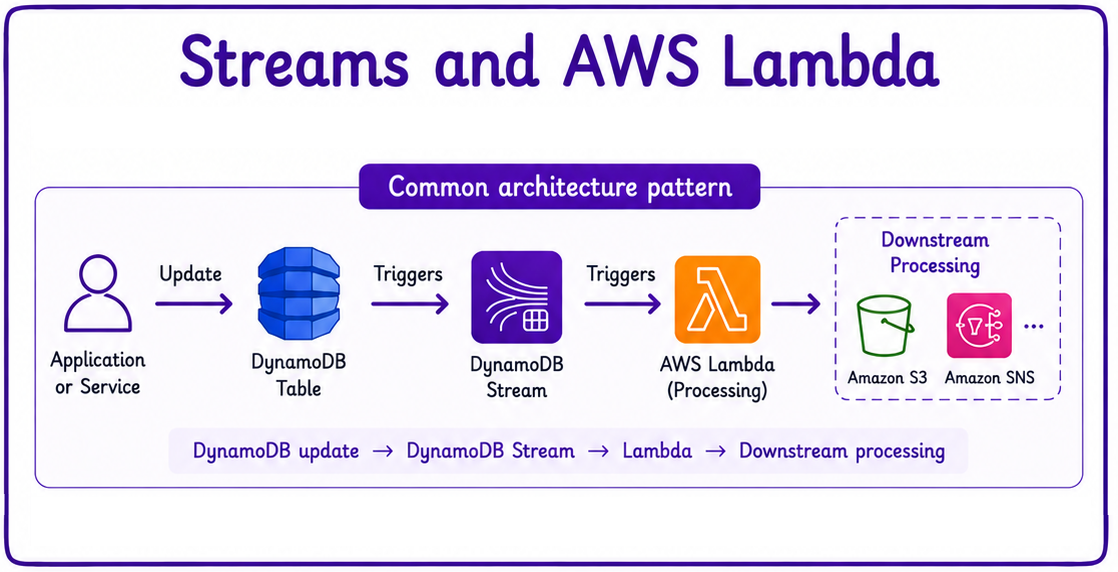
- 常见端到端模式:
- 项更新写入 DynamoDB。
- 变更生成流记录。
- 记录触发 Lambda 处理。
扩展性
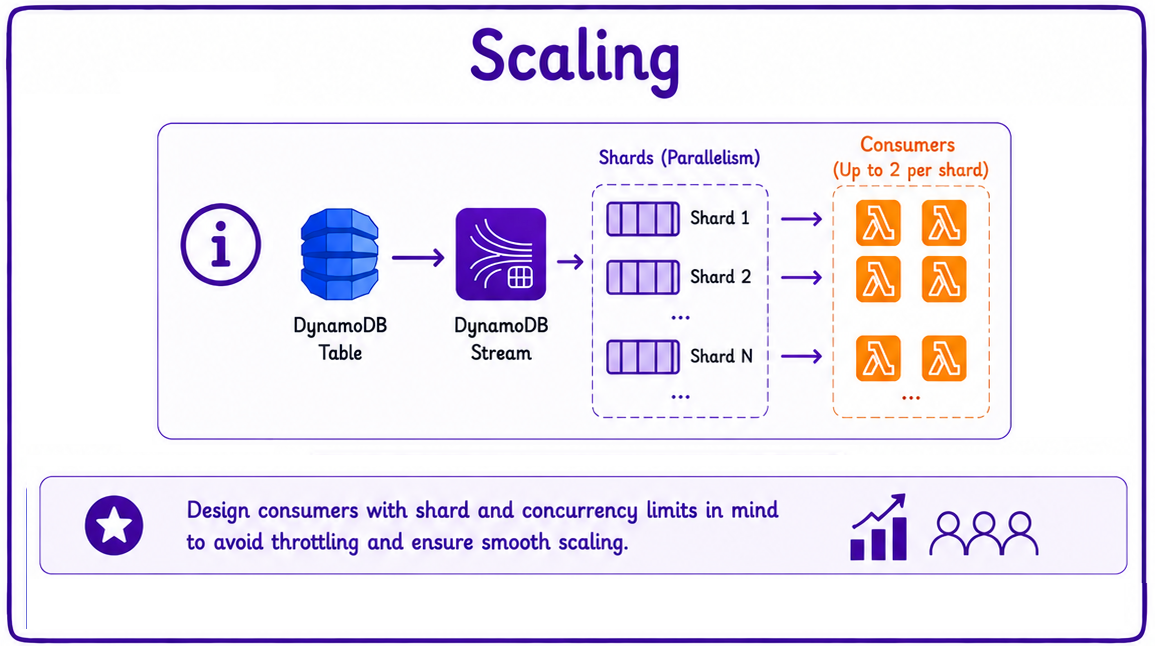
- 流在内部被分片。
- 每个分片最多支持两个并发消费者。
- Lambda 并发度随分片数扩展。
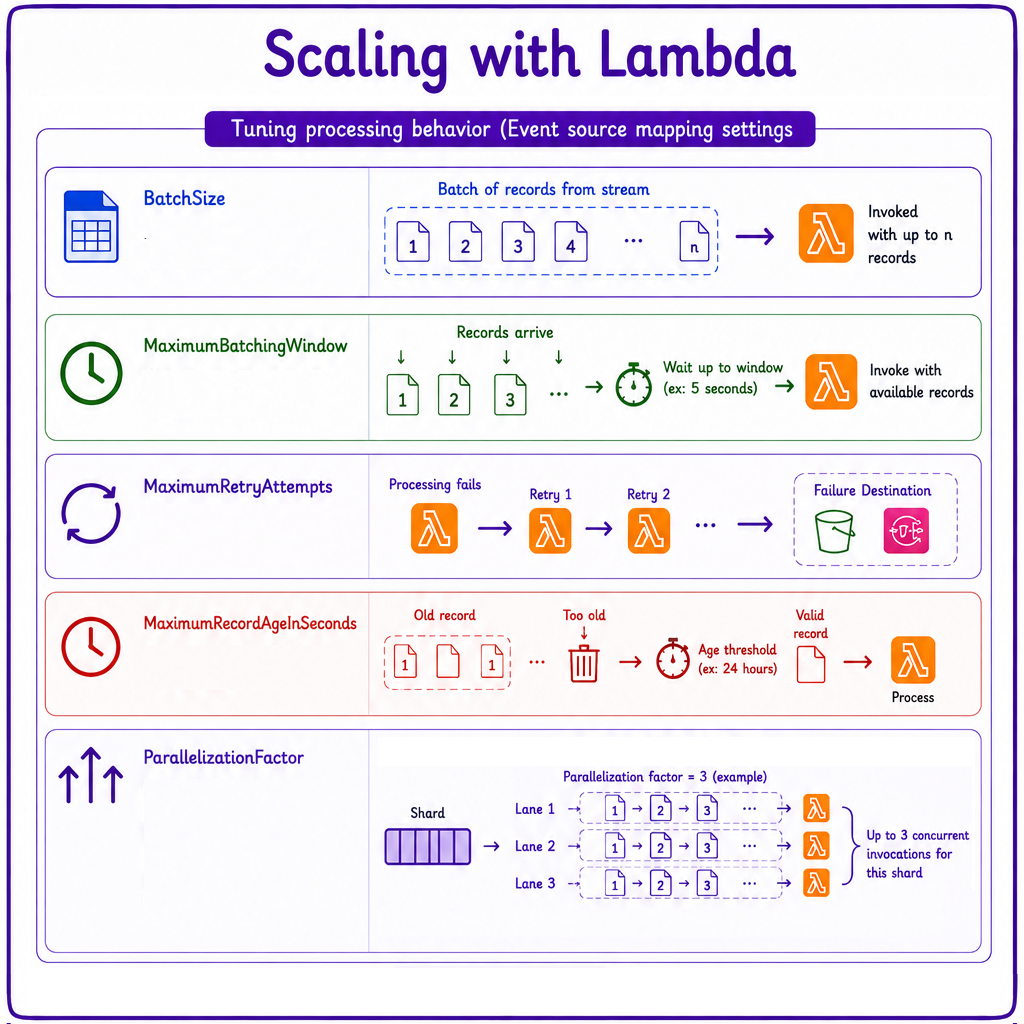
- 可通过以下参数调优处理:
BatchSize:每次调用的最大记录数。MaximumBatchingWindow:为凑满批次的等待时间。MaximumRetryAttempts:失败前的最大重试次数。MaximumRecordAgeInSeconds:丢弃超过此时长的记录。ParallelizationFactor:每分片并行度(最大 10)。
过滤与翻转窗口
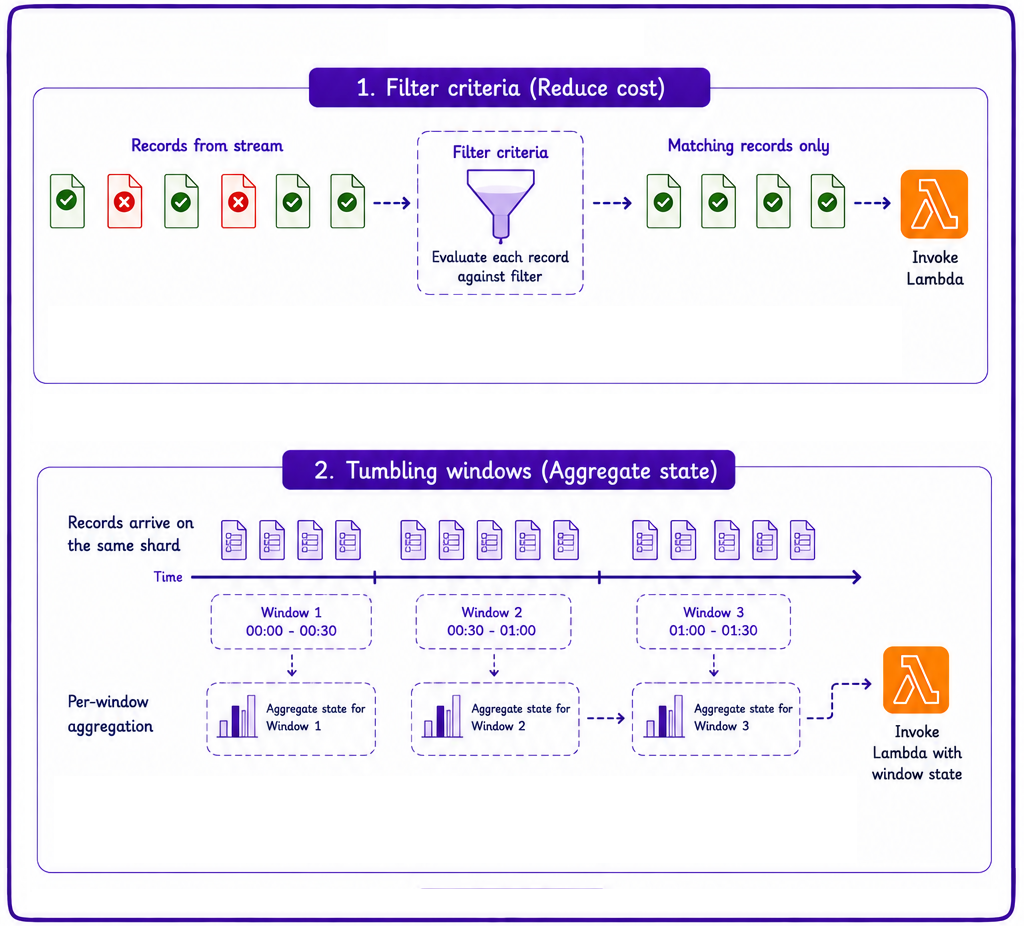
- Lambda 支持过滤条件。
- 在调用函数前丢弃无关记录。
- 减少不必要调用与成本。
- Lambda 支持翻转窗口。
管理重复记录
- 流对每次变更做到恰好一次捕获。
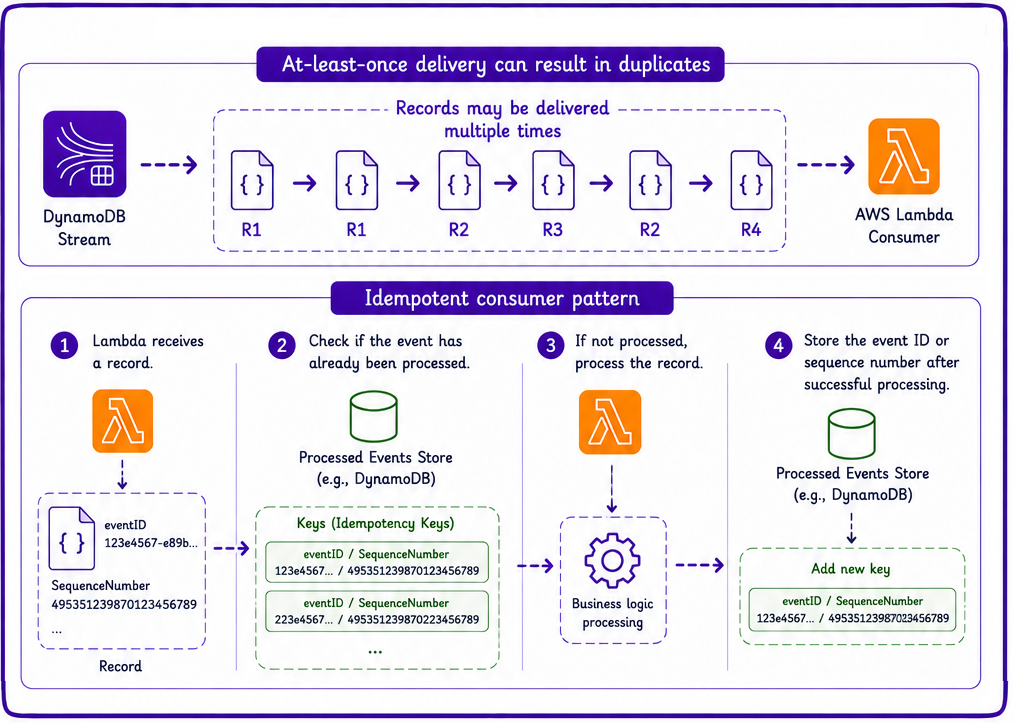
- Lambda 至少一次投递语义处理记录。
- 将消费者设计为幂等。
- 常见做法:存储已处理的
eventID 或 SequenceNumber。
- 跳过已处理的记录。
- 两者在重试中保持稳定。
- 可靠的幂等键。
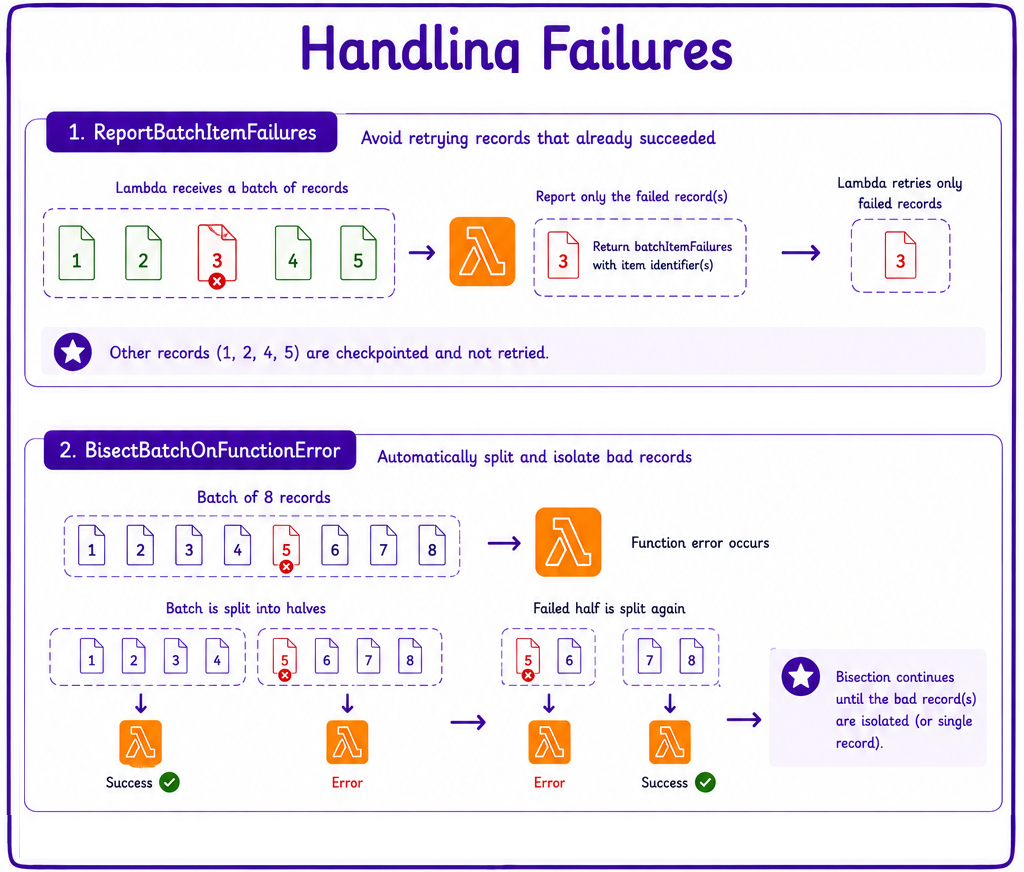
处理失败
ReportBatchItemFailures 仅重试失败的记录。- 处理 Lambda 失败可用:
BisectBatchOnFunctionError 进行批次二分。- 重试控制。
- 对耗尽重试的"毒"批次使用失败目的地。
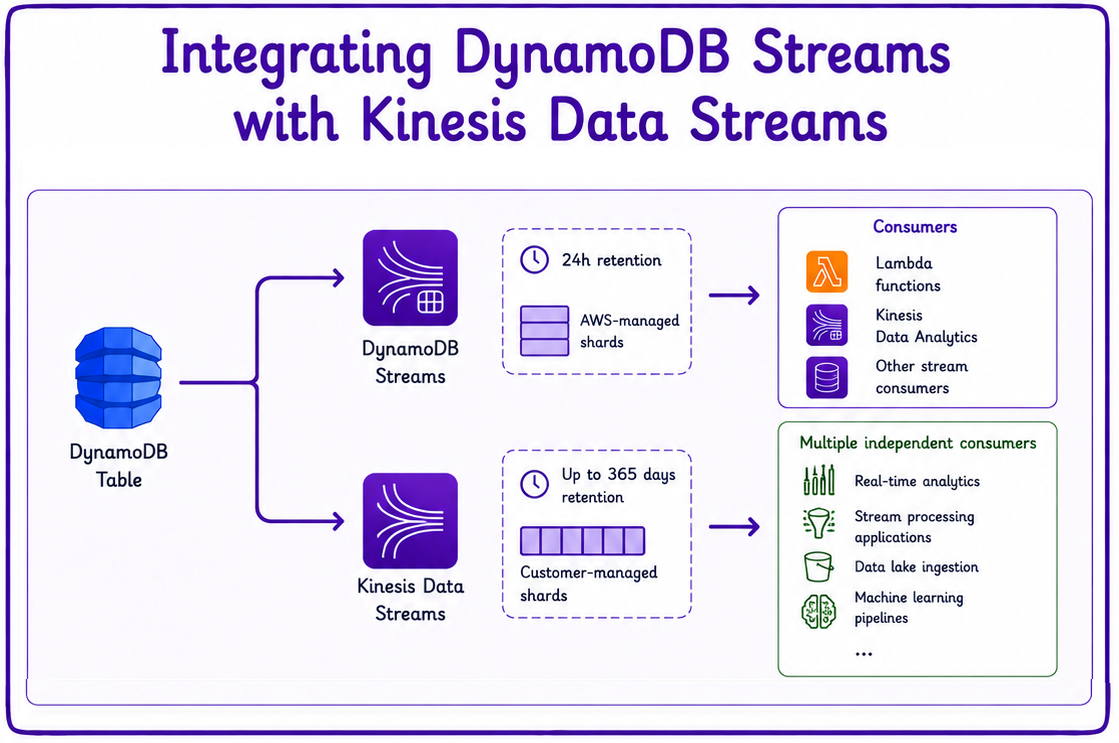
DynamoDB 到 Kinesis 的集成
- 表可将变更直接推送到 Kinesis Data Streams。
- 通过 Kinesis Data Streams for DynamoDB 功能。
- 独立的并行能力,非链式。
- 事件不会经过 DynamoDB Streams。
- 二者可在同一张表上同时运行。
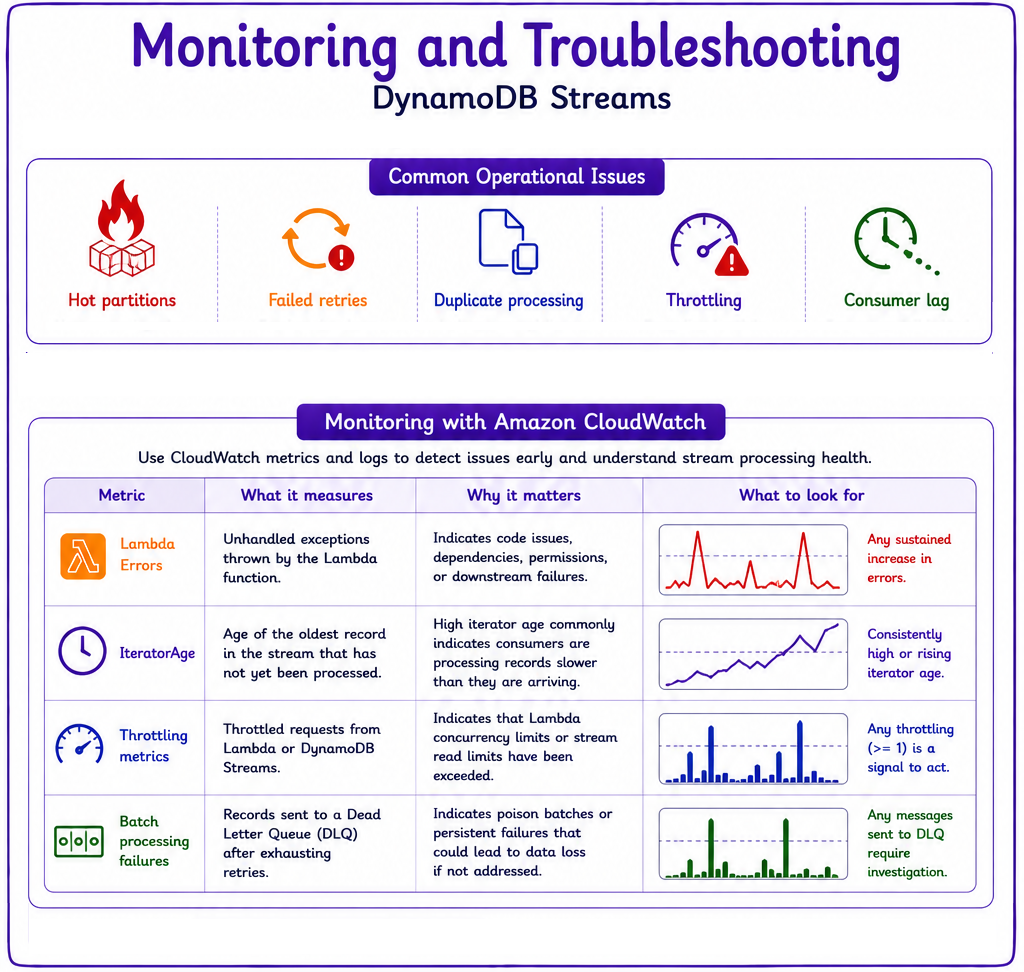
监控:常见问题
- 常见运维关注点:
- 热分区。
- 重试失败。
- 重复处理。
- 限流与消费者滞后。
监控:CloudWatch 指标
- 关键 CloudWatch 指标:
- Lambda Errors:定位代码或下游问题。
- IteratorAge:值高表示消费者缓慢。
- 限流指标:读取超限。
- 批处理失败:记录发送到 DLQ。
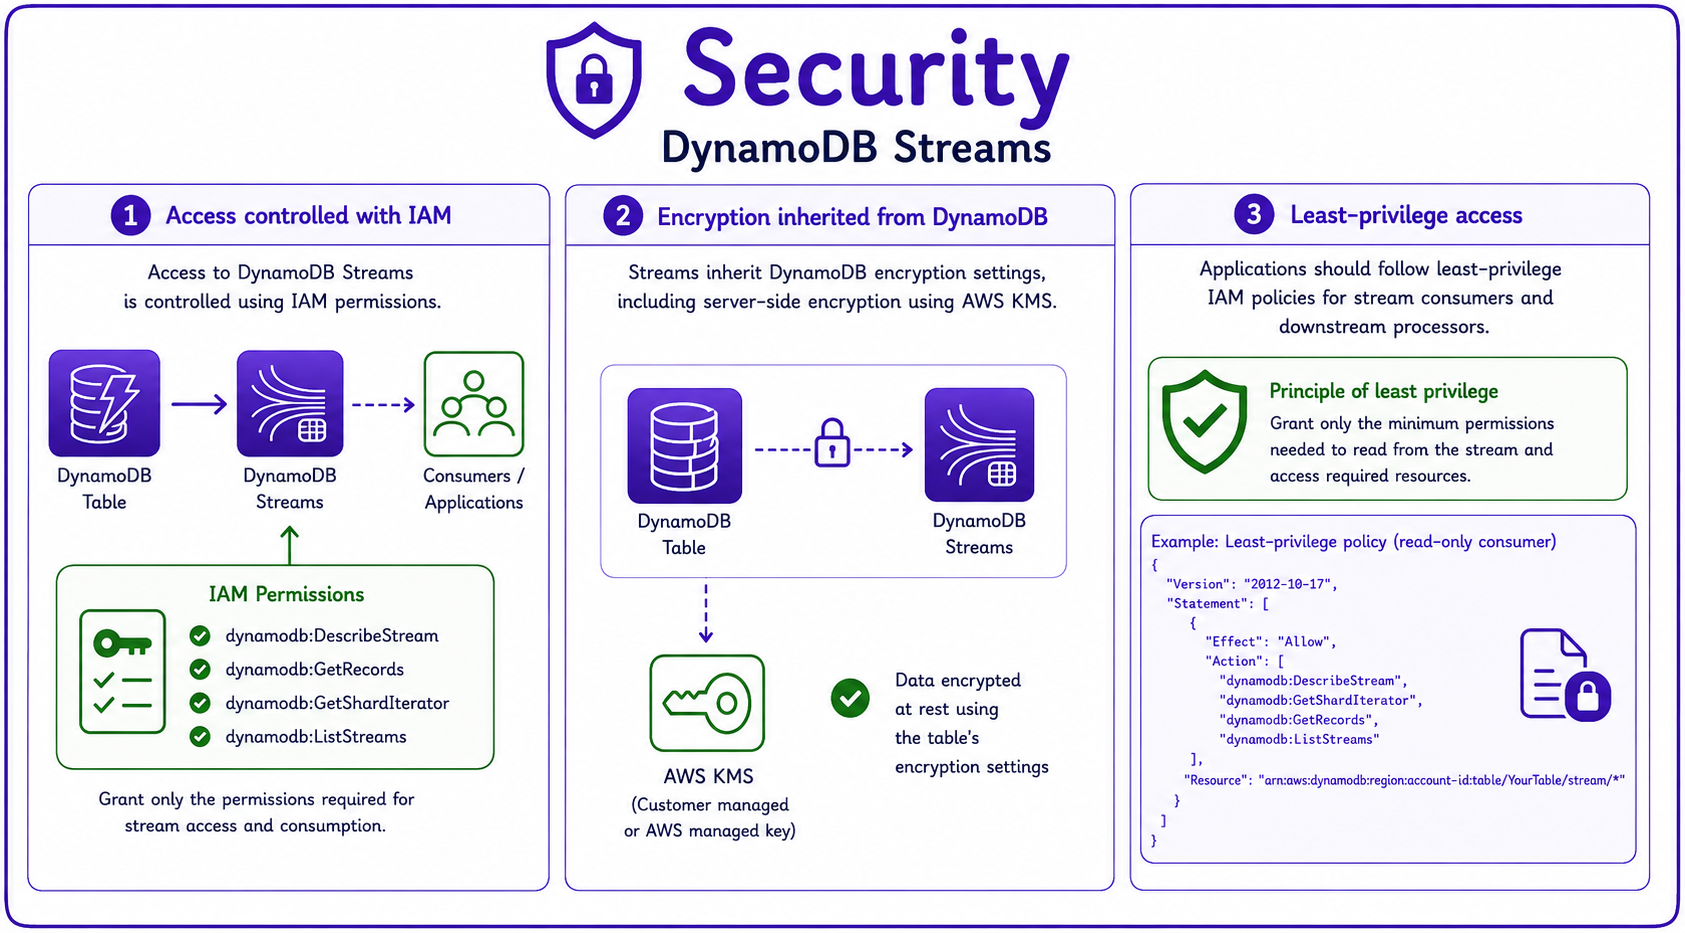
安全
- 访问流由 IAM 权限控制。
- 流继承表的加密设置。
- 对消费者和下游处理器应用最小权限策略。
 Preparing Video For Download...