Samordning av tjänster och tillståndshantering
Utveckla applikationer på AWS
Ricardo Sueiras
Principal Technologist
Tjänstesamordning
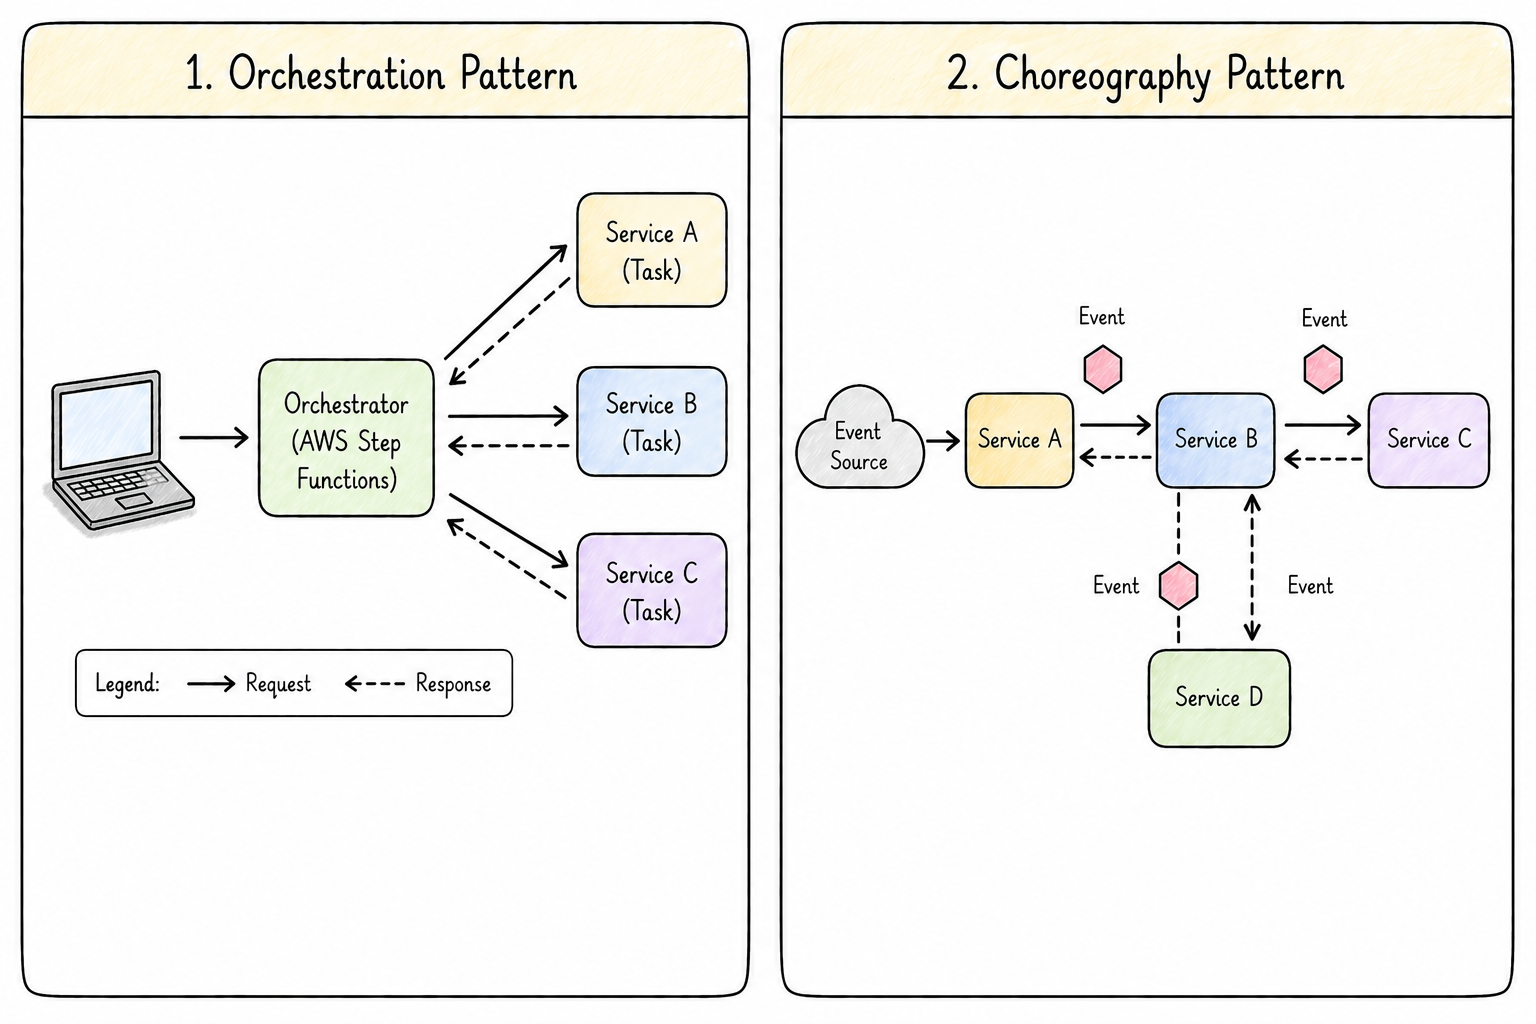
Flera tjänster måste samverka för att slutföra ett arbetsflöde.
De behöver en samordningsstrategi.
Två metoder: orkestrering och koreografi.
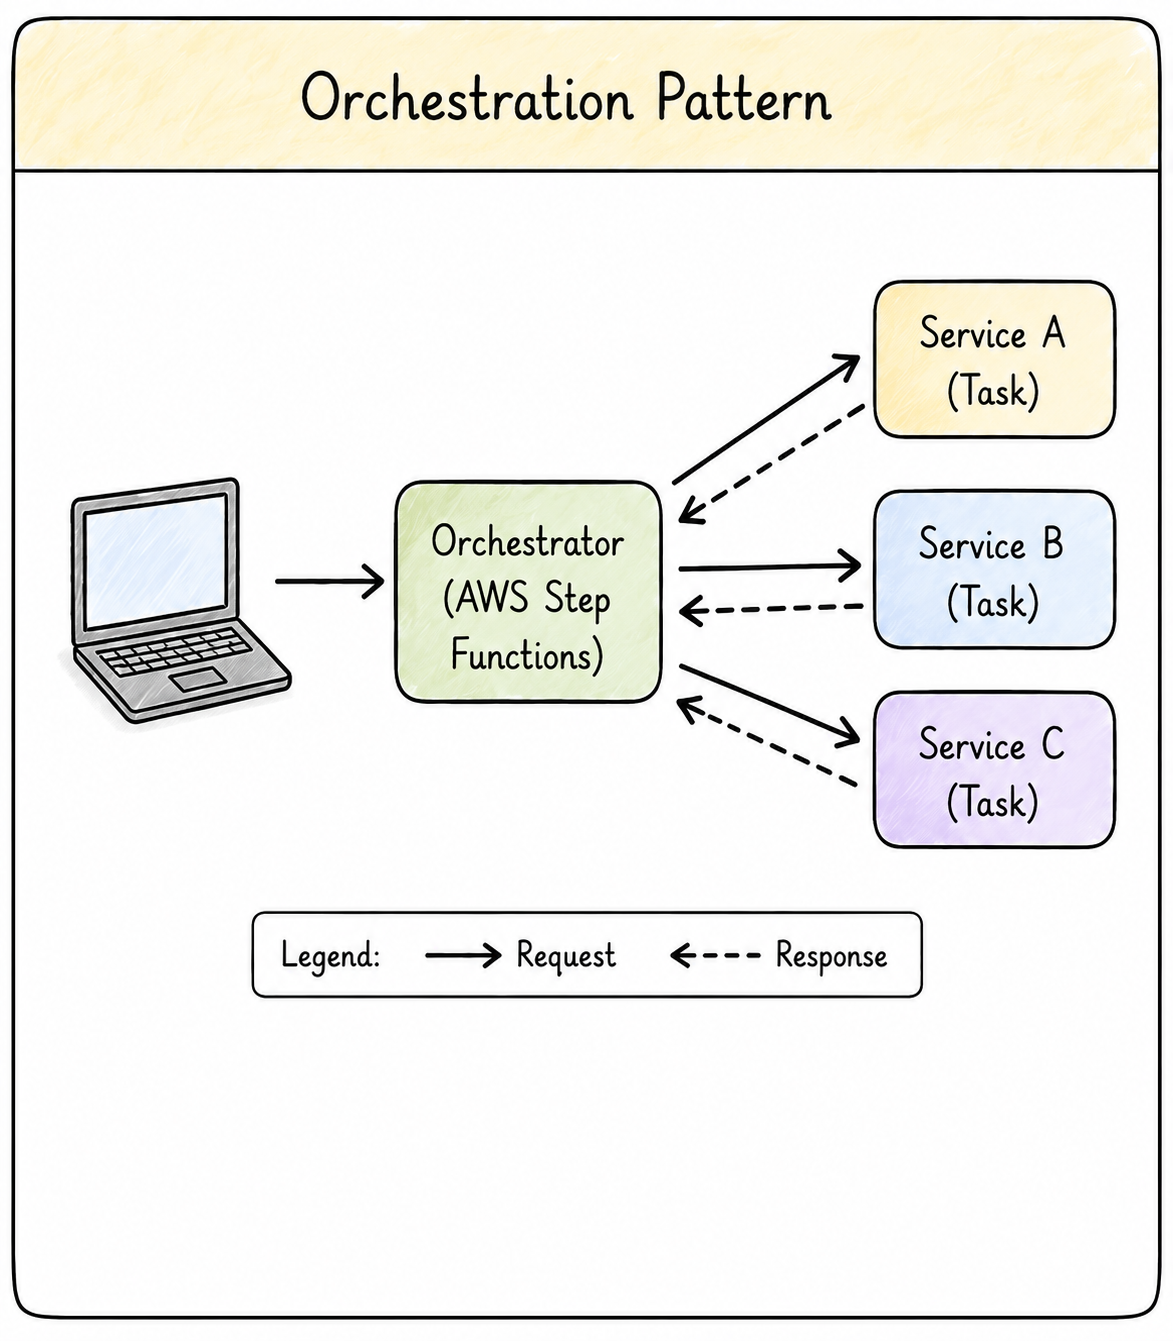
Orkestrering
En central orkestrerare samordnar arbetsflödet.
Orkestreraren styr ordningsföljden och bestämmer vilken tjänst som körs härnäst.
Användbart för återförsök, villkorsstyrd logik och felhantering.
På AWS: implementeras med Step Functions över Lambda, ECS och DynamoDB.
Orkestrering
Arbetsflödeslogiken finns på ett ställe, vilket förenklar felsökning och övervakning.
Avvägning: introducerar ett centralt beroende.
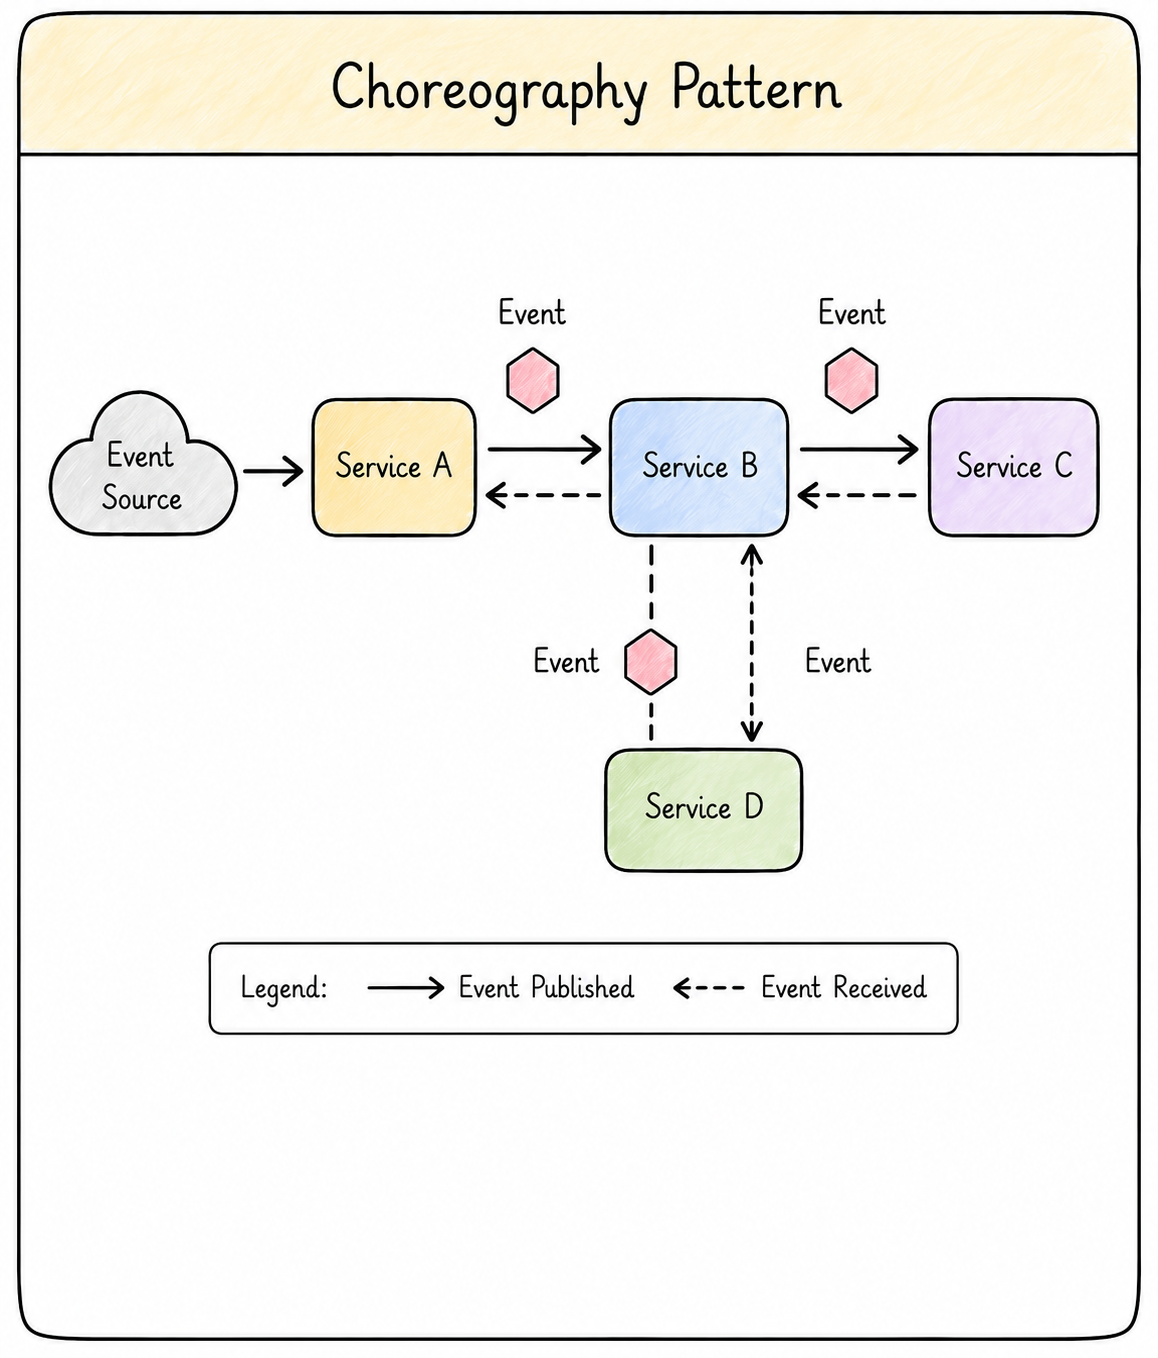
Koreografi
Ingen central kontroller.
Tjänster reagerar på händelser självständigt.
Varje tjänst lyssnar på relevanta händelser och utför sitt arbete.
Ingen tjänst behöver känna till hela arbetsflödet.
Förbättrar lös koppling och skalbarhet.
Koreografi
På AWS: EventBridge, SNS, SQS.
Hög skalbarhet.
Avvägning: svårare att förstå och felsöka när arbetsflödena växer.
Händelsestyrd arkitektur
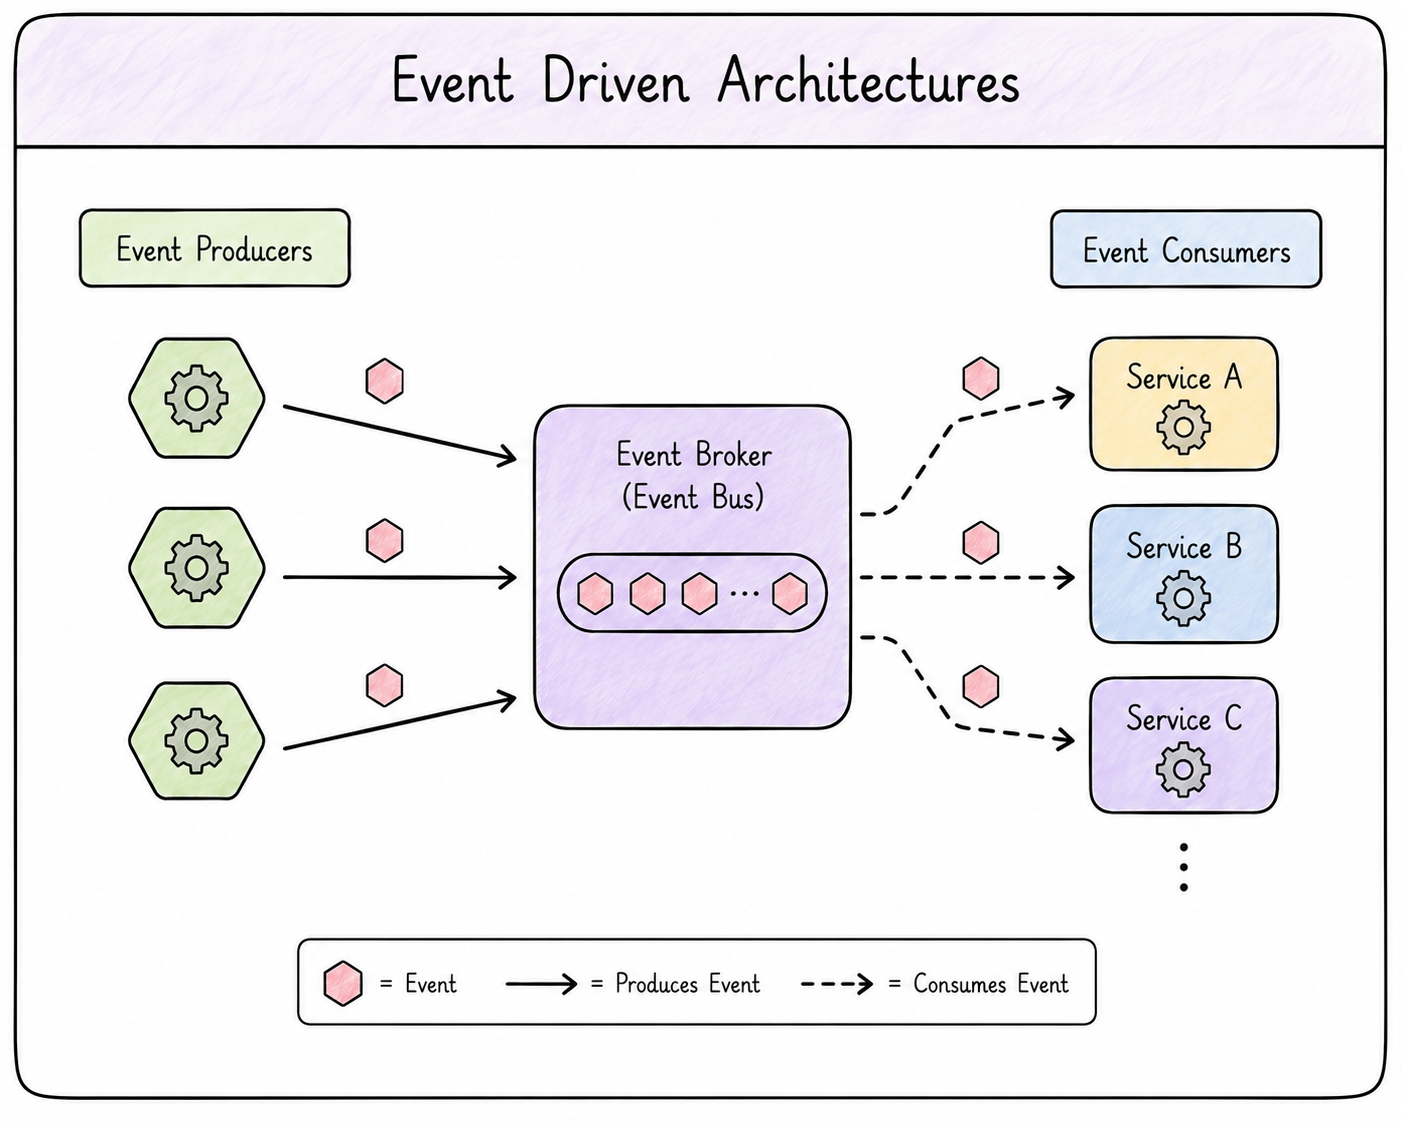
Tjänster kommunicerar genom att producera och konsumera händelser.
Främjar lös koppling mellan tjänster.
Främjar hög skalbarhet.
Möjliggör parallell bearbetning av händelser.
Nya tjänster kan prenumerera utan att befintliga ändras.
Händelsestyrd arkitektur
Avvägningar vid implementering av EDA:
Designa för slutlig konsistens.
Implementera idempotens.
Felhantering är mer komplex.
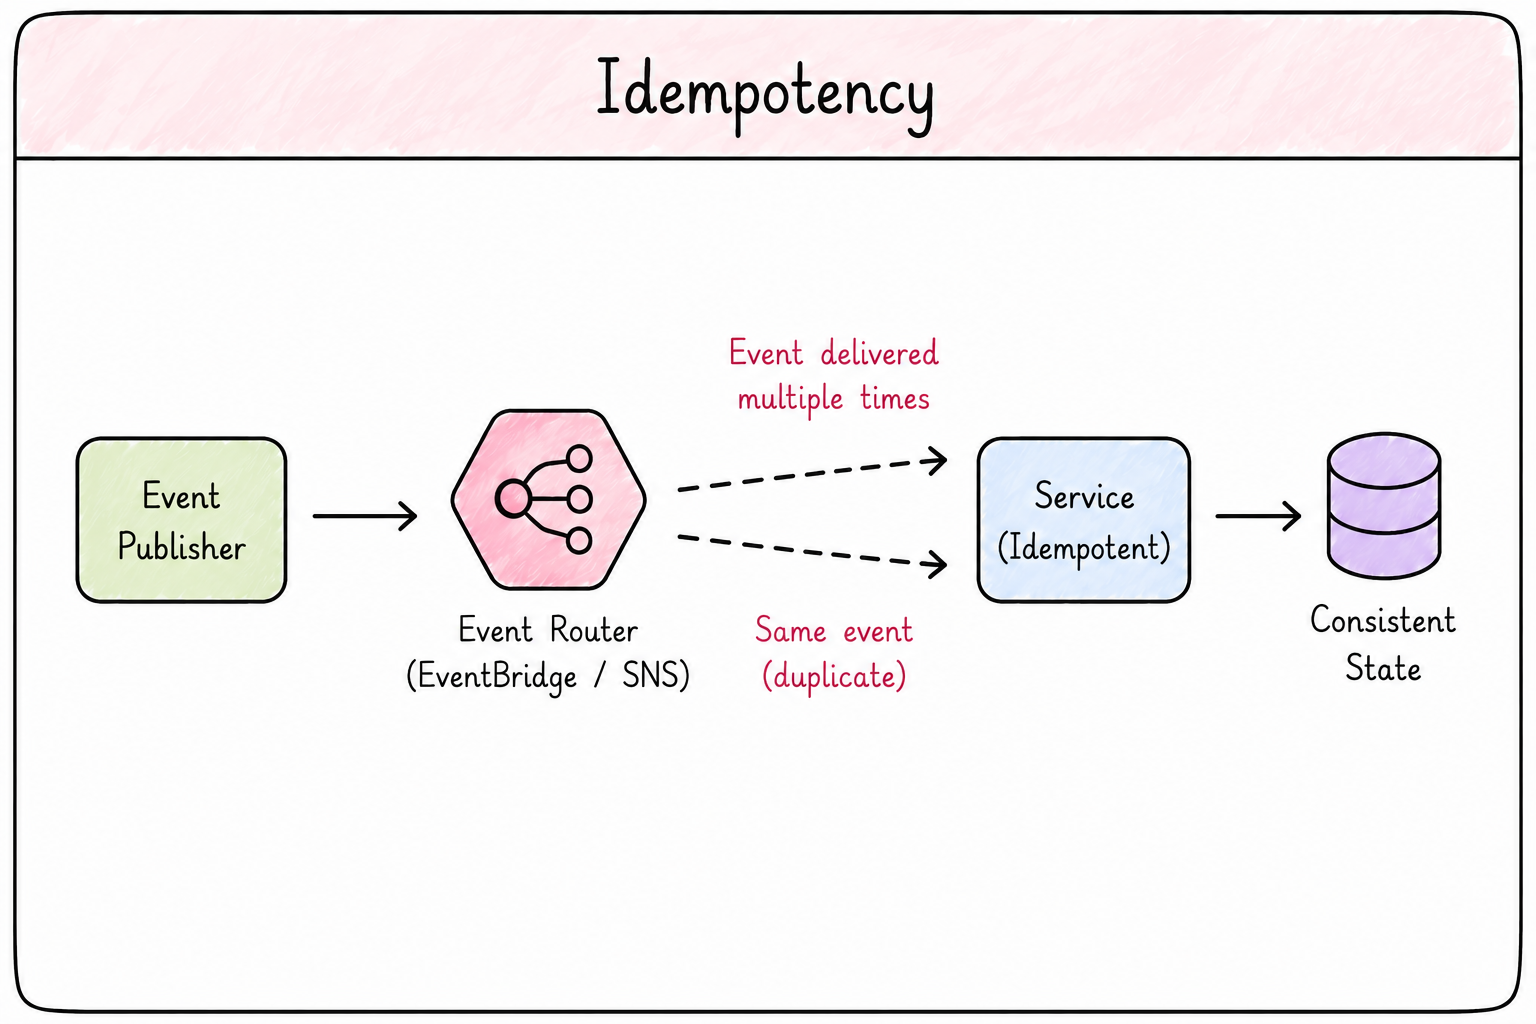
Idempotens
Samma operation ger samma resultat oavsett hur många gånger den körs.
Grundläggande designprincip i asynkrona och händelsestyrda system.
Distribuerade system kan leverera duplicerade händelser (återförsök, nätverksfel, ombearbetning).
Bevarar systemets korrekthet och tillförlitlighet.
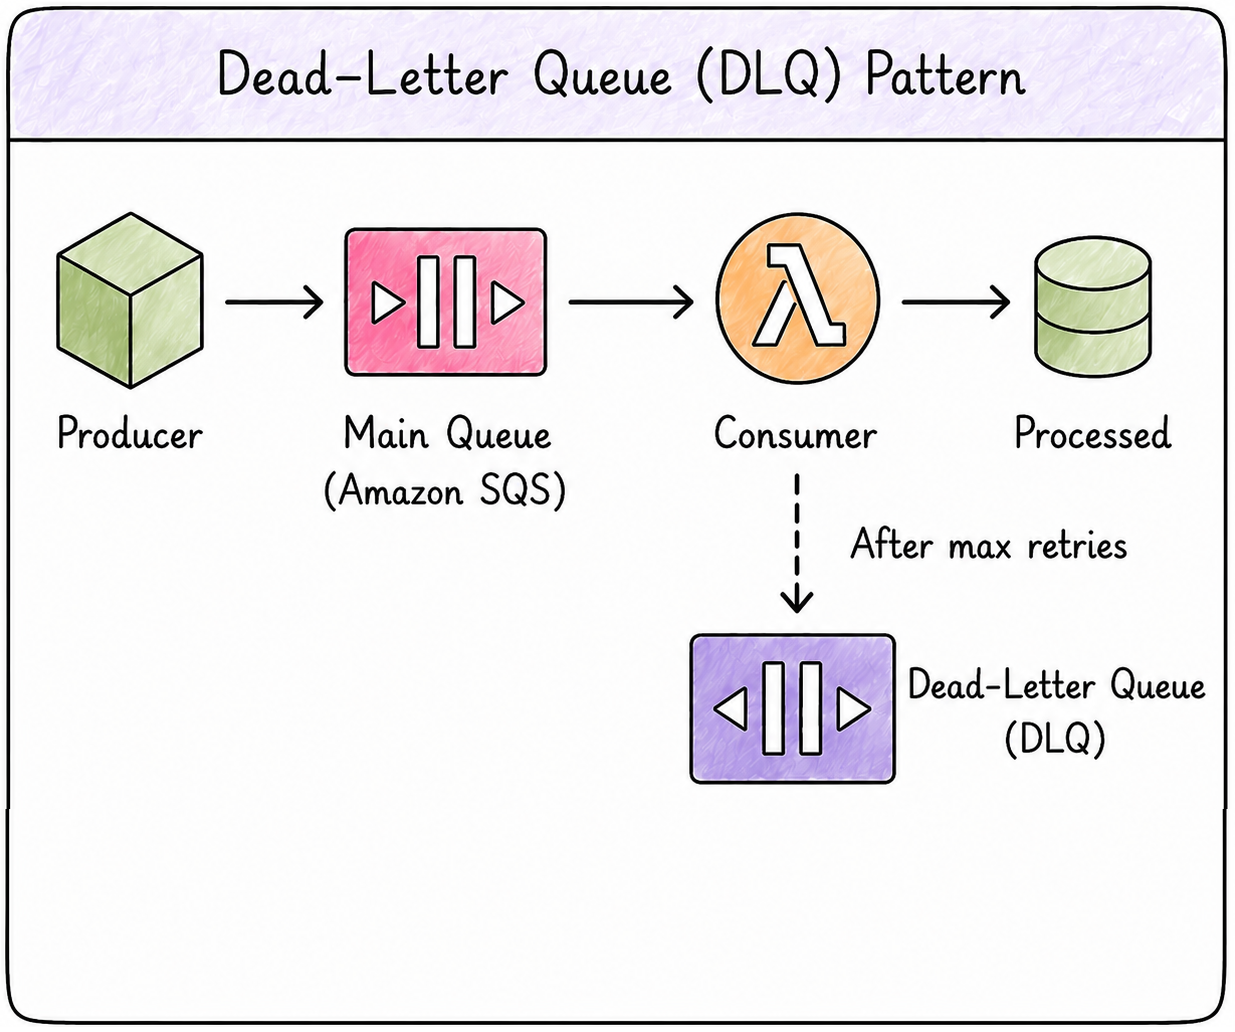
Dead letter queues
Hanterar fel i asynkron kommunikation.
Isolerar problematiska "gift"-meddelanden.
Efter upprepade misslyckade återförsök flyttas meddelandet till DLQ.
Huvudflödet fortsätter att köra.
Dead letter queues
Använd när meddelandeordning inte är kritisk.
Hoppa över för icke-kritiska system där tillfällig dataförlust är acceptabel.
Undvik när meddelandeordning måste bevaras.
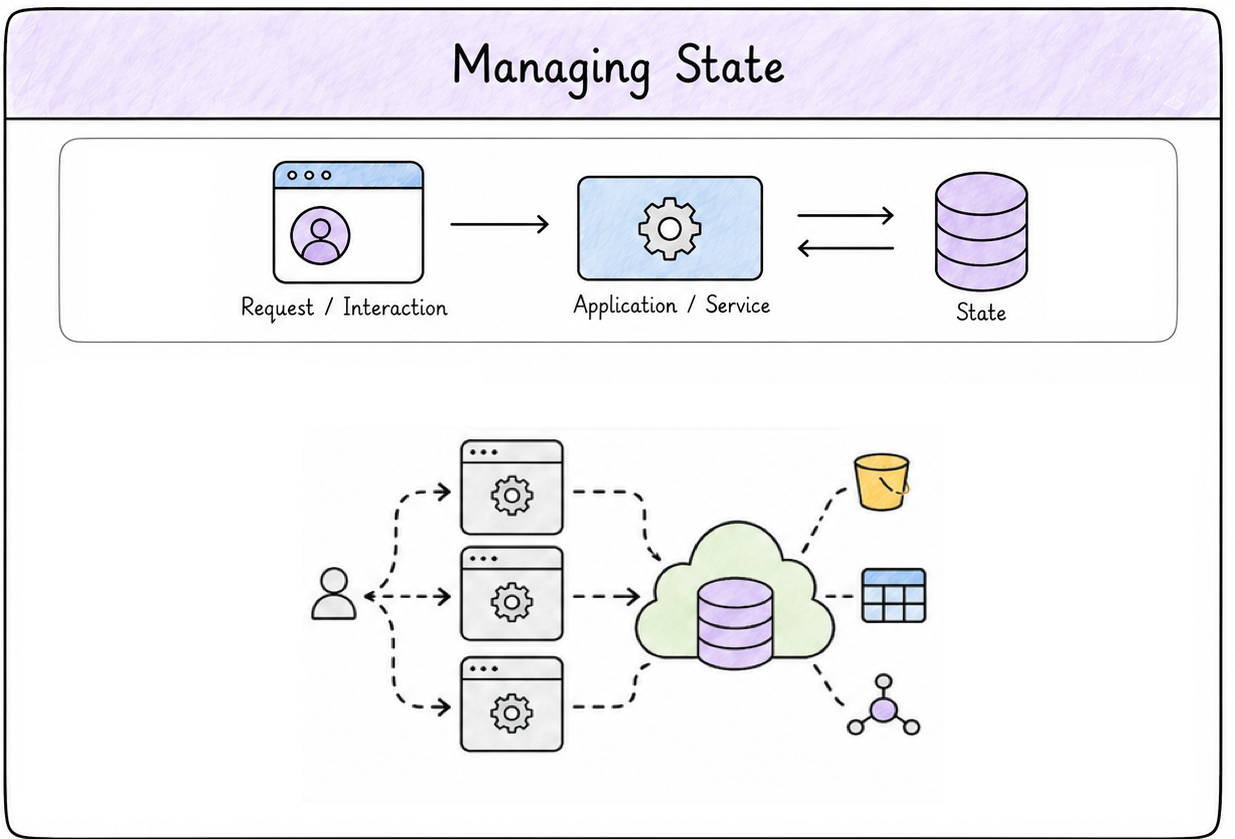
Tillståndshantering
Tillståndshantering är grundläggande i molnbaserade appar.
Tillstånd är all data som bevaras mellan interaktioner.
Att lagra tillstånd lokalt på servern begränsar skalbarhet och motståndskraft.
Tillståndshantering
Tillståndshantering innebär avvägningar beroende på vad du bygger.
Externt tillstånd förbättrar skalbarhet och motståndskraft.
Kostnader: ökad latens och komplexitet.
Att tänka på: konsistens, cachelagring och dataaccessmönster.
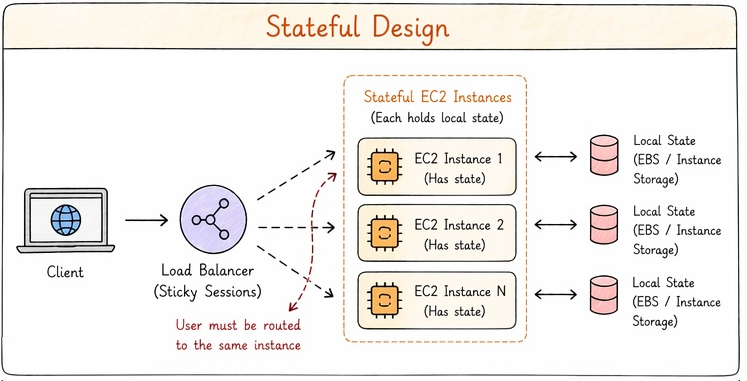
Tillståndsfull
Sessionsdata lagras på servern.
Förfrågningar måste dirigeras till
samma
instans (klibbiga sessioner).
Begränsar skalningsflexibiliteten.
Om instansen kraschar försvinner sessionen.
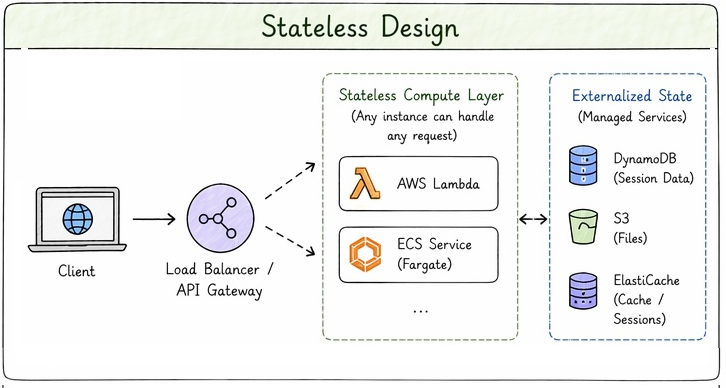
Tillståndslös
Varje förfrågan behandlas oberoende.
Inget tillstånd lagras på servern.
Tillstånd finns i externa system.
Föredragen metod för molnbaserade appar.
Alla instanser kan hantera alla förfrågningar, vilket gör horisontell skalning enkel.
Nu kör vi en övning!
Utveckla applikationer på AWS
Preparing Video For Download...