Koordynacja usług i zarządzanie stanem
Tworzenie aplikacji na AWS
Ricardo Sueiras
Principal Technologist
Koordynacja usług
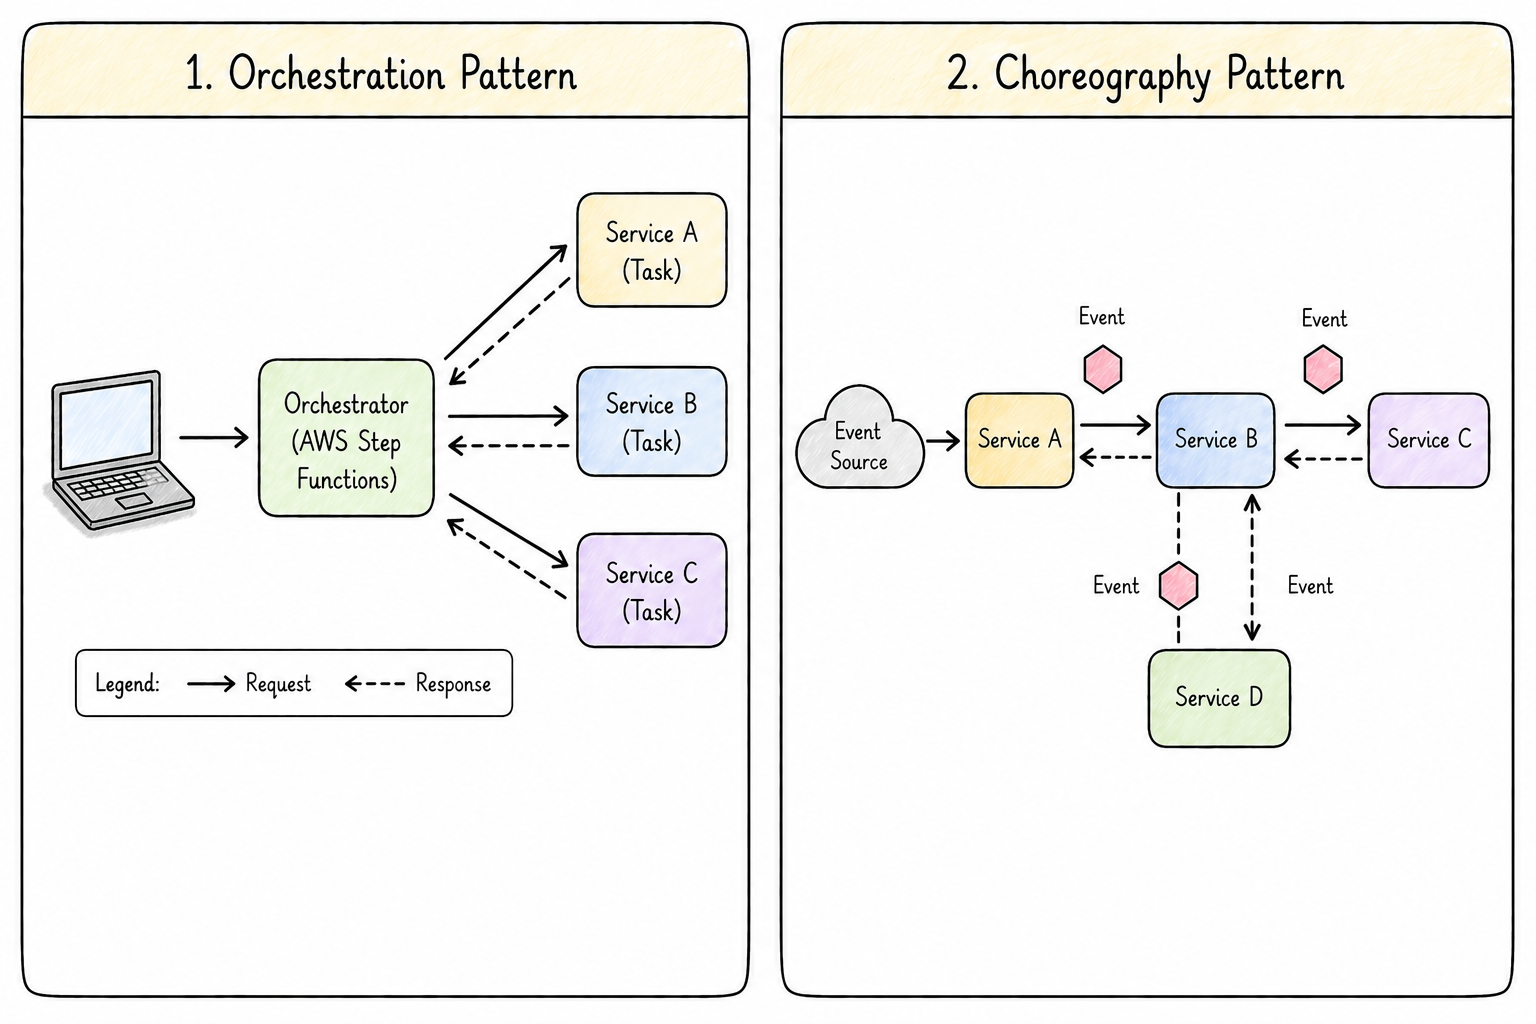
Wiele usług musi ze sobą współpracować, aby ukończyć przepływ pracy.
Potrzebują strategii koordynacji.
Dwa podejścia: orchestracja i choreografia.
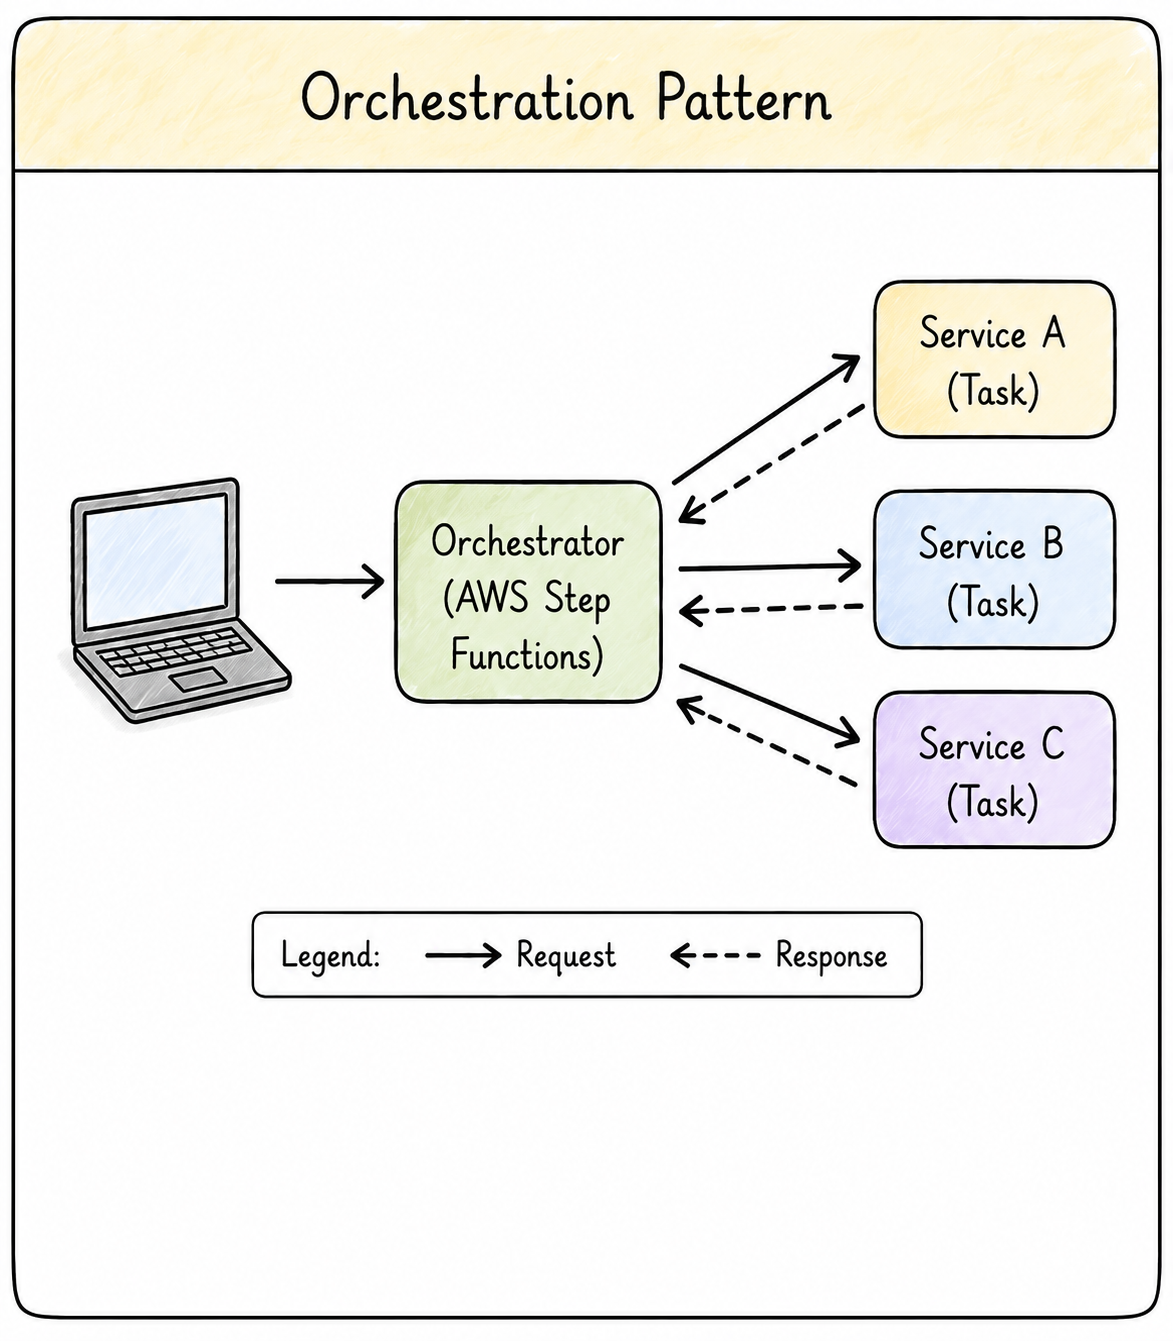
Orchestracja
Centralny orkiestrator koordynuje przepływ pracy.
Kontroluje kolejność i decyduje, która usługa uruchomi się następna.
Przydatny przy ponownych próbach, logice warunkowej i obsłudze błędów.
Na AWS: realizowany przez Step Functions — Lambda, ECS, DynamoDB.
Orchestracja
Logika przepływu jest w jednym miejscu, co ułatwia debugowanie i monitoring.
Kompromis: wprowadza centralną zależność.
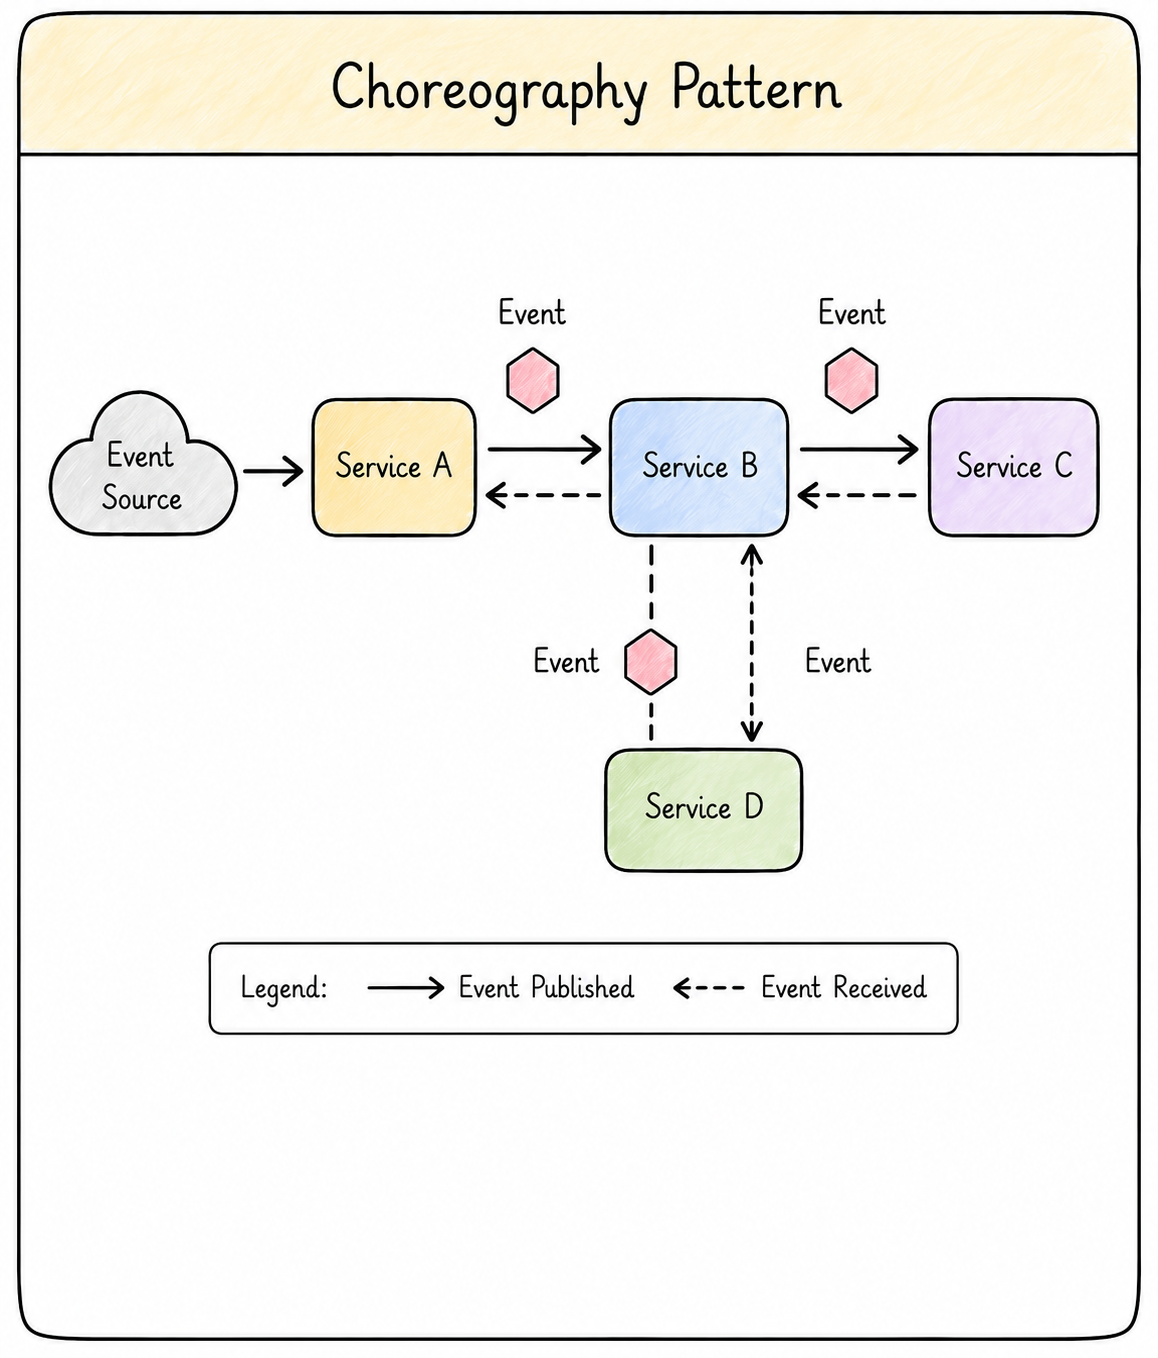
Choreografia
Brak centralnego kontrolera.
Usługi reagują na zdarzenia niezależnie.
Każda usługa nasłuchuje odpowiednich zdarzeń i wykonuje swoje zadanie.
Żadna usługa nie musi znać całego przepływu pracy.
Poprawia luźne powiązania i skalowalność.
Choreografia
Na AWS: EventBridge, SNS, SQS.
Wysoka skalowalność.
Kompromis: trudniejsza do zrozumienia i debugowania w miarę rozrastania się przepływów.
Architektura sterowana zdarzeniami
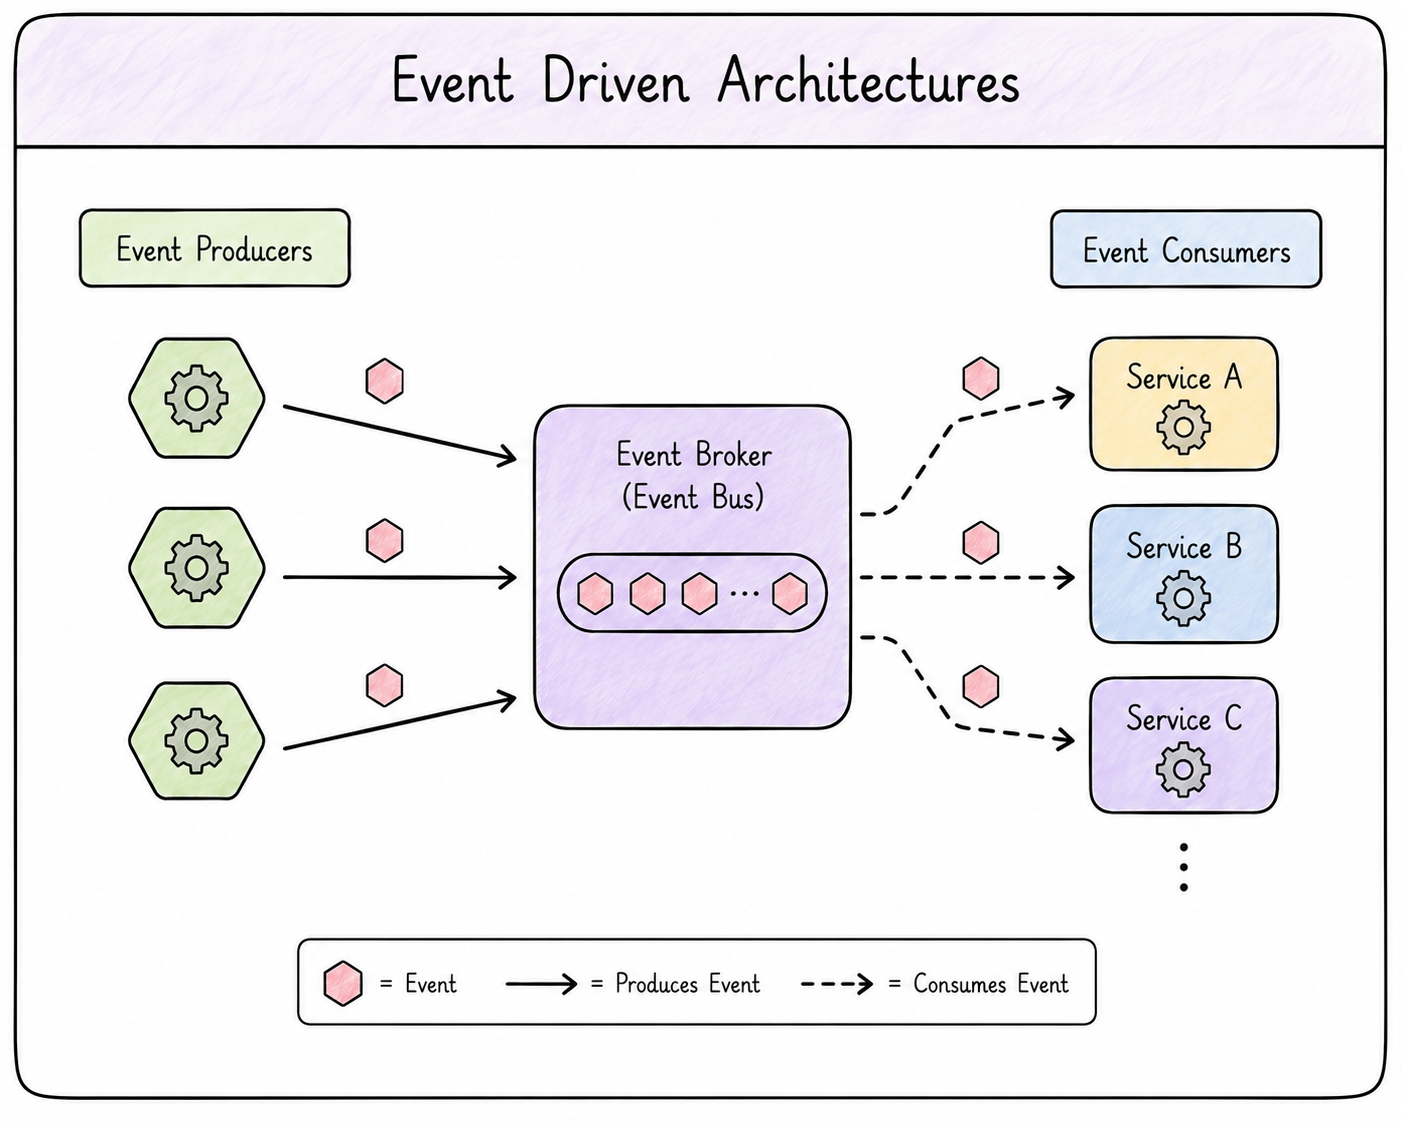
Usługi komunikują się, produkując i konsumując zdarzenia.
Sprzyja luźnemu powiązaniu między usługami.
Zapewnia wysoką skalowalność.
Umożliwia równoległe przetwarzanie zdarzeń.
Nowe usługi mogą się subskrybować bez modyfikowania istniejących.
Architektura sterowana zdarzeniami
Kompromisy przy wdrażaniu EDA:
Projektuj z myślą o spójności ostatecznej.
Zadbaj o idempotentność.
Obsługa błędów jest bardziej złożona.
Idempotentność
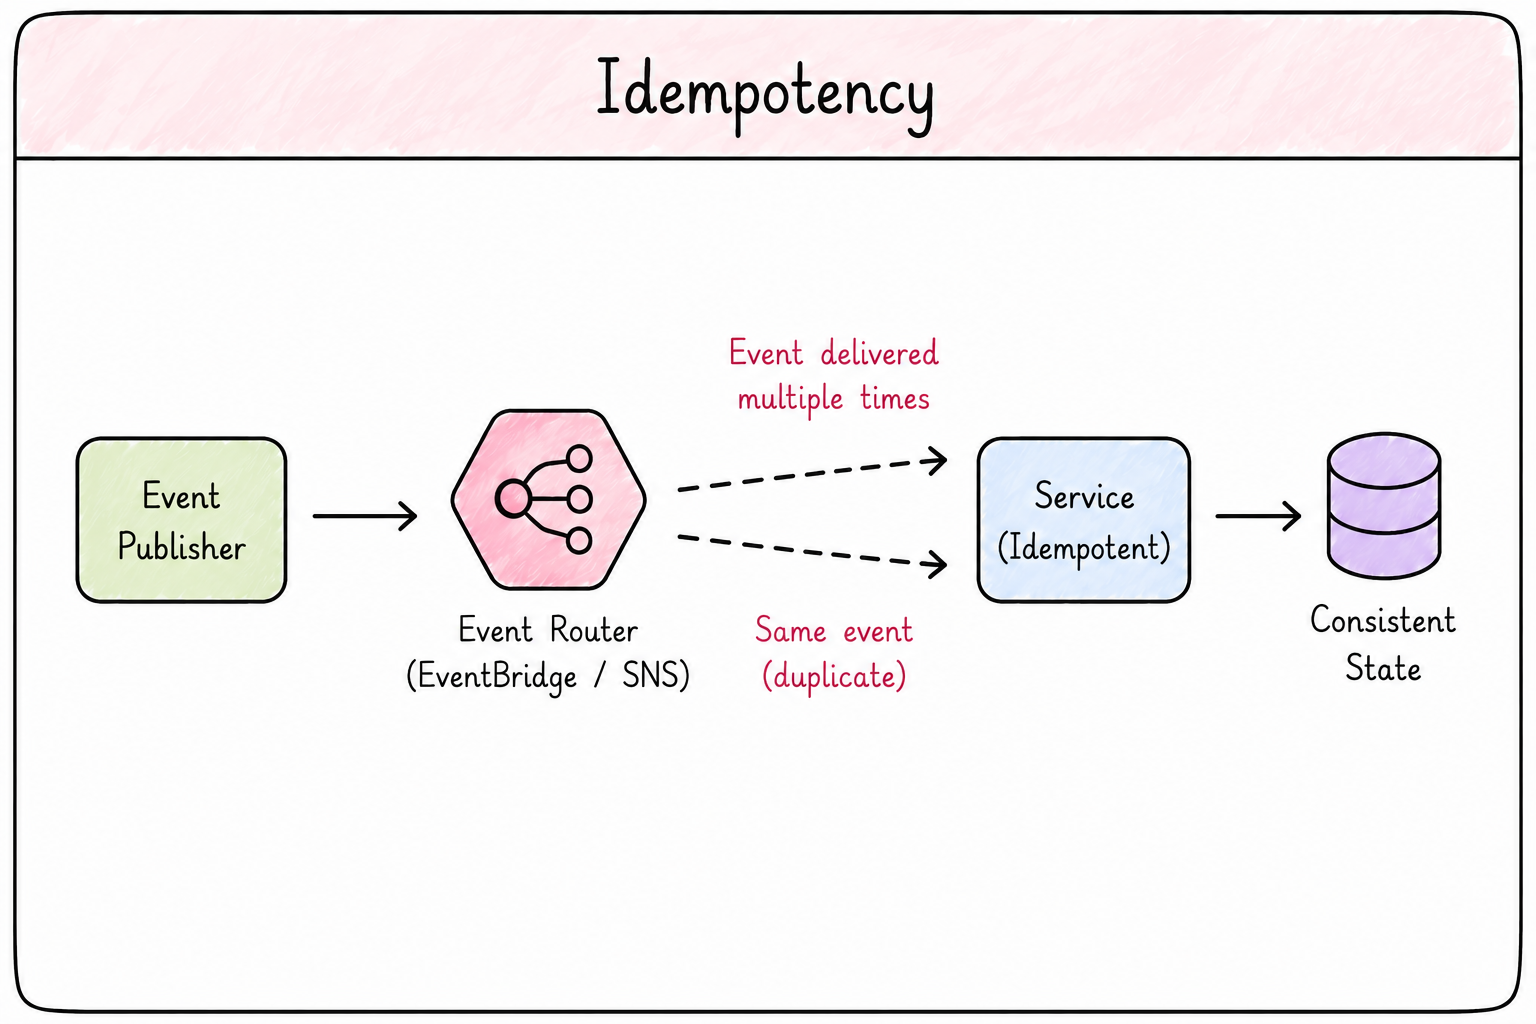
Wielokrotne wykonanie tej samej operacji daje ten sam wynik.
Kluczowa zasada projektowania w systemach asynchronicznych i sterowanych zdarzeniami.
Systemy rozproszone mogą dostarczać zduplikowane zdarzenia (ponowne próby, awarie sieci, ponowne przetwarzanie).
Gwarantuje poprawność i niezawodność systemu.
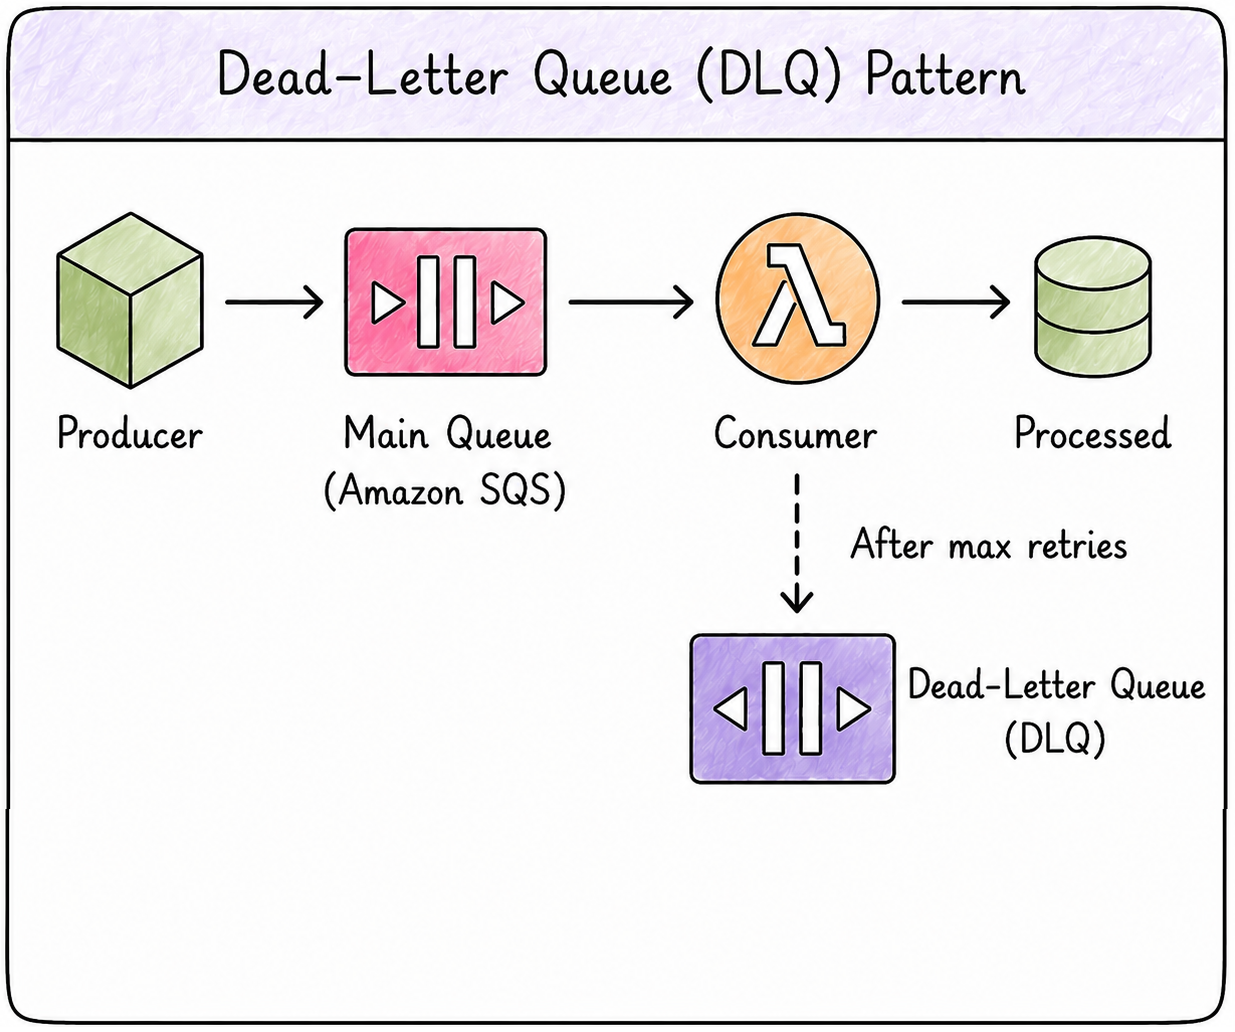
Kolejki niedostarczonych wiadomości
Zarządza błędami w komunikacji asynchronicznej.
Izoluje problematyczne wiadomości-„trucizny".
Po wielokrotnych nieudanych próbach wiadomość trafia do DLQ.
Główny przepływ przetwarzania działa bez zakłóceń.
Kolejki niedostarczonych wiadomości
Stosuj, gdy kolejność wiadomości nie jest istotna.
Pomiń w niekrytycznych systemach, gdzie sporadyczna utrata danych jest akceptowalna.
Unikaj, gdy kolejność wiadomości musi być zachowana.
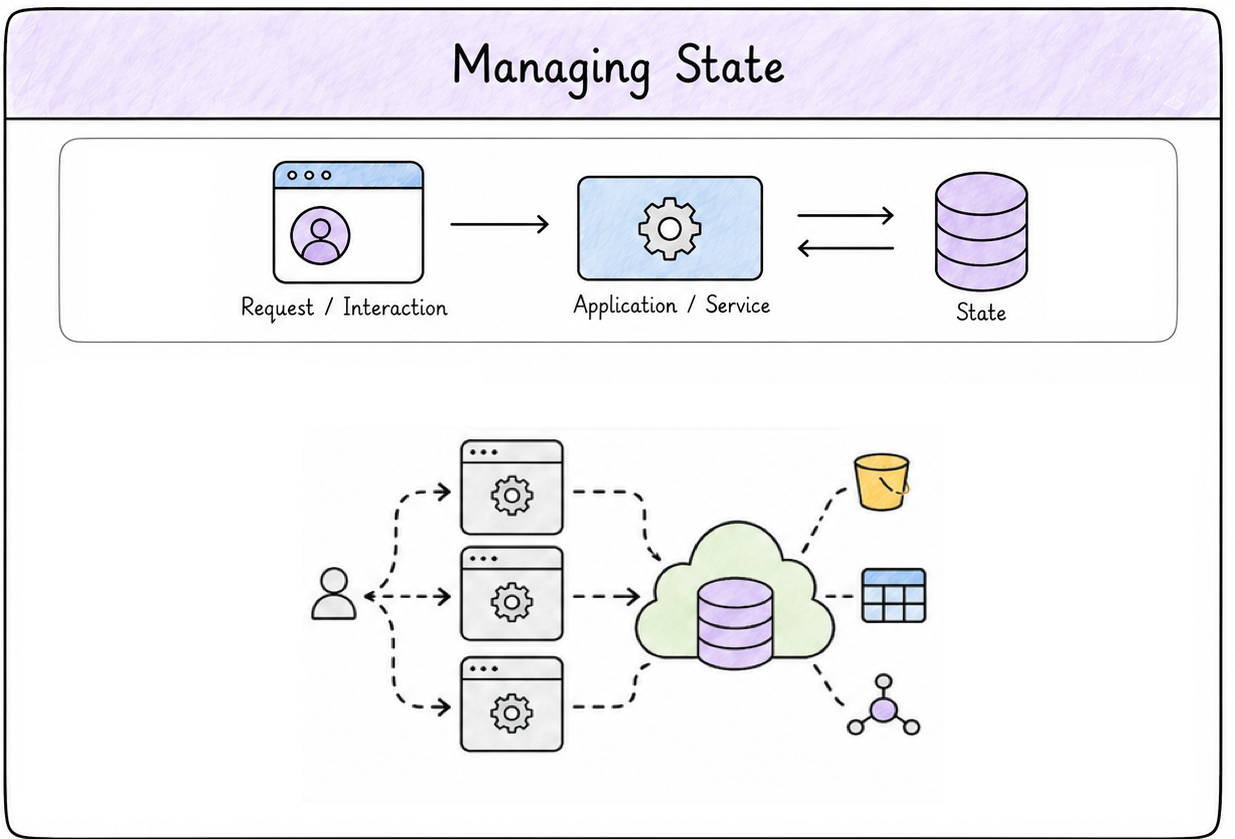
Zarządzanie stanem
Zarządzanie stanem jest podstawą aplikacji natywnych dla chmury.
Stan to dane zachowywane między kolejnymi interakcjami.
Przechowywanie stanu lokalnie na serwerze ogranicza skalowalność i odporność.
Zarządzanie stanem
Zarządzanie stanem wiąże się z kompromisami zależnymi od tego, co budujesz.
Zewnętrzny stan poprawia skalowalność i odporność.
Koszty: dodatkowe opóźnienia i złożoność.
Warto rozważyć: spójność, buforowanie i wzorce dostępu do danych.
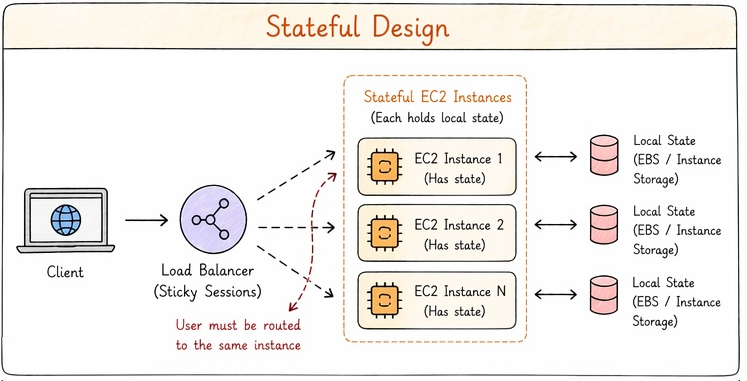
Stanowy
Dane sesji są przechowywane na serwerze.
Żądania muszą trafiać do
tej samej
instancji (sticky sessions).
Ogranicza elastyczność skalowania.
Gdy instancja ulegnie awarii, sesja przepada.
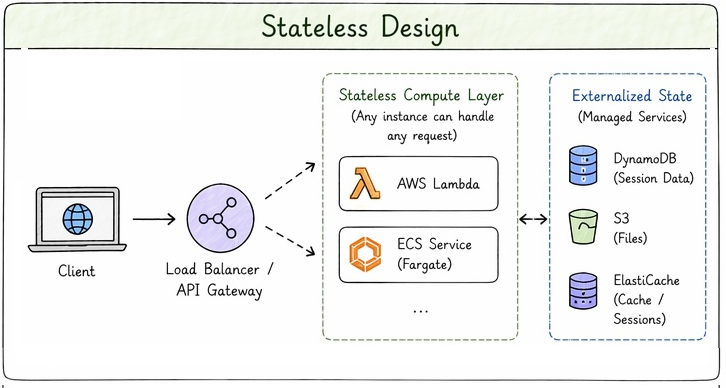
Bezstanowy
Każde żądanie jest traktowane niezależnie.
Serwer nie przechowuje żadnego stanu.
Stan znajduje się w systemach zewnętrznych.
Preferowane podejście w aplikacjach natywnych dla chmury.
Dowolna instancja może obsłużyć dowolne żądanie, co upraszcza skalowanie poziome.
Czas na praktykę!
Tworzenie aplikacji na AWS
Preparing Video For Download...