Koordinace služeb a správa stavu
Developing Applications on AWS
Ricardo Sueiras
Principal Technologist
Koordinace služeb
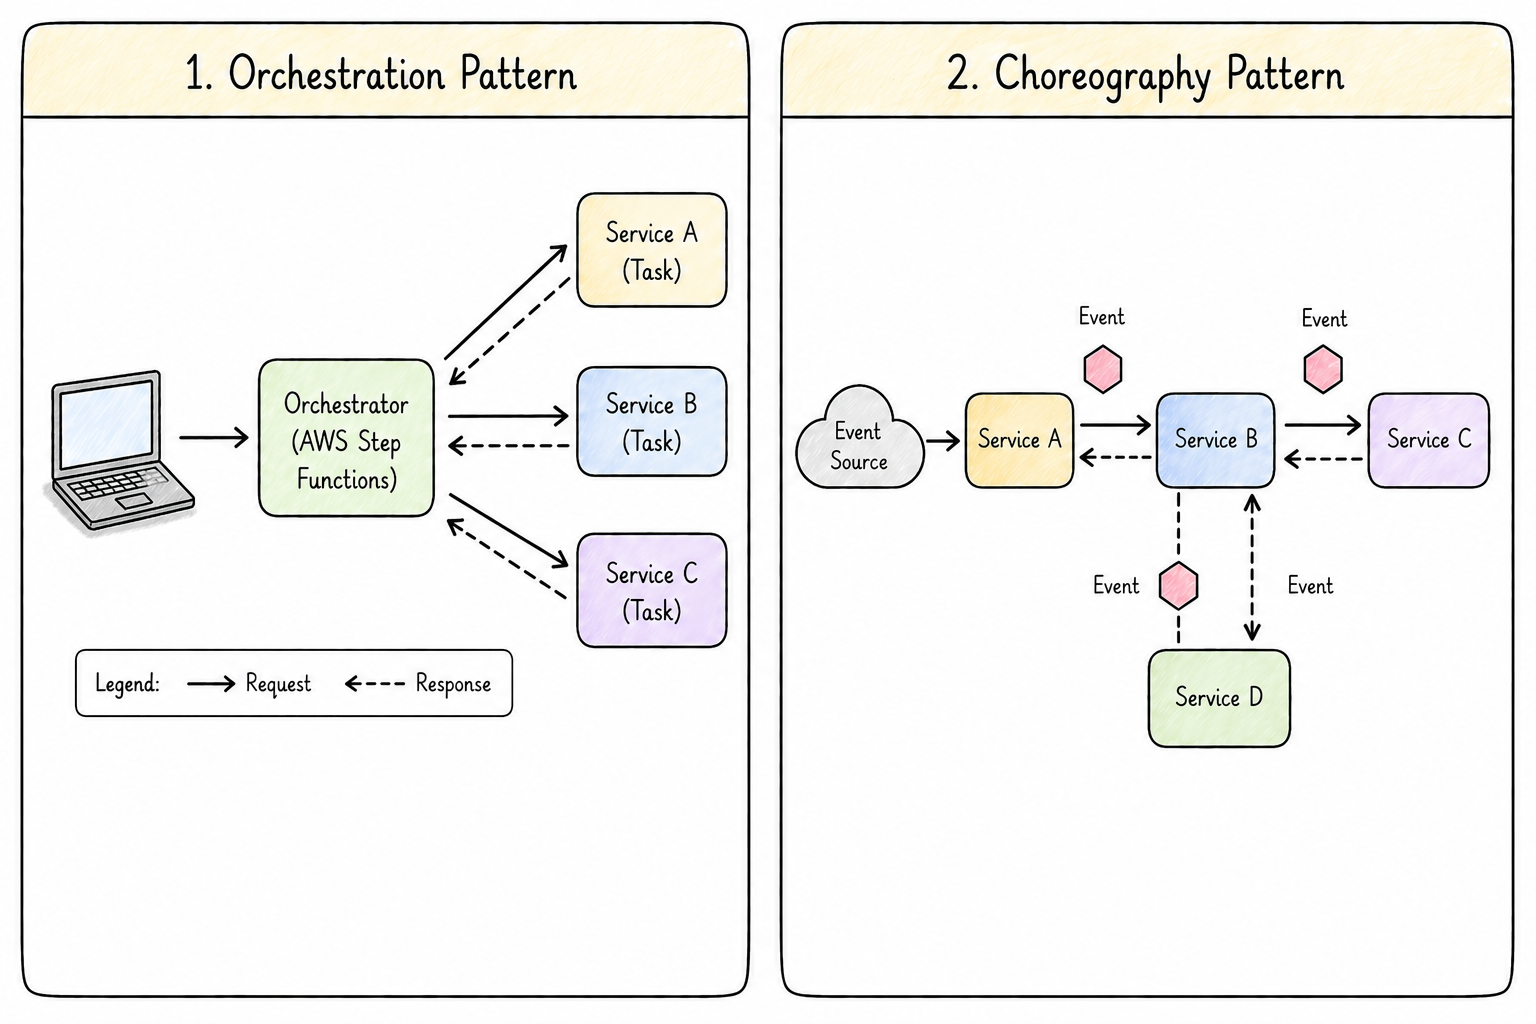
Více služeb musí spolupracovat, aby dokončily workflow.
Potřebují strategii koordinace.
Dva přístupy: orchestrace a choreografie.
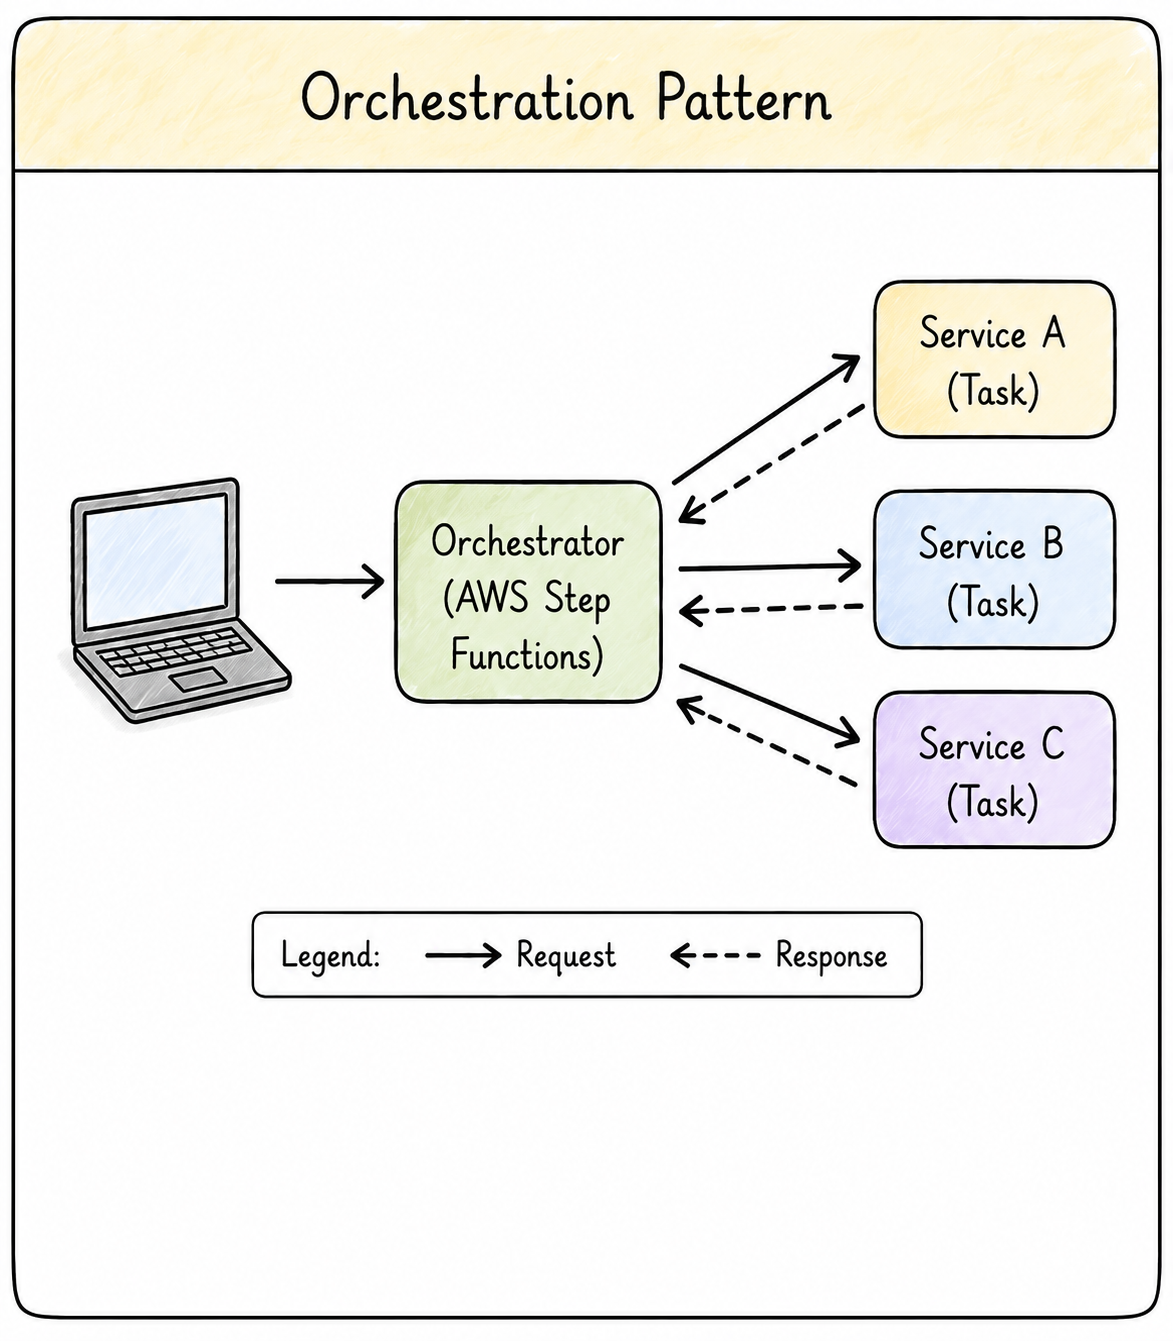
Orchestrace
Centrální orchestrátor koordinuje workflow.
Řídí pořadí kroků a rozhoduje, která služba poběží dál.
Vhodné pro opakované pokusy, podmíněnou logiku a zpracování chyb.
Na AWS: implementováno přes Step Functions s Lambda, ECS a DynamoDB.
Orchestrace
Logika workflow je na jednom místě – ladění a monitoring jsou snazší.
Kompromis: vzniká centrální závislost.
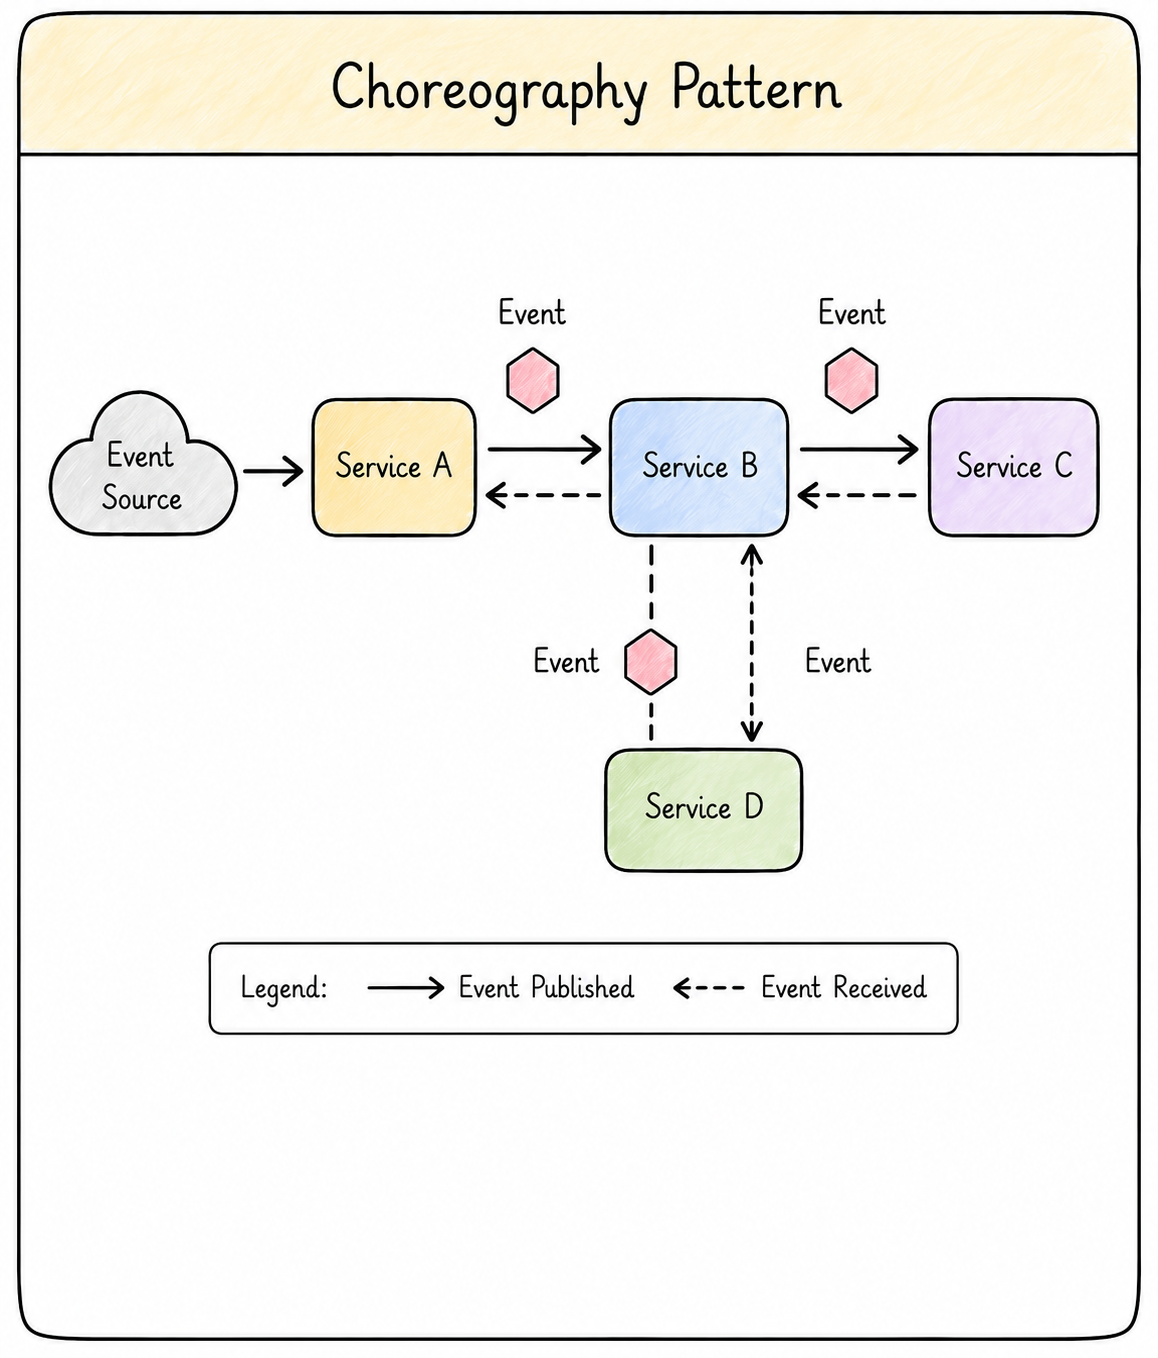
Choreografie
Žádný centrální kontroler.
Služby reagují na události samostatně.
Každá služba naslouchá relevantním událostem a vykoná svou práci.
Žádná služba nemusí znát celý workflow.
Zlepšuje volnou provázanost a škálovatelnost.
Choreografie
Na AWS: EventBridge, SNS, SQS.
Vysoká škálovatelnost.
Kompromis: s růstem workflow je pochopení a ladění obtížnější.
Architektura řízená událostmi
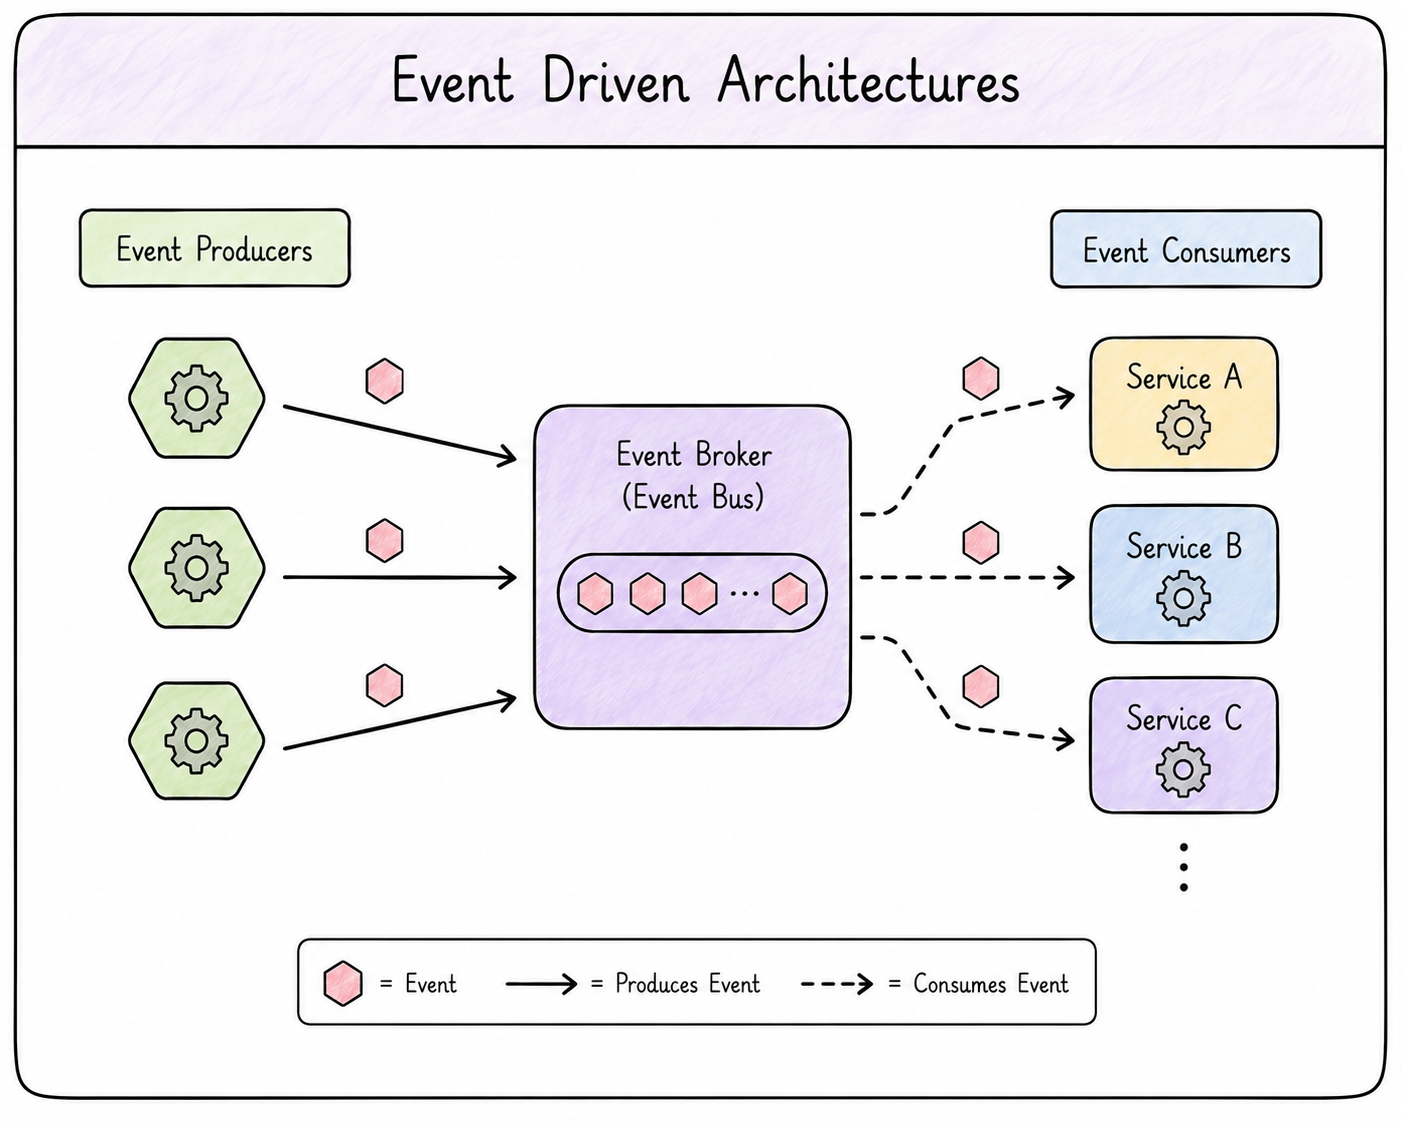
Služby komunikují produkcí a konzumací událostí.
Podporuje volnou provázanost mezi službami.
Podporuje vysokou škálovatelnost.
Umožňuje paralelní zpracování událostí.
Nové služby se mohou přihlásit k odběru bez úpravy stávajících.
Architektura řízená událostmi
Kompromisy při implementaci EDA:
Navrhuj s ohledem na eventuální konzistenci.
Implementuj idempotenci.
Zpracování chyb je složitější.
Idempotence
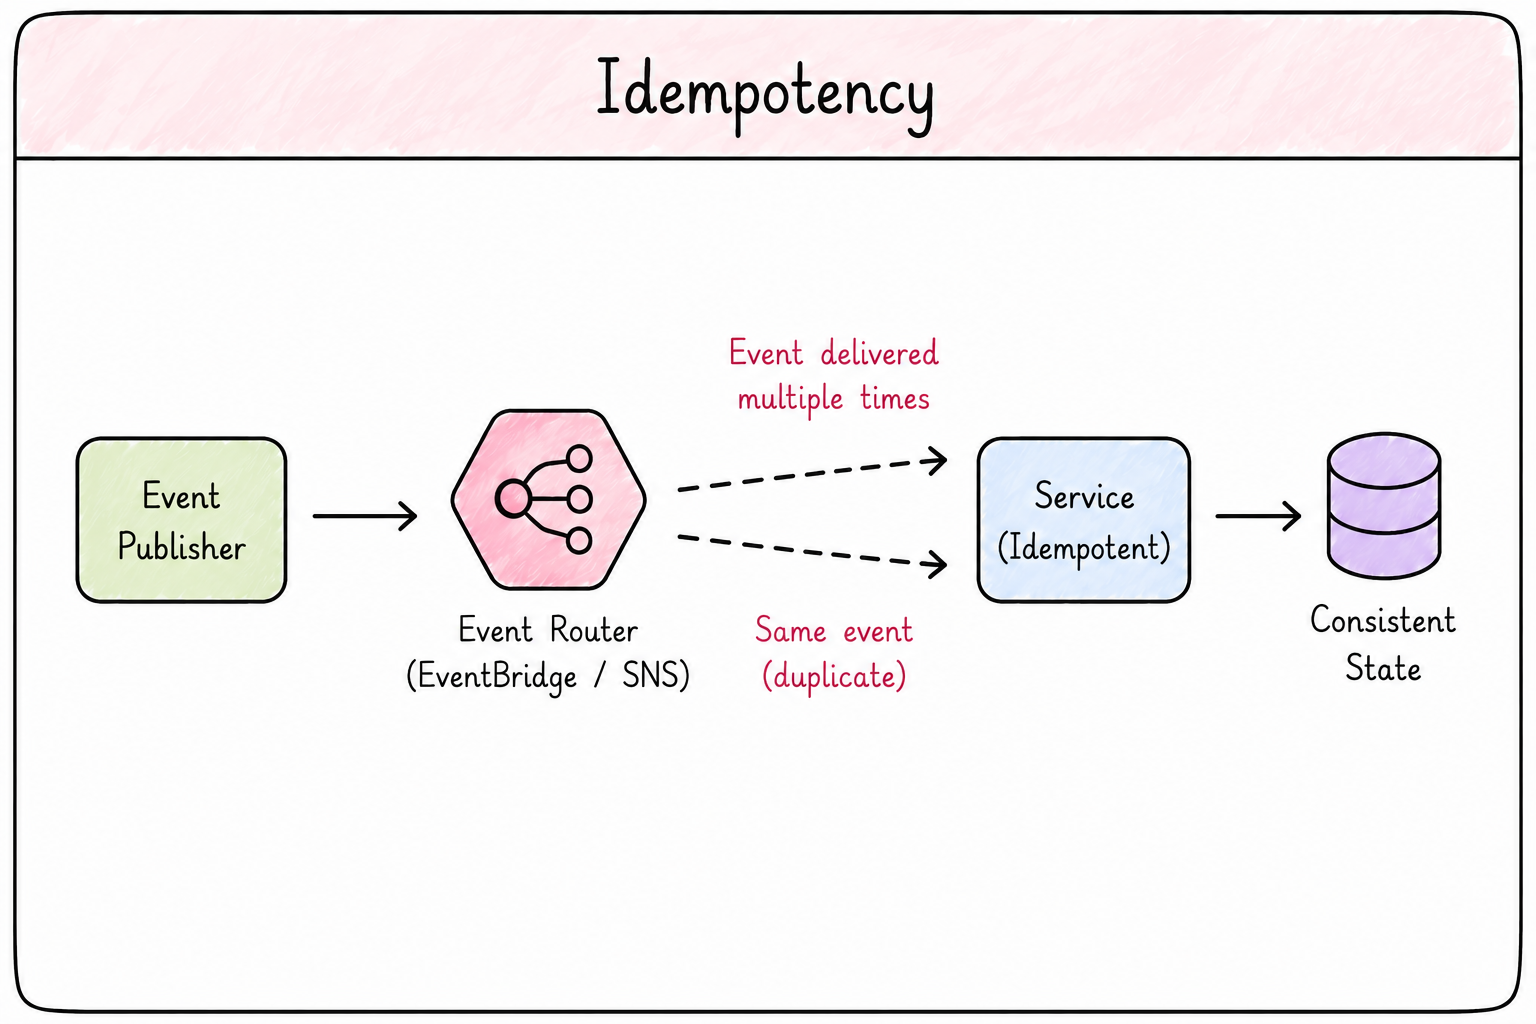
Opakované spuštění stejné operace vždy přinese stejný výsledek.
Klíčový návrhový princip v asynchronních a event-driven systémech.
Distribuované systémy mohou doručit duplicitní události (opakování, výpadky sítě, přepracování).
Zachovává správnost a spolehlivost systému.
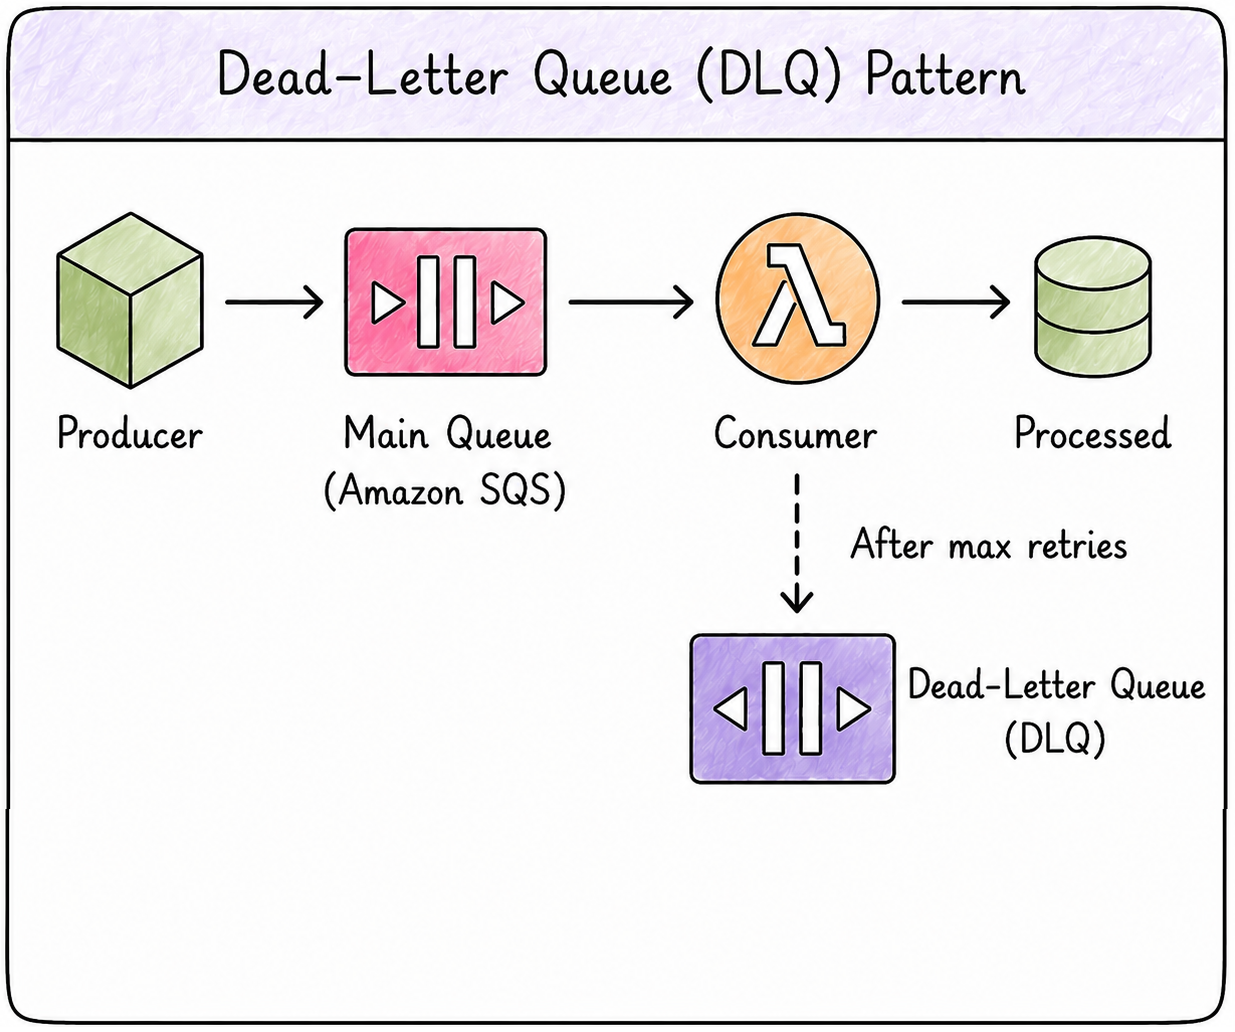
Dead letter queues
Spravuje selhání v asynchronní komunikaci.
Izoluje problematické „jedovaté" zprávy.
Po opakovaných selháních se zpráva přesune do DLQ.
Hlavní tok zpracování dále běží.
Dead letter queues
Použij, pokud pořadí zpráv není kritické.
Vynech u nekritických systémů, kde je příležitostná ztráta dat přijatelná.
Nepoužívej, když musí být pořadí zpráv zachováno.
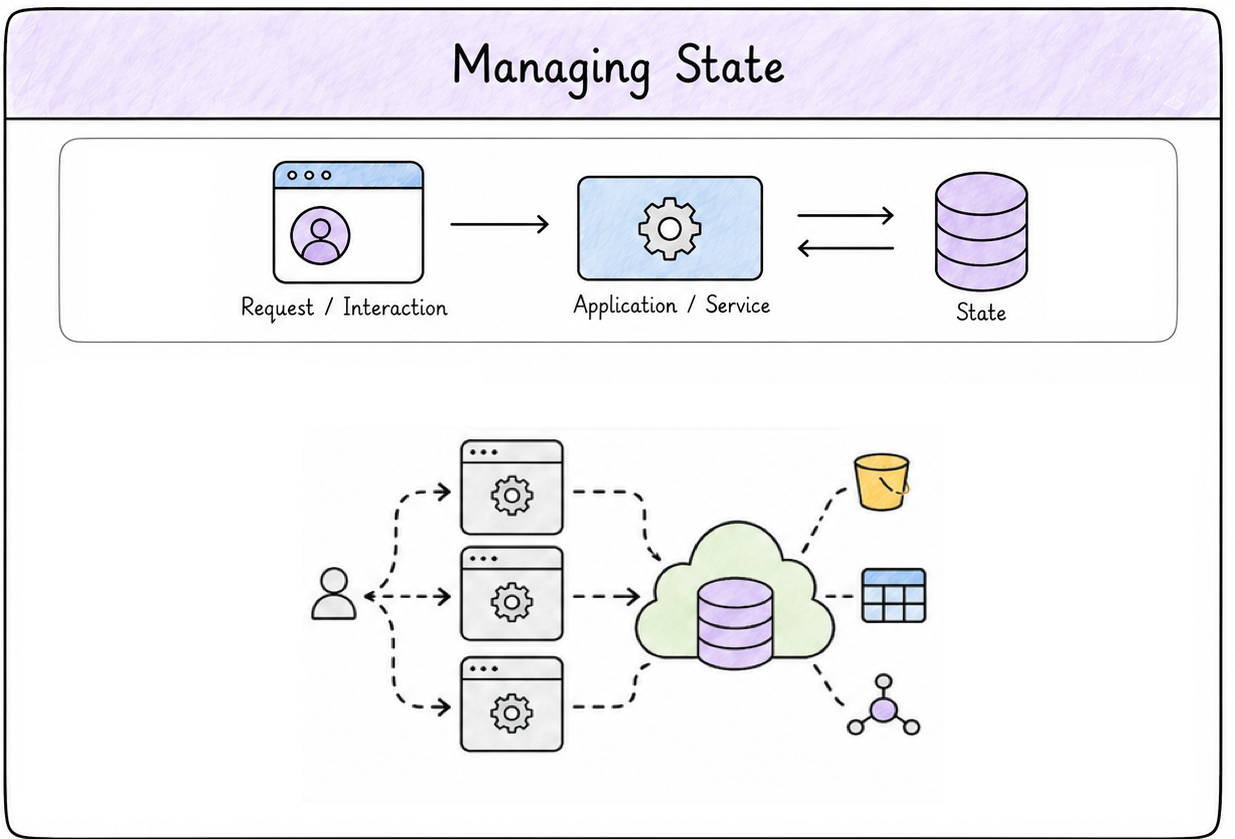
Správa stavu
Správa stavu je základem cloud native aplikací.
Stav jsou jakákoli data uchovávaná mezi interakcemi.
Ukládání stavu lokálně na serveru omezuje škálovatelnost a odolnost.
Správa stavu
Správa stavu zahrnuje kompromisy podle toho, co stavíš.
Externí stav zlepšuje škálovatelnost a odolnost.
Náklady: vyšší latence a složitost.
Co zvážit: konzistence, caching a vzory přístupu k datům.
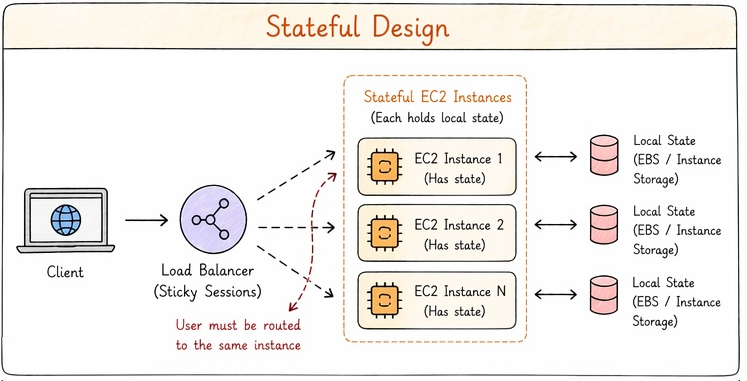
Stavový (stateful)
Data relace jsou uložena na serveru.
Požadavky musí směřovat na
stejnou
instanci (sticky sessions).
Omezuje flexibilitu škálování.
Pokud instance selže, relace je ztracena.
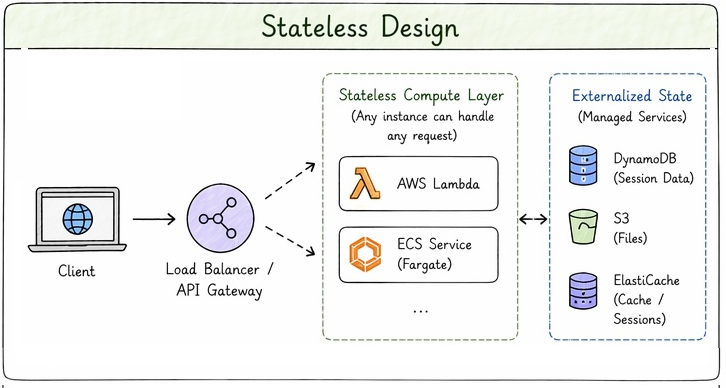
Bezstavový (stateless)
Každý požadavek je zpracován nezávisle.
Na serveru se neuchovává žádný stav.
Stav žije v externích systémech.
Preferovaný přístup pro cloud native aplikace.
Jakákoli instance zvládne libovolný požadavek – horizontální škálování je přímočaré.
Pojďme cvičit!
Developing Applications on AWS
Preparing Video For Download...