Coordonarea serviciilor și gestionarea stării
Dezvoltarea aplicațiilor pe AWS
Ricardo Sueiras
Principal Technologist
Coordonarea serviciilor
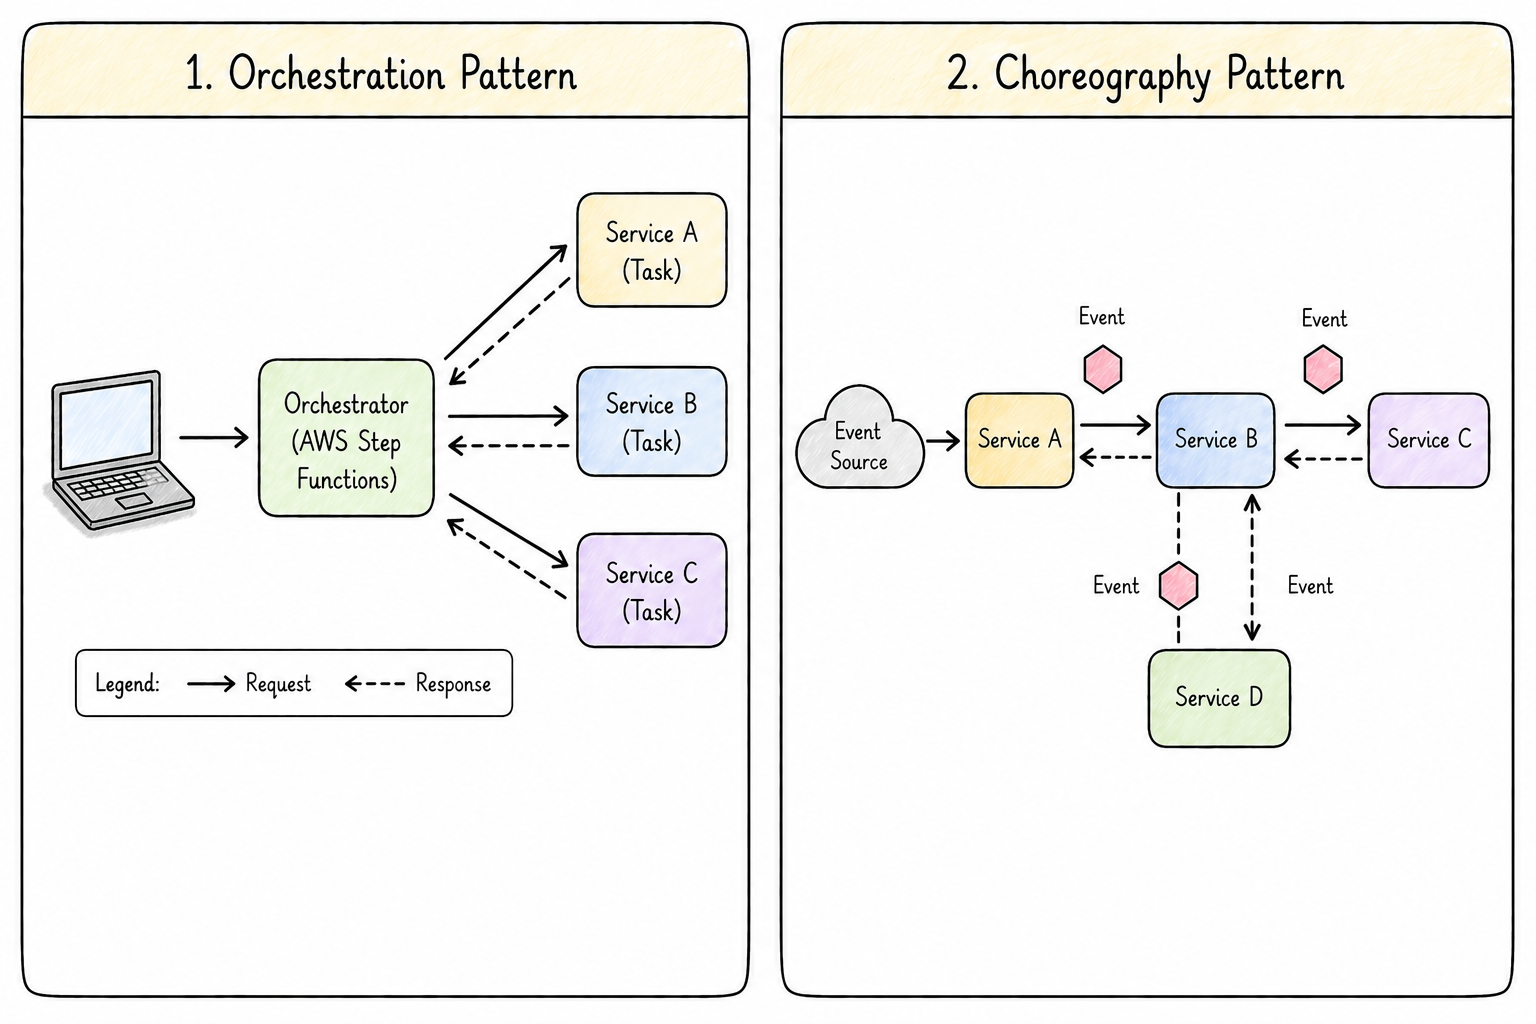
Mai multe servicii trebuie să colaboreze pentru a finaliza un flux de lucru.
Este nevoie de o strategie de coordonare.
Două abordări: orchestrare și coregrafie.
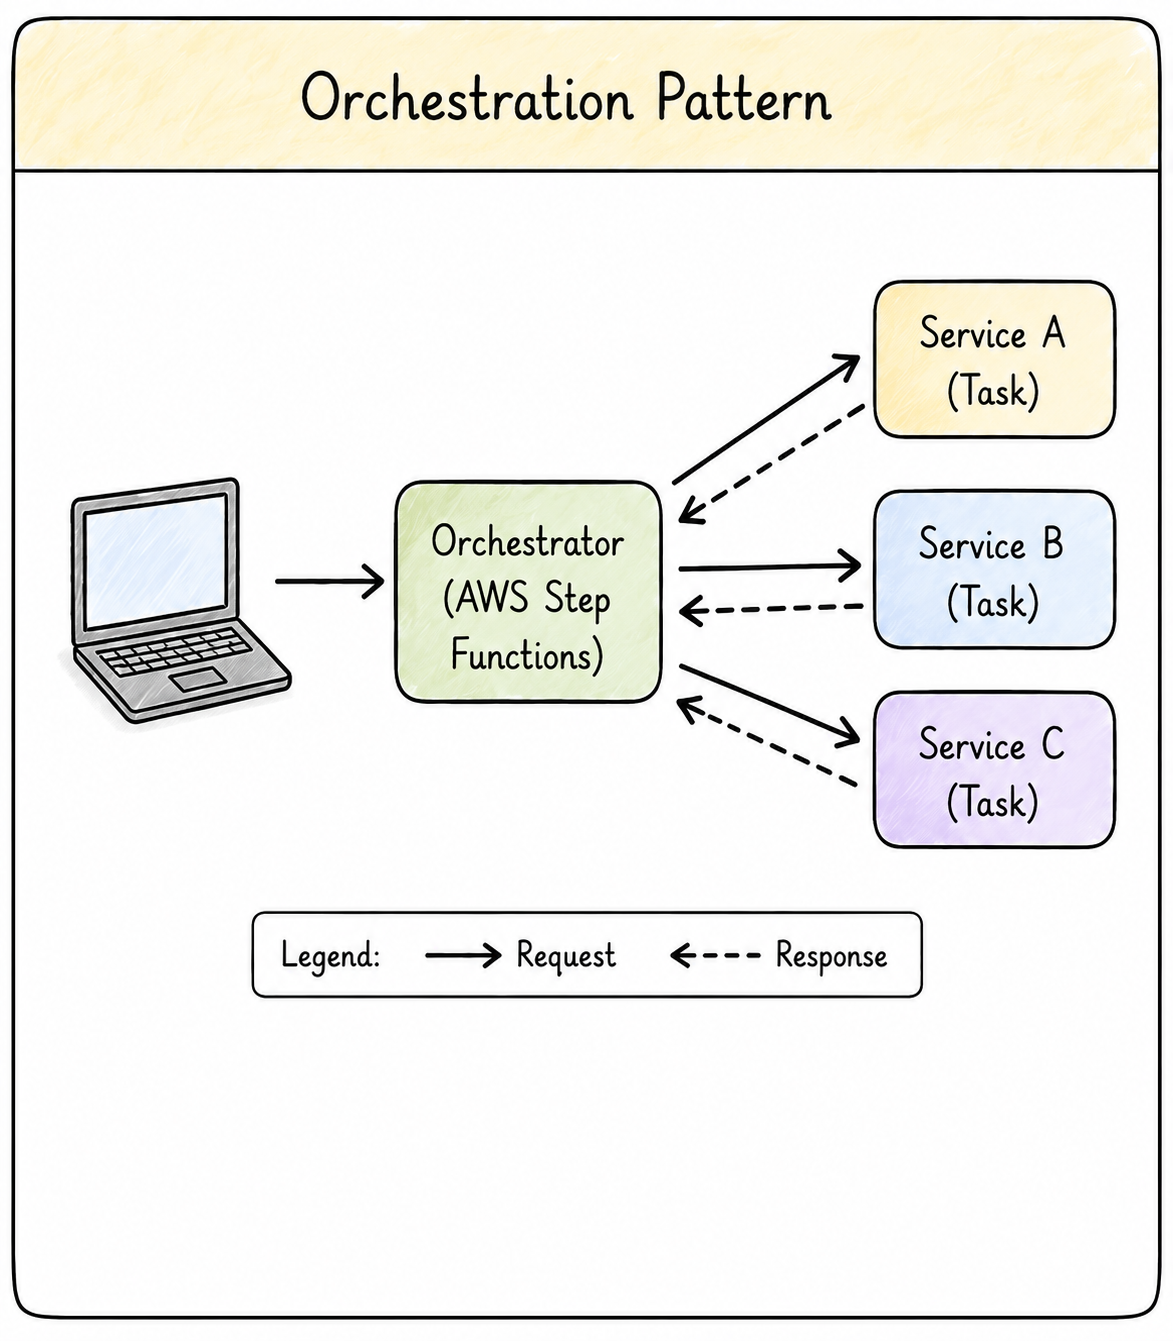
Orchestrare
Un orchestrator central coordonează fluxul de lucru.
Orchestratorul controlează secvența și decide ce serviciu rulează următor.
Util pentru reîncercări, logică condiționată și gestionarea erorilor.
Pe AWS: implementat cu Step Functions pentru Lambda, ECS, DynamoDB.
Orchestrare
Logica fluxului se află într-un singur loc, ceea ce simplifică depanarea și monitorizarea.
Compromis: introduce o dependență centrală.
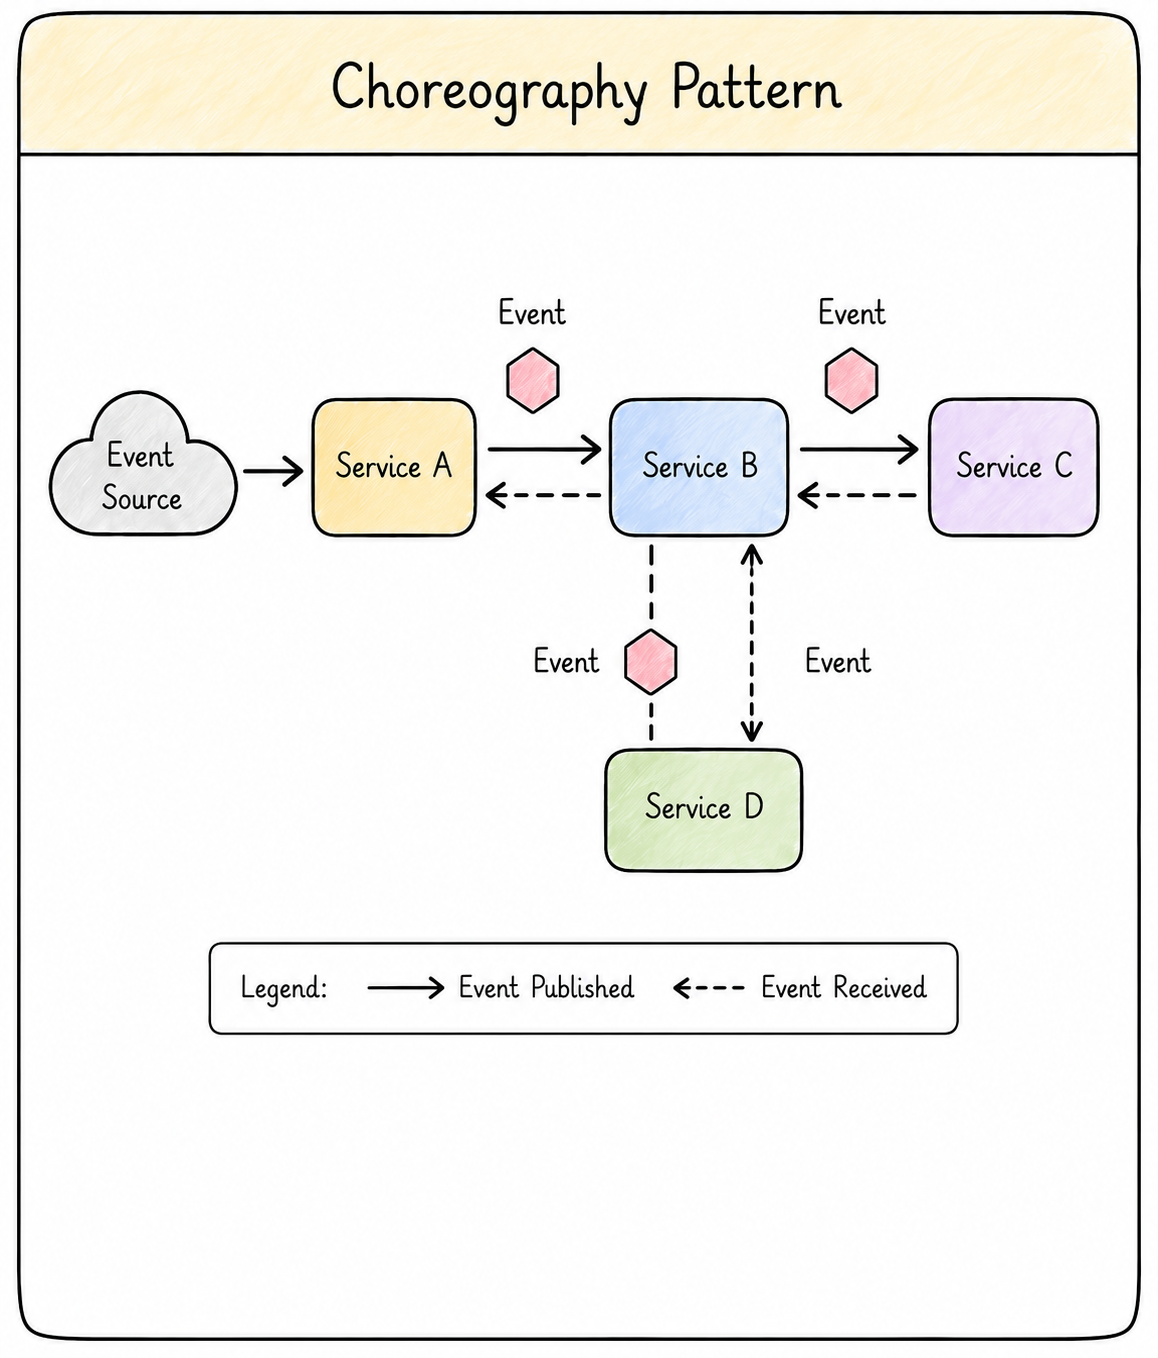
Coregrafie
Niciun controler central.
Serviciile reacționează la evenimente în mod independent.
Fiecare serviciu ascultă evenimentele relevante și își execută sarcina.
Niciun serviciu nu trebuie să cunoască întregul flux de lucru.
Îmbunătățește cuplarea slabă și scalabilitatea.
Coregrafie
Pe AWS: EventBridge, SNS, SQS.
Scalabilitate ridicată.
Compromis: mai greu de înțeles și depanat pe măsură ce fluxurile cresc.
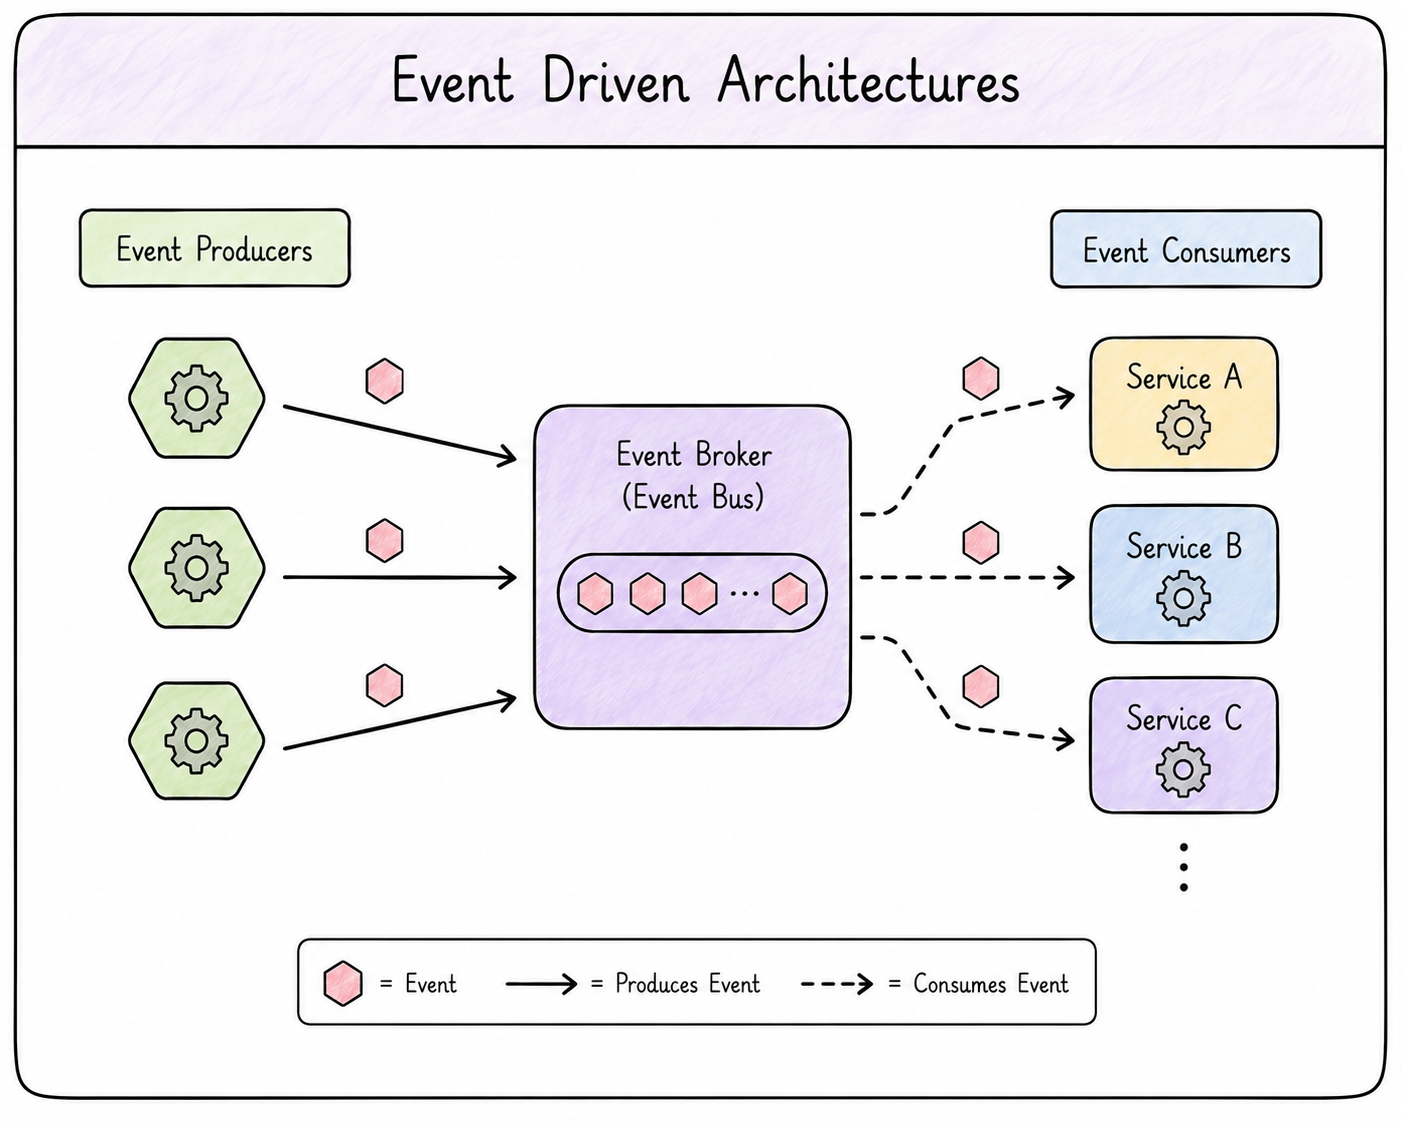
Arhitectură bazată pe evenimente
Serviciile comunică prin producerea și consumul de evenimente.
Promovează cuplarea slabă între servicii.
Promovează scalabilitate ridicată.
Permite procesarea paralelă a evenimentelor.
Servicii noi se pot abona fără a le modifica pe cele existente.
Arhitectură bazată pe evenimente
Compromisuri la implementarea EDA:
Proiectează pentru consistență eventuală.
Implementează idempotența.
Gestionarea eșecurilor este mai complexă.
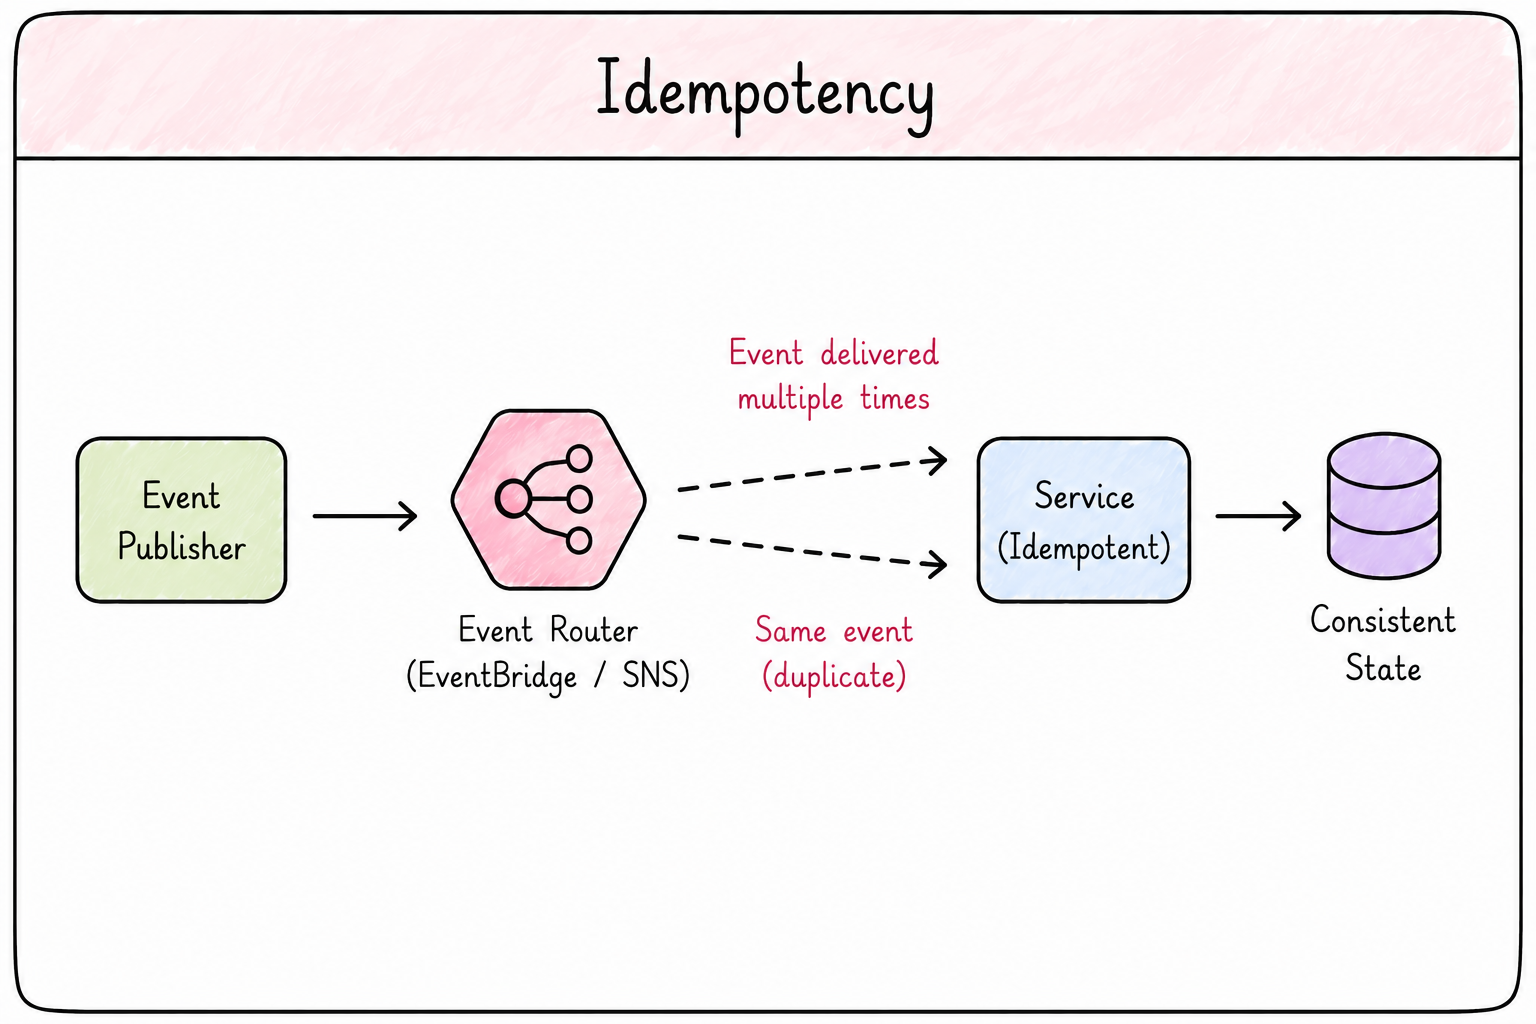
Idempotență
Aceeași operațiune executată de mai multe ori produce același rezultat.
Principiu de proiectare esențial în sistemele asincrone și bazate pe evenimente.
Sistemele distribuite pot livra evenimente duplicate (reîncercări, erori de rețea, reprocesare).
Păstrează corectitudinea și fiabilitatea sistemului.
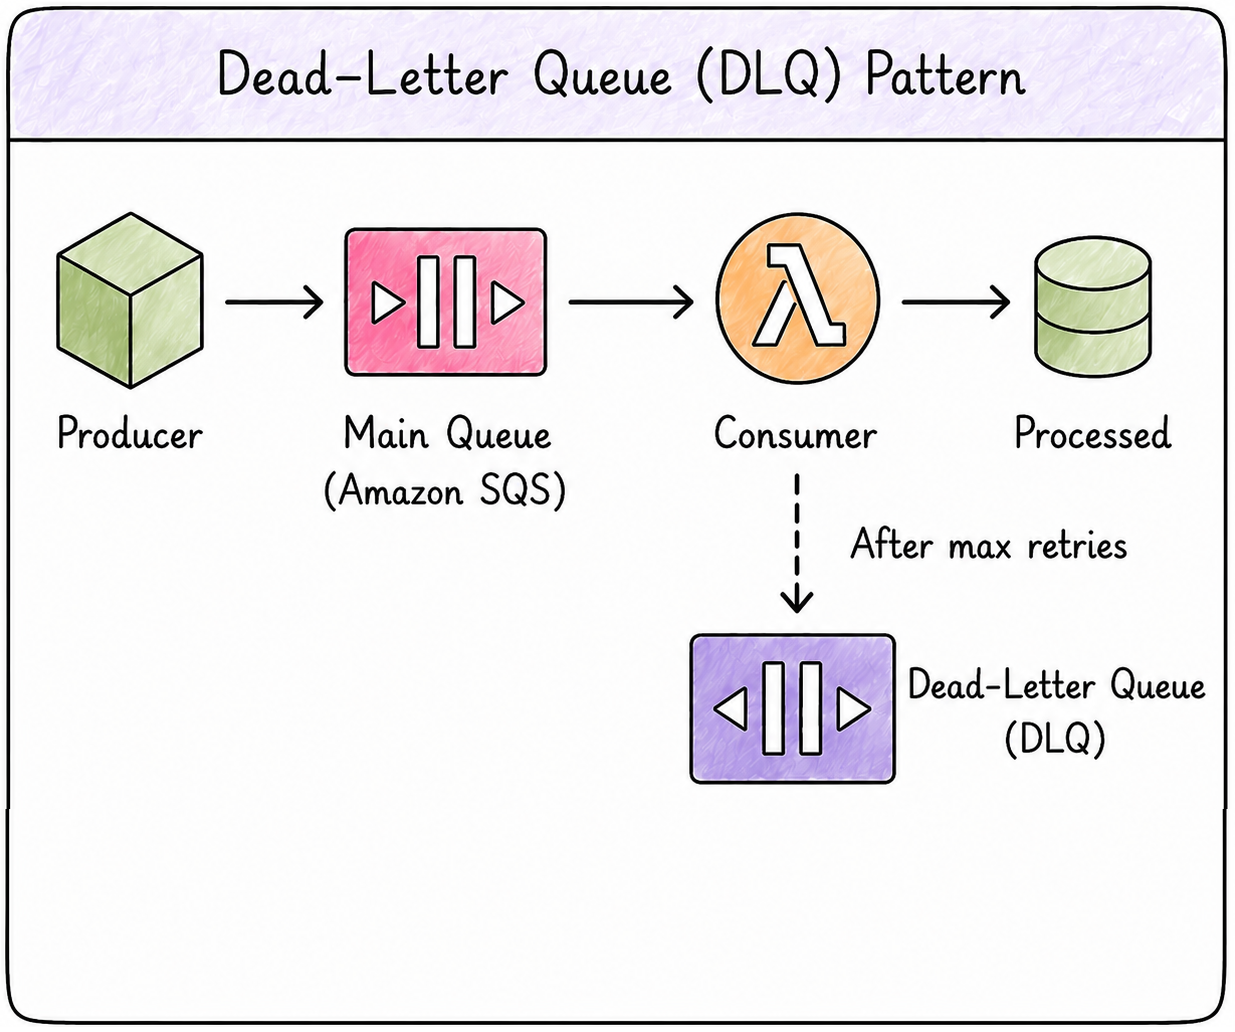
Cozi de mesaje moarte
Gestionează eșecurile în comunicarea asincronă.
Izolează mesajele problematice "poison".
După reîncercări repetate eșuate, mesajul este mutat în DLQ.
Fluxul principal de procesare continuă să ruleze.
Cozi de mesaje moarte
Folosește când ordinea mesajelor nu este critică.
Omite pentru sisteme necritice unde pierderea ocazională de date este acceptabilă.
Evită când ordinea mesajelor trebuie păstrată.
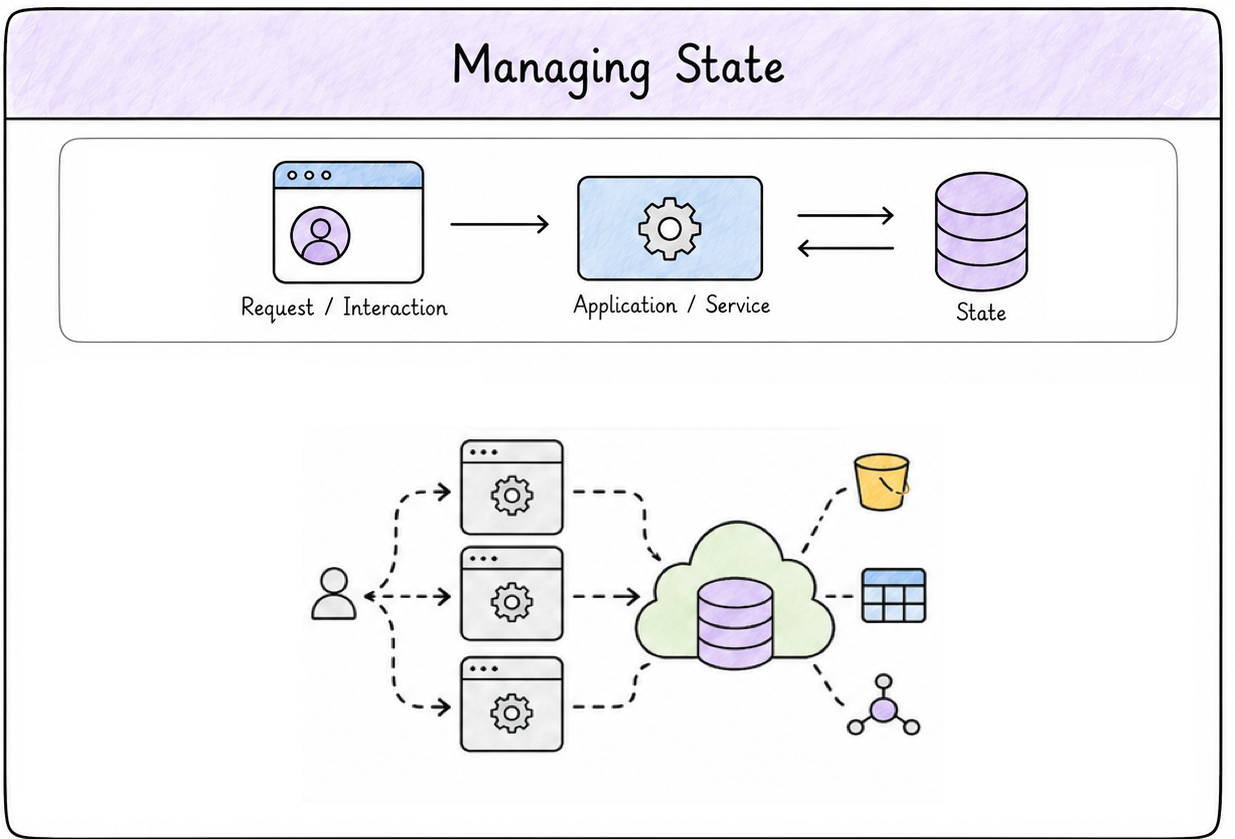
Gestionarea stării
Gestionarea stării este fundamentală pentru aplicațiile cloud-native.
Starea reprezintă orice date păstrate între interacțiuni.
Stocarea locală a stării pe server limitează scalabilitatea și reziliența.
Gestionarea stării
Gestionarea stării implică compromisuri în funcție de ce construiești.
Starea externă îmbunătățește scalabilitatea și reziliența.
Costuri: latență și complexitate suplimentare.
De luat în considerare: consistența, memoria cache și modelele de acces la date.
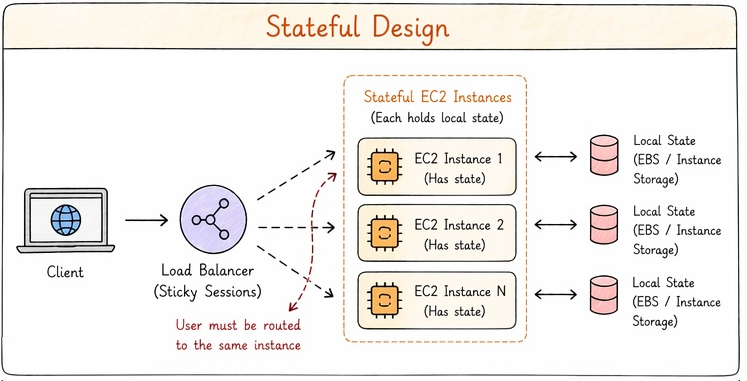
Stateful
Datele de sesiune sunt reținute pe server.
Cererile trebuie direcționate către
aceeași
instanță (sesiuni sticky).
Limitează flexibilitatea scalării.
Dacă instanța eșuează, sesiunea se pierde.
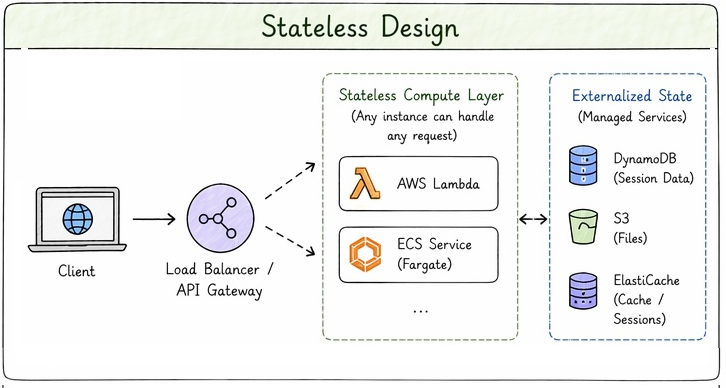
Stateless
Fiecare cerere este tratată independent.
Nicio stare stocată pe server.
Starea se află în sisteme externe.
Abordarea preferată pentru aplicațiile cloud-native.
Orice instanță poate gestiona orice cerere, deci scalarea orizontală este simplă.
Hai să exersăm!
Dezvoltarea aplicațiilor pe AWS
Preparing Video For Download...