การแจ้งเตือนและการแจ้งเหตุของ CloudWatch

การติดตามและแก้ไขปัญหาบน AWS

John Q. Martin

Principal Consultant

CloudWatch Alarms คืออะไร
 

แนวคิดหลัก

  • ตรวจสอบเมตริกเดียวในช่วงเวลาที่กำหนด
  • ดำเนินการเมื่อเมตริกเกินค่าเกณฑ์


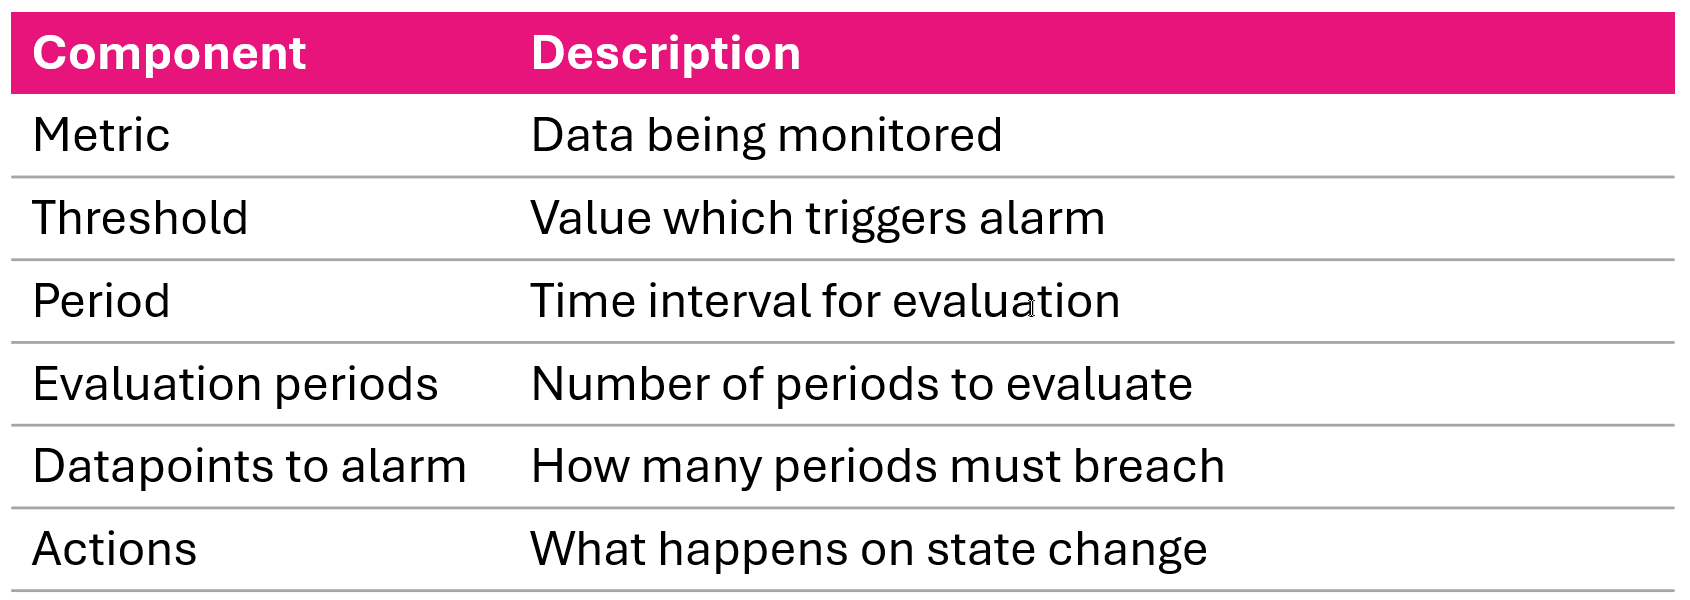
องค์ประกอบหลัก 6 อย่างของการแจ้งเตือน CloudWatch ได้แก่ metric threshold period evaluation periods datapoints to alarm และ actions

การติดตามและแก้ไขปัญหาบน AWS

สถานะของการแจ้งเตือน

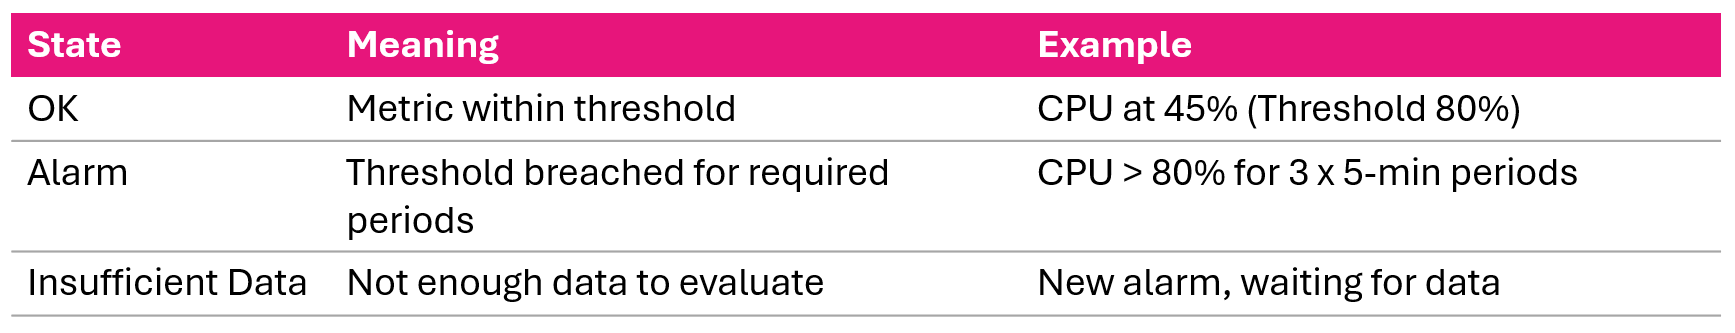
สถานะการแจ้งเตือน CloudWatch ทั้งสาม ได้แก่ OK ALARM และ INSUFFICIENT_DATA

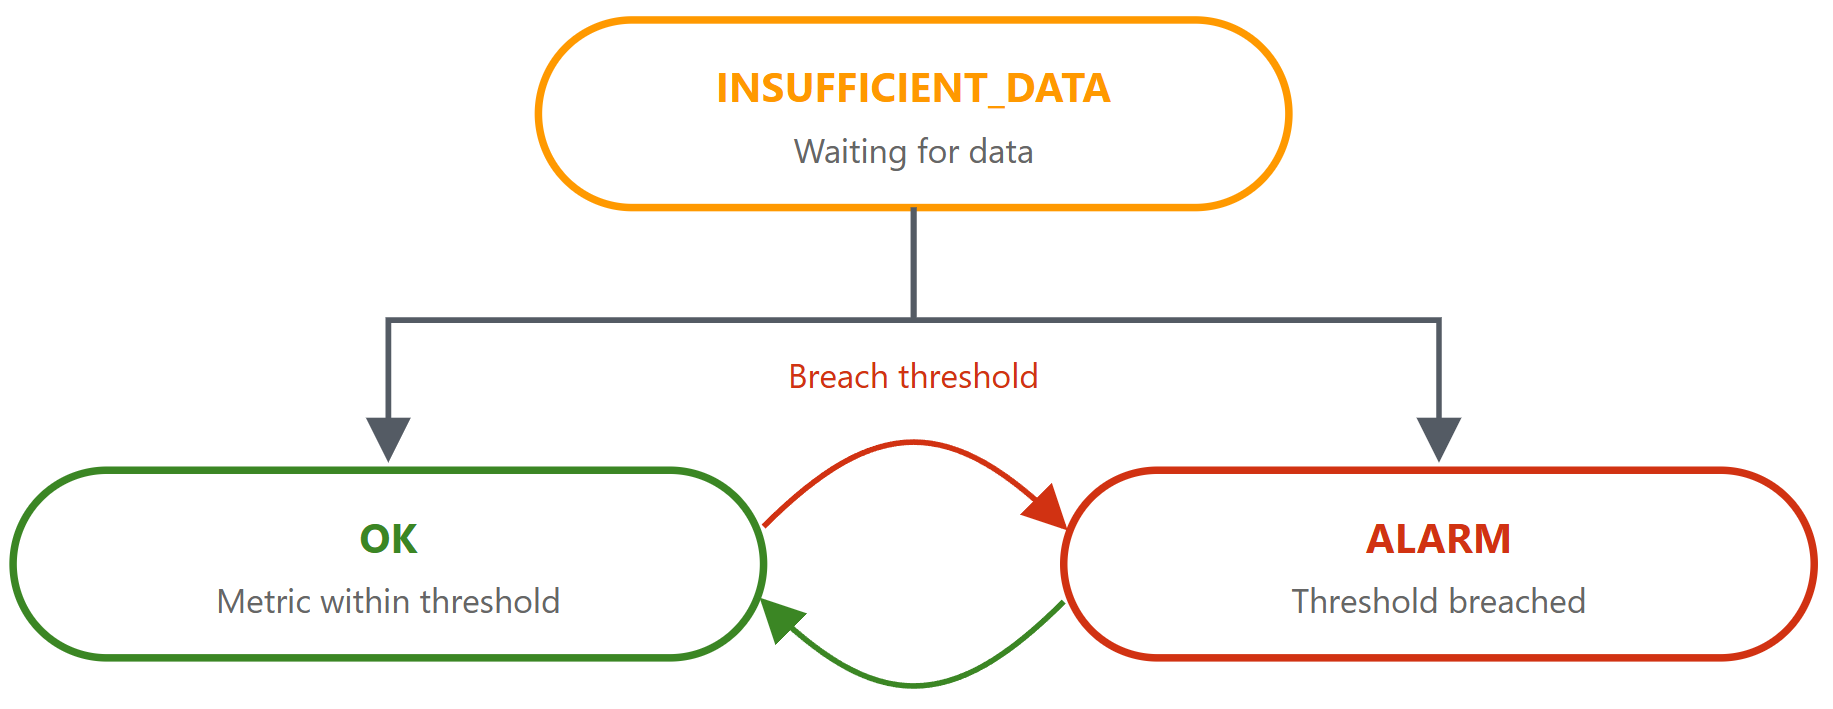
ไดอะแกรมแสดงการเปลี่ยนสถานะของการแจ้งเตือน CloudWatch เมื่อข้อมูลเมตริกเข้ามา

การติดตามและแก้ไขปัญหาบน AWS

การประเมินการแจ้งเตือน


  1. เก็บข้อมูลในช่วงเวลาที่กำหนด
  2. คำนวณค่าสถิติ (Average, Sum, Max, Min) ในแต่ละช่วง
  3. เปรียบเทียบผลลัพธ์กับค่าเกณฑ์
  4. นับจำนวนช่วงที่เกินค่าเกณฑ์
  5. เปลี่ยนสถานะเมื่อถึงเกณฑ์ datapoints-to-alarm


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
การติดตามและแก้ไขปัญหาบน AWS

กลยุทธ์การประเมิน


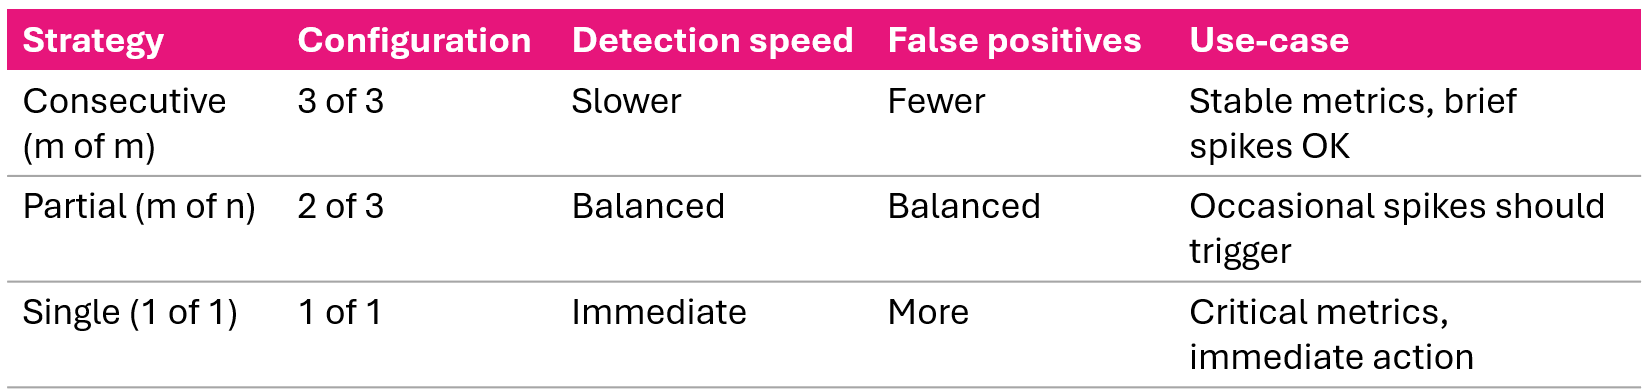
กลยุทธ์การประเมินการแจ้งเตือน 3 แบบ ได้แก่ consecutive partial และ single breach พร้อมข้อดีข้อเสียด้านความไว

การติดตามและแก้ไขปัญหาบน AWS

ประเภทและเงื่อนไขของการดำเนินการเมื่อแจ้งเตือน


เงื่อนไขที่กระตุ้นการดำเนินการ

  • OK
  • ALARM
  • INSUFFICIENT_DATA


ประเภทการดำเนินการ

  • SNS Notification
  • Auto Scaling
  • EC2 Action (stop/terminate/reboot/recover)
  • Systems Manager
การติดตามและแก้ไขปัญหาบน AWS

พฤติกรรมเมื่อข้อมูลหายไป


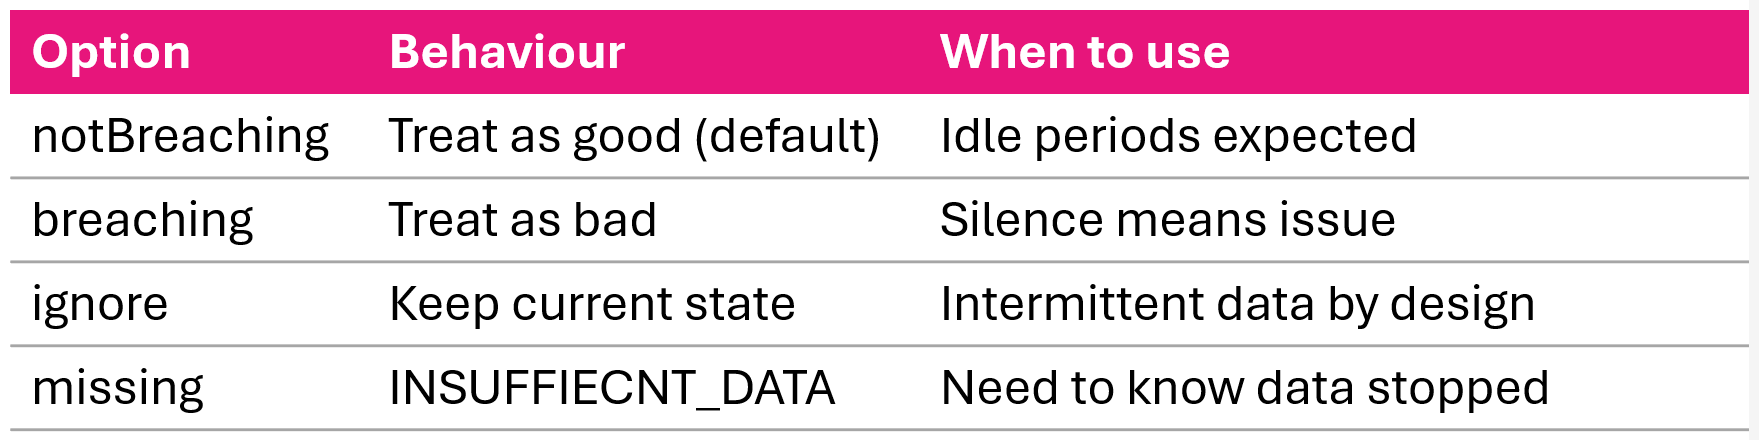
ตัวเลือกพฤติกรรมเมื่อข้อมูลหายไป ได้แก่ notBreaching breaching ignore และ missing

การติดตามและแก้ไขปัญหาบน AWS

การสร้าง Standard Alarm ด้วย AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
การติดตามและแก้ไขปัญหาบน AWS

Composite Alarms: คืออะไรและทำไมต้องใช้
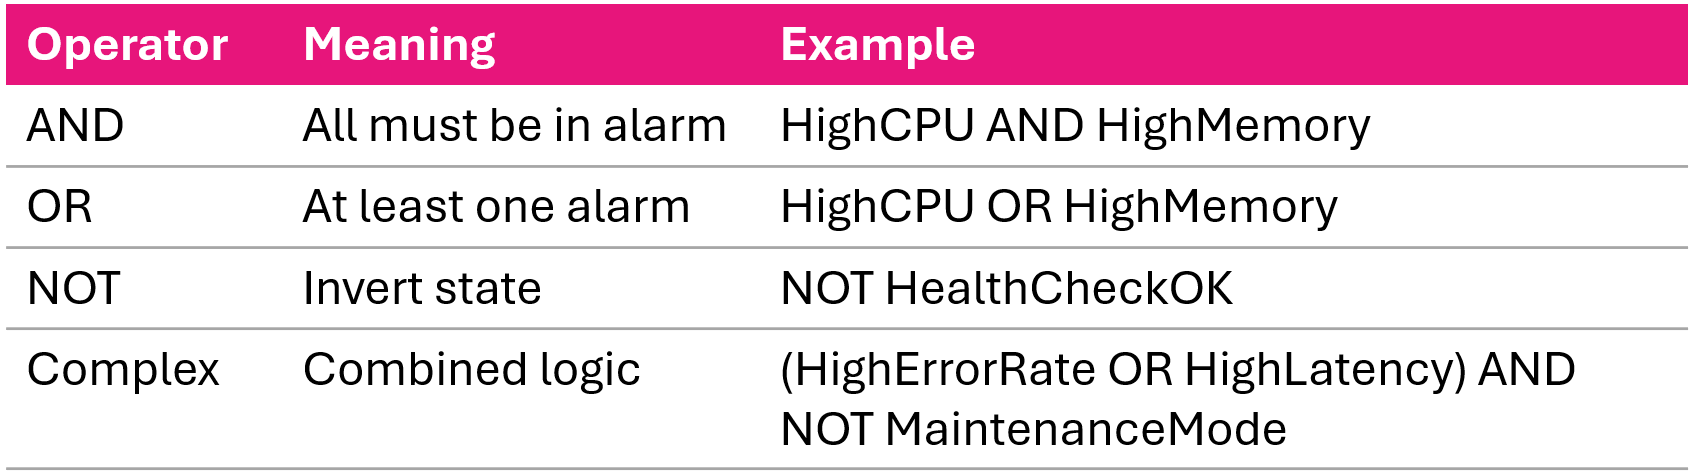
ปัญหา

  • การแจ้งเตือนที่เกี่ยวข้องกันแต่ทำงานแยกกัน = ความเหนื่อยล้าจากการแจ้งเตือน

วิธีแก้

  • รวมการแจ้งเตือนด้วย Logical Operator

ตรรกะของ Composite Alarm ที่รวม Child Alarm ด้วย AND OR และ NOT

การติดตามและแก้ไขปัญหาบน AWS

การสร้าง Composite Alarm ด้วย AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
ตัวอย่างกฎที่ซับซ้อน
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
การติดตามและแก้ไขปัญหาบน AWS

กลยุทธ์การเลือกค่าเกณฑ์

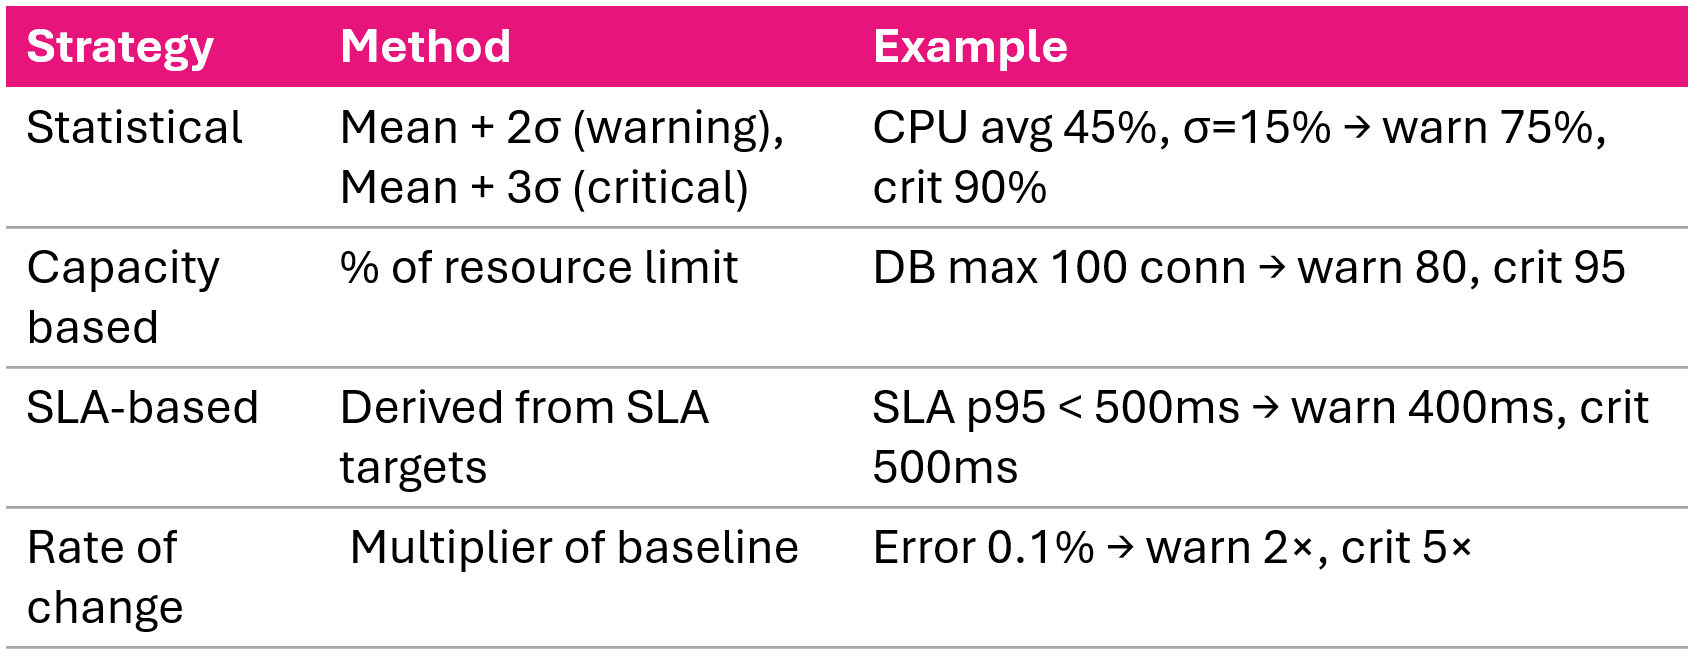
กลยุทธ์การเลือกค่าเกณฑ์ 4 แบบ ได้แก่ baseline deviation capacity limits SLA targets และ rate of change

การติดตามและแก้ไขปัญหาบน AWS

กลยุทธ์การแจ้งเตือนแบบหลายระดับ


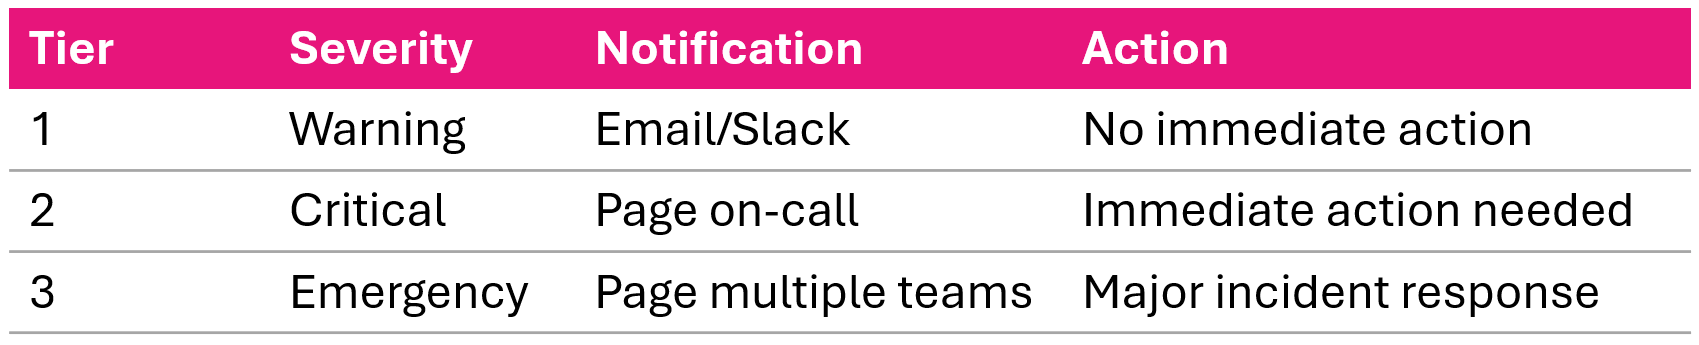
การแจ้งเตือนแบบหลายระดับ ได้แก่ warning critical และ emergency ที่ส่งไปยัง SNS Topic แยกกัน

ตัวอย่าง: CPU Warning ที่ 75%, Critical ที่ 90% โดยแต่ละระดับใช้ SNS Topic ต่างกัน

การติดตามและแก้ไขปัญหาบน AWS

การแจ้งเตือนด้วย Anomaly Detection

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • โมเดล ML เรียนรู้พฤติกรรมปกติของเมตริก
  • สร้างแถบค่าเกณฑ์แบบไดนามิก (ปรับได้)
  • ปรับตัวตามรูปแบบรายวัน/รายสัปดาห์
  • ลดการปรับค่าเกณฑ์ด้วยตนเอง
การติดตามและแก้ไขปัญหาบน AWS

การแจ้งเตือนสำหรับ Lambda และ ALB

การแจ้งเตือนสำหรับ Lambda
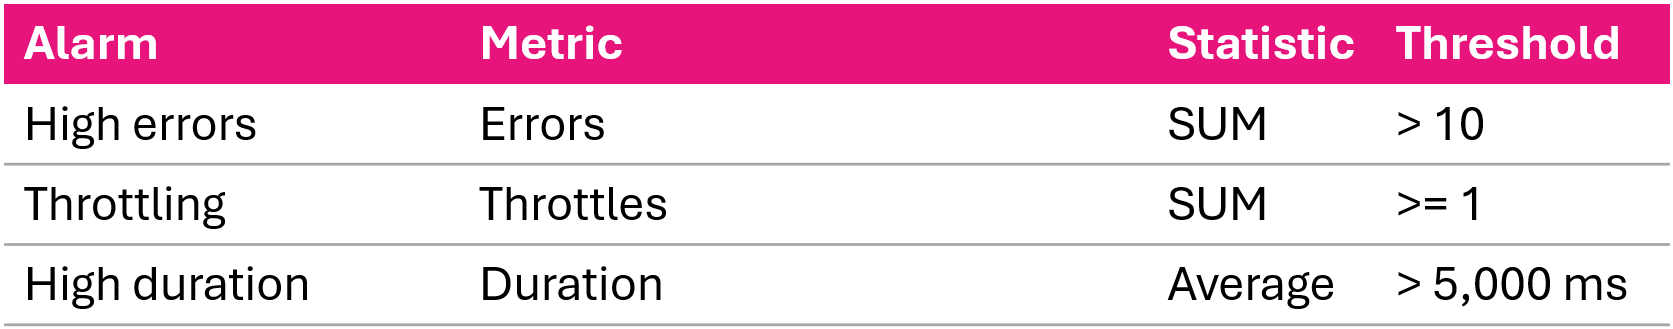
การแจ้งเตือน Lambda ที่แนะนำ ได้แก่ error count throttles และ duration ที่ใกล้ถึง timeout

การแจ้งเตือนสำหรับ ALB

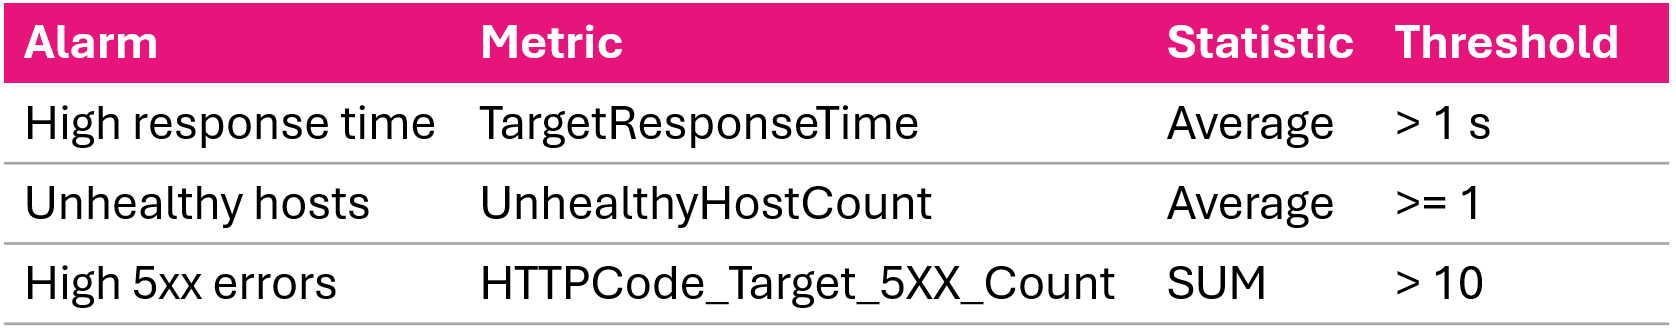
การแจ้งเตือน ALB ที่แนะนำ ได้แก่ target response time unhealthy hosts และ 5xx error counts

การติดตามและแก้ไขปัญหาบน AWS

แนวทางปฏิบัติที่แนะนำสำหรับการจัดการการแจ้งเตือน

  • การตั้งชื่อ: <Service>-<Metric>-<Resource>-<Severity>
  • คำอธิบาย: สิ่งที่ตรวจสอบ ค่าเกณฑ์ คำแนะนำแก้ปัญหา และลิงก์ runbook
  • Tags: Environment, Team, Severity
  • ตรวจสอบทุกเดือน: ปรับค่าเกณฑ์ ลบรายการที่ไม่ใช้ และอัปเดตการดำเนินการ
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
การติดตามและแก้ไขปัญหาบน AWS

สรุปเนื้อหา

  • สถานะการแจ้งเตือน 3 แบบ: OK, ALARM, INSUFFICIENT_DATA
  • กลยุทธ์การประเมิน: consecutive, partial, single breach
  • Composite Alarm รวมหลายการแจ้งเตือนด้วย AND, OR, NOT
  • กลยุทธ์ค่าเกณฑ์ 4 แบบ: statistical, capacity, SLA, rate of change
  • การแจ้งเตือนแบบหลายระดับ: warning → critical → emergency
  • การแจ้งเตือนสำหรับ Lambda (errors, throttles, duration) และ ALB (5xx, latency)
การติดตามและแก้ไขปัญหาบน AWS

มาฝึกกันเถอะ!

การติดตามและแก้ไขปัญหาบน AWS

Preparing Video For Download...