应用健康仪表板

AWS 监控与故障排查

John Q. Martin

Principal Consultant

仪表板设计:信息分层
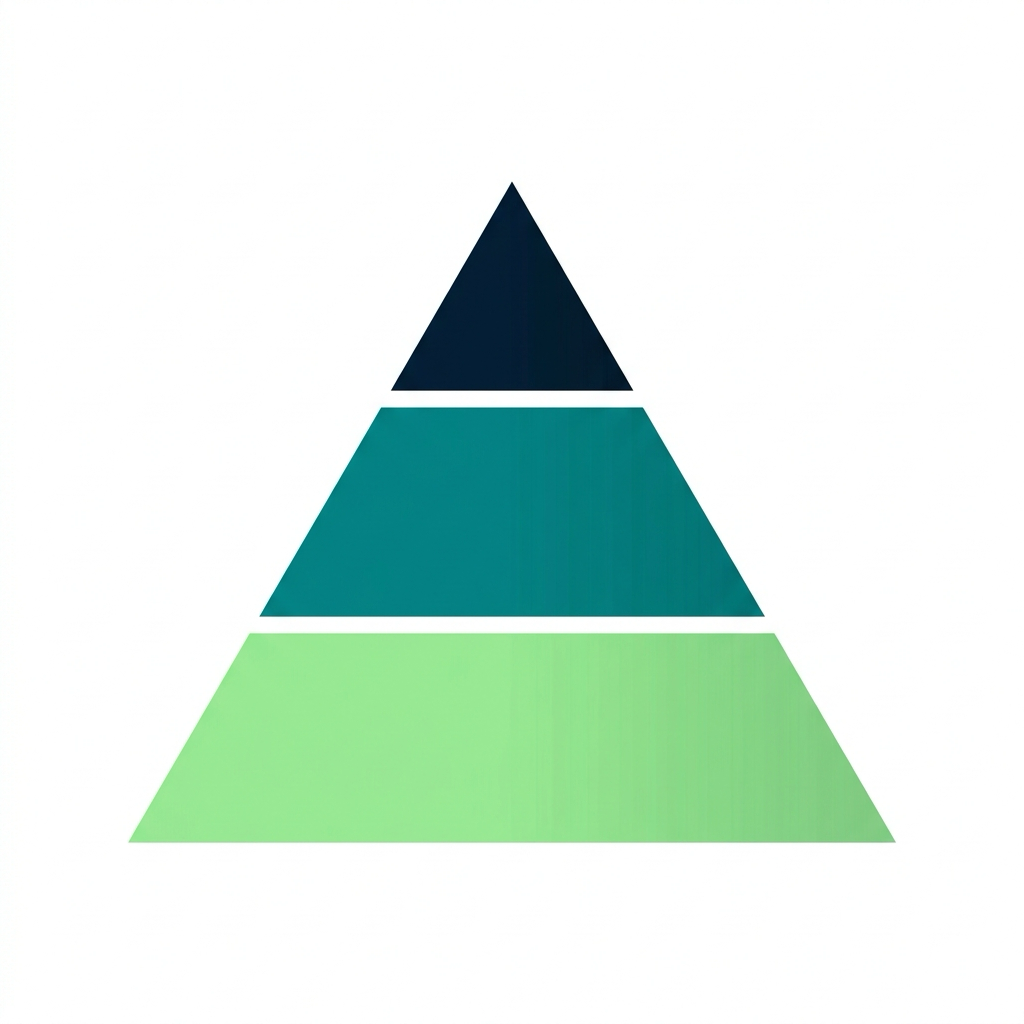
 

三层金字塔:顶部深色窄层,中部青色较宽层,底部绿色最宽层

类似医院:接待 → 病房 → 专家


顶部 - 管理摘要

  • 系统整体健康
  • 关键业务指标、SLA、当前事故

中部 - 服务健康

  • 错误率、延迟分位数、吞吐量

底部 - 详细诊断

  • 跟踪、日志、资源利用、依赖健康
AWS 监控与故障排查

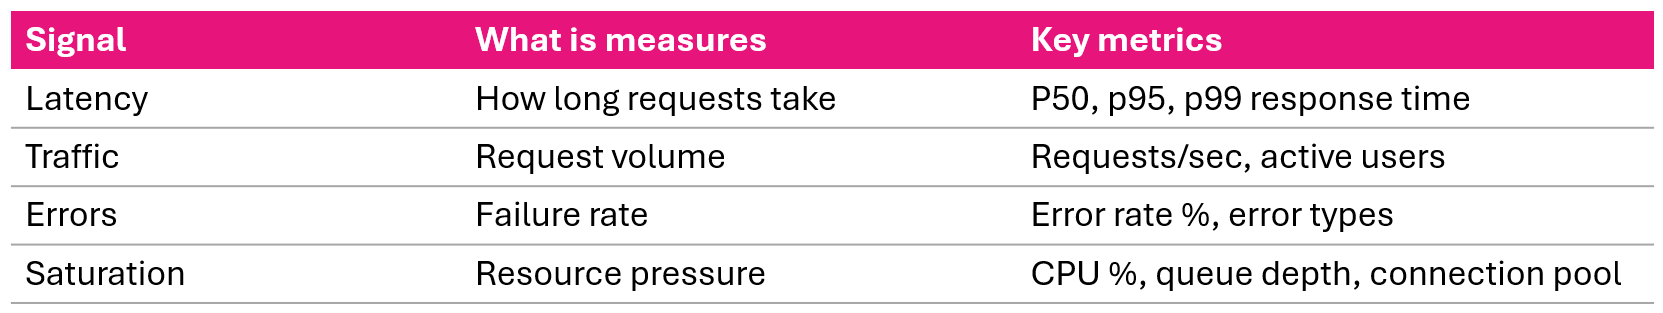
四个黄金信号


监控的四个黄金信号:延迟、流量、错误、饱和度

覆盖这四项,您就能覆盖绝大多数问题。

AWS 监控与故障排查

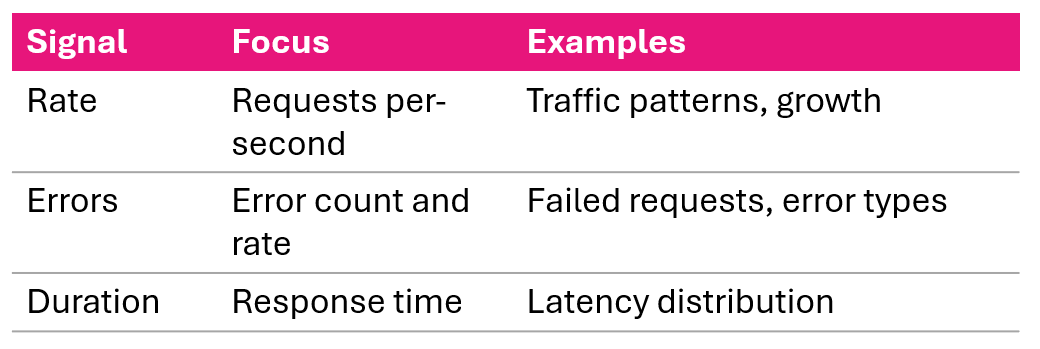
RED 方法


适用于请求驱动服务的 RED:

RED 方法:请求驱动服务的 rate、errors、duration


与黄金信号的关系:

  • RED 是四个黄金信号的聚焦子集
  • 为处理用户请求的服务设计
  • 基础设施监控需补充饱和度(第 4 个黄金信号)

以 RED 为起点,加入饱和度做更深入诊断。

AWS 监控与故障排查

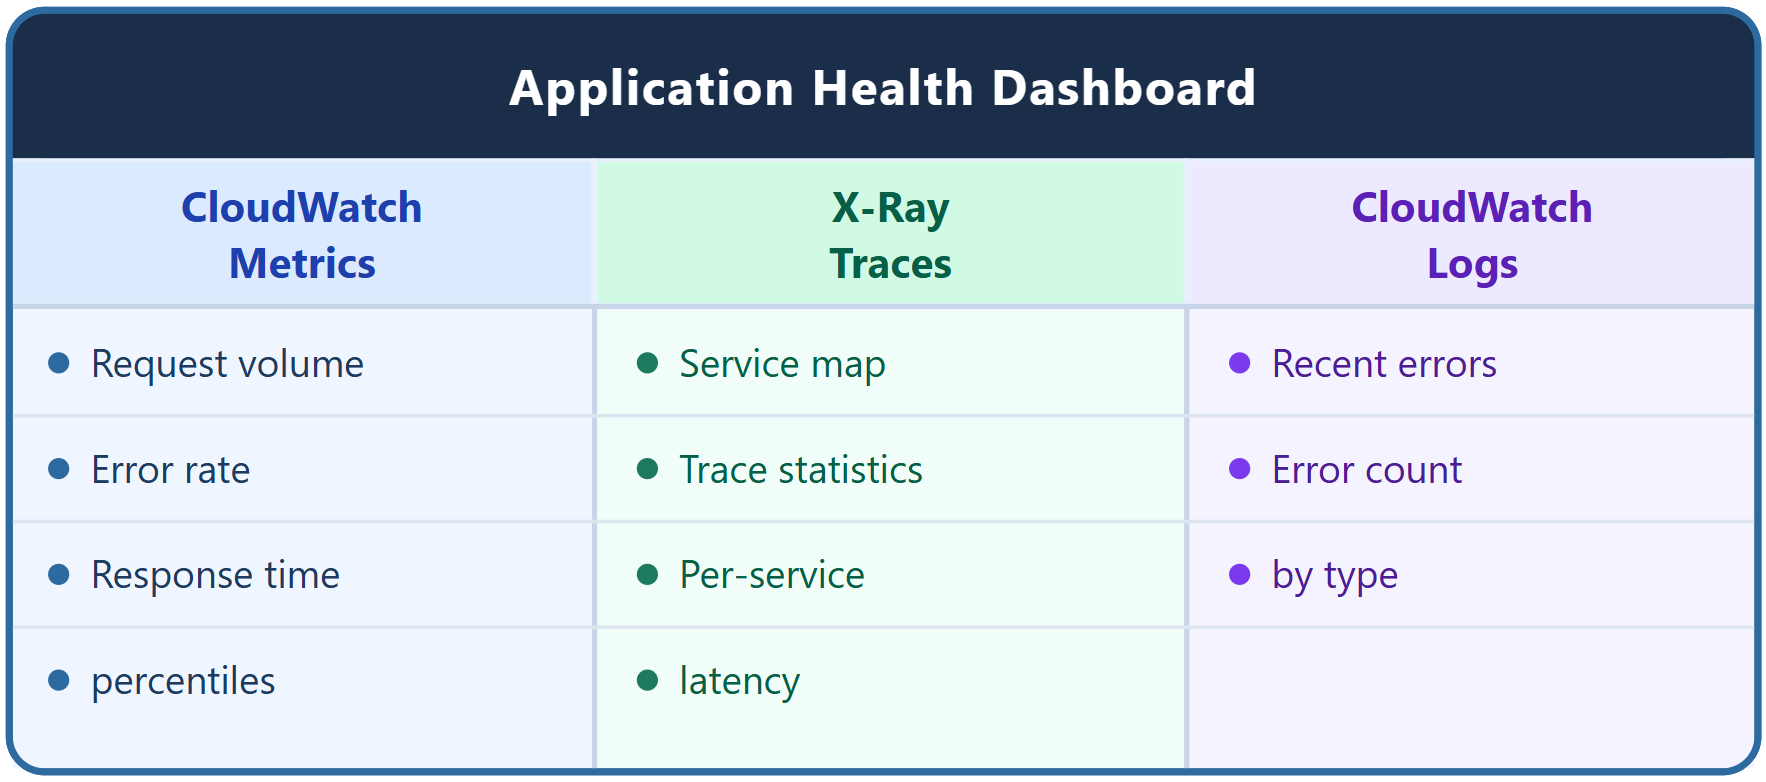
三类数据源


三个仪表板数据源示意图:CloudWatch 指标、X-Ray 跟踪、CloudWatch Logs

AWS 监控与故障排查

CloudWatch 指标组件

请求量:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

错误率(指标数学):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

响应时间分位数:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • 从 ALB 的 RequestCount 获取请求量
  • 错误率用 metric math:errors / invocations × 100
  • 响应时间用 p50、p95、p99 分位数
AWS 监控与故障排查

X-Ray 与日志组件


X-Ray 组件:

  • 服务地图——应用拓扑与健康指示
  • 跟踪统计——平均响应时间、错误率、故障率
  • 服务延迟——各服务响应时间对比


CloudWatch Logs 组件:

最近错误查询:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

按类型统计错误数:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
AWS 监控与故障排查

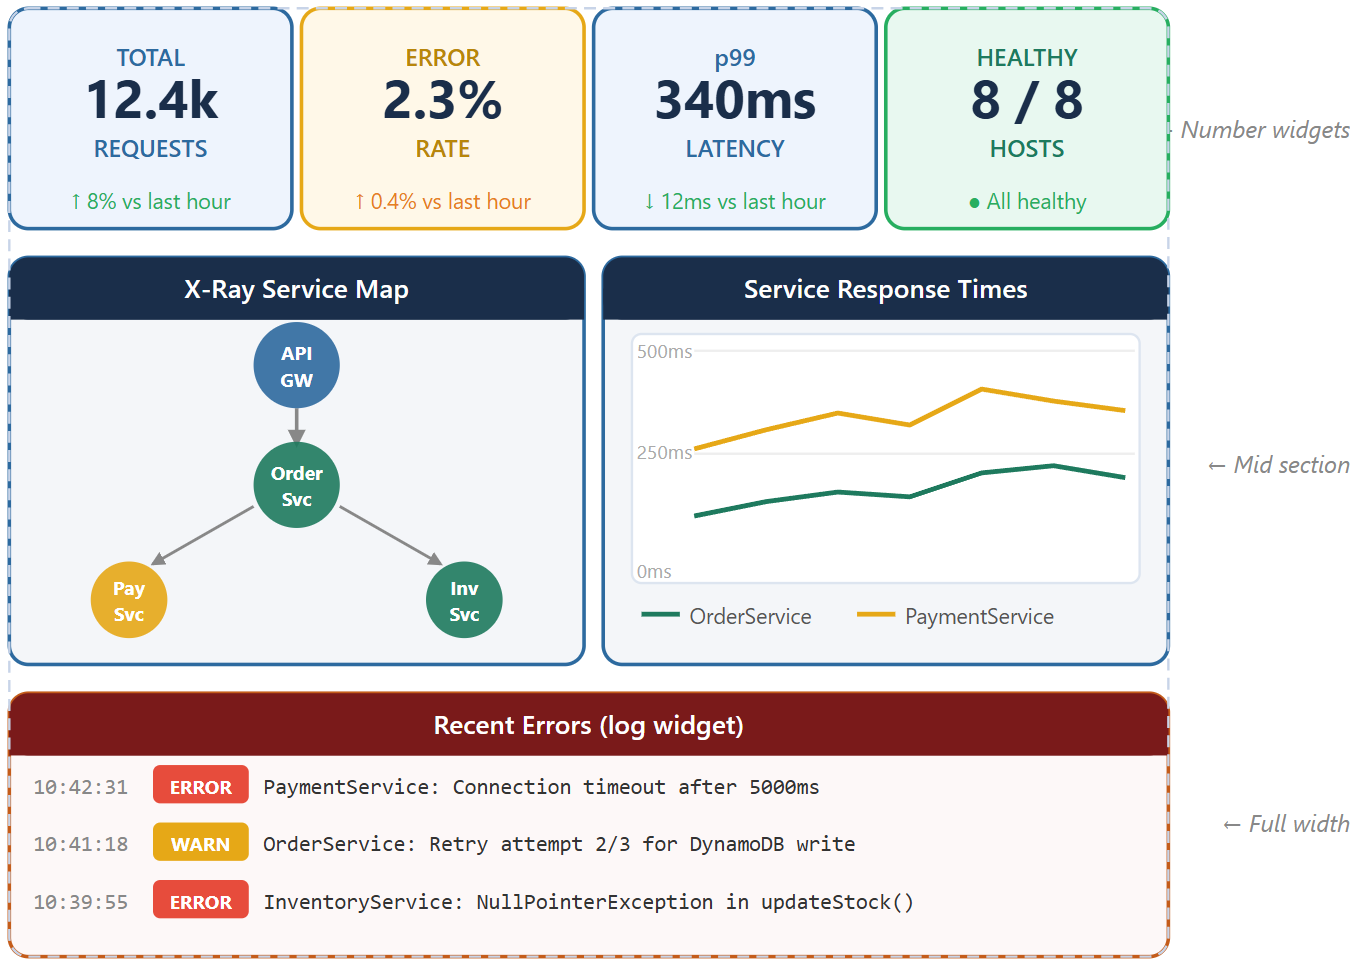
完整仪表板布局


健康仪表板布局:顶部摘要组件,中部服务地图,底部错误日志

AWS 监控与故障排查

事故排障流程


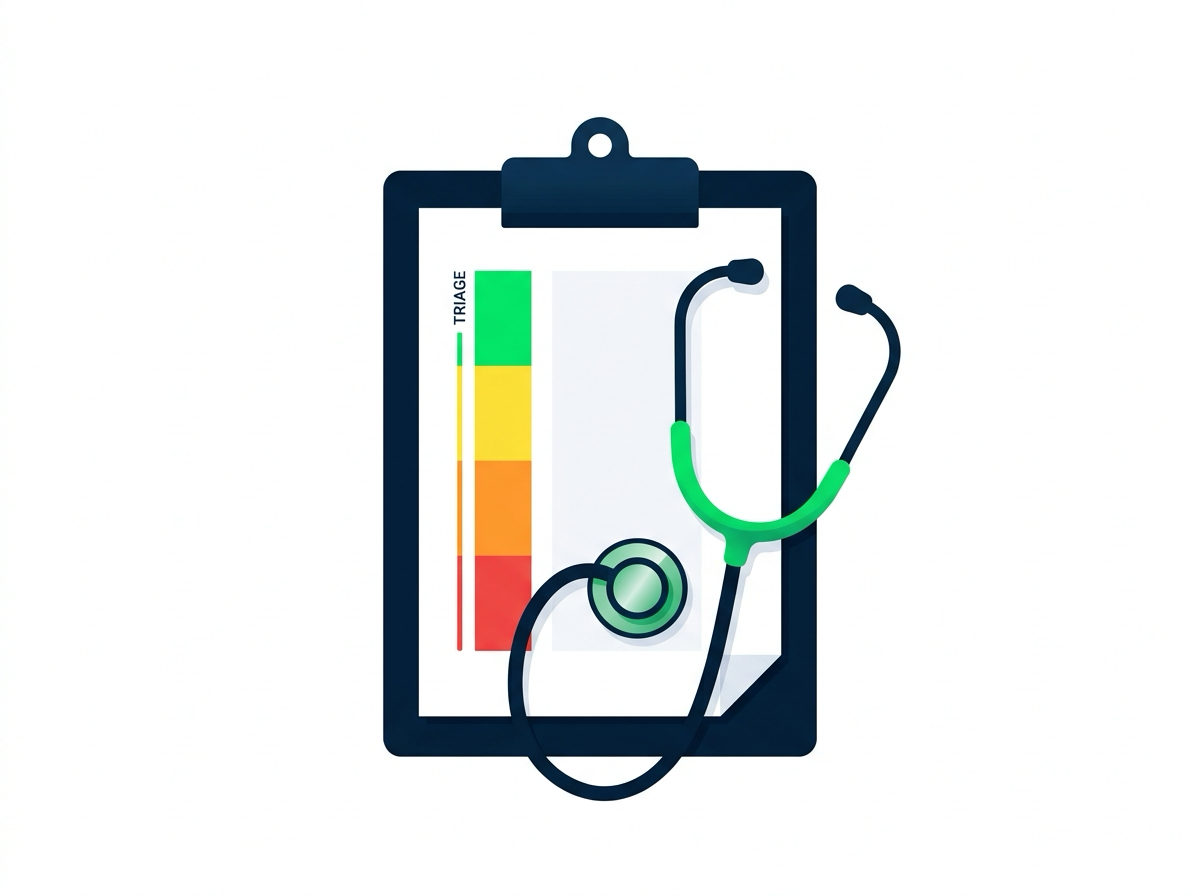
急诊分诊夹板,带彩色优先级条带和听诊器

如同急诊分诊:稳定 → 诊断 → 处置 → 验证

  1. 识别——红/黄指示、错误突增
  2. 界定范围——哪些服务?何时?是否恶化?
  3. 关联——错误+延迟、流量+资源
  4. 下钻——服务地图 → 跟踪 → 日志
  5. 根因——依赖、DB、内存、配置
  6. 修复——熔断、扩容、回滚、故障转移
  7. 验证——错误率恢复、地图转绿、告警清除
AWS 监控与故障排查

场景 1:突发流量激增

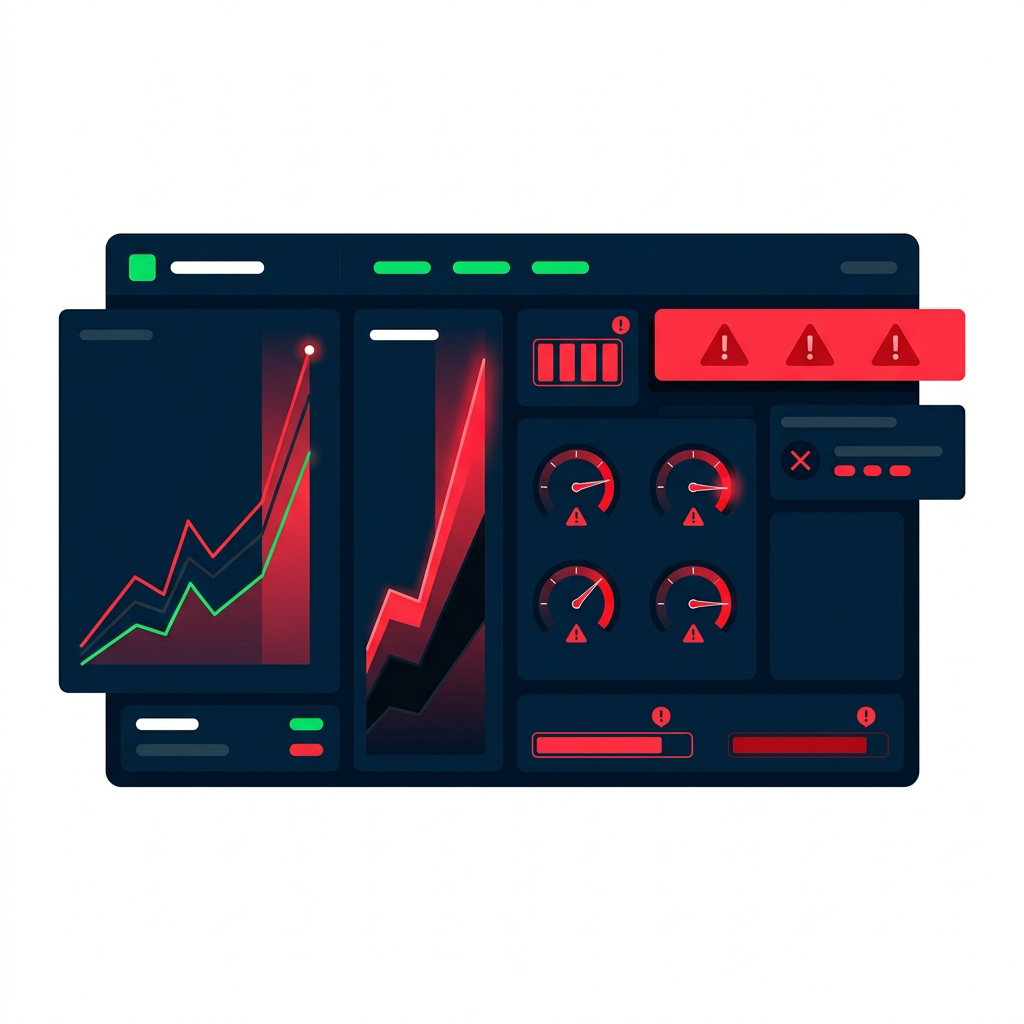
流量激增期间的监控仪表板:折线图急剧上扬、指针打到红区、红色警报横幅

仪表板上可见:

  • 请求量为日常的 10×
  • 错误率 25%
  • 延迟 3000ms
  • CPU 95%

分析:流量激增导致资源过载


行动:

  • 立刻横向扩容
  • 启用自动伸缩
  • 实施限流
  • 增加缓存以减轻后端压力
AWS 监控与故障排查

场景 2:数据库瓶颈

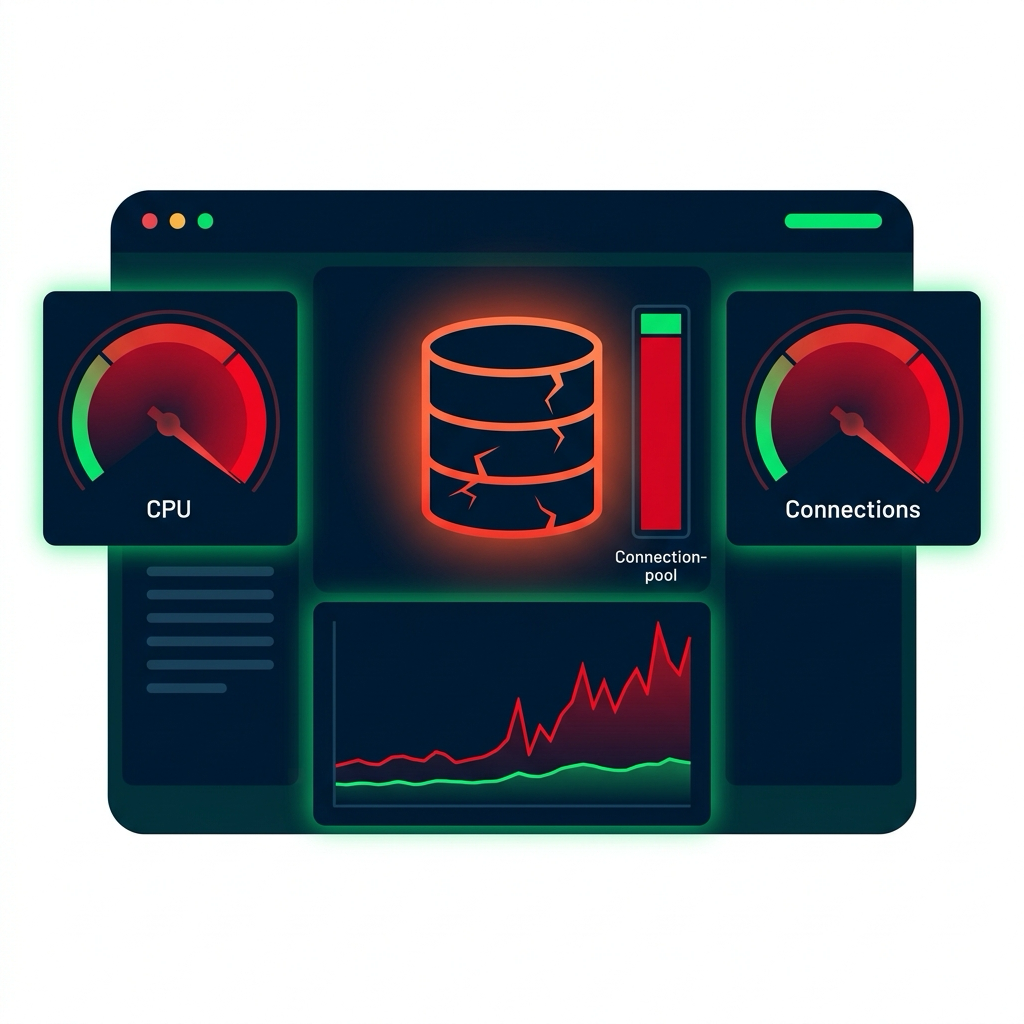
展示数据库瓶颈的监控仪表板:裂开的红色数据库图标,CPU 和连接指针打到红区,查询延迟曲线陡升,连接池条形图几乎满格

仪表板上可见:

  • DB CPU 95%
  • DB 连接数 95/100
  • 查询延迟 5000ms
  • 应用延迟 5500ms

分析:数据库成为瓶颈,慢查询耗尽连接池


行动:

  • 在日志中定位慢查询
  • 添加索引,优化查询
  • 增大连接池
  • 扩展数据库
AWS 监控与故障排查

场景 3:级联故障


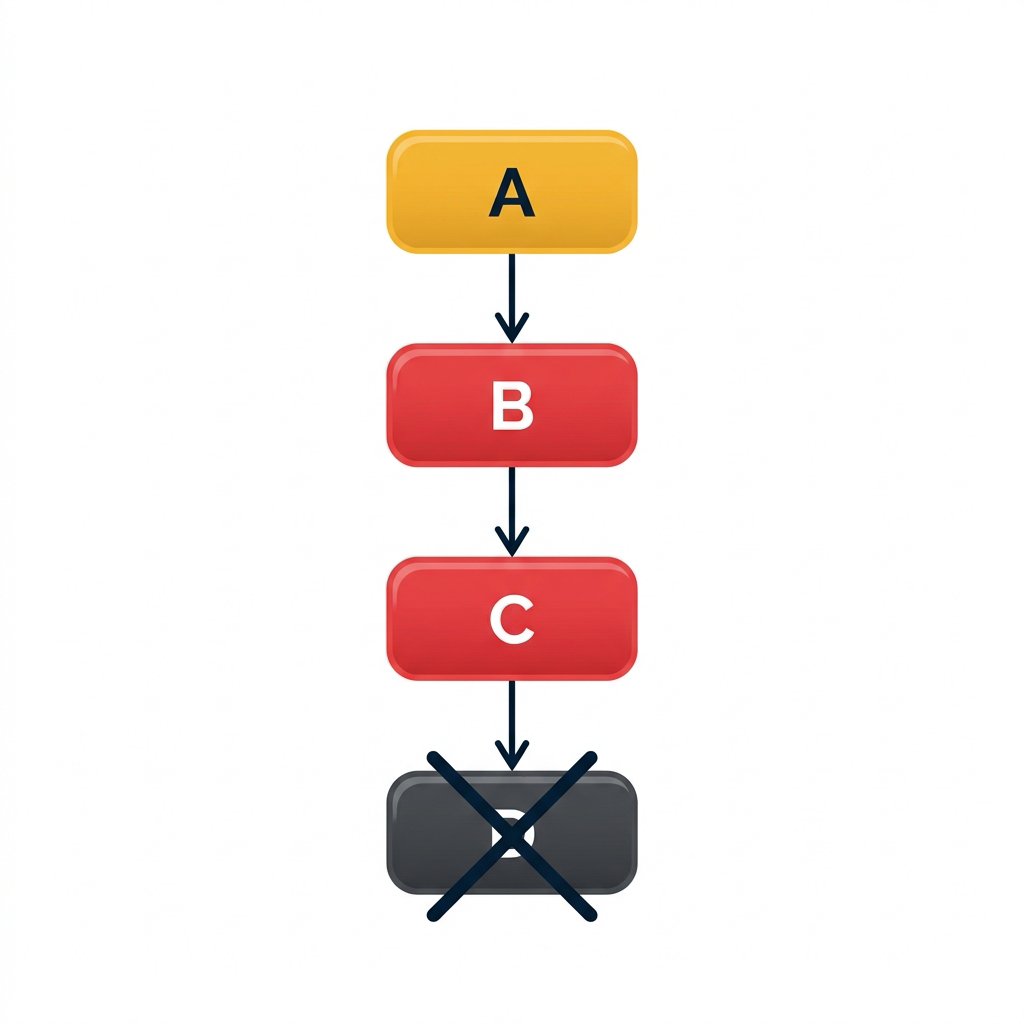
服务地图上可见:

服务地图级联:节点 A 呈琥珀色有客户端错误,B 和 C 为红色服务器故障,D 变暗完全宕机,箭头沿链路向下流动


分析:

服务 A 的小问题沿依赖链级联放大

行动:

  • 使用熔断器阻断级联
  • 各层设置超时
  • 为失败依赖提供降级方案
  • 修复服务 A 的根因
AWS 监控与故障排查

仪表板最佳实践


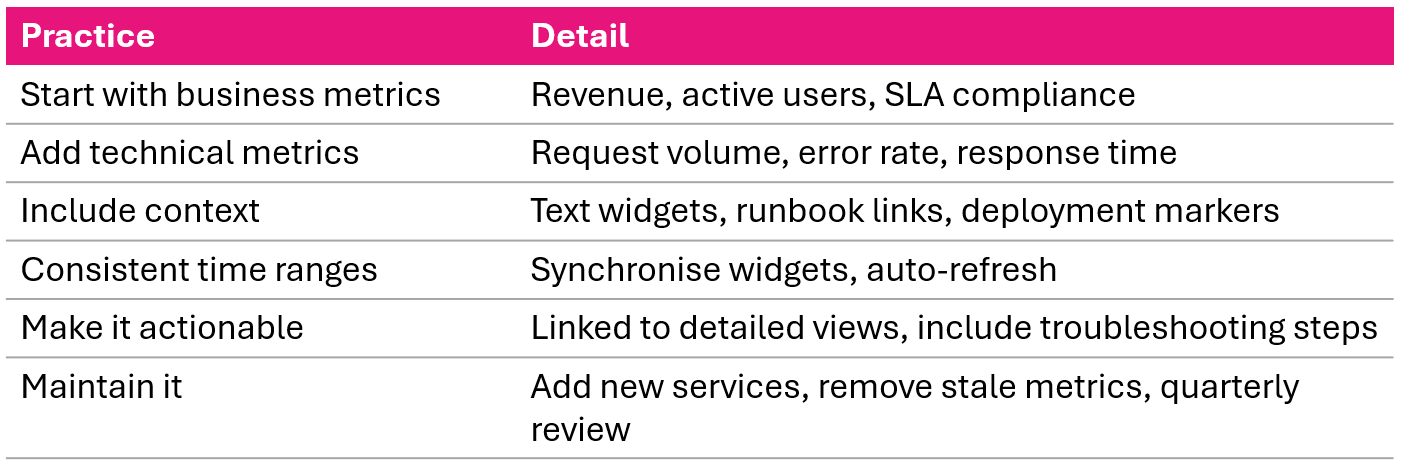
应用健康监控的六条仪表板最佳实践

AWS 监控与故障排查

视频总结与课程完成

  • 以信息分层和四个黄金信号为设计基础
  • 在同一视图中组合 CloudWatch 指标、X-Ray 跟踪与日志
  • 七步事故流程:识别 → 定界 → 关联 → 下钻 → 根因 → 修复 → 验证

您现在可以:

  • 用 CloudWatch 指标、日志和仪表板进行监控
  • 使用 SNS 和 SQS 配置告警与通知
  • 用 X-Ray 实现分布式跟踪
  • 构建应用健康仪表板,提升运维卓越性
AWS 监控与故障排查

应用健康仪表板

AWS 监控与故障排查

Preparing Video For Download...