分析跟踪与服务地图

AWS 监控与故障排查

John Q. Martin

Principal Consultant

什么是服务地图?


由您的跟踪数据自动生成:无需手动设置
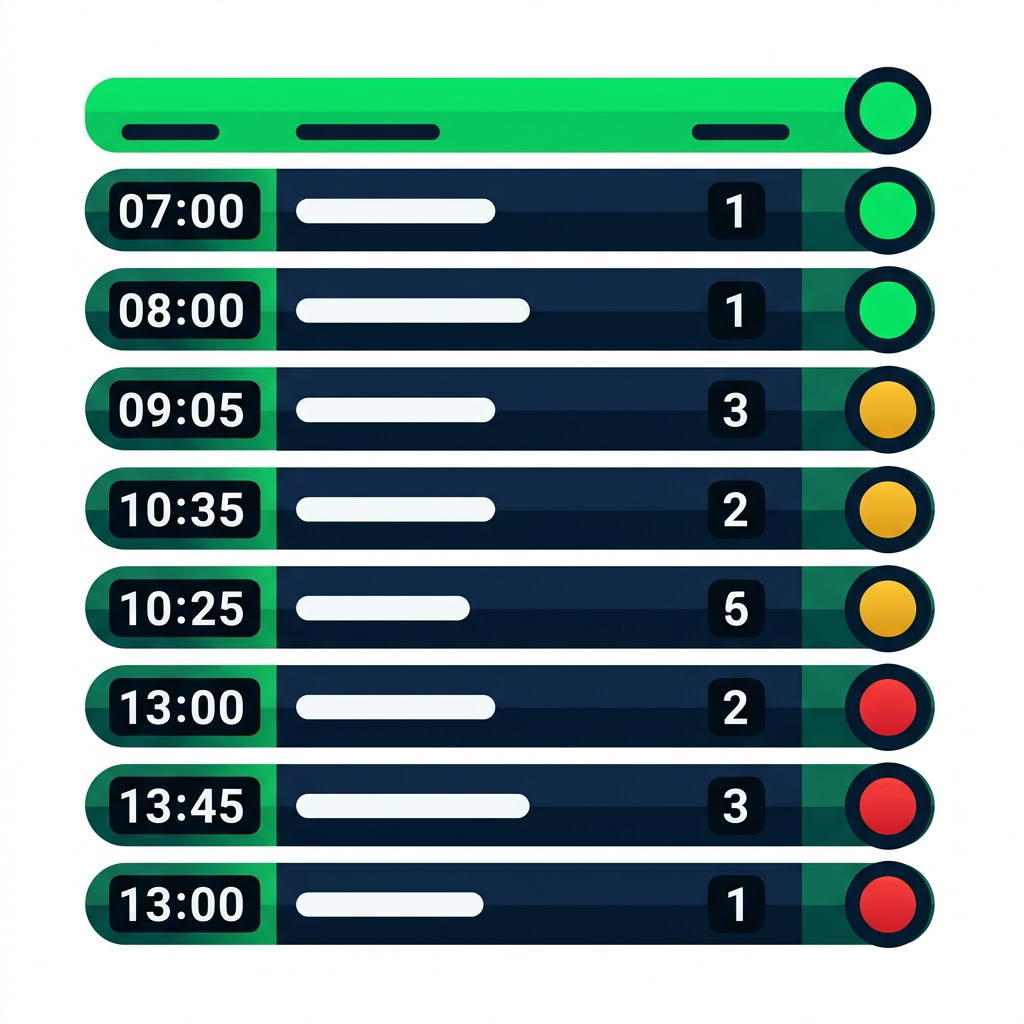
带有多行服务的火车出发牌,每行有彩色状态灯:绿色准点、琥珀色延误、红色停止

一眼看懂:绿色 = 准点 · 琥珀色 = 延误 · 红色 = 停止


访问方式:

  • X-Ray 控制台 → Service map
  • 使用筛选器
  • 点击节点 → 查看详细分解
AWS 监控与故障排查

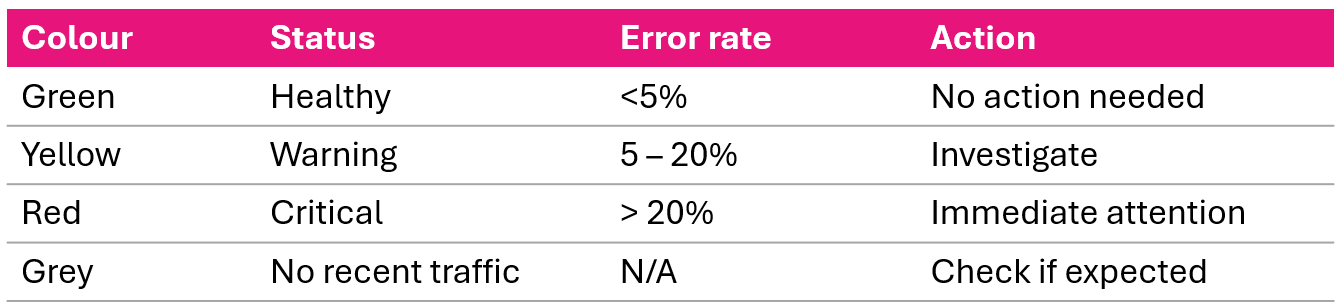
服务地图颜色编码


服务地图颜色编码键:绿色成功调用,黄色客户端错误,红色服务器故障,紫色限流,灰色无流量

打开服务地图时,先看所有不是绿色的部分。

点击任意节点可查看:响应时间分布、HTTP 状态分解、错误类型。

AWS 监控与故障排查

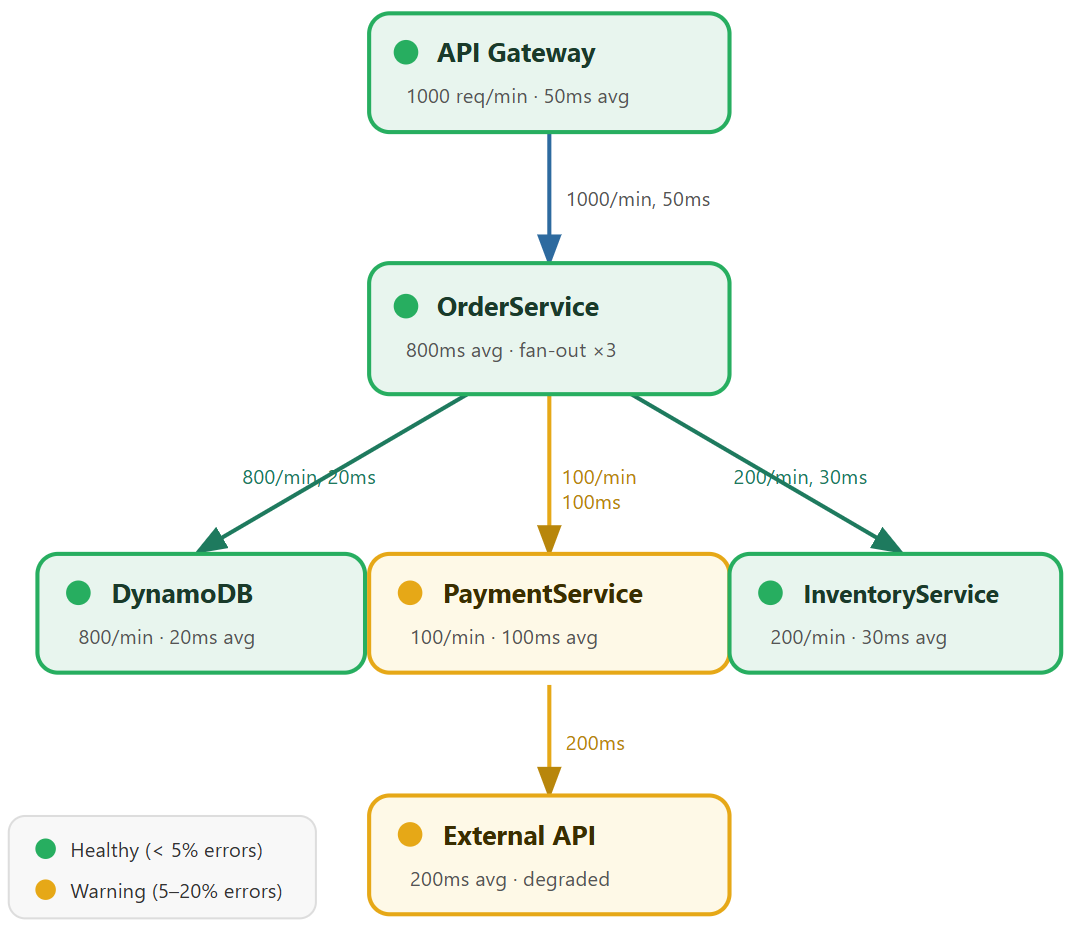
如何阅读服务地图


服务地图:API Gateway 和 OrderService 发散到 DynamoDB Inventory,以及一个黄色的 Payment 服务

AWS 监控与故障排查

关键路径分析


关键路径 = 最长的服务调用链

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total: 400ms

External API = 占总延迟的 50%


如何利用:

  • External API 是您的优化目标
  • 选项:加入缓存、实现超时+回退、协商 SLA

对比另一条路径:

OrderService -> DynamoDB
Total: 120ms (fast)
AWS 监控与故障排查

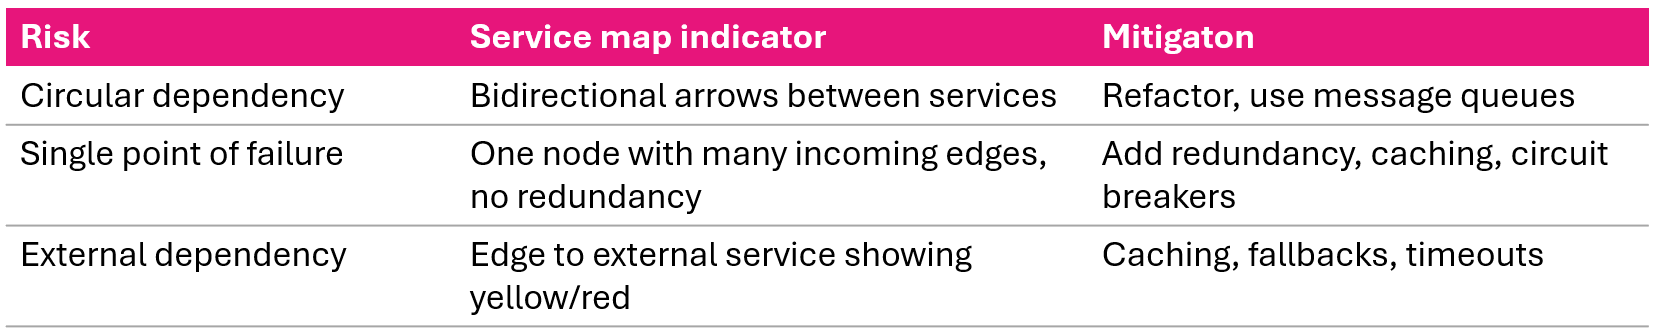
依赖风险


服务地图依赖风险:循环依赖、单点故障和高风险外部依赖

AWS 监控与故障排查

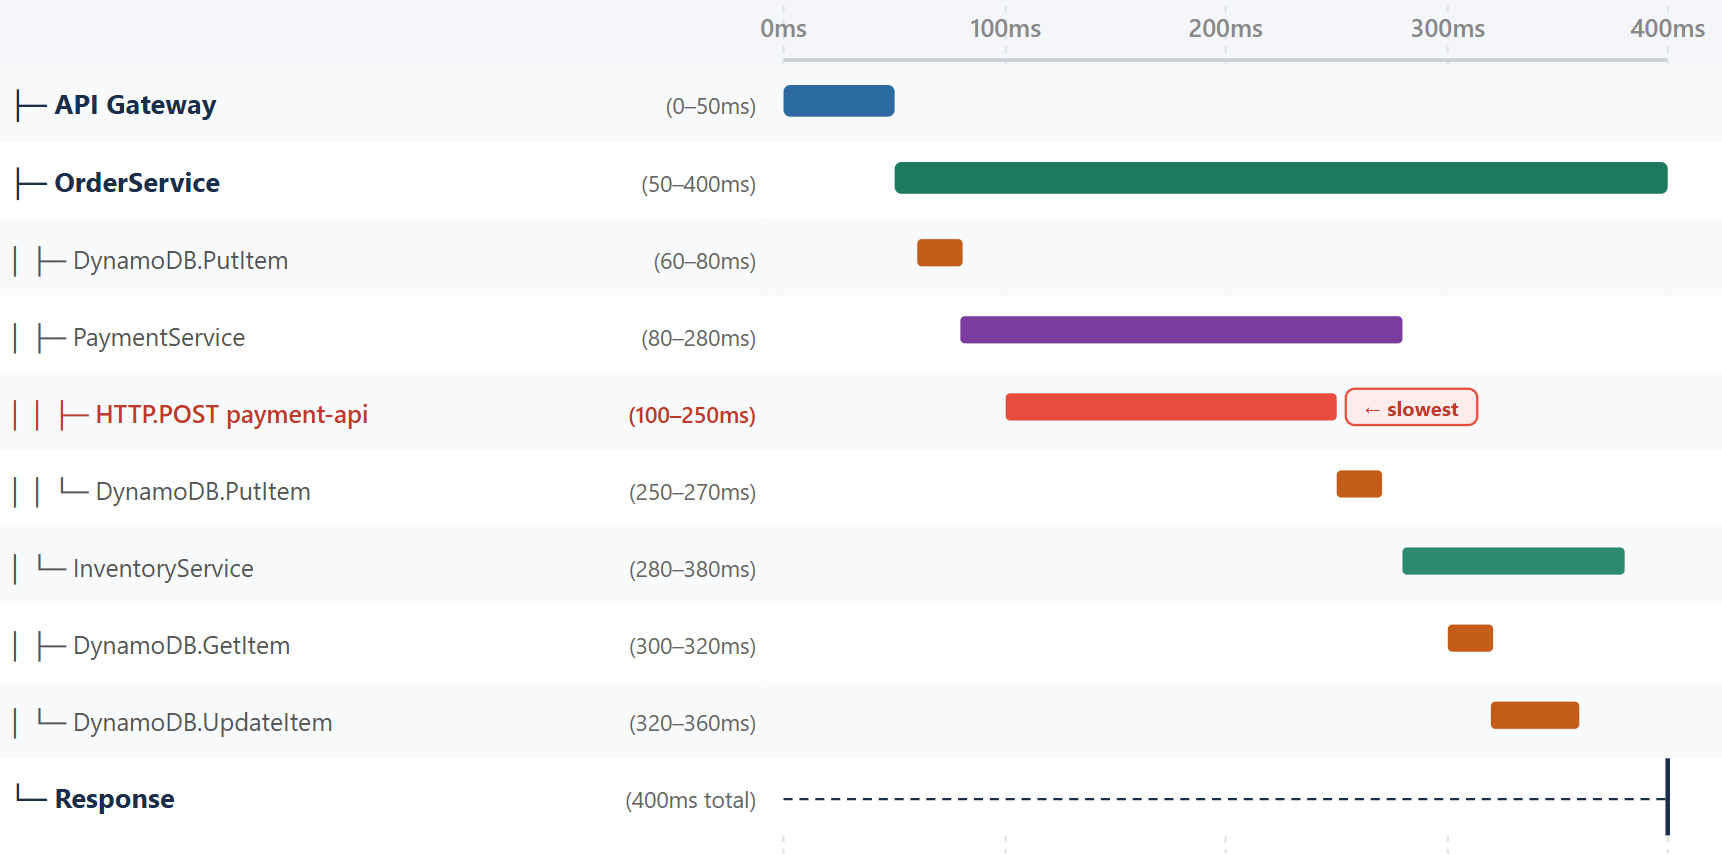
理解跟踪时间线


跟踪时间线:时间轴上带子段,显示 payment-api 调用为最长操作


  • 水平轴 时间:操作开始时间与持续时长
  • 垂直轴 服务层级:子段缩进在父级之下
  • HTTP.POST 到 payment-api (100-250ms) = 单次最长操作
AWS 监控与故障排查

模式 1:串行瓶颈


之前(串行 - 80ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


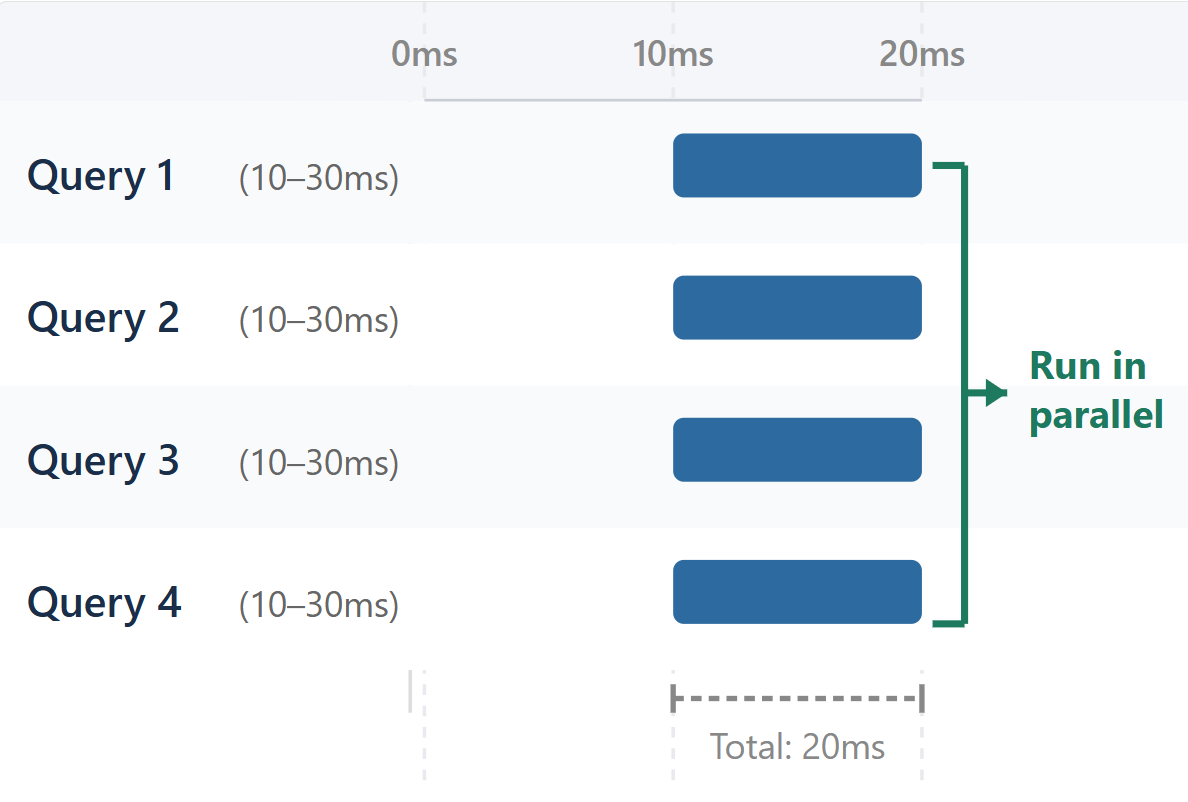
之后(并行 - 20ms):

四个查询并行运行的跟踪时间线,重叠完成于 20ms

AWS 监控与故障排查

模式 2:N+1 查询与啰嗦式服务


N+1 查询问题:

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 sequential queries

修复:批量查询、预加载


啰嗦式服务:

  • 两个服务之间进行 50 次小调用,而非 1 次批量调用
  • 每次调用:连接建立 + 序列化 + 往返
  • 开销放大 50×

修复:批量请求、消息队列、缓存

AWS 监控与故障排查

模式 3:冷启动与级联失败


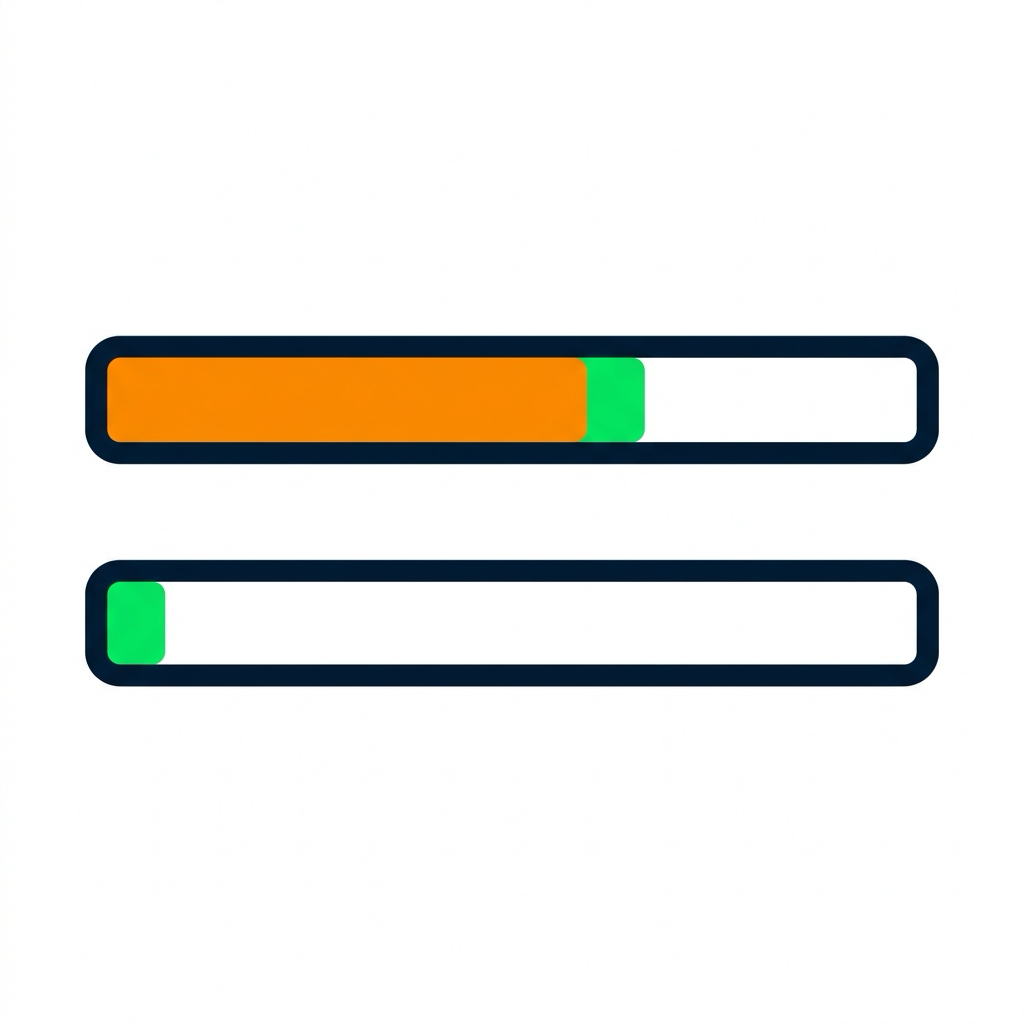
两条时间线:冷启动有较大的橙色初始化块加小的绿色处理器;暖启动仅有小的绿色处理器

Lambda 冷启动:

  • 冷启动:3000ms(2500ms 初始化 + 500ms 处理)
  • 暖启动:500ms(仅处理)
  • 首次调用可见大型初始化片段

修复:预置并发、优化初始化


级联失败:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

匹配的超时块沿跟踪层级逐层堆叠

修复:超时、断路器、回退

AWS 监控与故障排查

用注解筛选跟踪

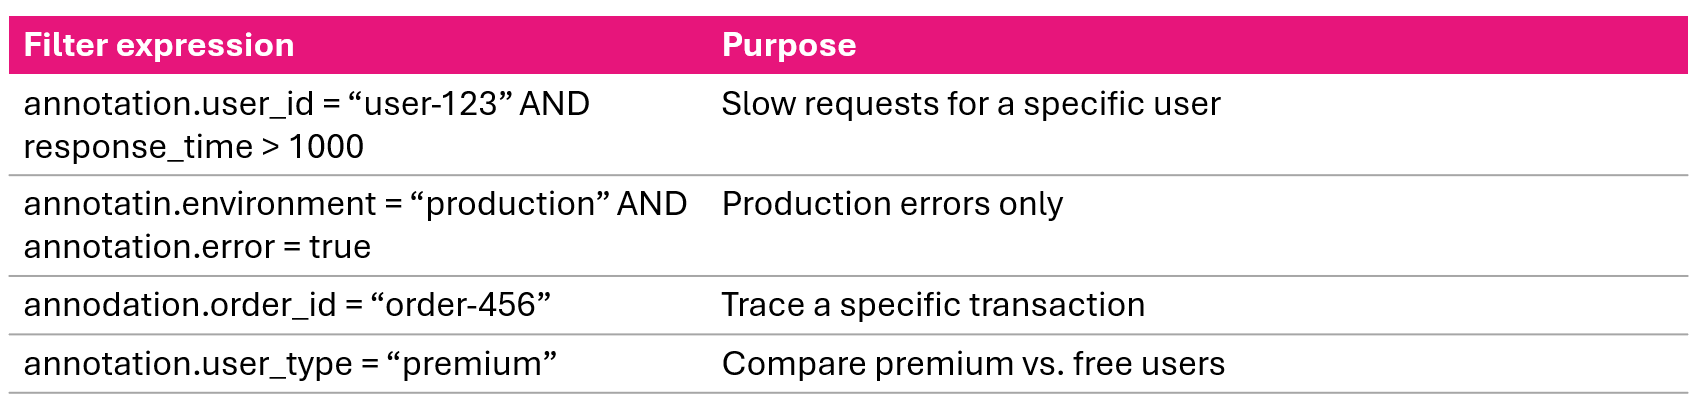
X-Ray 控制台按注解键值对筛选跟踪

对比分组:

  • 付费用户平均 200ms vs. 免费用户平均 150ms → 高级功能带来额外延迟
  • EU West 比 US East 慢 3× → 跨区域数据访问问题
AWS 监控与故障排查

跟踪分析流程


  1. 识别 - 筛选:response_time > 1000ms,按持续时间排序
  2. 分析 - 找出最长操作、串行瓶颈、并行机会
  3. 注解 - 查看业务上下文注解:user ID、order ID、environment
  4. 审查 - 检查元数据:请求详情、错误信息
  5. 关联 - 与 CloudWatch Logs 交叉引用
  6. 诊断 - 根因:慢查询、超时、算法、资源耗尽
  7. 修复 - 优化代码、加缓存、并行化、扩容
  8. 验证 - 对比改前/改后跟踪,监控延迟与错误率
AWS 监控与故障排查

从 X-Ray 数据创建告警


# 高延迟告警
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# 高错误数告警
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
AWS 监控与故障排查

视频总结


  • 服务地图 - 自动生成的架构图:节点(服务)、边(连接)、颜色标注健康度
  • 颜色编码 - 绿色(成功)、黄色(4xx)、红色(5xx 故障)、紫色(429)、灰色(无流量)
  • 关键路径 - 最长调用链,指明优化目标
  • 跟踪时间线 - 揭示串行瓶颈、N+1 查询、冷启动、级联失败
  • 注解 - 按业务上下文筛选与分组跟踪
  • 流程 - 八步:识别 → 分析 → 注解 → 审查 → 关联 → 诊断 → 修复 → 验证
AWS 监控与故障排查

分析跟踪与服务地图

AWS 监控与故障排查

Preparing Video For Download...