Dashboards voor applicatiegezondheid

Monitoring en troubleshooting van AWS

John Q. Martin

Principal Consultant

Dashboardontwerp: informatiehiërarchie
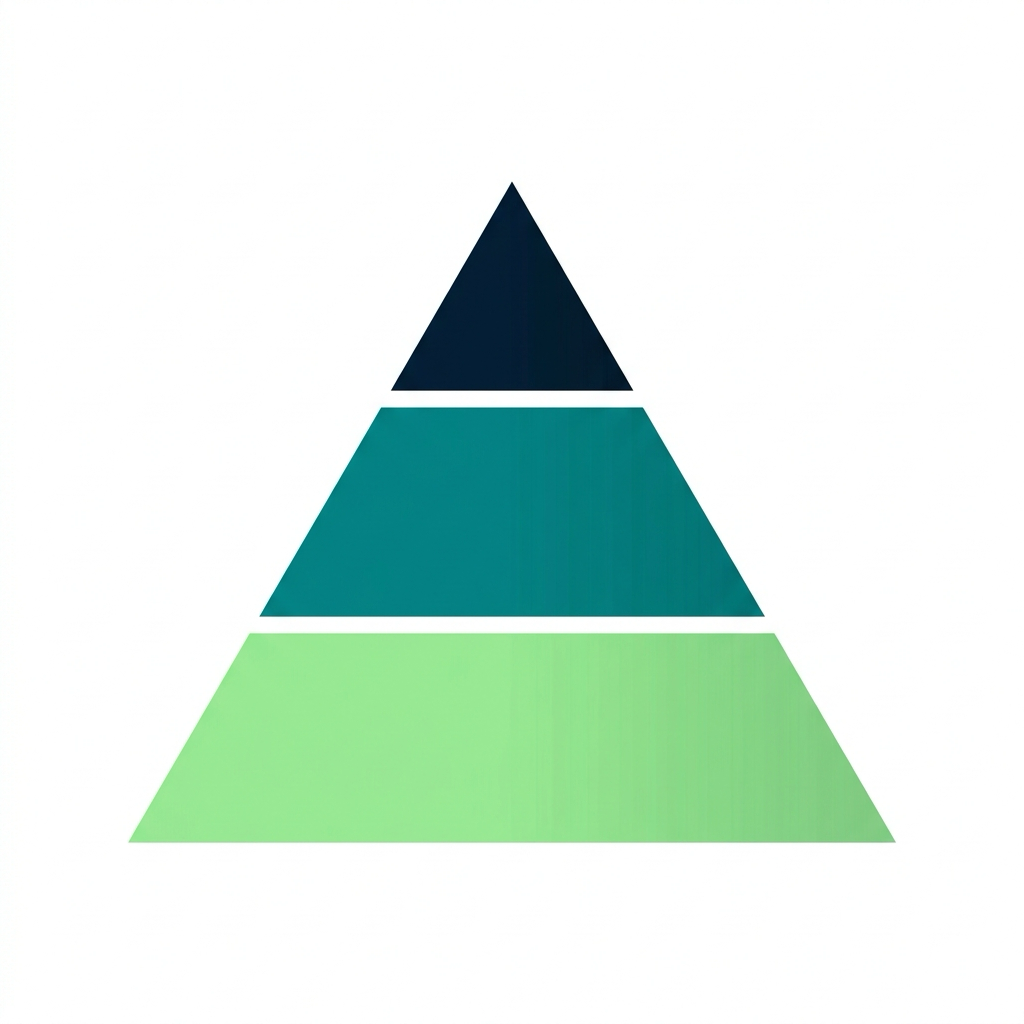
 

Driedelige piramide: smalle donkere top, bredere teal middenlaag en breedste groene basis

.Net als in een ziekenhuis: balie → afdeling → specialist_


Boven - Managementsamenvatting

  • Algemene systeemsituatie
  • Belangrijke businessmetrics, SLA, actuele incidenten

Midden - Servicegezondheid

  • Foutpercentages, latency-percentielen, throughput

Onder - Gedetailleerde diagnostiek

  • Traces, logs, resourcegebruik, afhankelijkheden
Monitoring en troubleshooting van AWS

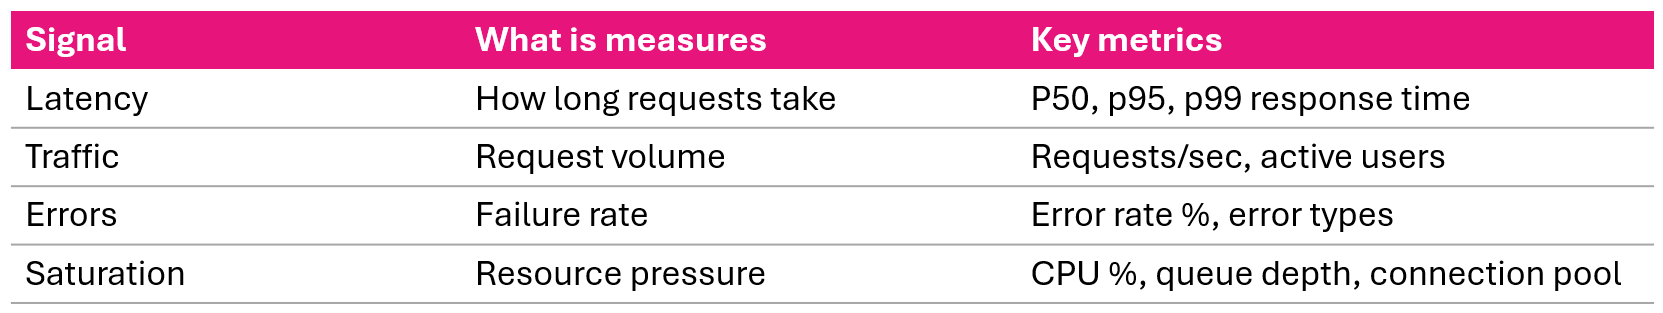
De vier gouden signalen


De vier gouden signalen van monitoring: latency, verkeer, fouten en verzadiging

Als je deze vier dekt, vang je het overgrote deel van de problemen op.

Monitoring en troubleshooting van AWS

De RED-methode


RED voor request-gedreven services:
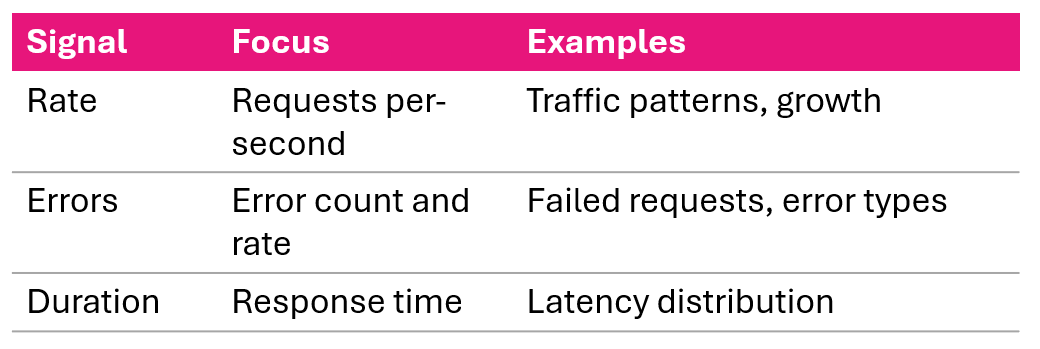
RED-methodepatroon met rate, errors en duration voor request-gedreven services


Relatie met gouden signalen:

  • RED is een gerichte subset van de vier gouden signalen
  • Ontworpen voor services die gebruikersrequests afhandelen
  • Verzadiging (4e gouden signaal) toegevoegd voor infrastructuurmonitoring

Gebruik RED als startpunt en voeg verzadiging toe voor diepere diagnose.

Monitoring en troubleshooting van AWS

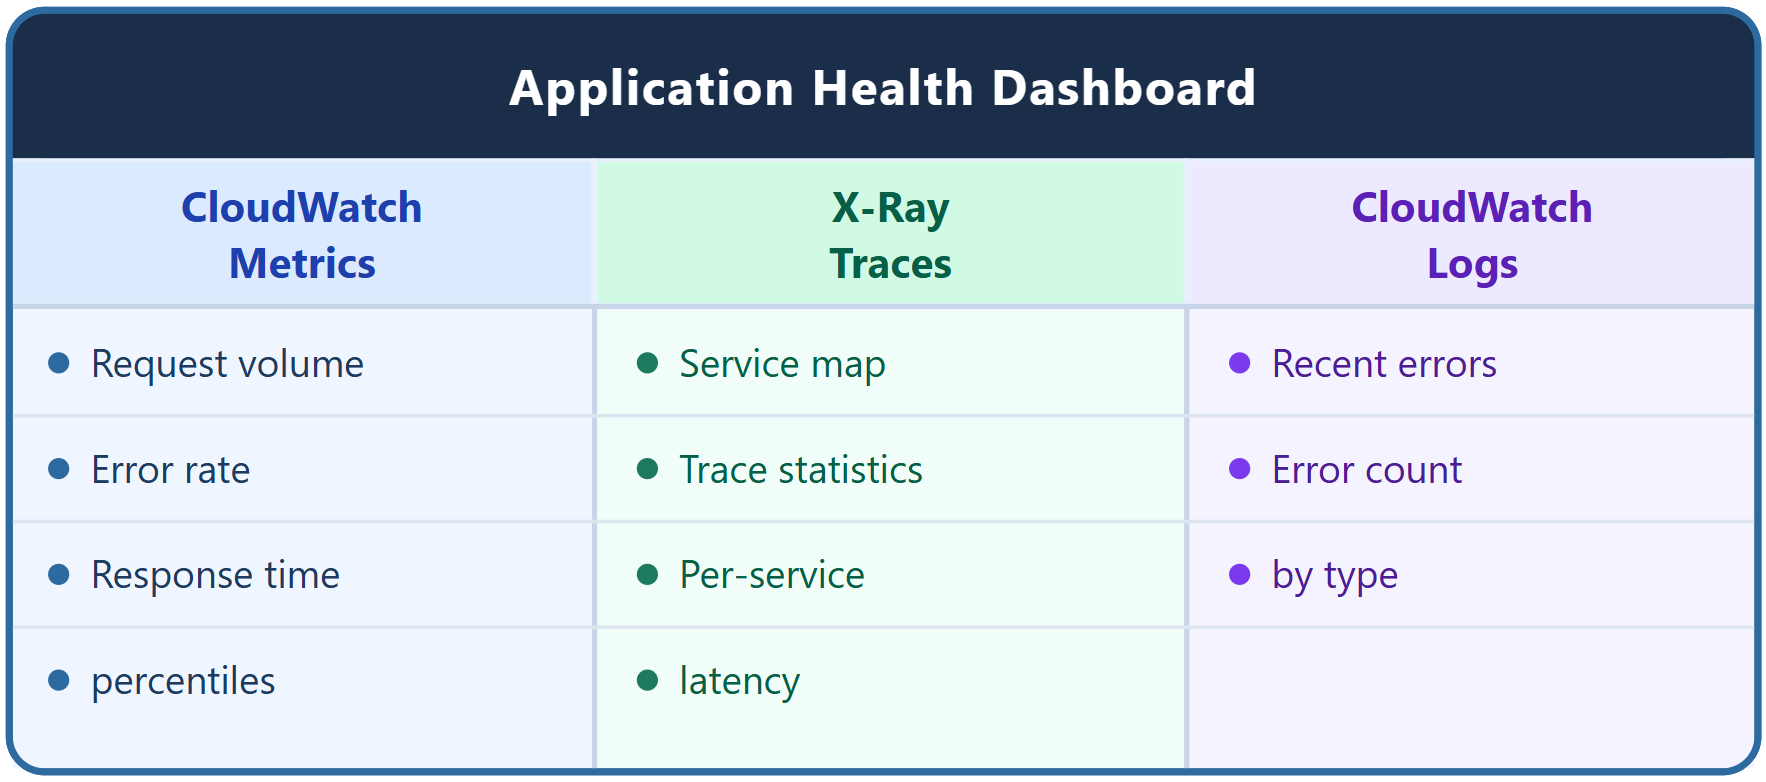
Drie databronnen


Diagram van drie dashboardbronnen: CloudWatch-metrics, X-Ray-traces en CloudWatch Logs

Monitoring en troubleshooting van AWS

CloudWatch-metricwidgets

Aantal requests:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Foutpercentage (metric math):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Responstijd-percentielen:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Aantal requests via ALB RequestCount
  • Foutpercentage gebruikt metric math - errors / invocations x 100
  • Responstijd als p50, p95, p99 percentielen
Monitoring en troubleshooting van AWS

X-Ray- en logwidgets


X-Ray-widgets:

  • Service map - applicatietopologie met gezondheidsindicatoren
  • Trace-statistieken - gemiddelde responstijd, fout- en faalpercentages
  • Servicelatency - vergelijking van responstijden per service


CloudWatch Logs-widgets:

Recente fouten-query:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Fouttellingen per type:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Monitoring en troubleshooting van AWS

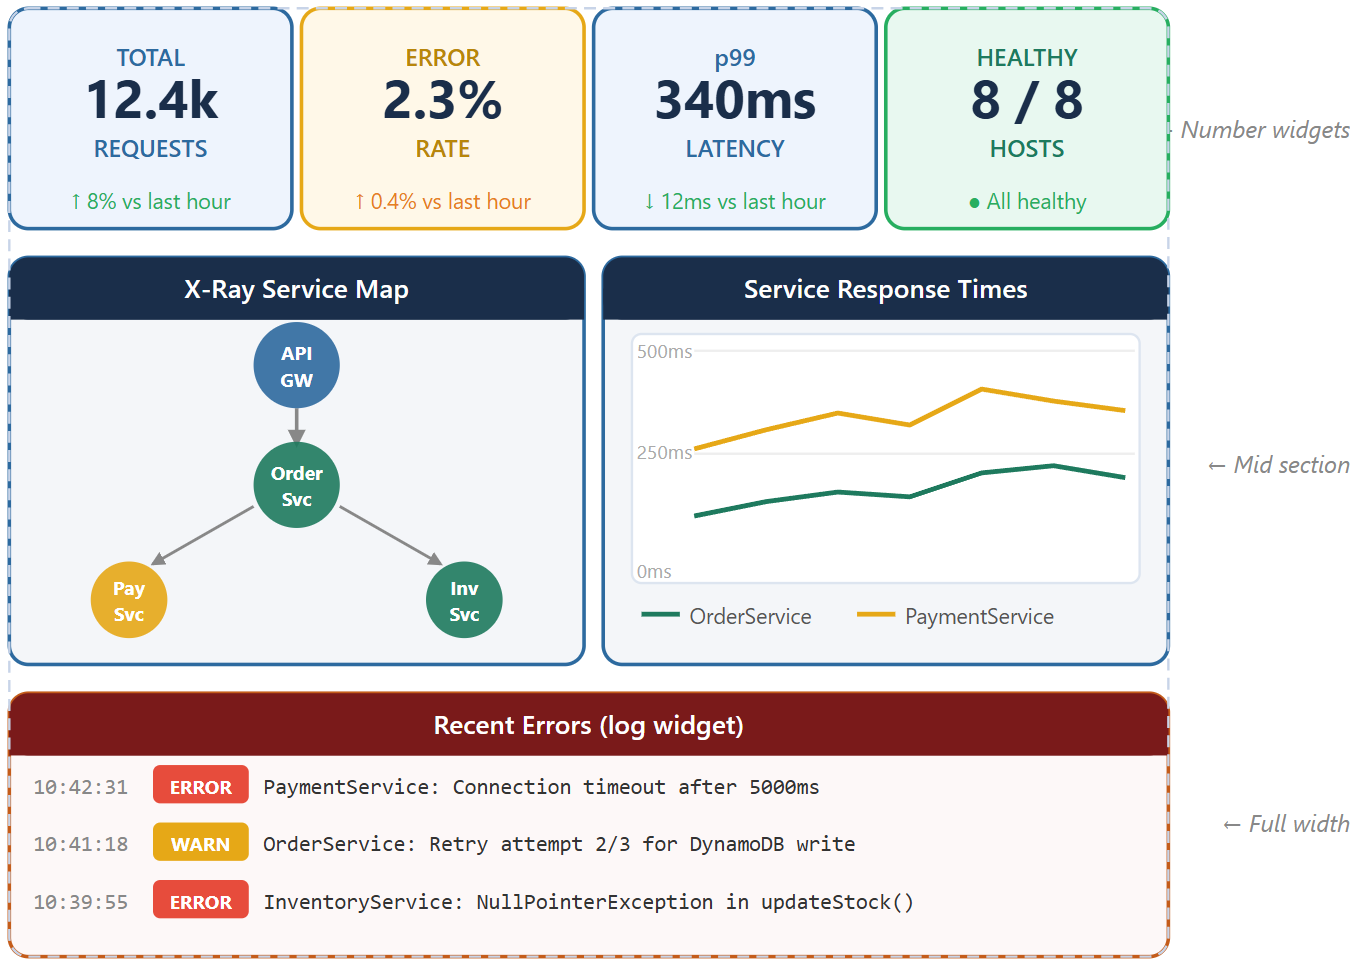
Compleet dashboardontwerp


Layout van gezondheidsdashboard met samenvattingswidgets bovenaan, servicemap in het midden en foutlogs onderaan

Monitoring en troubleshooting van AWS

Workflow voor incidentoplossing


SEH-triage-klembord met gekleurde prioriteitsbanden en een stethoscoop

.Net als SEH-triage: stabiliseren → diagnosticeren → behandelen → verifiëren_

  1. Identificeren - rood/gele indicatoren, foutpieken
  2. Afgrenzen - welke services? wanneer? verslechtert het?
  3. Correlëren - fouten + latency, verkeer + resources
  4. Inzoomen - servicemap → traces → logs
  5. Oorzaak - afhankelijkheid, DB, geheugen, config
  6. Oplossen - circuit breaker, schalen, rollback, failover
  7. Verifiëren - foutpercentage normaal, map groen, alarmen weg
Monitoring en troubleshooting van AWS

Scenario 1: plotselinge verkeerspiek

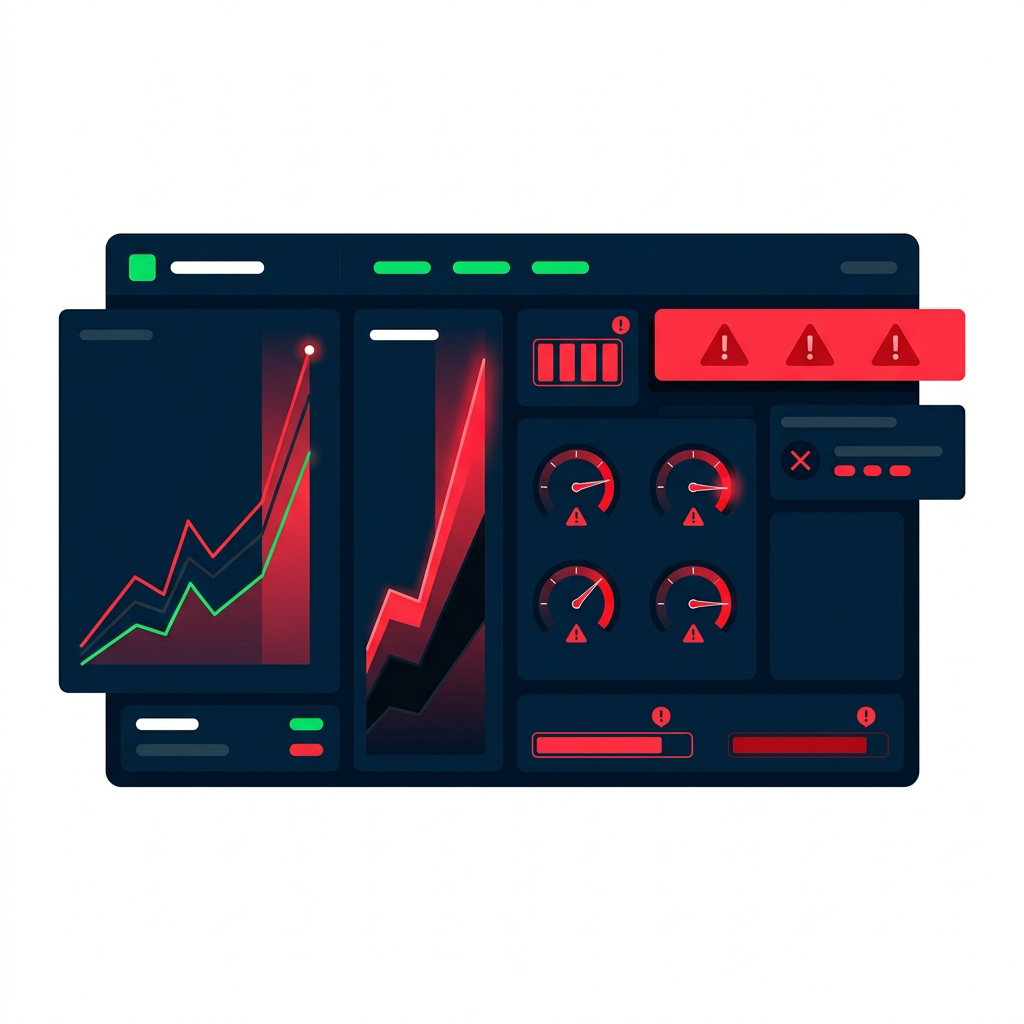
Monitoringdashboard tijdens verkeerspiek: lijngrafieken die pieken, meters in het rood, rode waarschuwingsbanners

Wat je ziet op het dashboard:

  • Aantal requests 10× normaal
  • Foutpercentage 25%
  • Latency 3000 ms
  • CPU 95%

Analyse: Resources worden overspoeld door verkeerspiek


Acties:

  • Meteen opschalen
  • Auto-scaling inschakelen
  • Rate limiting implementeren
  • Caching toevoegen om backend te ontlasten
Monitoring en troubleshooting van AWS

Scenario 2: databaseknelpunt

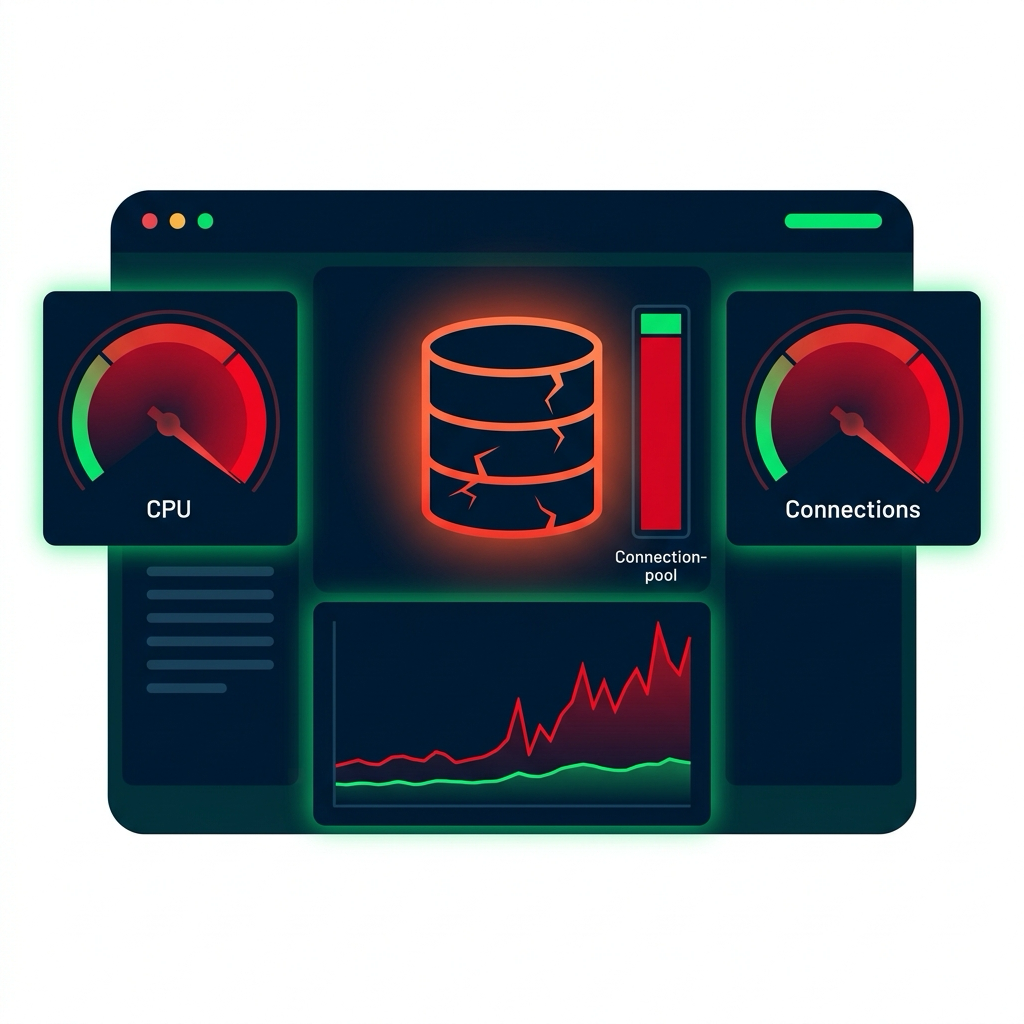
Monitoringdashboard met databaseknelpunt: gebarsten rood database-icoon, CPU- en connectiemeters in het rood, sterk oplopende query-latency, bijna volle connectionpool-balk

Wat je ziet op het dashboard:

  • DB-CPU 95%
  • DB-verbindingen 95/100
  • Query-latency 5000 ms
  • App-latency 5500 ms

Analyse: Database is het knelpunt; trage queries putten de connectionpool uit


Acties:

  • Trage queries in logs identificeren
  • Indexen toevoegen, queries optimaliseren
  • Grootte van de connectionpool verhogen
  • Database opschalen
Monitoring en troubleshooting van AWS

Scenario 3: cascaderende fout


Wat je ziet op de servicemap:
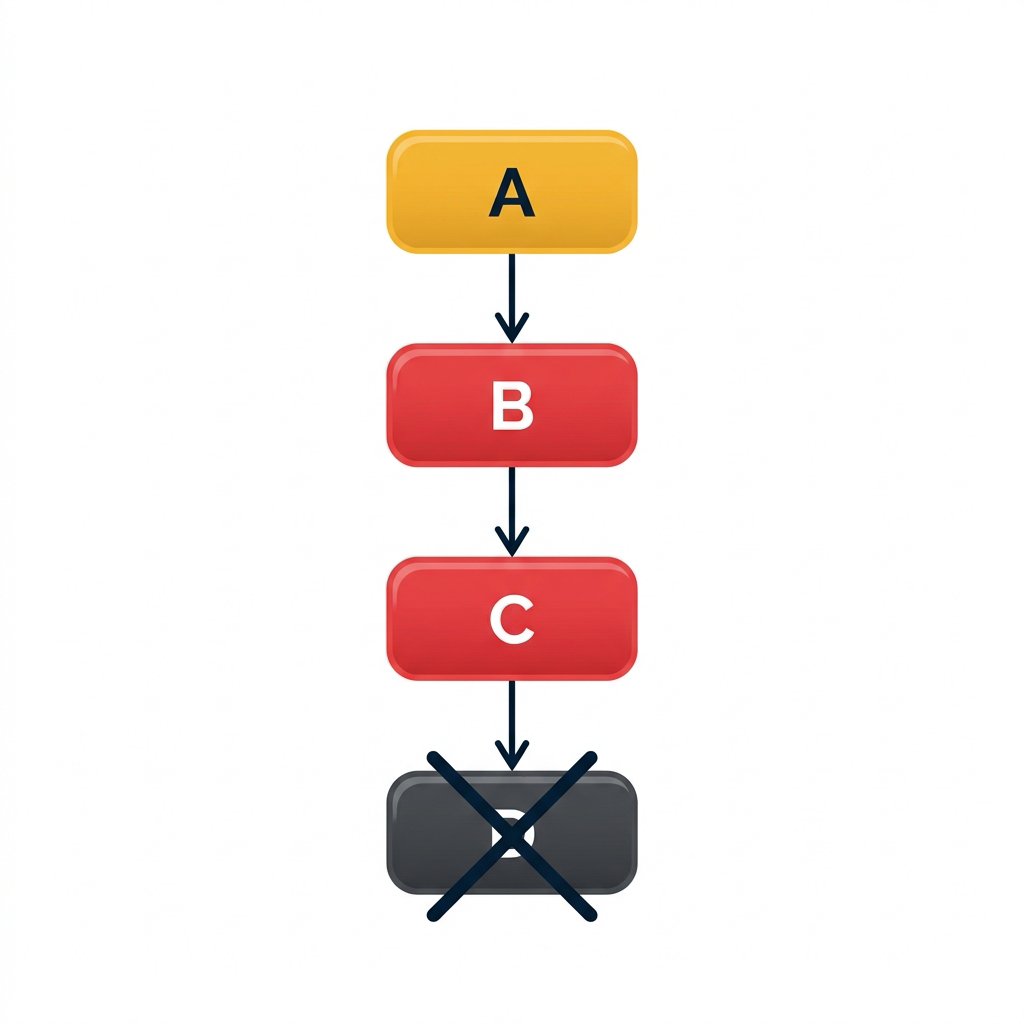
Servicemap-cascade: knooppunt A amber met clientfouten, B en C rood met serverfouten, D donker en volledig uit, pijlen stromen omlaag in de keten


Analyse:

Een klein probleem in Service A is door de afhankelijkheidsketen gecascadeerd

Acties:

  • Circuit breakers om de cascade te stoppen
  • Time-outs op elk serviceniveau
  • Fallbacks voor mislukte afhankelijkheden
  • Basisoorzaak oplossen in Service A
Monitoring en troubleshooting van AWS

Dashboard-best practices


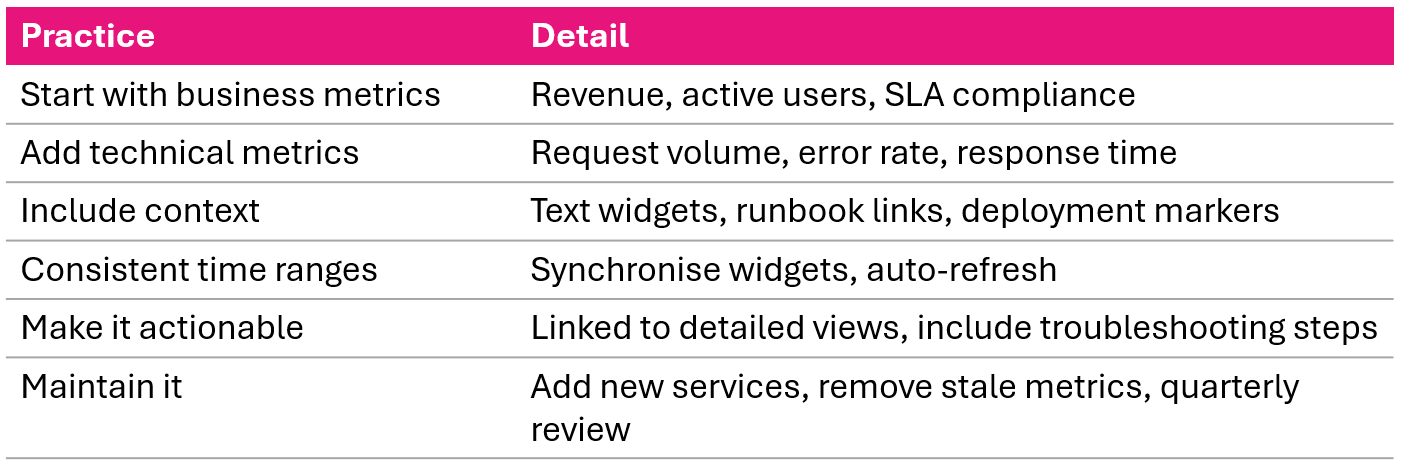
Zes aanbevolen best practices voor dashboards voor applicatiegezondheid

Monitoring en troubleshooting van AWS

Videosamenvatting en cursus voltooid

  • Ontwerp met informatiehiërarchie en de vier gouden signalen
  • Combineer CloudWatch-metrics, X-Ray-traces en logs in één view
  • Zevenstaps incidentworkflow: identificeren → afgrenzen → correleren → inzoomen → oorzaak → oplossen → verifiëren

Je kunt nu:

  • Monitoren met CloudWatch-metrics, logs en dashboards
  • Alarmen en meldingen configureren met SNS en SQS
  • Distributed tracing implementeren met X-Ray
  • Dashboards voor applicatiegezondheid bouwen voor operational excellence
Monitoring en troubleshooting van AWS

Dashboards voor applicatiegezondheid

Monitoring en troubleshooting van AWS

Preparing Video For Download...