CloudWatch-alarms en meldingen

Monitoring en troubleshooting van AWS

John Q. Martin

Principal Consultant

Wat zijn CloudWatch Alarms
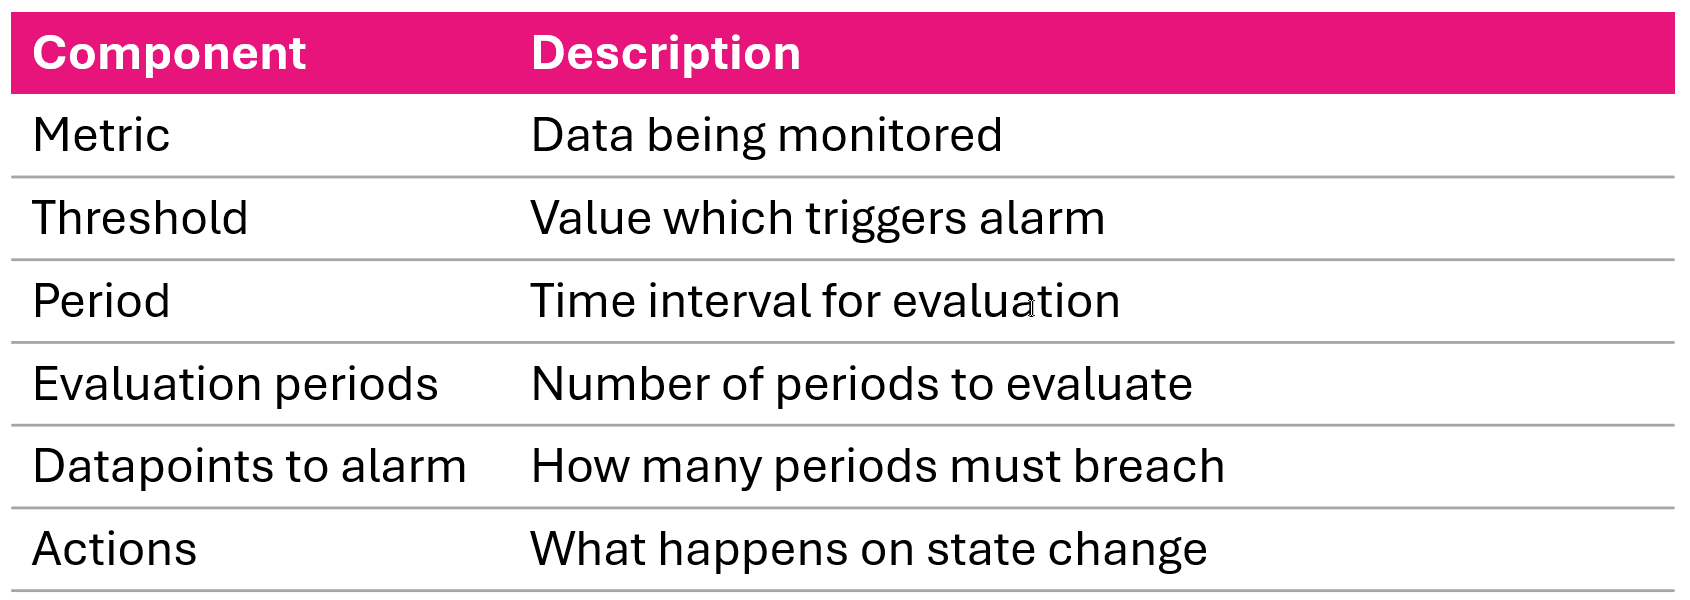
 

Kernbegrippen

  • Houdt één metriek bij over een periode
  • Voert acties uit als de metriek een drempel overschrijdt


Zes kernonderdelen van een CloudWatch-alarm: metriek, drempel, periode, evaluatieperioden, datapoints-to-alarm en acties

Monitoring en troubleshooting van AWS

Alarmtoestanden

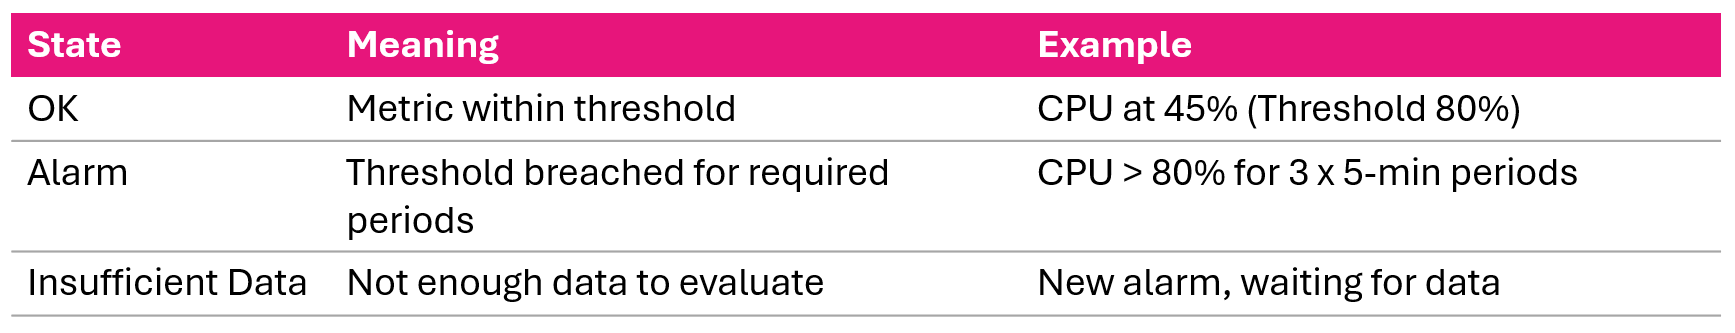
De drie alarmtoestanden van CloudWatch: OK, ALARM en INSUFFICIENT_DATA

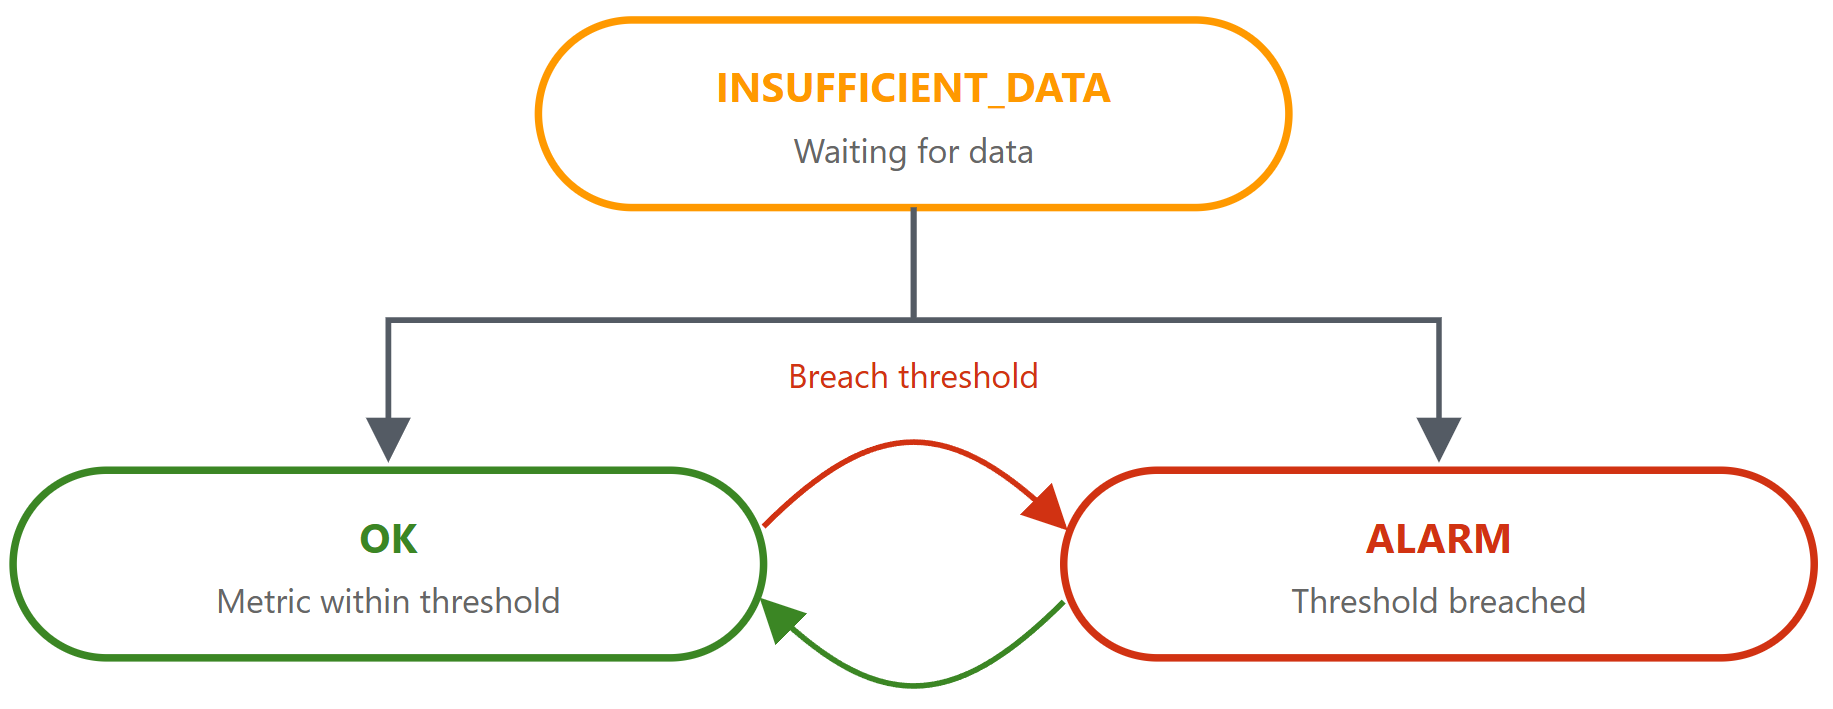
Diagram van hoe een CloudWatch-alarm tussen toestanden wisselt wanneer metriekdata binnenkomt

Monitoring en troubleshooting van AWS

Alarmevaluatie


  1. Verzamel datapunten op vaste intervallen
  2. Pas statistiek toe (Average, Sum, Max, Min) over de periode
  3. Vergelijk resultaat met de drempel
  4. Tel overschrijdende evaluatieperioden
  5. Verander toestand als datapoints-to-alarm is gehaald


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Monitoring en troubleshooting van AWS

Evaluatiestrategieën


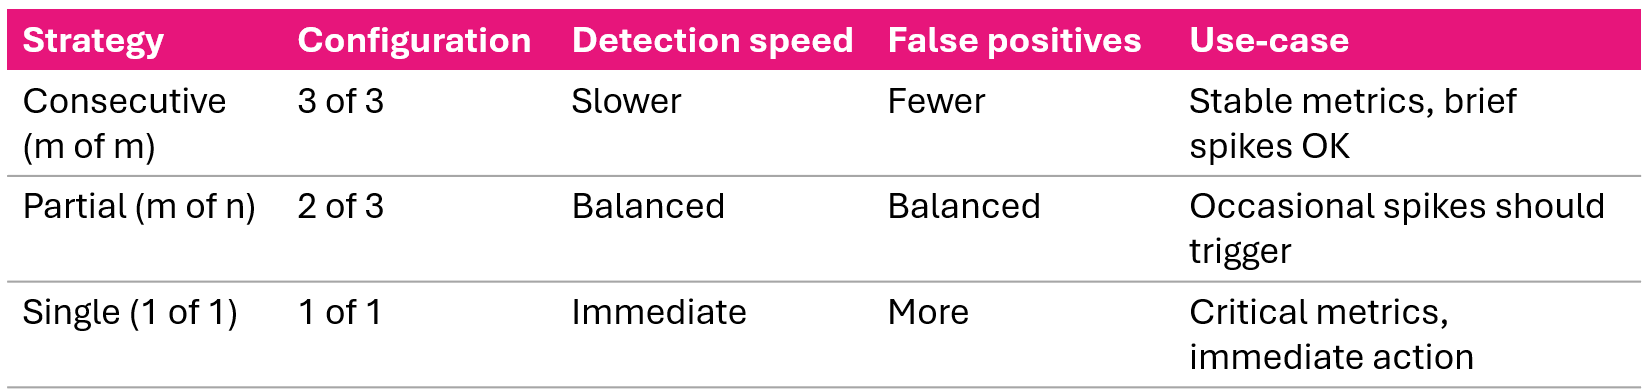
Drie evaluatiestrategieën: opeenvolgend, gedeeltelijk en enkele overschrijding met hun gevoeligheidsafwegingen

Monitoring en troubleshooting van AWS

Alarmacties: typen en triggers


Actietriggers

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Actietypen

  • SNS-melding
  • Auto Scaling
  • EC2-actie (stop/terminate/reboot/recover)
  • Systems Manager
Monitoring en troubleshooting van AWS

Gedrag bij ontbrekende data


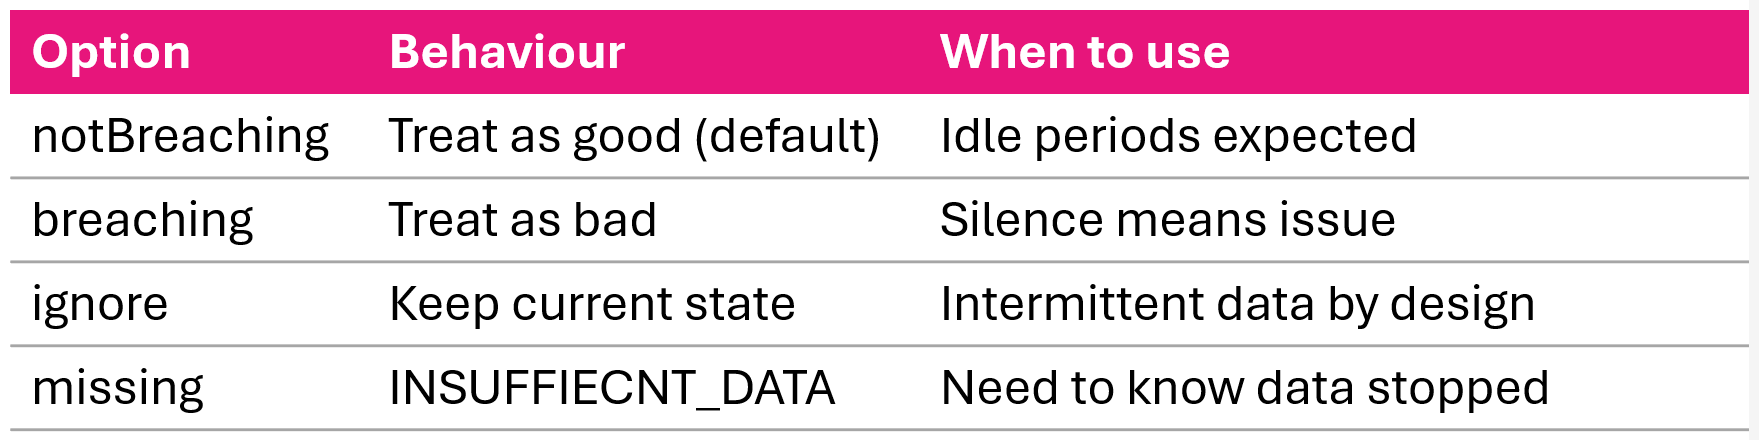
Opties voor gedrag bij ontbrekende data: notBreaching, breaching, ignore en missing

Monitoring en troubleshooting van AWS

Een standaardalarm maken: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Monitoring en troubleshooting van AWS

Composite alarms: wat en waarom

Probleem

  • Meerdere verwante alarms gaan los van elkaar af = alert-moeheid

Oplossing

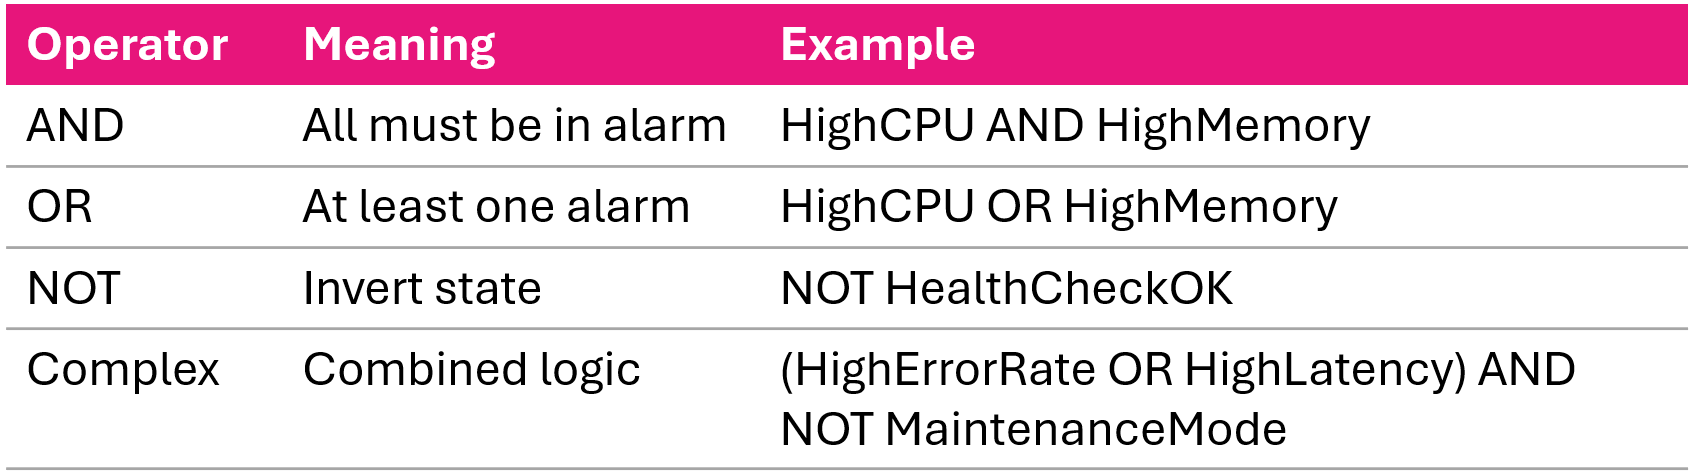
  • Combineer alarms met logische operatoren

Samenstelling van composite-alarmlogica met AND-, OR- en NOT-operatoren

Monitoring en troubleshooting van AWS

Composite alarm maken: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Voorbeeld van een complexe regel
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Monitoring en troubleshooting van AWS

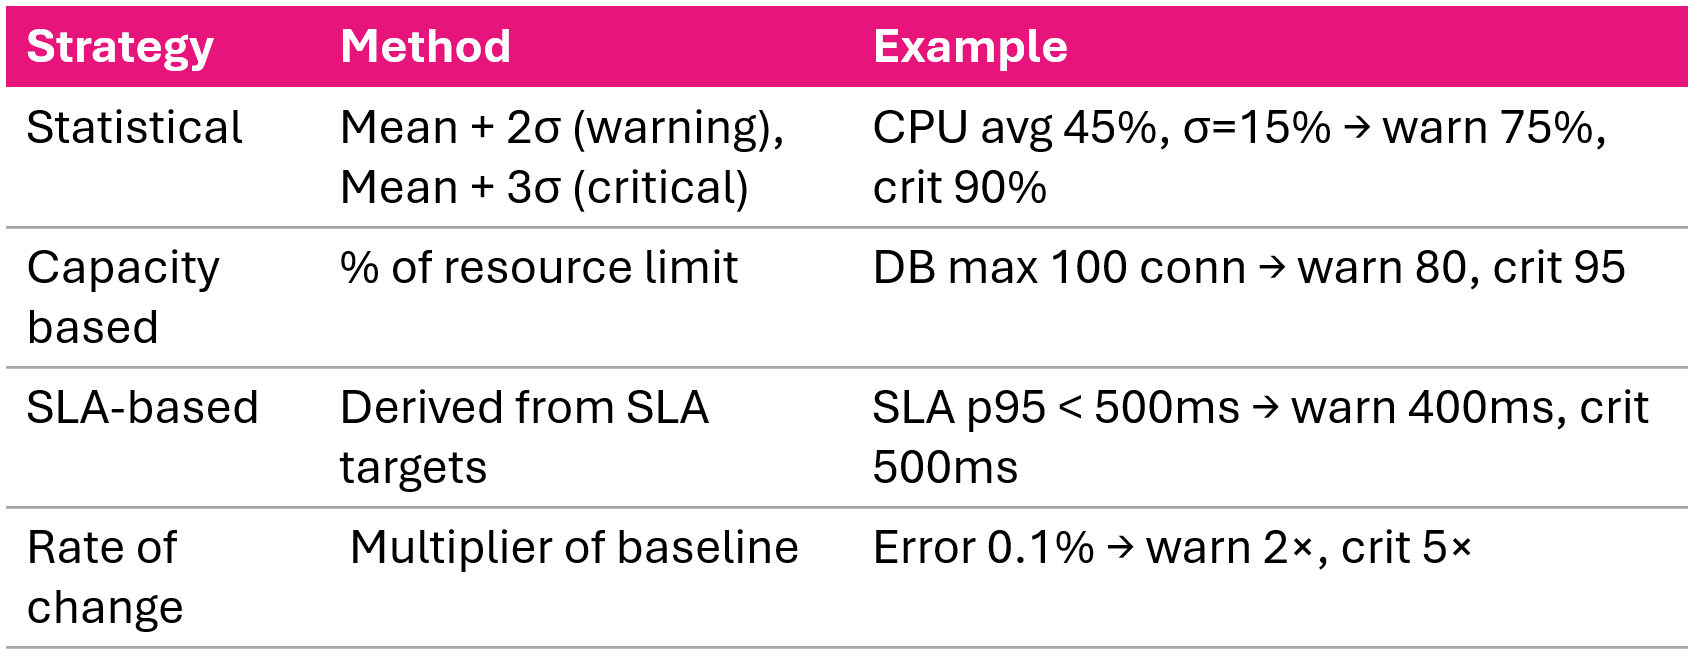
Strategie voor drempelkeuze

Vier strategieën voor drempelkeuze: baselineafwijking, capaciteitslimieten, SLA-doelen en veranderingssnelheid

Monitoring en troubleshooting van AWS

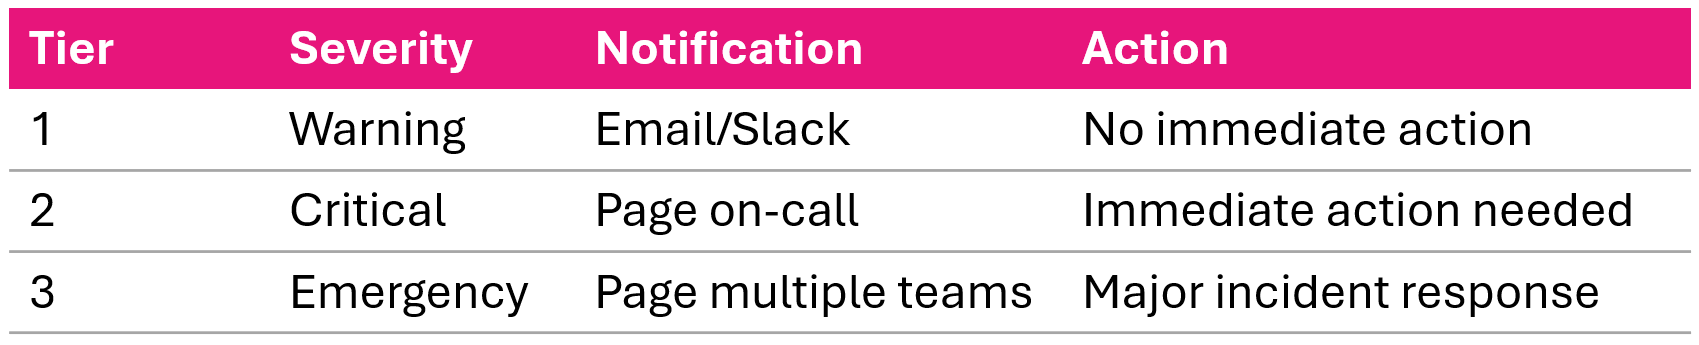
Meerlaagse alarmstrategie


Meerlagige alarmrespons met warning-, critical- en emergency-niveaus die naar aparte SNS-topics worden gestuurd

Voorbeeld: CPU Warning op 75%, Critical op 90%, elk met eigen SNS-topic

Monitoring en troubleshooting van AWS

Anomaliedetectie-alarms

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • ML-model leert normaal metriekgedrag
  • Maakt een dynamische drempelband (instelbaar)
  • Past zich aan dagelijkse/wekelijkse patronen aan
  • Vermindert handmatig tunen van drempels
Monitoring en troubleshooting van AWS

Resource-alarms: Lambda en ALB

Lambda-alarms
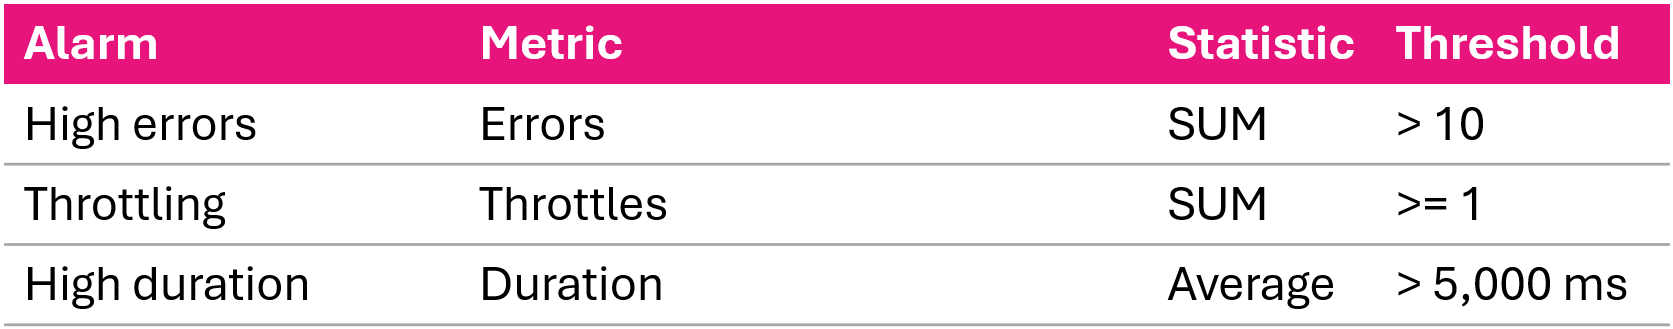
Aanbevolen Lambda-alarms: errors, throttles en hoge duur dicht bij de time-outlimiet

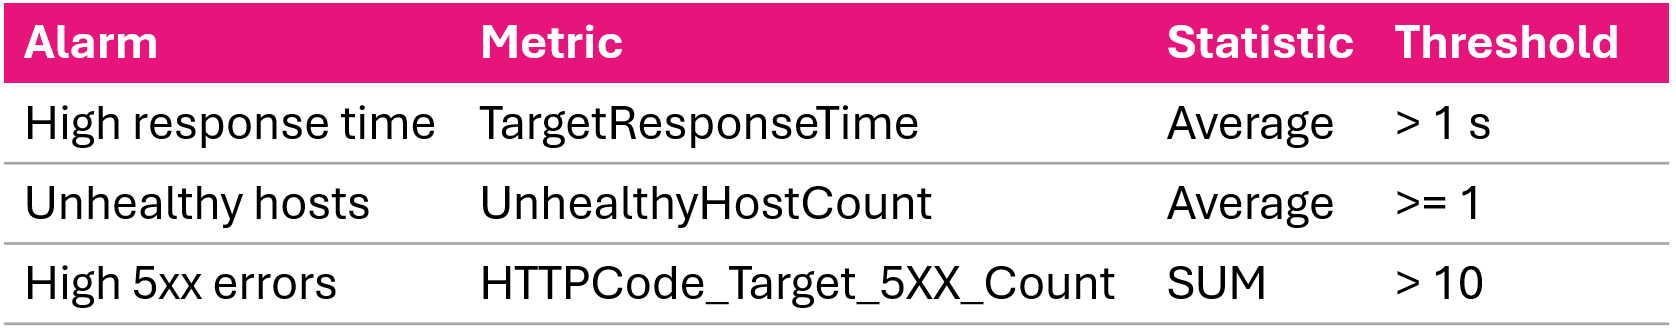
ALB-alarms

Aanbevolen ALB-alarms: responstijd van targets, ongezonde hosts en 5xx-fouten

Monitoring en troubleshooting van AWS

Aanbevolen praktijken voor alarmbeheer

  • Naamgeving: <Service>-<Metric>-<Resource>-<Severity>
  • Omschrijvingen: wat wordt bewaakt, drempel, tips voor troubleshooting, links naar runbooks
  • Tags: Environment, Team, Severity
  • Maandelijks reviewen: drempels bijstellen, oude verwijderen, acties updaten
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Monitoring en troubleshooting van AWS

Videosamenvatting

  • Drie alarmtoestanden: OK, ALARM, INSUFFICIENT_DATA
  • Evaluatiestrategieën: opeenvolgend, gedeeltelijk, enkele overschrijding
  • Composite alarms combineren meerdere alarms met AND, OR, NOT
  • Vier drempelstrategieën: statistisch, capaciteit, SLA, veranderingssnelheid
  • Meerlagige alertering: warning → critical → emergency
  • Resource-alarms voor Lambda (errors, throttles, duur) en ALB (5xx, latentie)
Monitoring en troubleshooting van AWS

Laten we oefenen!

Monitoring en troubleshooting van AWS

Preparing Video For Download...