Інсайти та аналіз журналів
Моніторинг і усунення несправностей в AWS

John Q. Martin
Principal Consultant
Структура запиту Logs Insights
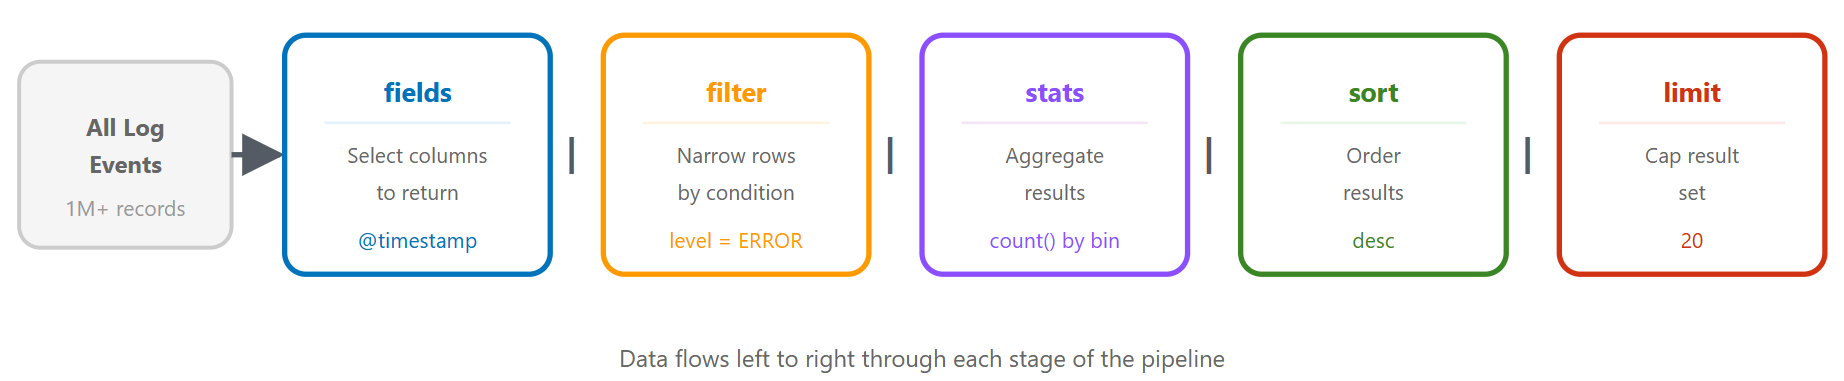
Мови запитів: один запит, три способи
CloudWatch Logs Insights QL
fields @timestamp, @message, level
| filter level = "ERROR"
| filter @timestamp > ago(1h)
| sort @timestamp desc
| limit 20
OpenSearch PPL
source = `/aws/lambda/my-function`
| where level = 'ERROR' and @timestamp > ago(1h)
| fields @timestamp, @message, level
| sort - @timestamp
| head 20
Мови запитів: OpenSearch SQL
OpenSearch SQL
SELECT `@timestamp`, `@message`, level
FROM `/aws/lambda/my-function`
WHERE level = 'ERROR'
  AND `@timestamp` > ago(1h)
ORDER BY `@timestamp` DESC
LIMIT 20
- Стандартний синтаксис SELECT / FROM / WHERE
- Додає JOIN між групами журналів
- Оберіть той, що підходить вашій команді
Сценарій 1: Сплески помилок
fields @timestamp, @message, level
| filter level = "ERROR"
| stats count() as error_count by bin(5m)
| sort @timestamp desc
Розширено: групування за типом помилки
fields @timestamp, error_type, error_message
| filter level = "ERROR"
| stats count() as count by error_type, bin(5m)
| sort count desc
Сценарій 2: Повільні кінцеві точки API
fields @timestamp, endpoint, response_time, status_code
| filter response_time > 1000
| stats avg(response_time) as avg_time,
        max(response_time) as max_time,
        count() as slow_requests
        by endpoint
| sort avg_time desc
Заглиблення
fields @timestamp, endpoint, response_time, user_id, request_id
| filter endpoint = "/api/users" and response_time > 1000
| sort response_time desc
| limit 20
Сценарій 3: Невдала автентифікація
fields @timestamp, user_id, ip_address, action
| filter action = "login_failed"
| stats count() as failed_attempts by user_id, ip_address
| sort failed_attempts desc
| limit 50
Часовий аналіз
fields @timestamp, user_id, ip_address
| filter action = "login_failed"
| stats count() as attempts by ip_address, bin(1h)
| filter attempts > 10
| sort attempts desc
Сценарії 4 і 5: Таймаути БД та витоки пам'яті
Таймаути бази даних
fields @timestamp, @message
| filter @message like /database/ and @message like /timeout|error|failed/
| parse @message "timeout after * seconds" as timeout_duration
| stats count() as timeout_count,
        avg(timeout_duration) as avg_timeout
        by bin(5m)
Виявлення витоків пам'яті
fields @timestamp, memory_used_mb, heap_size_mb
| stats avg(memory_used_mb) as avg_memory,
        max(memory_used_mb) as max_memory
        by bin(1h)
| sort @timestamp asc
Сценарій 6: Трасування запитів
fields @timestamp, @message, request_id, service, action
| filter request_id = "abc123def456"
| sort @timestamp asc
Трасування між сервісами
fields @timestamp, service, action, duration_ms, status
| filter request_id = "abc123def456"
| sort @timestamp asc
| display @timestamp, service, action, duration_ms, status
Просунуті прийоми: parse, Regex
Розбір неструктурованих журналів
fields @timestamp, @message
| parse @message "[*] User * failed to access resource * from IP *"
    as level, user, resource, ip
Розбір за Regex
| parse @message /Request completed in (?<duration>\d+)ms with status (?<status>\d+)/
Просунуті прийоми: обчислювані поля
fields @timestamp, requests, errors
| fields error_rate = (errors / requests) * 100

fields @timestamp, status_code
| fields status_category =
    case(status_code < 300, "success",
         status_code < 500, "client_error",
         status_code >= 500, "server_error")
| stats count() as request_count by status_category
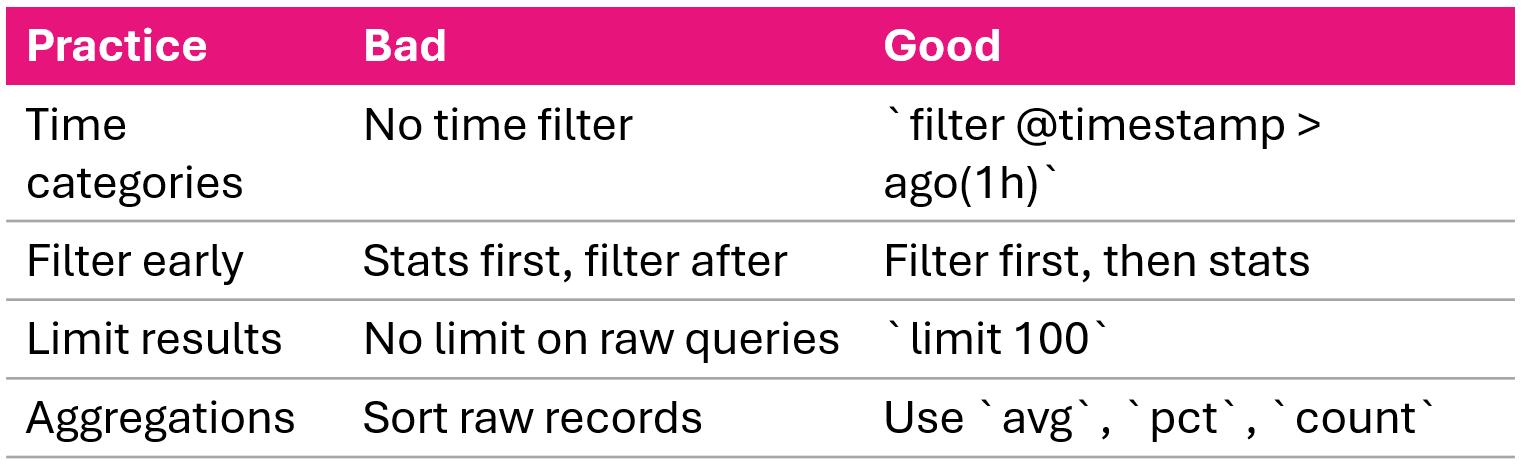
Оптимізація запитів
Виявлення аномалій і кореляція
Статистичне виявлення аномалій
- Обчисліть базову лінію: середнє та стандартне відхилення за 7 днів
- Порівняйте поточний період з базовою лінією
- Позначайте значення > 2 стандартних відхилень як аномальні
Кореляція рівня помилок
fields @timestamp, level
| stats count() as total_requests,
        sum(case(level = "ERROR", 1, 0)) as errors
        by bin(5m)
| fields error_rate = (errors / total_requests) * 100
Підсумок
- CloudWatch Logs Insights: інтерактивний сервіс запитів, інфраструктура не потрібна
- Три мови запитів: Logs Insights QL, OpenSearch PPL, OpenSearch SQL
- Шість сценаріїв діагностики: сплески помилок, повільні кінцеві точки, невдала автентифікація, таймаути БД, витоки пам'яті, трасування запитів
- Просунуті прийоми:
parseдля неструктурованого тексту,bin()для часових рядів,pct()для перцентилей - Кореляція та виявлення аномалій: аналіз рівня помилок, порівняння зі статистичною базою
- Від розслідування до автоматизації: фільтри метрик і сповіщення замикають цикл
Давайте потренуємось!
Моніторинг і усунення несправностей в AWS

