Аналіз трас і мап сервісів

Моніторинг і усунення несправностей в AWS

John Q. Martin

Principal Consultant

Що таке мапа сервісів?


Автоматично з ваших трас: без ручного налаштування
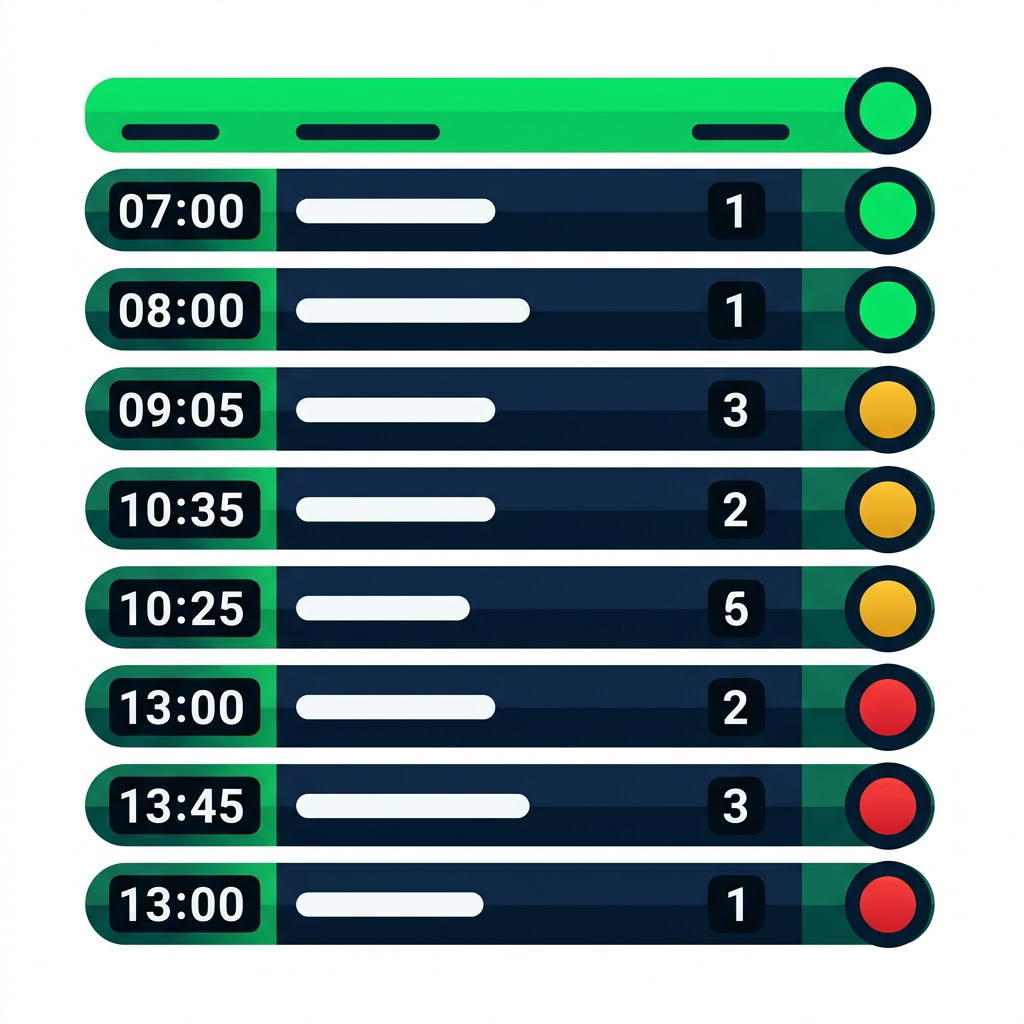
Табло відправлень із рядками сервісів і кольоровими індикаторами стану: зелений — вчасно, бурштиновий — затримка, червоний — зупинено

Одним поглядом: зелений = вчасно · бурштиновий = затримка · червоний = зупинено


Як відкрити:

  • X-Ray console → Service map
  • Застосуйте filters
  • Клацніть вузол → детальний розбір
Моніторинг і усунення несправностей в AWS

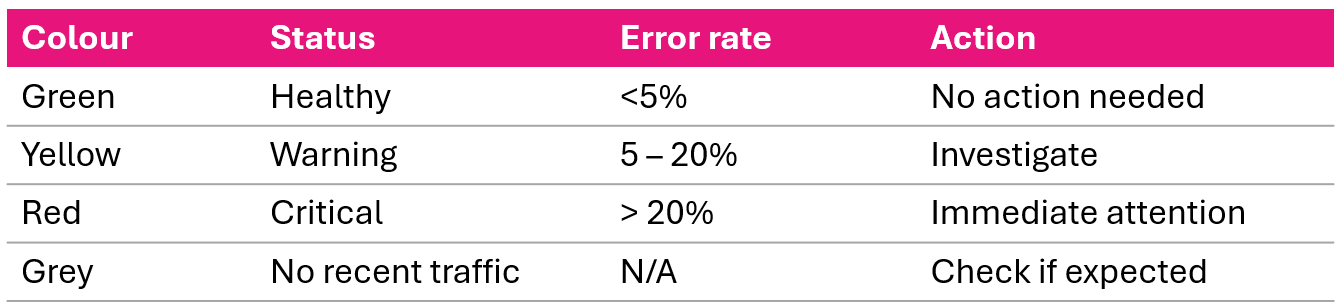
Кодування кольорів мапи сервісів


Ключ кольорів мапи сервісів: зелений успішні виклики, жовтий помилки клієнта, червоний збої сервера, фіолетовий ліміт, сірий немає трафіку

Відкривши мапу сервісів, одразу шукайте все, що не зелене.

Клацніть будь-який вузол, щоб побачити: розподіл часу відповіді, розбиття HTTP-статусів, типи помилок.

Моніторинг і усунення несправностей в AWS

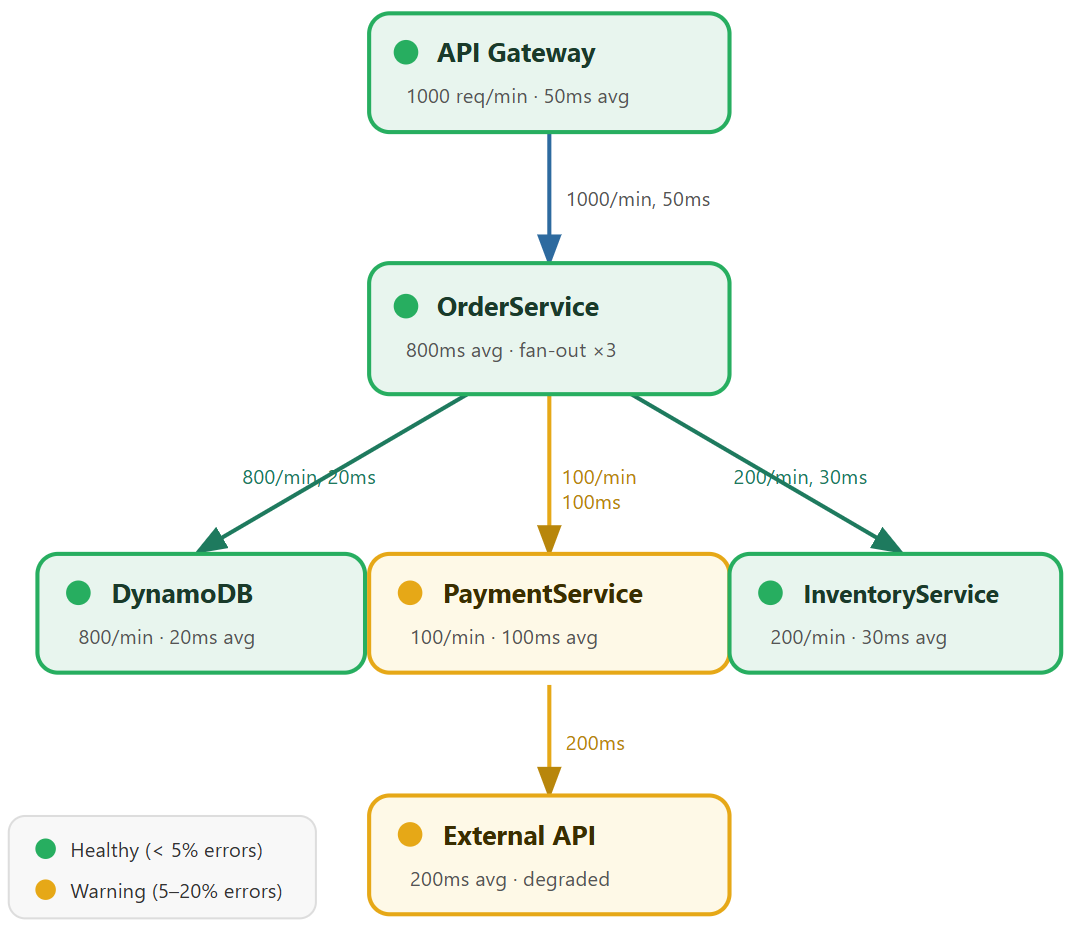
Як читати мапу сервісів


Мапа сервісів: API Gateway і OrderService розгалужуються до DynamoDB Inventory та жовтого Payment сервісу

Моніторинг і усунення несправностей в AWS

Аналіз критичного шляху


Критичний шлях = найдовший ланцюжок викликів

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Разом: 400ms

External API = 50% загальної затримки


Що з цим робити:

  • External API — ваша ціль для оптимізації
  • Варіанти: додати кешування, реалізувати timeout + fallback, узгодити SLA

Порівняйте альтернативний шлях:

OrderService -> DynamoDB
Разом: 120ms (швидко)
Моніторинг і усунення несправностей в AWS

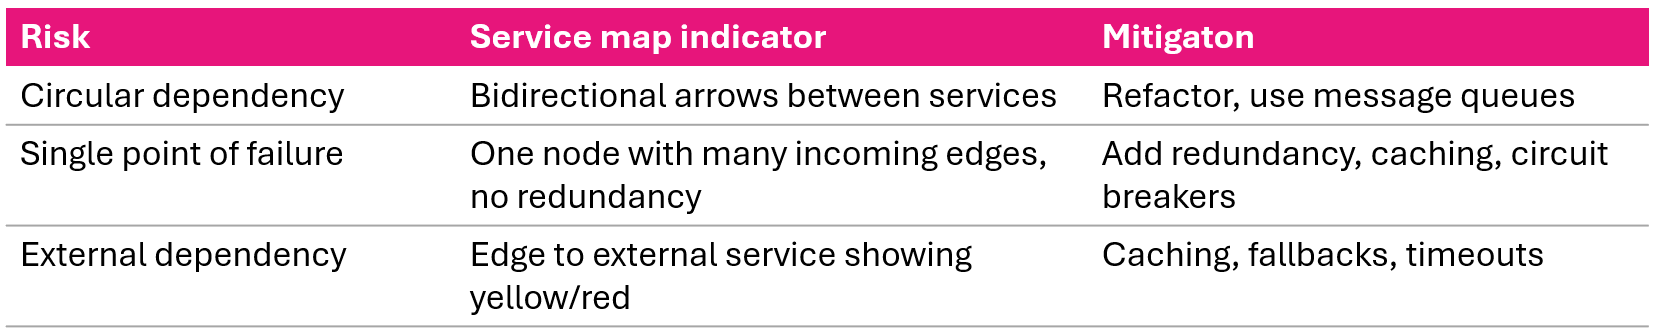
Ризики залежностей


Ризики залежностей на мапі сервісів: циклічні залежності, єдині точки відмови та ризикові зовнішні залежності

Моніторинг і усунення несправностей в AWS

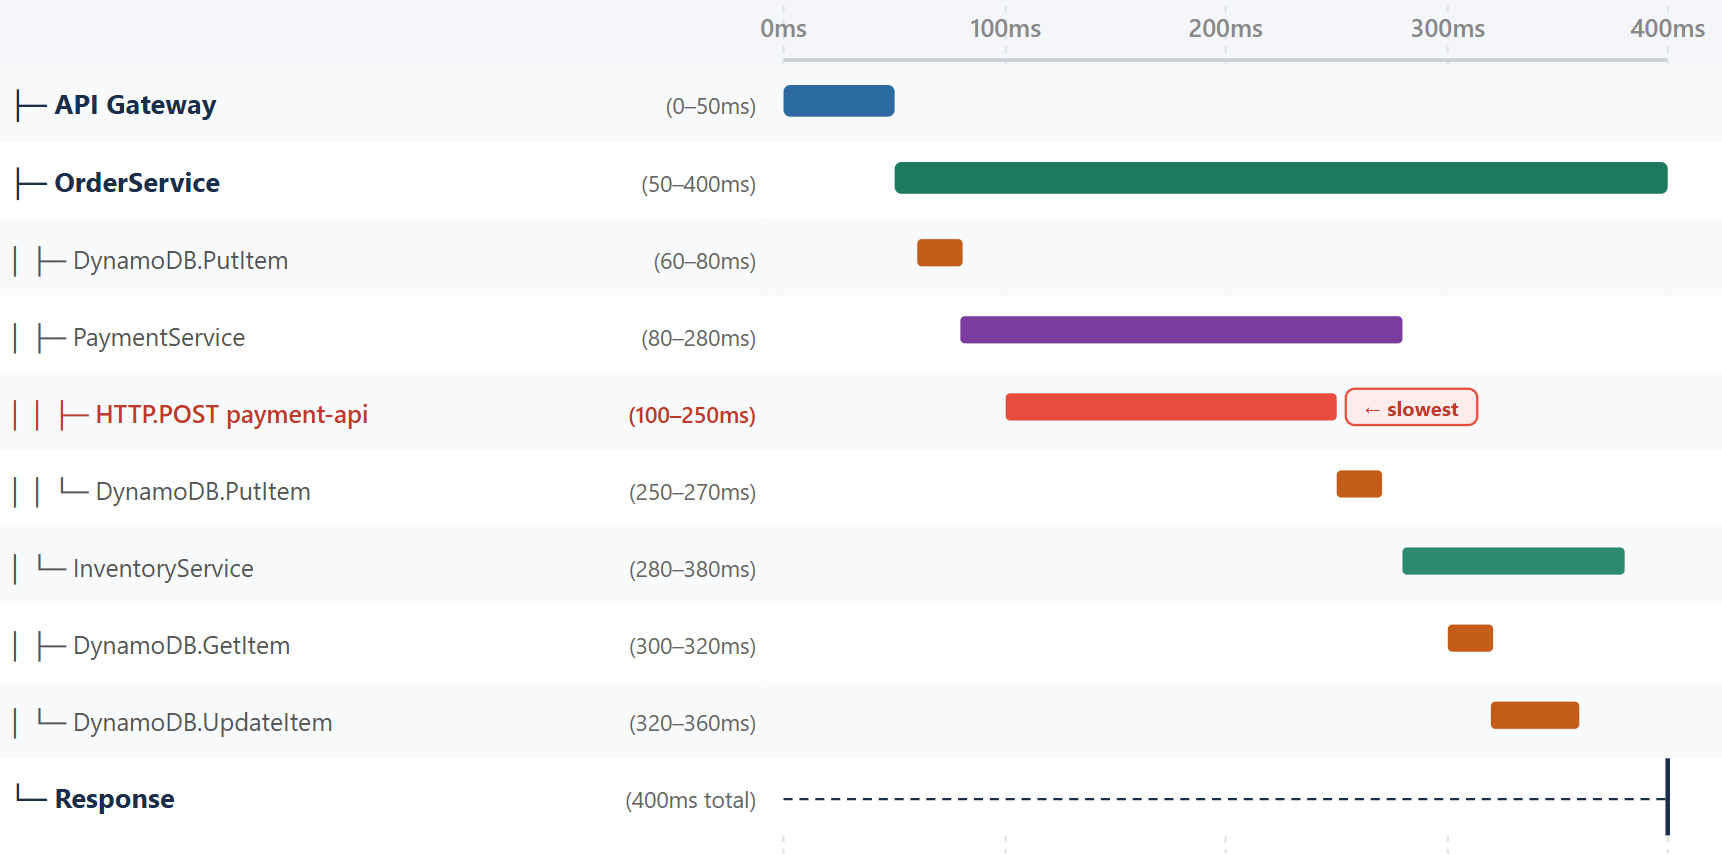
Розуміння шкал часу трас


Шкала часу трас із підсегментами: виклик payment-api — найдовша операція


  • Horizontal axis time: when operations started and how long they lasted
  • Vertical axis service hierarchy: subsegments indented under parents
  • HTTP.POST to payment-api (100-250ms) = the single longest operation
Моніторинг і усунення несправностей в AWS

Шаблон 1: Послідовні вузькі місця


До (послідовно — 80ms):

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


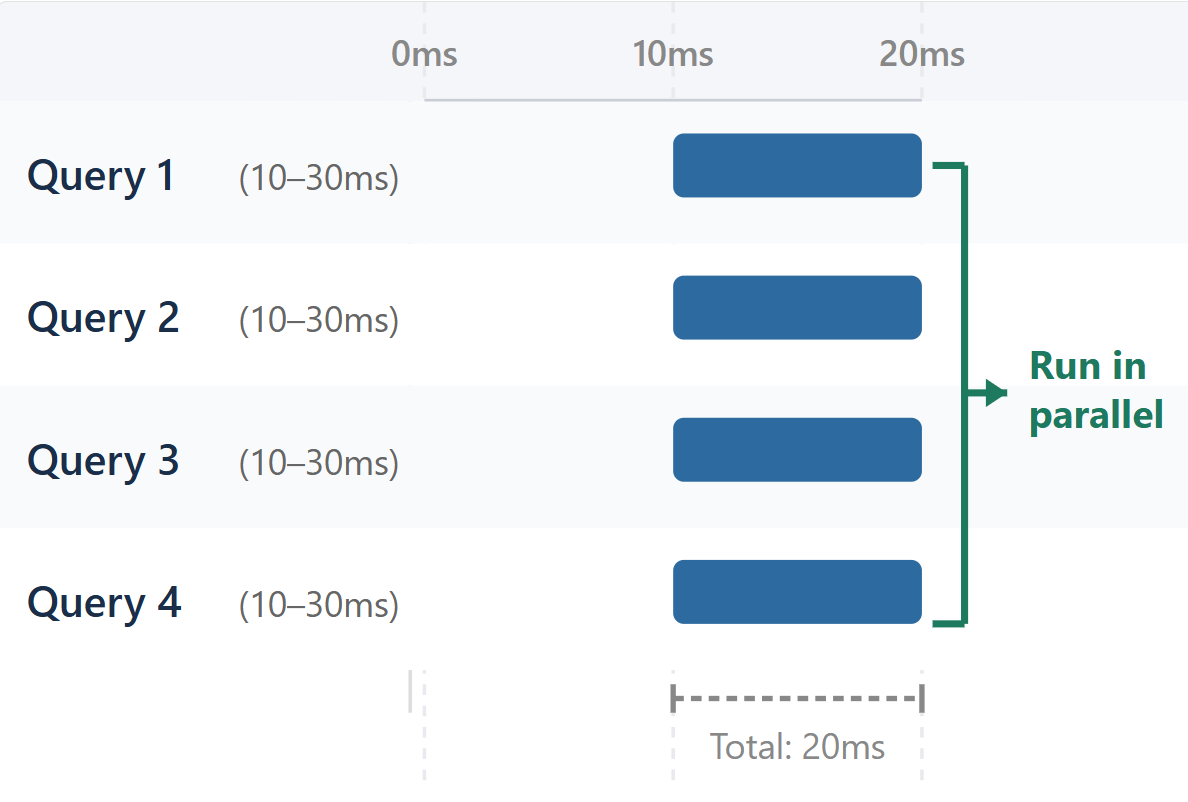
Після (паралельно — 20ms):

Шкала часу чотирьох запитів, що йдуть паралельно та завершуються за 20ms

Моніторинг і усунення несправностей в AWS

Шаблон 2: N+1 запитів і «балакучі» сервіси


Проблема N+1 запитів:

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 послідовних запитів

Виправлення: пакетні запити, eager loading


«Балакучі» сервіси:

  • 50 дрібних викликів між двома сервісами замість 1 пакетного
  • Кожен виклик: встановлення зʼєднання + серіалізація + зворотний прохід
  • 50× накладні витрати

Виправлення: пакетні запити, черги повідомлень, кешування

Моніторинг і усунення несправностей в AWS

Шаблон 3: Cold starts і каскадні збої
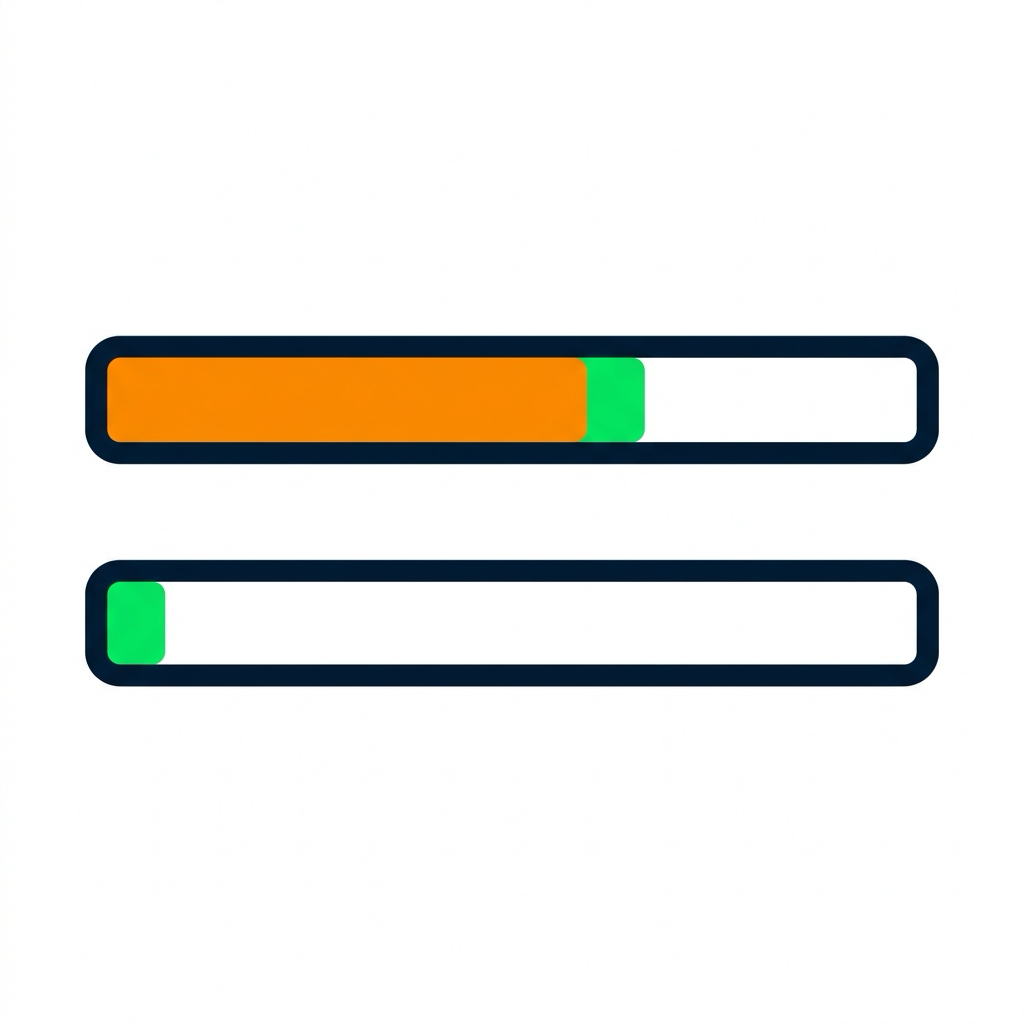
 

Дві смуги часу: cold start має великий помаранчевий блок ініціалізації та малий зелений handler; warm start — лише малий зелений handler

Lambda Cold Start:

  • Cold: 3000ms (2500ms init + 500ms handler)
  • Warm: 500ms (лише handler)
  • Видно як великий сегмент init під час першого виклику

Виправлення: provisioned concurrency, оптимізуйте ініціалізацію


Каскадний збій:

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

Однакові блоки timeout, складені вздовж ієрархії трас

Виправлення: timeouts, circuit breakers, fallbacks

Моніторинг і усунення несправностей в AWS

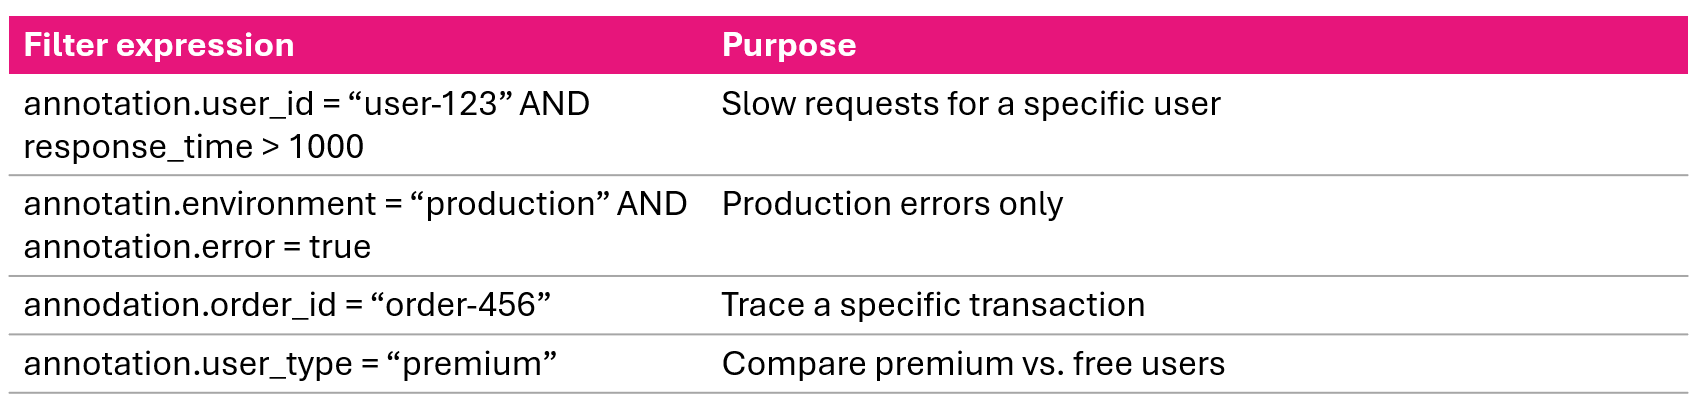
Фільтрація трас за анотаціями

Консоль X-Ray: фільтрація трас за парами ключ-значення анотацій

Порівнюйте групи:

  • Premium-користувачі середнє 200ms проти free 150ms → преміум-функції додають затримку
  • EU West у 3× повільніший за US East → проблема міжрегіонального доступу до даних
Моніторинг і усунення несправностей в AWS

Робочий процес аналізу трас


  1. Identify — фільтр: response_time > 1000ms, сортування за тривалістю
  2. Analyze — найдовші операції, послідовні вузькі місця, можливості паралелізації
  3. Annotate — анотації для бізнес-контексту: user ID, order ID, environment
  4. Review — метадані: деталі запиту, повідомлення про помилки
  5. Correlate — звірте з CloudWatch Logs
  6. Diagnose — першопричина: повільний запит, тайм-аут, алгоритм, вичерпання ресурсів
  7. Fix — оптимізуйте код, додайте кеш, паралелізуйте, масштабуйте
  8. Verify — порівняйте «до/після», відстежуйте затримку та частоту помилок
Моніторинг і усунення несправностей в AWS

Створення сповіщень з даних X-Ray


# Сповіщення про високу затримку
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# Сповіщення про велику кількість помилок
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Моніторинг і усунення несправностей в AWS

Підсумок відео


  • Service maps — автостворені діаграми архітектури: вузли (сервіси), ребра (зʼєднання), кольори стану
  • Color coding — зелений (успіх), жовтий (4xx), червоний (5xx збої), фіолетовий (429), сірий (без трафіку)
  • Critical path — найдовший ланцюжок викликів, визначає ціль оптимізації
  • Trace timelines — показують послідовні вузькі місця, N+1 запити, cold starts, каскадні збої
  • Annotations — фільтруйте й групуйте траси за бізнес-контекстом
  • Workflow — вісім кроків: identify → analyze → annotate → review → correlate → diagnose → fix → verify
Моніторинг і усунення несправностей в AWS

Аналіз трас і мап сервісів

Моніторинг і усунення несправностей в AWS

Preparing Video For Download...