Сповіщення та повідомлення CloudWatch

Моніторинг і усунення несправностей в AWS

John Q. Martin

Principal Consultant

Що таке CloudWatch Alarms
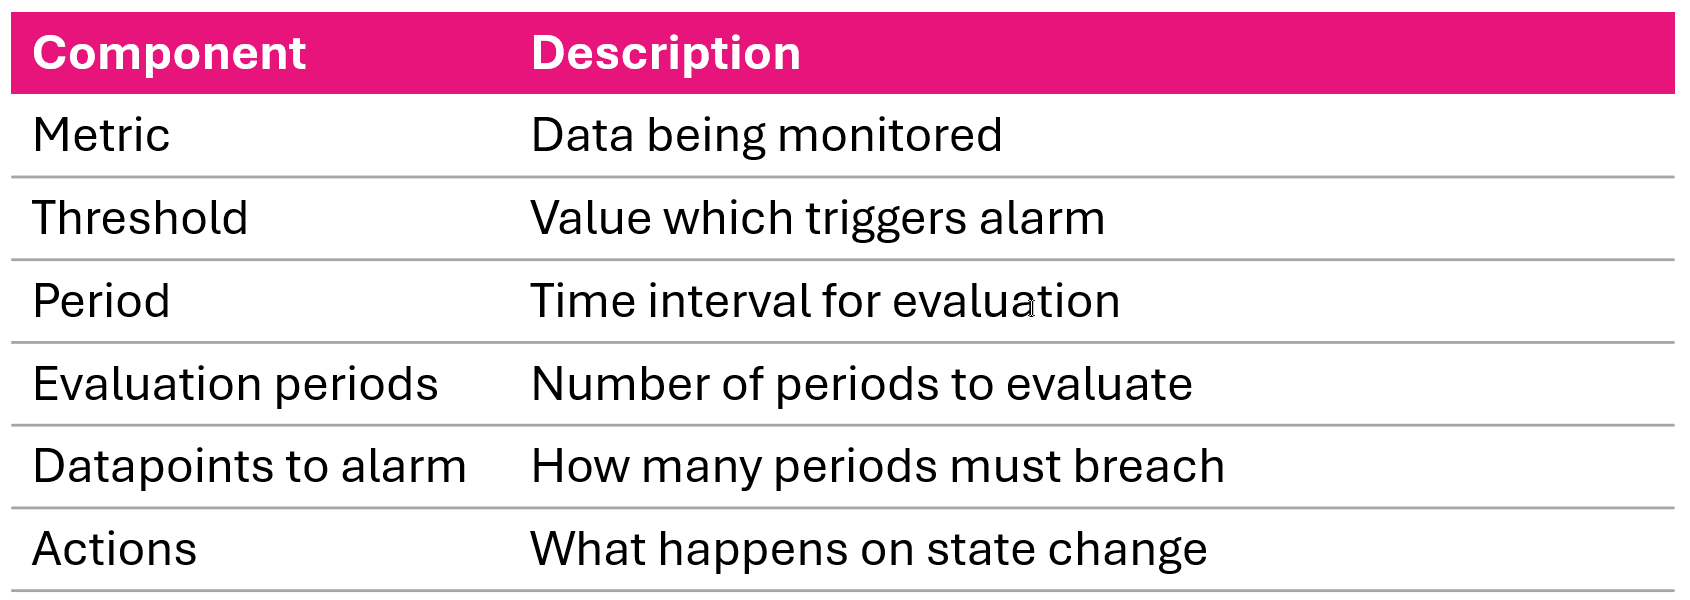
 

Ключові поняття

  • Стежить за одним метриком упродовж періоду
  • Виконує дії, коли метрик перетинає поріг


Шість основних компонентів тривоги CloudWatch: metric, threshold, period, evaluation periods, datapoints to alarm і actions

Моніторинг і усунення несправностей в AWS

Стани тривоги

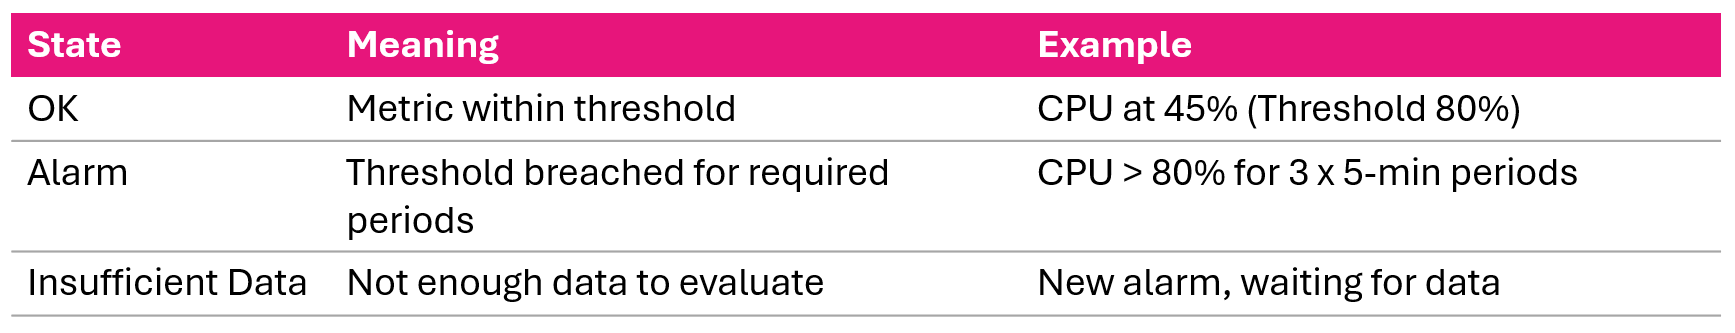
Три стани тривоги CloudWatch: OK, ALARM і INSUFFICIENT_DATA

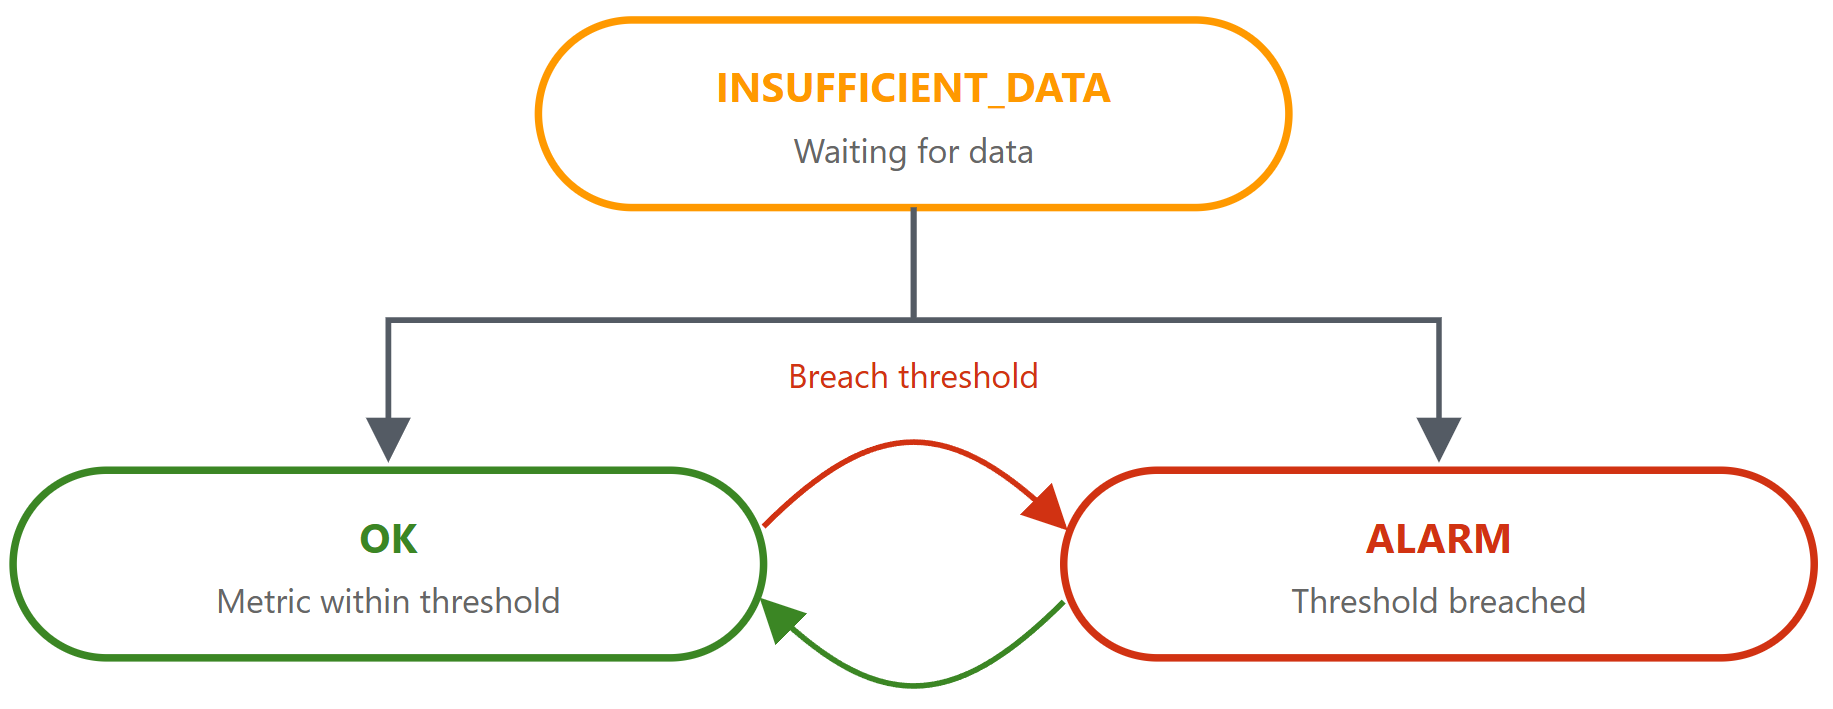
Схема переходів станів тривоги CloudWatch у міру надходження даних метрик

Моніторинг і усунення несправностей в AWS

Оцінювання тривоги


  1. Збирає точки даних із заданим інтервалом
  2. Застосовує статистику (Average, Sum, Max, Min) за період
  3. Порівнює результат із порогом
  4. Рахує періоди оцінки з порушенням
  5. Змінює стан, якщо досягнуто datapoints-to-alarm


Metric: CPUUtilization > 80%
Period: 5 min | 
Eval Periods: 3 | 
Datapoints to Alarm: 2 of 3

Period 1: 85% (breach) | 
Period 2: 75% (ok) | 
Period 3: 90% (breach)
Result: ALARM — 2 of 3 breached
Моніторинг і усунення несправностей в AWS

Стратегії оцінювання


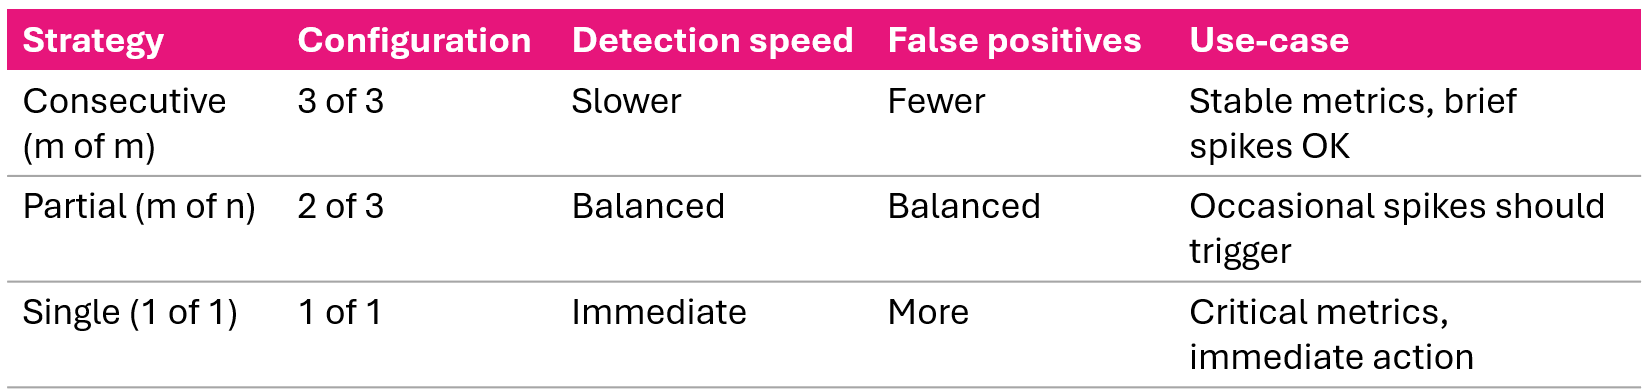
Три стратегії оцінювання тривог: послідовна, часткова та одиничне порушення з компромісами чутливості

Моніторинг і усунення несправностей в AWS

Типи дій тривог і тригери


Тригери дій

  • OK
  • ALARM
  • INSUFFICIENT_DATA


Типи дій

  • SNS Notification
  • Auto Scaling
  • EC2 Action (stop/terminate/reboot/recover)
  • Systems Manager
Моніторинг і усунення несправностей в AWS

Поведение за відсутності даних


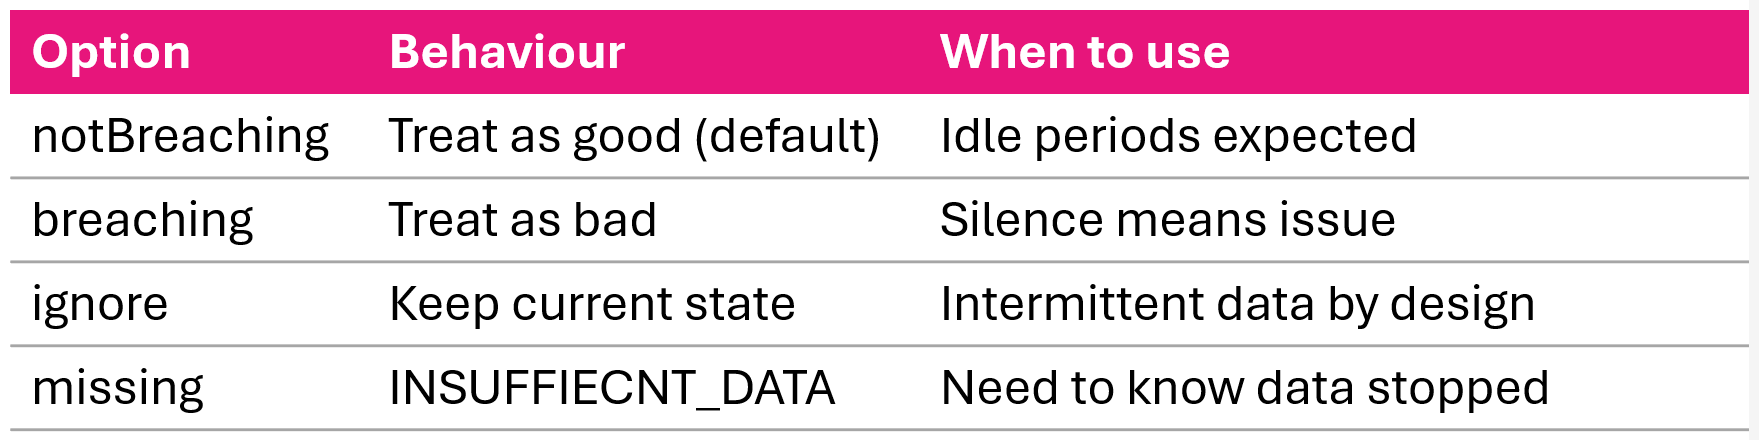
Поведінка за відсутності даних: notBreaching, breaching, ignore і missing

Моніторинг і усунення несправностей в AWS

Створення стандартної тривоги: AWS CLI

aws cloudwatch put-metric-alarm \
  --alarm-name HighCPUUtilization \
  --alarm-description "Alert when CPU exceeds 80%" \
  --metric-name CPUUtilization \
  --namespace AWS/EC2 \
  --statistic Average \
  --period 300 \
  --evaluation-periods 2 \
  --threshold 80 \
  --comparison-operator GreaterThanThreshold \
  --dimensions Name=InstanceId,Value=i-1234567890abcdef0 \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:my-topic
Моніторинг і усунення несправностей в AWS

Складені тривоги: що і навіщо

Проблема

  • Кілька пов'язаних тривог спрацьовують окремо = вигорання від сповіщень

Розв'язання

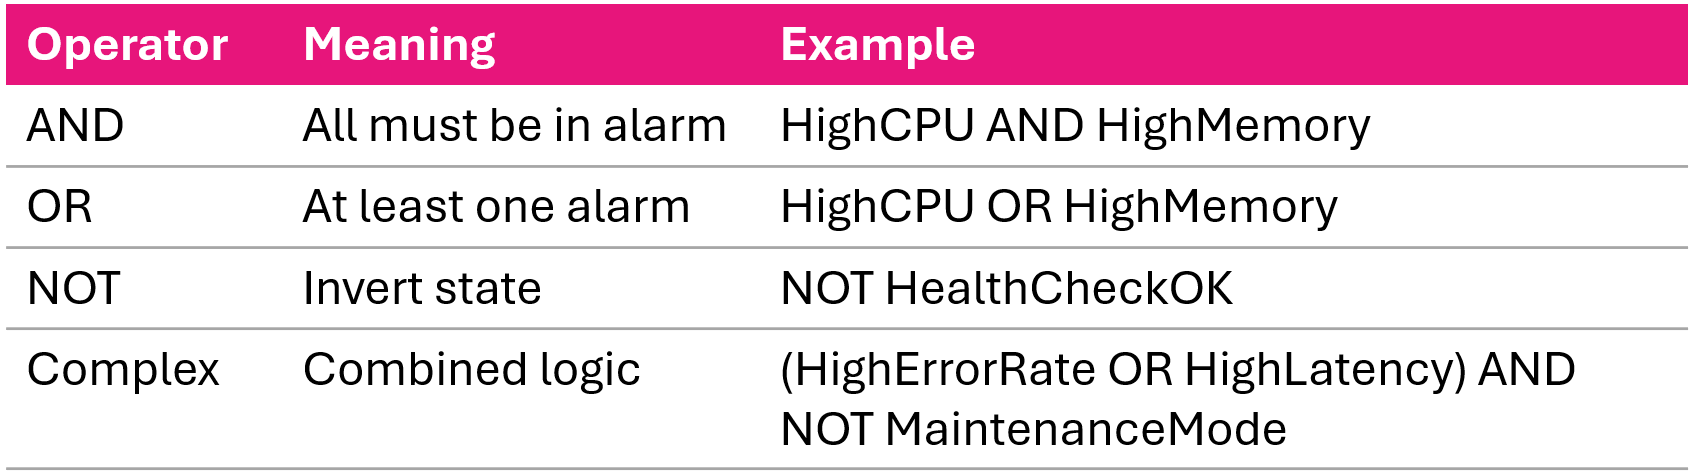
  • Об'єднайте тривоги логічними операторами

Логіка складеної тривоги: поєднання дочірніх тривог операторами AND, OR і NOT

Моніторинг і усунення несправностей в AWS

Створення складеної тривоги: AWS CLI

aws cloudwatch put-composite-alarm \
  --alarm-name CriticalSystemHealth \
  --alarm-description "Critical when CPU and Memory both high" \
  --actions-enabled \
  --alarm-actions arn:aws:sns:us-east-1:123456789012:critical-alerts \
  --alarm-rule "ALARM(HighCPUAlarm) AND ALARM(HighMemoryAlarm)"
Приклад складного правила
--alarm-rule "(ALARM(HighErrorRate) OR ALARM(HighLatency)) \
  AND NOT ALARM(MaintenanceMode)"
Моніторинг і усунення несправностей в AWS

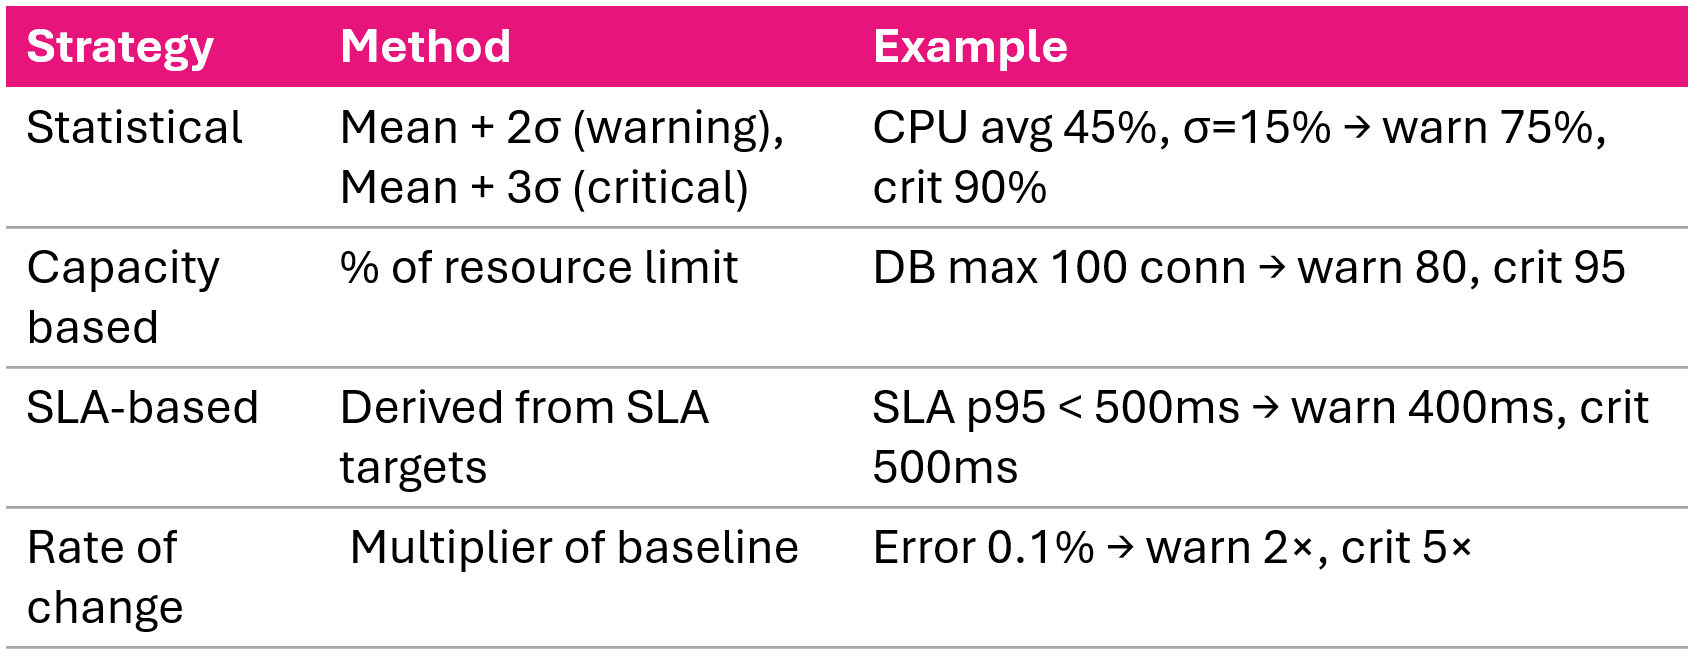
Стратегія вибору порога

Чотири стратегії вибору порога: базове відхилення, межі потужності, цілі SLA та швидкість змін

Моніторинг і усунення несправностей в AWS

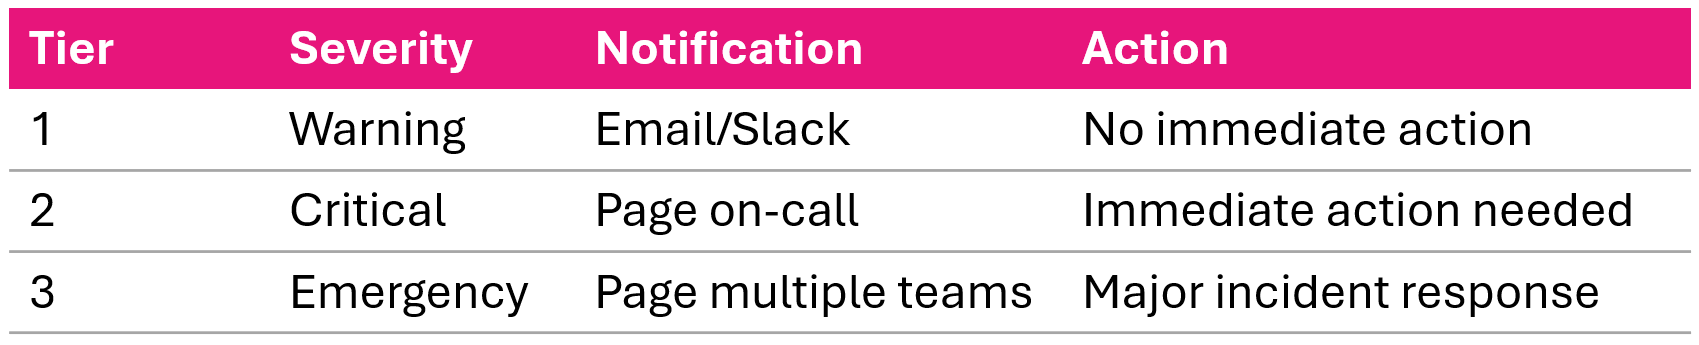
Багаторівнева стратегія тривог


Багаторівнева реакція на тривоги: рівні warning, critical та emergency з маршрутизацією до окремих тем SNS

Приклад: попередження CPU на 75%, критично на 90%, кожне до своєї теми SNS

Моніторинг і усунення несправностей в AWS

Тривоги виявлення аномалій

aws cloudwatch put-metric-alarm \
  --alarm-name AnomalousTraffic \
  --comparison-operator LessThanLowerOrGreaterThanUpperThreshold \
  --metrics '[
    {"Id":"m1","MetricStat":{"Metric":{"Namespace":"AWS/ApplicationELB",
      "MetricName":"RequestCount"},"Period":300,"Stat":"Average"}},
    {"Id":"e1","Expression":"ANOMALY_DETECTION_BAND(m1, 2)"}
  ]'
  • Модель ML навчається нормальній поведінці метрика
  • Створює динамічний діапазон порога (налаштовується)
  • Адаптується до добових/тижневих патернів
  • Зменшує ручне підлаштування порогів
Моніторинг і усунення несправностей в AWS

Тривоги для ресурсів: Lambda та ALB

Тривоги для Lambda
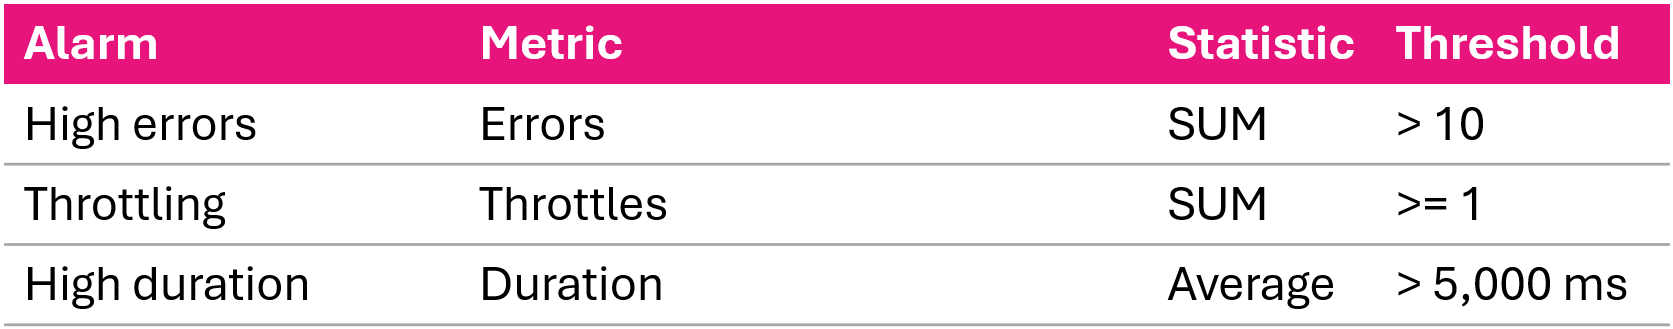
Рекомендовані тривоги Lambda: помилки, throttles і тривалість поблизу ліміту часу

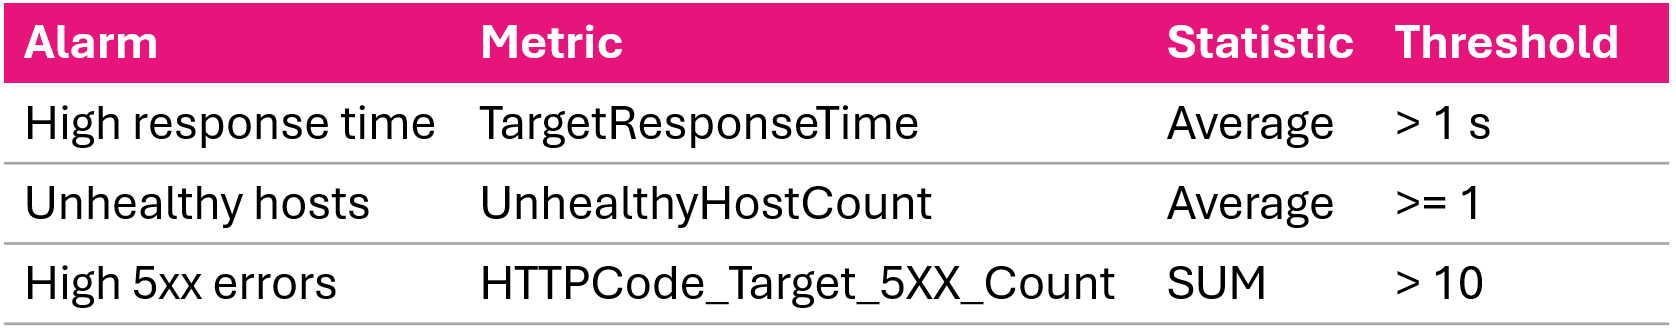
Тривоги для ALB

Рекомендовані тривоги ALB: час відповіді цілей, непрацездатні вузли та кількість помилок 5xx

Моніторинг і усунення несправностей в AWS

Рекомендовані практики керування тривогами

  • Іменування: <Service>-<Metric>-<Resource>-<Severity>
  • Опис: що моніториться, поріг, поради з усунення, посилання на runbook
  • Теґи: Environment, Team, Severity
  • Щомісячний перегляд: коригуйте пороги, прибирайте зайве, оновлюйте дії
aws cloudwatch set-alarm-state \
  --alarm-name MyAlarm \
  --state-value ALARM \
  --state-reason "Testing alarm notification"
Моніторинг і усунення несправностей в AWS

Підсумок відео

  • Три стани тривоги: OK, ALARM, INSUFFICIENT_DATA
  • Стратегії оцінювання: послідовна, часткова, одиничне порушення
  • Складені тривоги поєднують кілька тривог через AND, OR, NOT
  • Чотири стратегії порогів: статистична, потужності, SLA, швидкості змін
  • Багаторівневе сповіщення: warning → critical → emergency
  • Тривоги для ресурсів: Lambda (errors, throttles, duration) і ALB (5xx, latency)
Моніторинг і усунення несправностей в AWS

Давайте потренуємось!

Моніторинг і усунення несправностей в AWS

Preparing Video For Download...