Tableaux de bord de santé applicative

Supervision et dépannage sur AWS

John Q. Martin

Principal Consultant

Conception de tableau de bord : hiérarchie de l'information
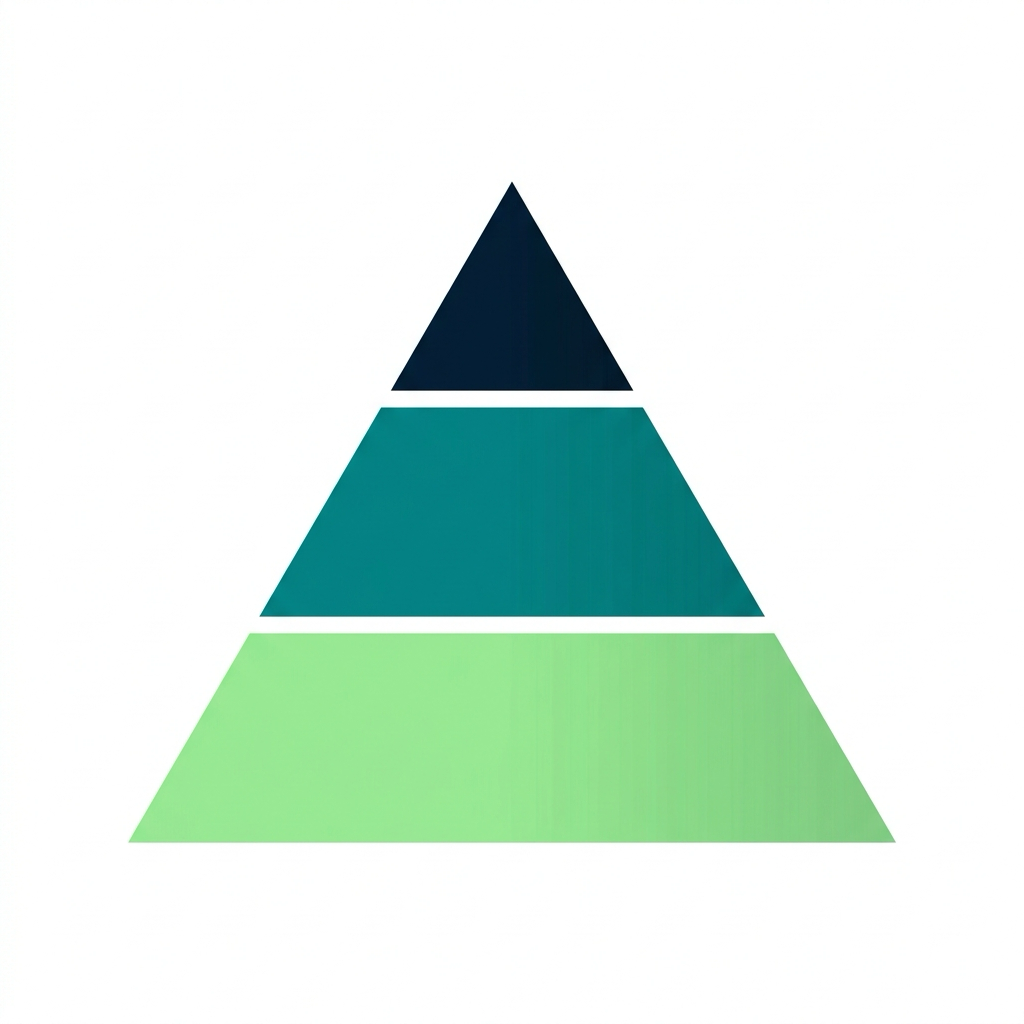
 

Pyramide à trois niveaux : un sommet étroit foncé, un milieu bleu sarcelle plus large et une base verte la plus large

Comme à l'hôpital : accueil → service → spécialiste


Haut - Synthèse exécutive

  • Santé globale du système
  • Indicateurs clés, SLA, incidents en cours

Milieu - Santé des services

  • Taux d'erreurs, percentiles de latence, débit

Bas - Diagnostics détaillés

  • Traces, journaux, utilisation des ressources, santé des dépendances
Supervision et dépannage sur AWS

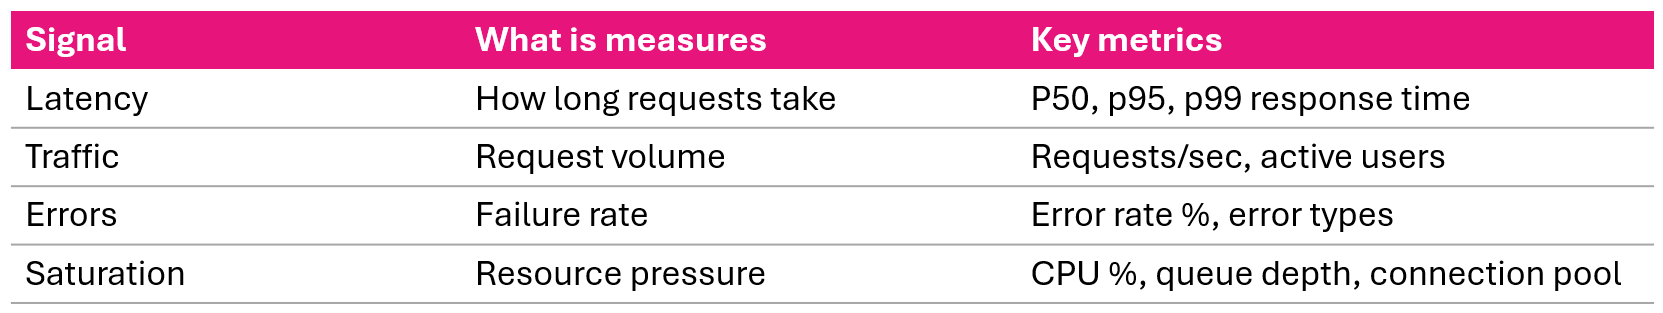
Les quatre signaux d'or


Les quatre signaux d'or de la supervision : latence, trafic, erreurs et saturation

Couvrez ces quatre points et vous couvrirez l'immense majorité des problèmes.

Supervision et dépannage sur AWS

La méthode RED


RED pour les services pilotés par requêtes :
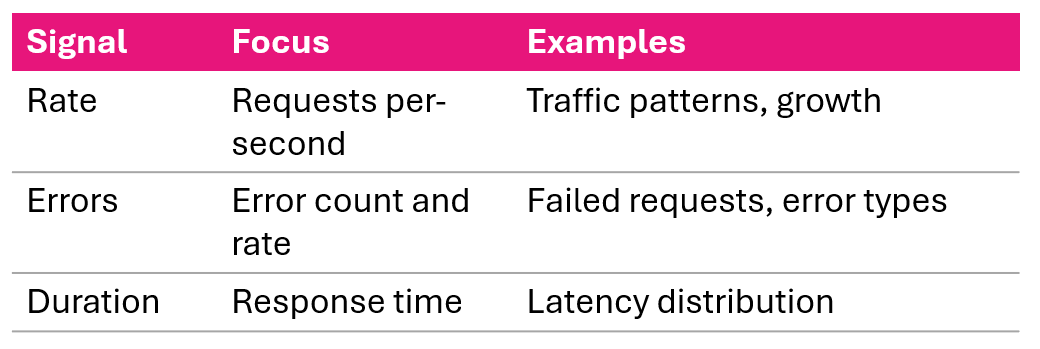
Schéma de la méthode RED montrant taux, erreurs et durée pour les services orientés requêtes


Lien avec les signaux d'or :

  • RED est un sous-ensemble ciblé des quatre signaux d'or
  • Conçu pour les services qui traitent des requêtes utilisateur
  • Saturation (4e signal d'or) ajoutée pour la supervision d'infrastructure

Utilisez RED comme point de départ, ajoutez la saturation pour un diagnostic plus poussé.

Supervision et dépannage sur AWS

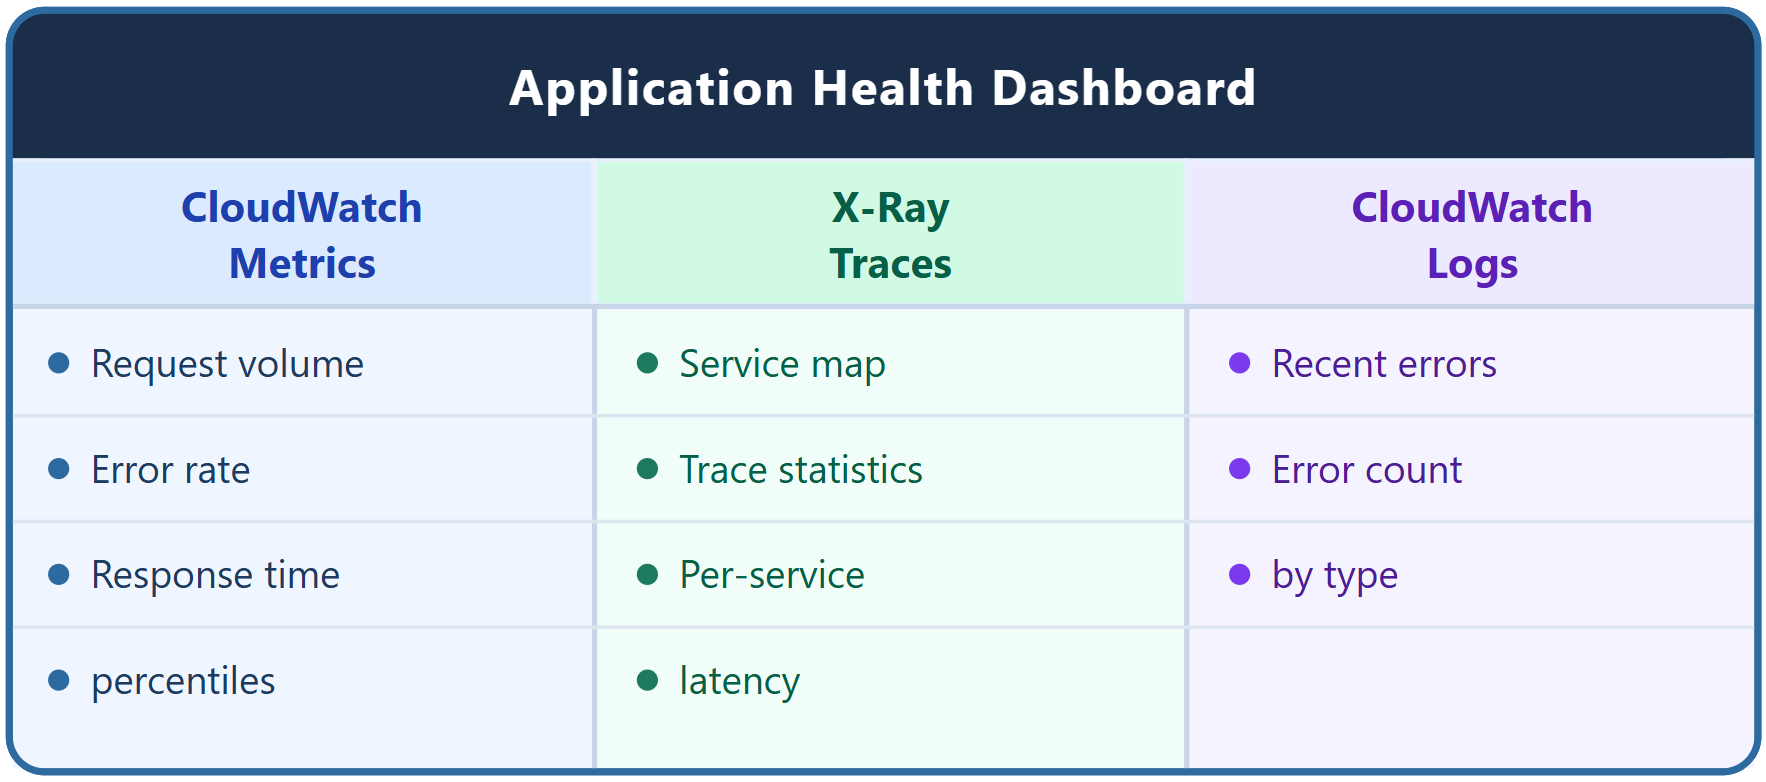
Trois sources de données


Schéma de trois sources de données pour tableau de bord : métriques CloudWatch, traces X-Ray et CloudWatch Logs

Supervision et dépannage sur AWS

Widgets de métriques CloudWatch

Volume de requêtes :

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

Taux d'erreurs (metric math) :

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

Percentiles de temps de réponse :

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • Volume de requêtes via ALB RequestCount
  • Taux d'erreurs via metric math : errors / invocations × 100
  • Temps de réponse en percentiles p50, p95, p99
Supervision et dépannage sur AWS

Widgets X-Ray et journaux


Widgets X-Ray :

  • Service map : topologie applicative avec indicateurs de santé
  • Trace statistics : temps de réponse moyen, taux d'erreurs, taux de fautes
  • Service latency : comparaison des temps de réponse par service


Widgets CloudWatch Logs :

Requête erreurs récentes :

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

Nombre d'erreurs par type :

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
Supervision et dépannage sur AWS

Mise en page complète du tableau de bord
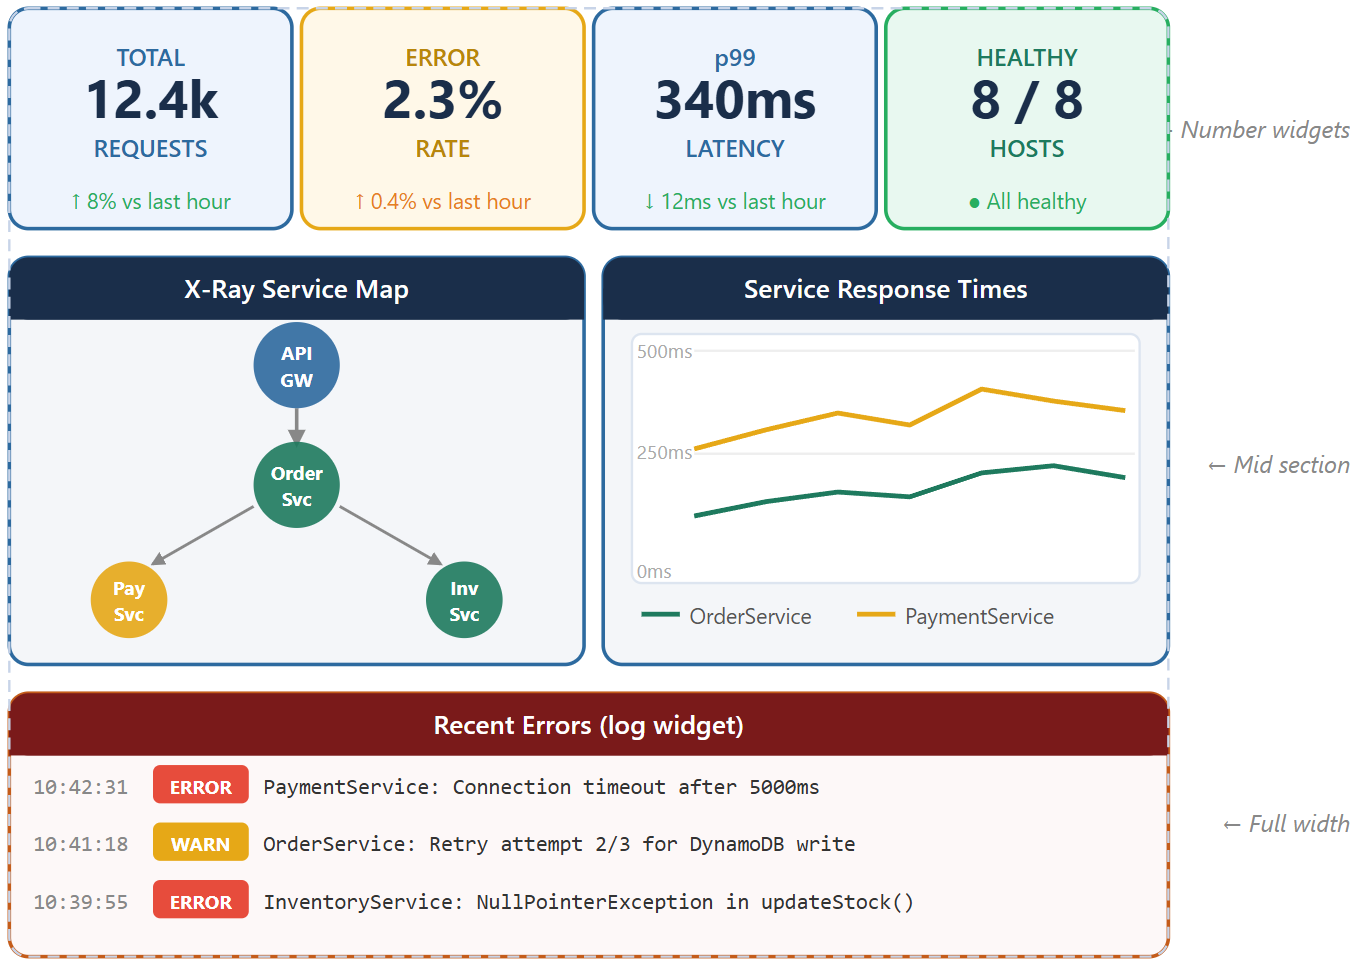
 

Mise en page d'un tableau de bord de santé : widgets de synthèse en haut, carte des services au milieu et journaux d'erreurs en bas

Supervision et dépannage sur AWS

Flux de diagnostic d'incident


Fiche de triage des urgences avec bandes de priorité colorées et stéthoscope

Comme le triage aux urgences : stabiliser → diagnostiquer → traiter → vérifier

  1. Identifier : indicateurs rouges/jaunes, pics d'erreurs
  2. Délimiter : quels services ? quand ? cela empire ?
  3. Corréler : erreurs + latence, trafic + ressources
  4. Explorer : service map → traces → journaux
  5. Cause racine : dépendance, BD, mémoire, config
  6. Corriger : disjoncteur, montée en charge, rollback, bascule
  7. Vérifier : taux d'erreurs normal, carte au vert, alarmes claires
Supervision et dépannage sur AWS

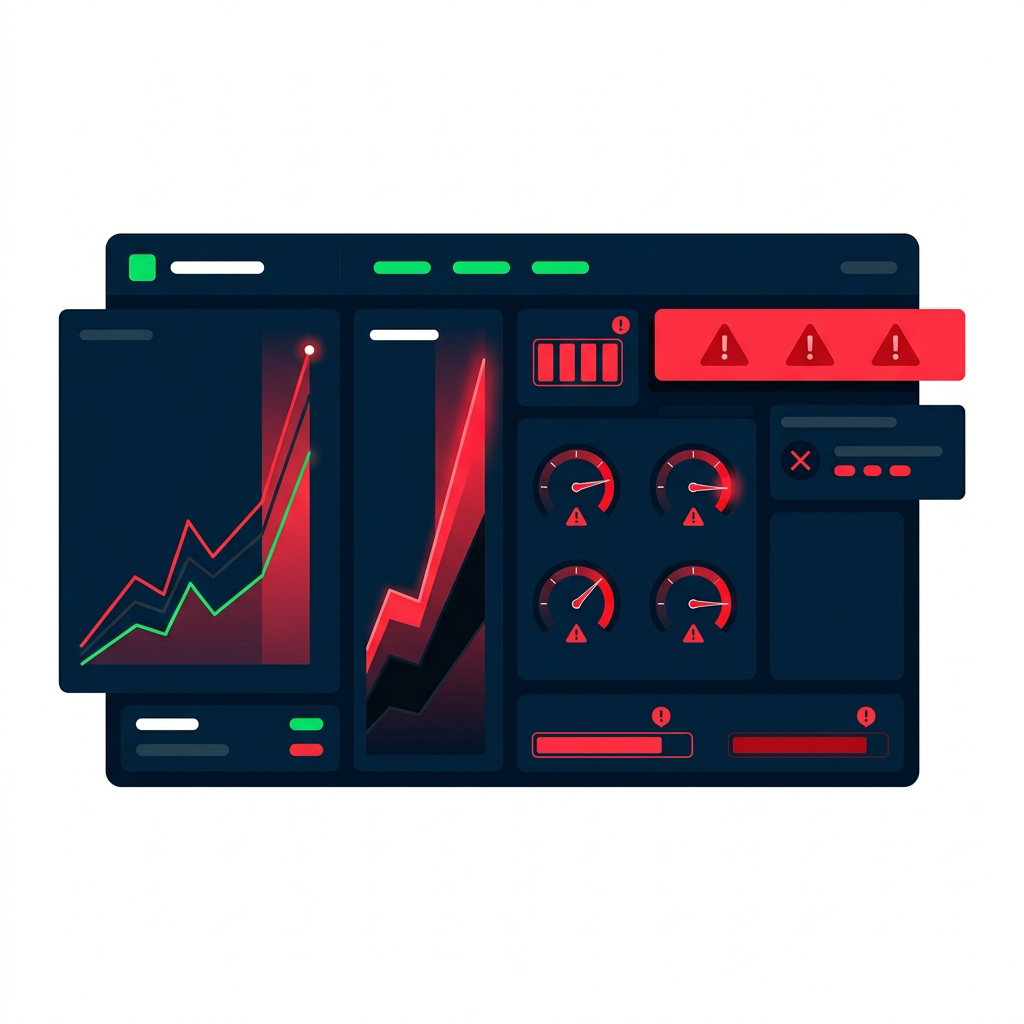
Scénario 1 : pic de trafic soudain

Tableau de bord pendant un pic de trafic : courbes en forte hausse, jauges dans le rouge, bannières d'alerte rouges

Ce que vous voyez sur le tableau de bord :

  • Volume de requêtes ×10
  • Taux d'erreurs : 25 %
  • Latence : 3000 ms
  • CPU : 95 %

Analyse : Ressources saturées par un afflux de trafic


Actions :

  • Élargir immédiatement (scale out)
  • Activer l'auto-scaling
  • Mettre en place un rate limiting
  • Ajouter du cache pour soulager le backend
Supervision et dépannage sur AWS

Scénario 2 : goulot d'étranglement base de données
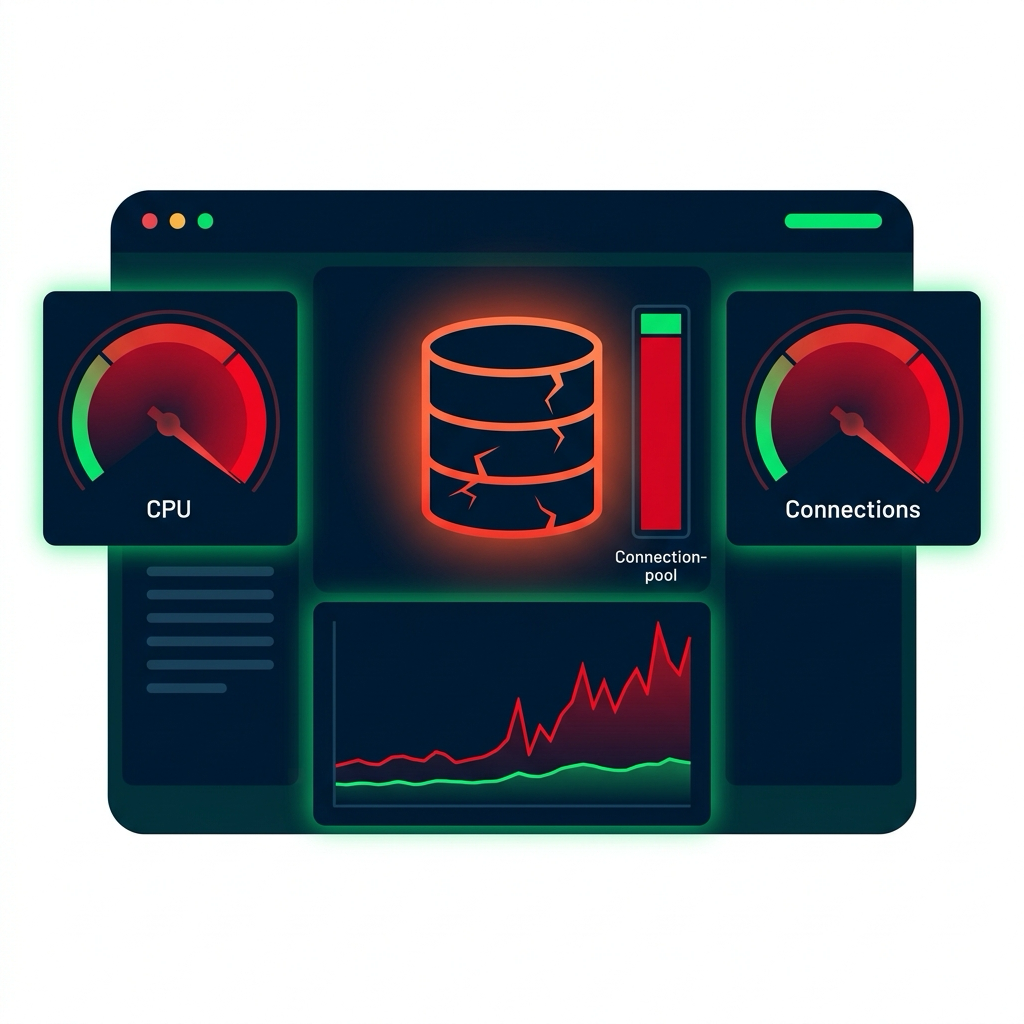
Tableau de bord montrant un goulot d'étranglement BD : icône de base rouge fissurée, jauges CPU et connexions au maximum, latence des requêtes en forte hausse, pool de connexions presque plein

Ce que vous voyez sur le tableau de bord :

  • CPU BD : 95 %
  • Connexions BD : 95/100
  • Latence des requêtes : 5000 ms
  • Latence app : 5500 ms

Analyse : La base de données est le goulot ; requêtes lentes épuisant le pool de connexions


Actions :

  • Repérer les requêtes lentes dans les journaux
  • Ajouter des index, optimiser les requêtes
  • Augmenter la taille du pool de connexions
  • Monter la base en charge
Supervision et dépannage sur AWS

Scénario 3 : panne en cascade


Ce que vous voyez sur la carte des services :
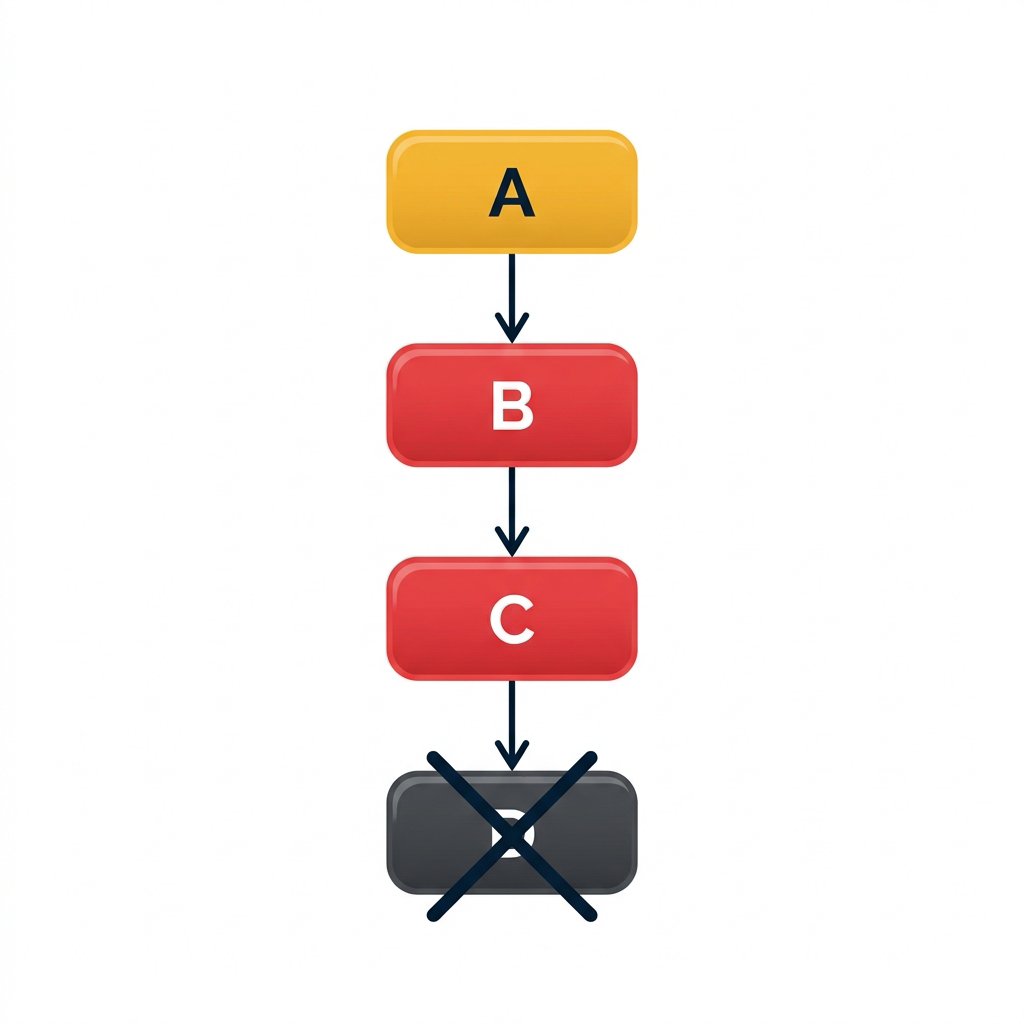
Cascade sur la carte des services : nœud A ambre avec erreurs client, B et C rouges avec fautes serveur, D sombre et totalement à l'arrêt, flèches descendant la chaîne


Analyse :

Un petit problème dans le Service A a déclenché une cascade dans la chaîne de dépendances

Actions :

  • Disjoncteurs pour arrêter la cascade
  • Timeouts à chaque niveau de service
  • Mécanismes de repli pour les dépendances en échec
  • Corriger la cause racine dans le Service A
Supervision et dépannage sur AWS

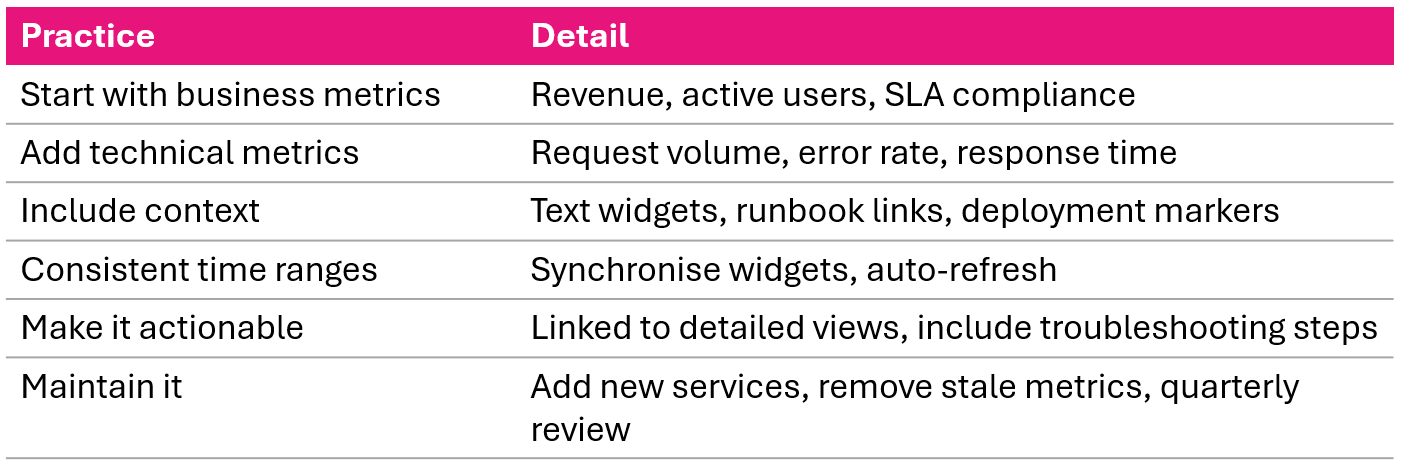
Bonnes pratiques de tableau de bord


Six bonnes pratiques recommandées pour les tableaux de bord de santé applicative

Supervision et dépannage sur AWS

Résumé vidéo et fin du cours

  • Concevoir avec la hiérarchie de l'information et les quatre signaux d'or
  • Combiner métriques CloudWatch, traces X-Ray et journaux en une vue
  • Flux d'incident en 7 étapes : identifier → délimiter → corréler → explorer → cause racine → corriger → vérifier

Vous pouvez désormais :

  • Superviser avec métriques, journaux et tableaux de bord CloudWatch
  • Configurer des alarmes et notifications avec SNS et SQS
  • Mettre en place du traçage distribué avec X-Ray
  • Créer des tableaux de bord de santé pour l'excellence opérationnelle
Supervision et dépannage sur AWS

Tableaux de bord de santé applicative

Supervision et dépannage sur AWS

Preparing Video For Download...