Analyse des traces et des cartes de services

Supervision et dépannage sur AWS

John Q. Martin

Principal Consultant

Qu'est-ce qu'une carte de services ?


Généré automatiquement à partir de vos traces : aucune config manuelle
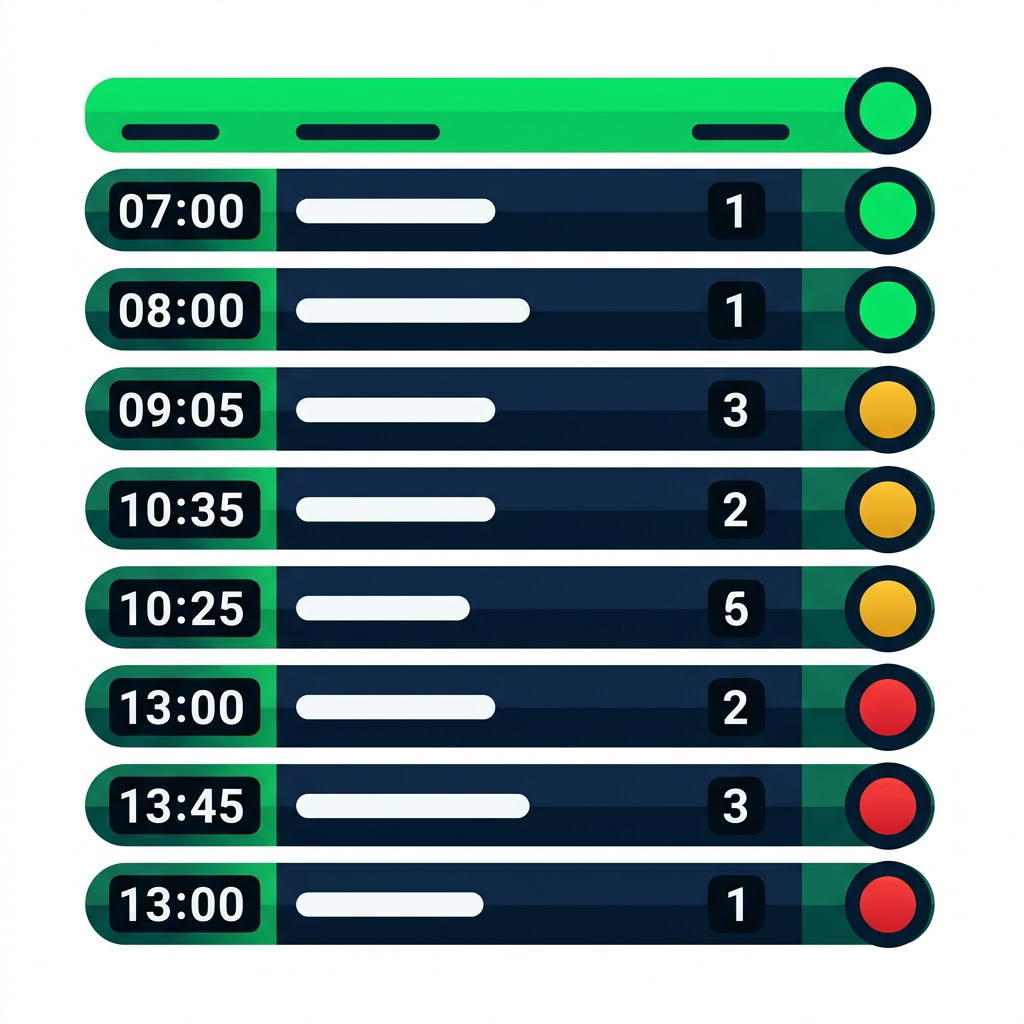
Panneau de départ ferroviaire avec des lignes de services, chacune avec un voyant coloré : vert à l'heure, ambre en retard, rouge à l'arrêt

D'un coup d'œil : vert = à l'heure · ambre = en retard · rouge = à l'arrêt


Accès :

  • Console X-Ray → Service map
  • Appliquer des filtres
  • Cliquer un nœud → vue détaillée
Supervision et dépannage sur AWS

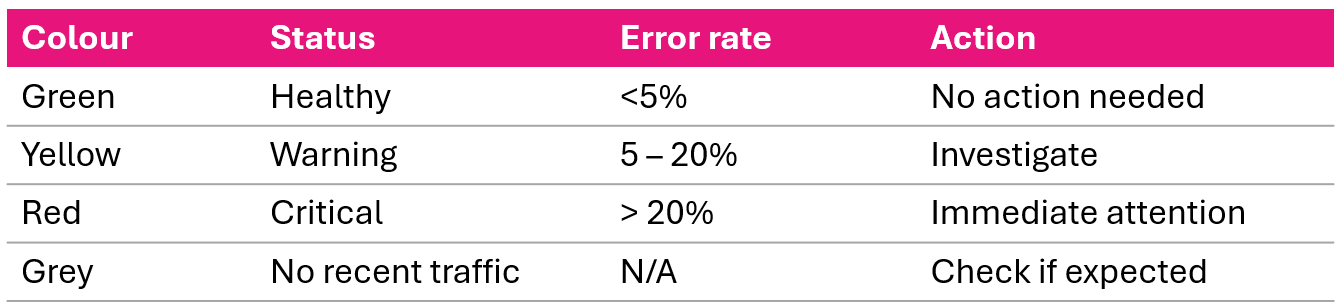
Code couleur de la carte de services


Légende de couleurs d'une carte de services : vert appels réussis, jaune erreurs client, rouge pannes serveur, violet limitation, gris aucun trafic

Quand vous ouvrez une carte, allez directement à tout ce qui n'est pas vert.

Cliquez sur un nœud pour voir : distribution des temps de réponse, répartition des statuts HTTP, types d'erreurs.

Supervision et dépannage sur AWS

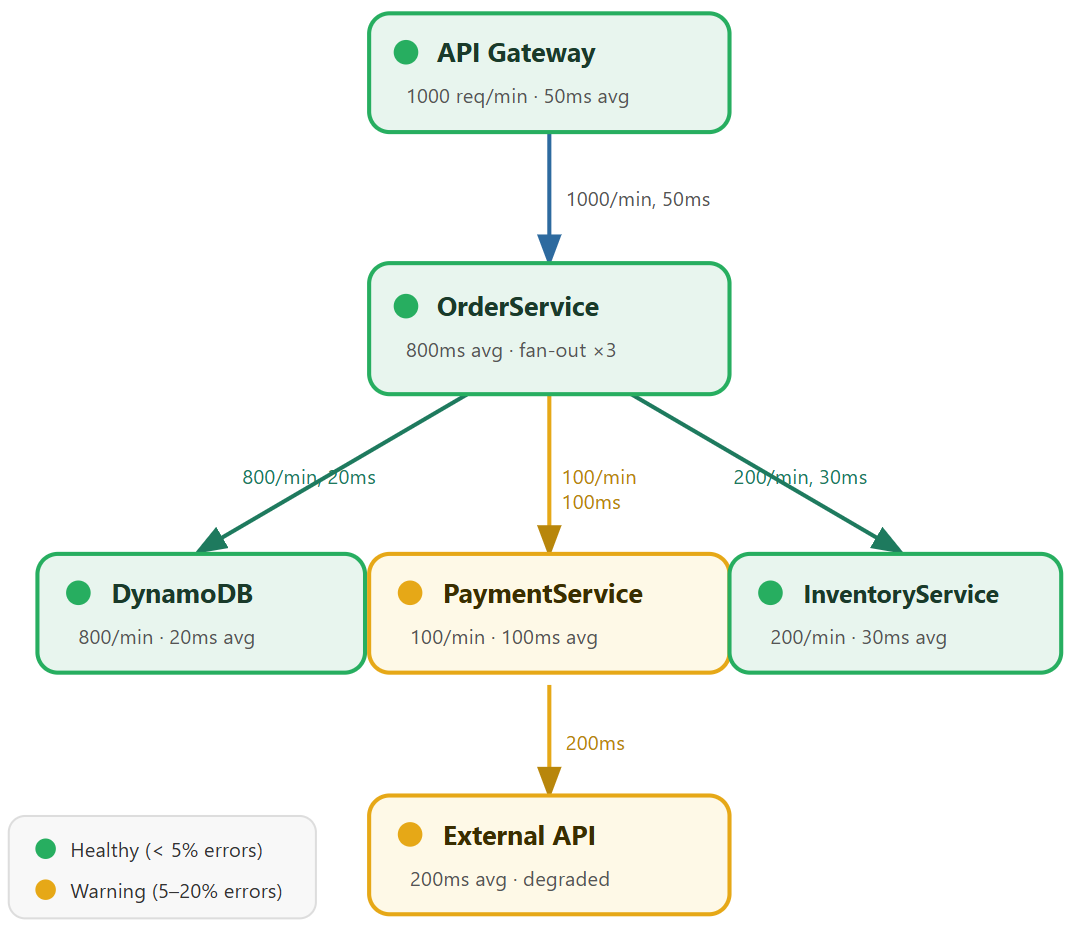
Lire une carte de services


Carte de services avec API Gateway et OrderService se déployant vers DynamoDB Inventory et un service Payment en jaune

Supervision et dépannage sur AWS

Analyse du chemin critique


Chemin critique = plus longue chaîne d'appels

API Gateway (50ms)
  -> OrderService (50ms)
    -> PaymentService (100ms)
      -> External API (200ms)

Total : 400ms

External API = 50 % de la latence totale


À en faire :

  • External API est votre cible d'optimisation
  • Options : ajouter du cache, implémenter délai d'attente + secours, négocier des SLA

Comparer un chemin alternatif :

OrderService -> DynamoDB
Total : 120ms (rapide)
Supervision et dépannage sur AWS

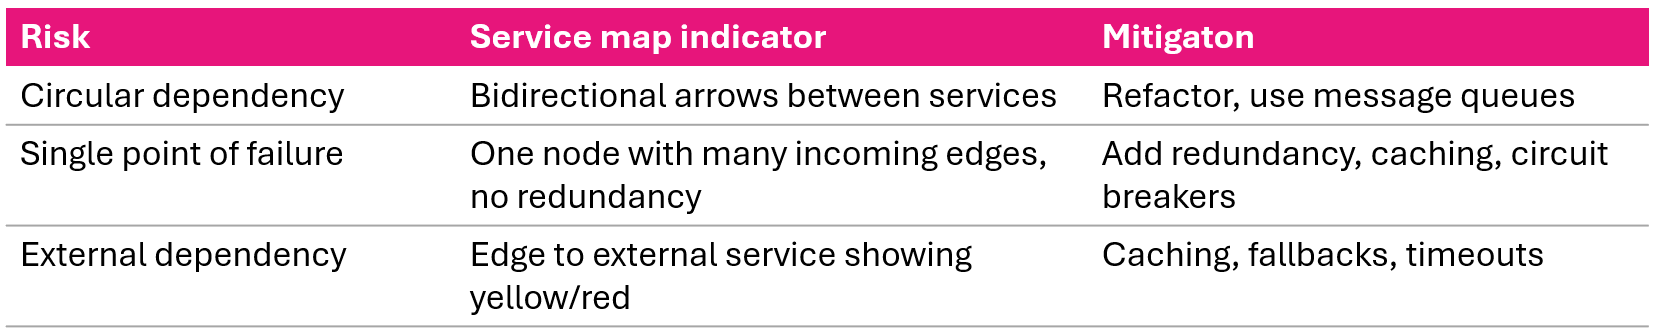
Risques de dépendance


Risques de dépendances sur une carte : dépendances circulaires, points uniques de défaillance, dépendances externes risquées

Supervision et dépannage sur AWS

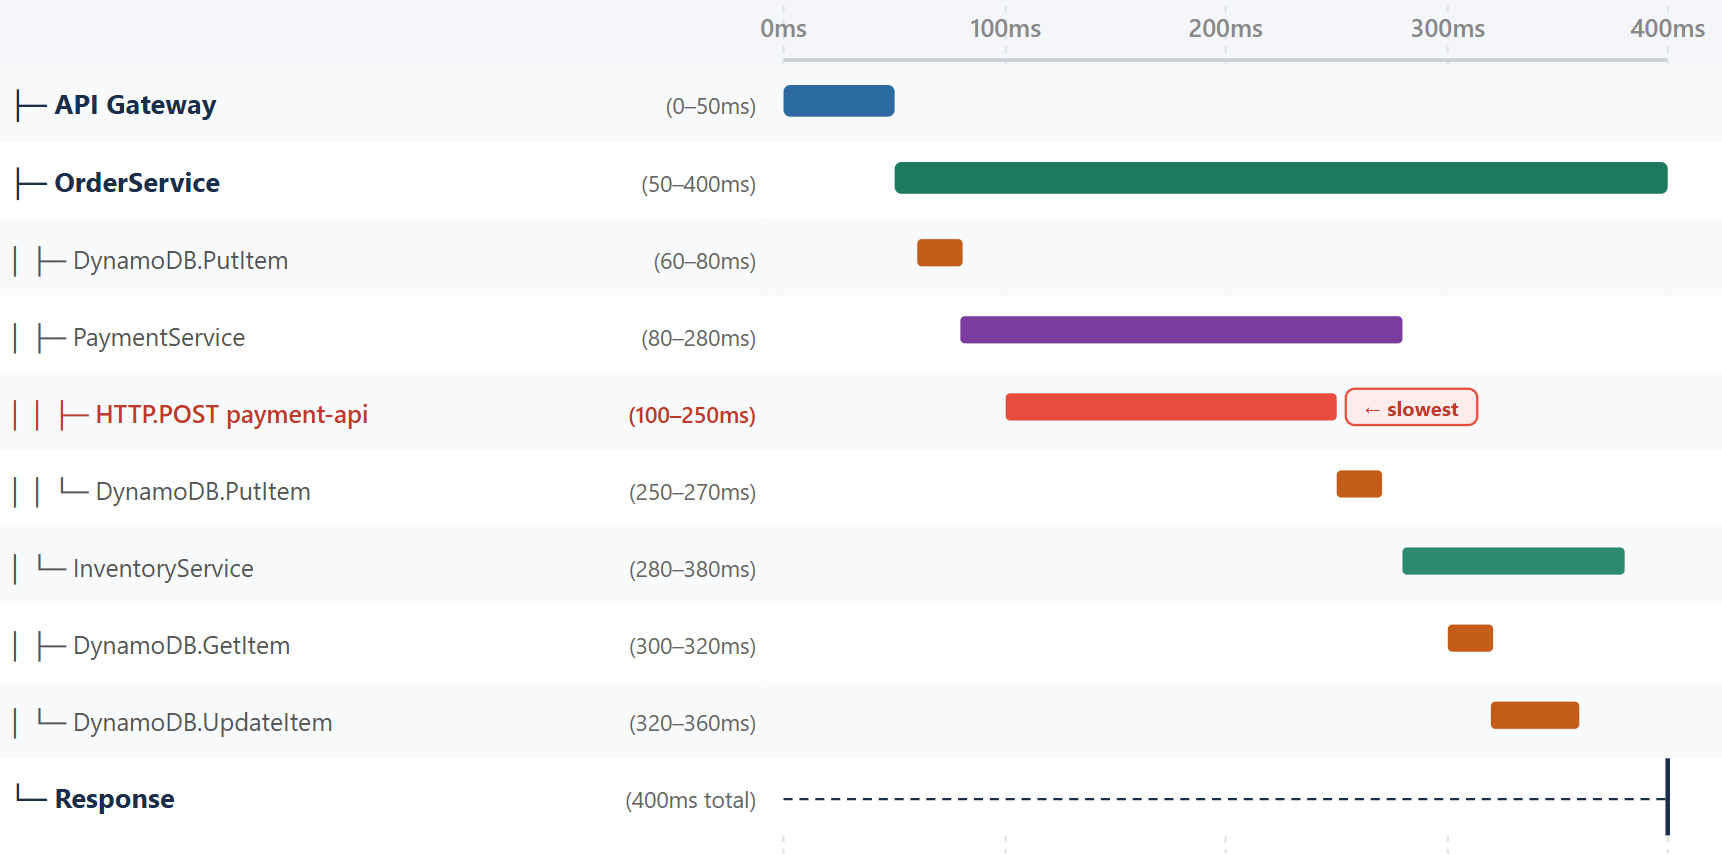
Lire les chronologies de trace


Chronologie de trace avec sous-segments sur un axe temporel, montrant un appel payment-api comme l'opération la plus longue


  • Axe horizontal temps : quand les opérations commencent et leur durée
  • Axe vertical hiérarchie des services : sous-segments indentés sous les parents
  • HTTP.POST vers payment-api (100–250ms) = l'opération la plus longue
Supervision et dépannage sur AWS

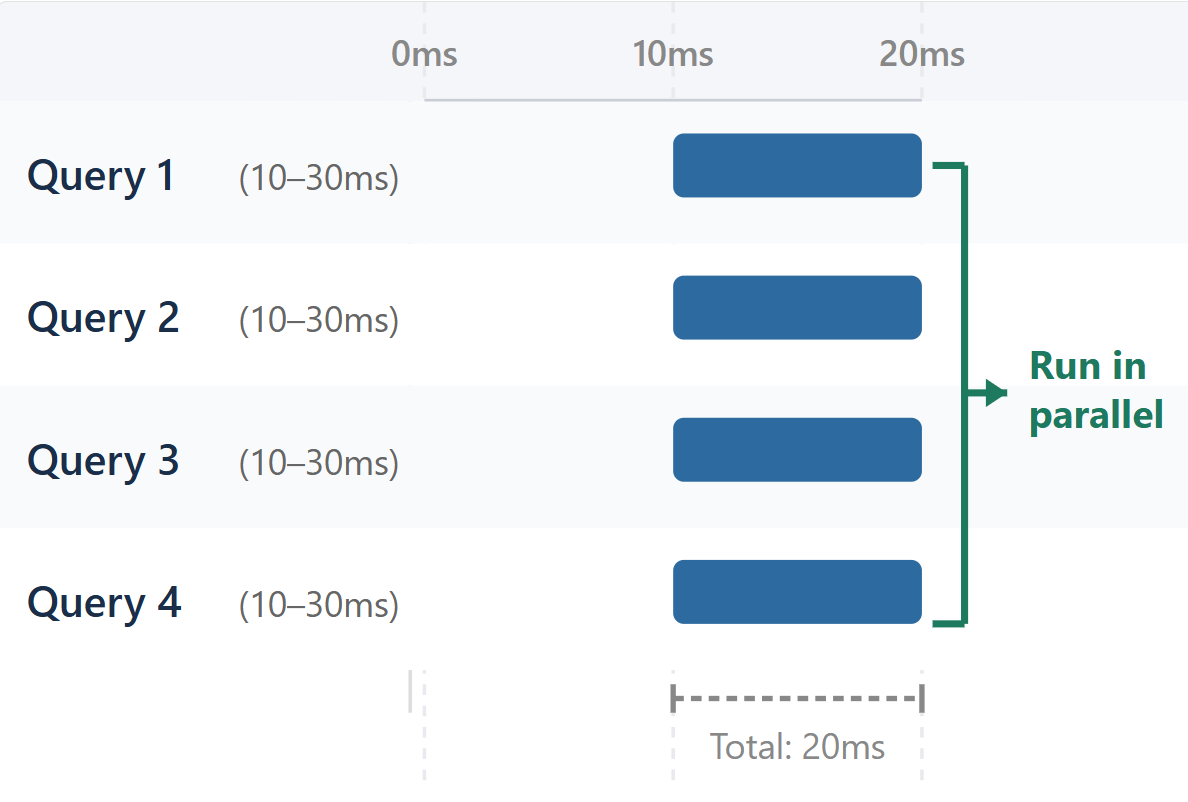
Schéma 1 : Goulots d'étranglement séquentiels


Avant (séquentiel – 80ms) :

Query 1 (10-30ms)
         -> Query 2 (30-50ms)
                  -> Query 3 (50-70ms)
                           -> Query 4 (70-90ms)


Après (parallèle – 20ms) :

Chronologie de quatre requêtes en parallèle se chevauchant pour finir en 20ms

Supervision et dépannage sur AWS

Schéma 2 : Requêtes N+1 et services bavards


Problème des requêtes N+1 :

Get user list       (10-20ms)
Get user 1 details  (20-30ms)
Get user 2 details  (30-40ms)
... ×100 requêtes séquentielles

Correctif : regrouper les requêtes, eager loading


Services bavards :

  • 50 petits appels entre deux services au lieu d'un lot
  • Chaque appel : établissement de connexion + sérialisation + aller‑retour
  • 50× de surcoût

Correctif : regrouper les requêtes, files de messages, mise en cache

Supervision et dépannage sur AWS

Schéma 3 : Démarrages à froid et défaillances en cascade
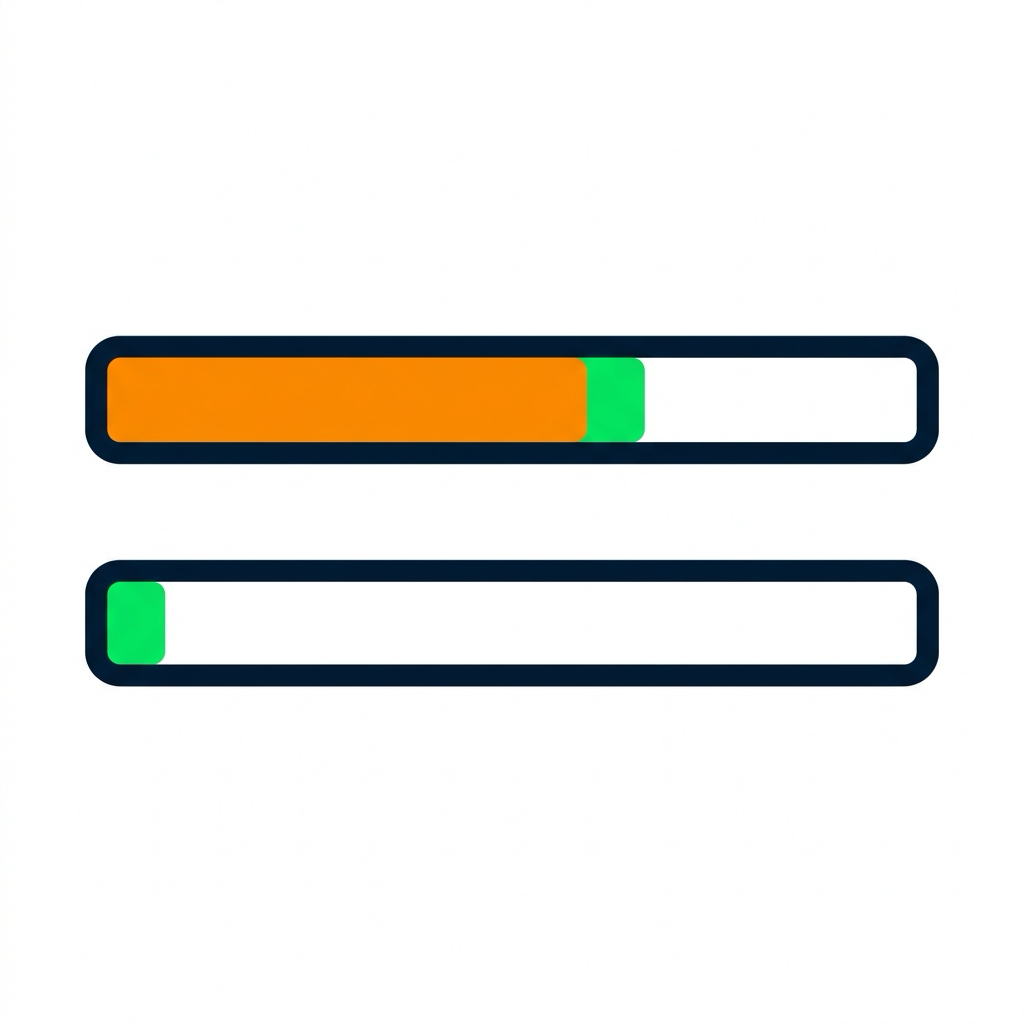
 

Deux barres temporelles : un « cold start » a un grand bloc d'initialisation orange puis un petit gestionnaire vert ; un « warm start » n'a que le petit gestionnaire vert

Démarrage à froid Lambda :

  • Froid : 3000ms (2500ms init + 500ms handler)
  • Chaud : 500ms (handler seul)
  • Visible comme un grand segment d'init au premier appel

Correctif : concurrence provisionnée, optimiser l'initialisation


Défaillance en cascade :

Service A [Error]
  -> Service B [Timeout 5s]
    -> Service C [Timeout 5s]
      -> Database [Timeout 5s]

Blocs de délais identiques empilés dans la hiérarchie de la trace

Correctif : délais d'attente, coupe‑circuits, solutions de secours

Supervision et dépannage sur AWS

Filtrer les traces avec des annotations
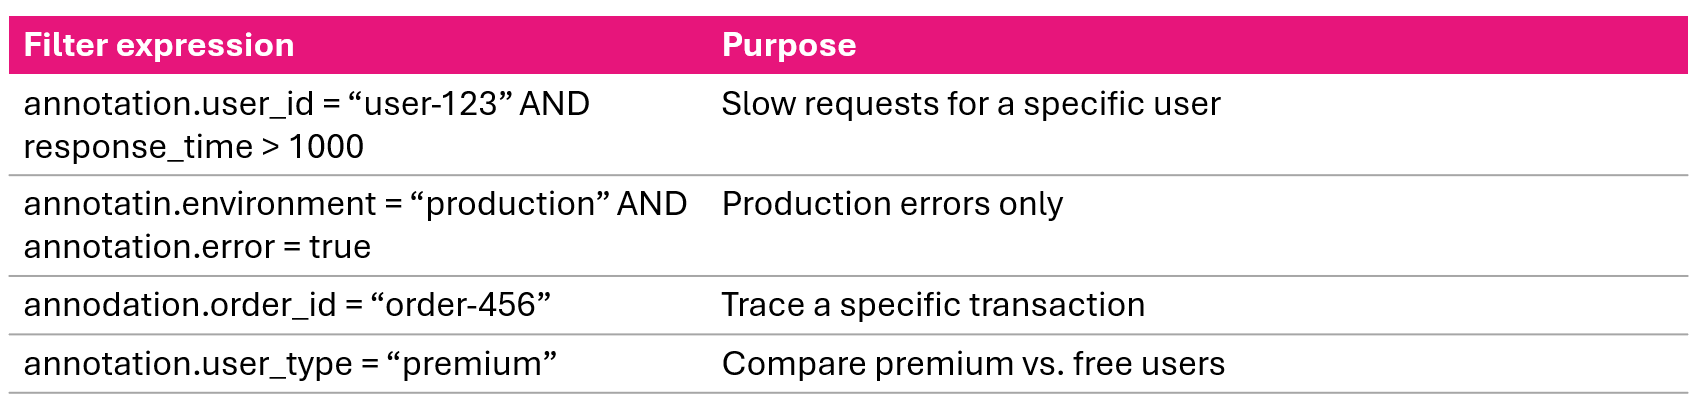
Console X-Ray filtrant les traces par paires clé‑valeur d'annotations

Comparer des groupes :

  • Utilisateurs premium moy. 200ms vs. gratuits moy. 150ms → fonctionnalités premium ajoutent de la latence
  • UE Ouest 3× plus lent que US Est → accès inter‑région au data problématique
Supervision et dépannage sur AWS

Flux d'analyse de traces


  1. Identifier – filtre : response_time > 1000ms, trier par durée
  2. Analyser – repérer opérations les plus longues, goulots séquentiels, parallélisable
  3. Annoter – vérifier les annotations pour le contexte métier : ID utilisateur, ID commande, environnement
  4. Revoir – examiner les métadonnées : détails de requête, messages d'erreur
  5. Corréler – recouper avec CloudWatch Logs
  6. Diagnostiquer – cause racine : requête lente, délai, algorithme, ressource saturée
  7. Corriger – optimiser le code, ajouter du cache, paralléliser, mettre à l'échelle
  8. Vérifier – comparer avant/après, suivre latence et taux d'erreurs
Supervision et dépannage sur AWS

Créer des alertes à partir des données X-Ray


# Alarme de forte latence
aws cloudwatch put-metric-alarm \
  --alarm-name HighLatency \
  --metric-name ResponseTime \
  --namespace AWS/XRay \
  --statistic Average \
  --period 300 \
  --threshold 1000 \
  --comparison-operator GreaterThanThreshold


# Alarme de forte erreur cumulée
aws cloudwatch put-metric-alarm \
  --alarm-name HighErrorCount \
  --metric-name ErrorCount \
  --namespace AWS/XRay \
  --statistic Sum \
  --period 300 \
  --threshold 50 \
  --comparison-operator GreaterThanThreshold
Supervision et dépannage sur AWS

Résumé vidéo


  • Cartes de services – diagrammes d'architecture auto‑générés : nœuds (services), arêtes (connexions), état par couleur
  • Code couleur – vert (succès), jaune (4xx), rouge (pannes 5xx), violet (429), gris (aucun trafic)
  • Chemin critique – plus longue chaîne d'appels ; cible d'optimisation
  • Chronologies de trace – révèlent goulots séquentiels, requêtes N+1, démarrages à froid, défaillances en cascade
  • Annotations – filtrer et regrouper les traces par contexte métier
  • Flux – huit étapes : identifier → analyser → annoter → revoir → corréler → diagnostiquer → corriger → vérifier
Supervision et dépannage sur AWS

Analyse des traces et des cartes de services

Supervision et dépannage sur AWS

Preparing Video For Download...